快速导读:UltraWorld 用临床视频先验、三维解剖合成轨迹与 Acoustic Sampling Map,在没有真实视频–位姿对的条件下蒸馏出动作条件超声世界模型。
自主超声扫描需要从当前局部影像预判探头动作会看到什么。现有世界模型多依赖同步采集的视频–位姿对,而日常临床记录几乎没有探头运动标注;扫描还会同时改变解剖切面和声学采样几何。UltraWorld(arXiv:2610.09785,香港中文大学与中山大学附属第八医院)提出一条自蒸馏配方:先从无动作临床视频学出超声外观与时序先验,再用三维解剖与可编程轨迹合成动作–视频,把生成器迁成观测加动作条件的世界模型。项目页为 https://ultraworld-project.github.io/ 。
关键几何表示是 Acoustic Sampling Map(AsMap):把探头位姿与成像参数写成像素级三维采样位置、声束方向与深度。合成轨迹上 AsMap 的峰值信噪比达到 24.994,高于傅里叶、MLP 与 PRoPE 条件;九段仿真闭环规划相对视觉伺服把终点距离和姿态误差分别降低 29% 与 38%。必须事先讲清边界:这是预印本研究配方,不是临床产品,不得外推为临床可用,也不能替代超声医师或已认证扫描系统。
英文题目:UltraWorld: Learning Interactive Ultrasound World Models from Untracked Clinical Videos with Acoustic Sampling Map
论文出处:arXiv 每日论文精选 · arXiv:2610.09785
原始论文:PDF / 论文页面
这篇论文解决什么问题?
世界模型已经用于探头引导和从预测观测学习策略,对超声尤其有吸引力,因为医师必须把二维切面接到三维解剖再决定下一步运动。难点有两层。第一,成对的超声视频与探头位姿需要专家操作、标定跟踪、同步记录和受试者招募,规模与临床多样性都受限。第二,slide、sweep、rock、深度调节和回访会改变被采样的解剖截面,也会改变每个像素对应的物理采样位置;只给 6 自由度位姿,无法区分探头几乎不动、成像深度却被调浅的情况。
相机控制视频生成常用 Plücker 射线或相对投影几何,但 B 超像素是沿声束的深度定位采样,不是一条光学视线。Cardiac Copilot、EchoWorld 与后续扩散世界模型已经证明预测采集结果有用,却仍吃同步位姿。仿真路线或省略组织散射衰减,或需要配准的 CT–超声对。UltraWorld 因此改走可扩展路径:利用大量无跟踪临床视频的外观先验,把缺失的动作监督单独从三维解剖构造出来。
核心创新
- 自蒸馏配方:临床视频先验与三维解剖可编程监督结合,无需真实视频–位姿对即可学动作条件预测。
- Acoustic Sampling Map 把探头运动与成像参数写成像素级三维采样位置、声束方向与深度。
- 在预测保真、动作跟随、未见临床帧一致性与仿真闭环局部规划上做实验验证。
方法概览
先把视频基础模型适配成参考图加解剖掩膜条件的超声生成器,用 BUV 与 CAMUS 的无动作临床视频学习外观与时序先验。再用 I-SPY1 三维乳腺 MRI 与可编程轨迹(sweep、slide、rock、revisit、深度/视野变化)重采样掩膜序列,由生成器合成与采集状态成对的动作–视频。自蒸馏把掩膜条件换成 Acoustic Sampling Map(AsMap):每个像素写成第一帧探头坐标系下的三维采样位置 q、单位声束方向 b 与采样深度 ρ,共七通道;几何编码器 Φ 与视频 token 对齐后在第一个 transformer 块前相加。骨干由生成器权重初始化,先冻骨干训编码器再联合微调,推理只需当前观测与规定采集轨迹,不再需要掩膜或三维资产。规划侧在仿真里用冻结世界模型加 CEM 的 MPC 做闭环局部扫描。
- 第一阶段学习掩膜条件超声生成器。给定无动作序列,用逐帧解剖掩膜作为结构化控制,再加一张参考超声图锚定外观,把视频基础模型适配成 p_φ(X | r, M)。此阶段不需要采集状态 Ξ。实现上生成器初始化自 Wan2.1-FunControl-1.3B-V1.1,用 BUV 乳腺超声视频与 CAMUS 超声心动图、在 512×512 分辨率上以 LoRA 与条件 flow matching 训练。CAMUS 只用于先验,不进入后续世界模型轨迹。
- 缺失的动作监督来自三维解剖。I-SPY1 乳腺 DCE-MRI 提供语义体数据 V;可编程轨迹覆盖 sweep、slide、rock、revisit 以及成像深度或视野变化。每个采集状态 ξt=(Tt, κt) 对体数据做容积重采样得到掩膜 mt。掩膜序列送进已训练的生成器,合成超声视频,从而得到由构造保证对齐的动作–视频对。论文强调 MRI 只提供三维几何,超声外观仍继承自临床视频先验。
- AsMap 把采集状态变成像素对齐的几何图。对每个像素计算物理采样位置 q、单位声束方向 b 与采样深度 ρ,并变换到第一帧探头坐标系,得到七通道图 Gt∈R^{H×W×7}。同一位姿、不同成像配置会改变 AsMap;对患者坐标系做刚体变换则保持不变。轻量几何编码器 Φ 把 AsMap 序列对齐到视频 token,并在第一个 transformer 块前加到 patch 特征上,不改内部注意力结构。
- 自蒸馏分三步:用生成器权重初始化世界模型骨干;把解剖掩膜条件换成 AsMap,同时保留第一帧观测;先冻骨干只训编码器,再联合微调。两边都用合成轨迹。推理时输入当前观测与规定采集轨迹,不再需要掩膜或三维资产。仿真规划把冻结世界模型接到 CEM 优化的 MPC:每步采样可行动作块,用预测影像与目标图的 LPIPS 打分,只执行第一块再重规划,固定八次迭代。
逐图理解论文
数据缺口
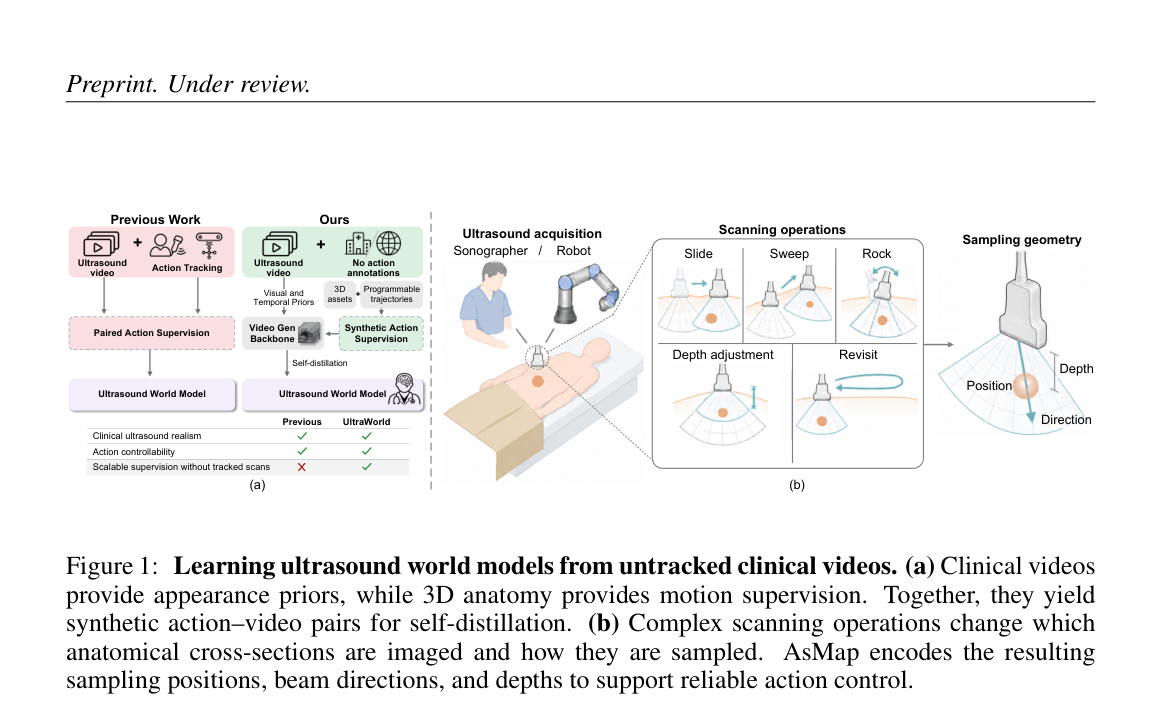
图1是问题与配方对照,页眉带 Preprint. Under review.。(a) 左侧 Previous Work 需要超声视频加动作跟踪才能得到成对监督;右侧 Ours 把无动作临床视频的外观先验与三维资产上的可编程轨迹拼起来,经视频生成骨干自蒸馏。底表三行里,临床真实感与动作可控两边都打勾,只有“无跟踪扫描的可扩展监督”一项 Previous 打叉、UltraWorld 打勾。(b) 医师与机械臂对躺着的患者扫描橙色目标,五种操作 Slide、Sweep、Rock、Depth adjustment、Revisit 画在扇形切面里,右侧再标 Position、Depth、Direction。患者图是示意,不是病例;也不得把机器人扫描读成临床系统。
自蒸馏配方
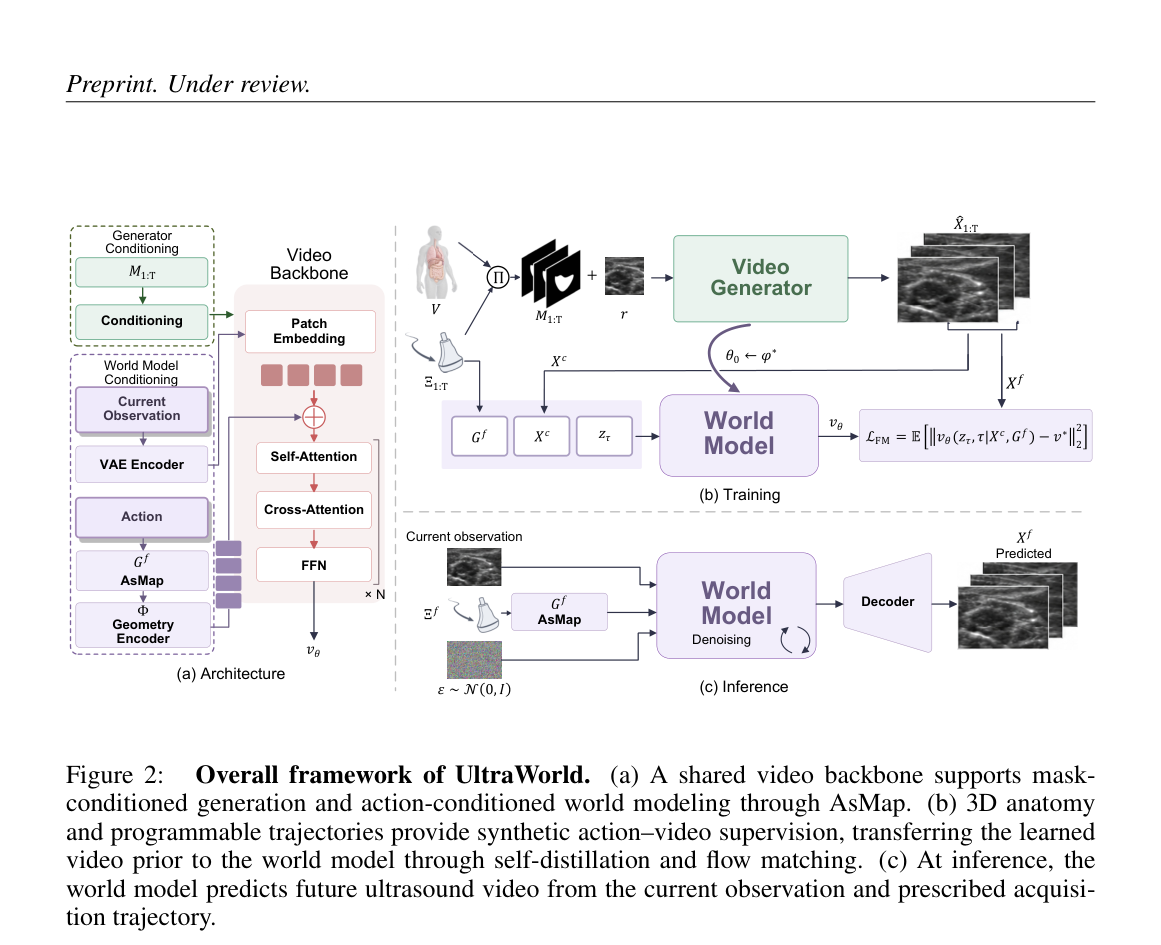
图2是总体框架,宜作特色图。(a) 共享视频骨干:生成器走掩膜条件 M1:T,世界模型走当前观测、VAE、动作与 AsMap 几何编码器。(b) 训练把体数据重采样成掩膜,加参考图 r 生成合成视频 X̂,再以 θ0←φ* 把先验迁到世界模型,用 flow matching 拟合未来帧。(c) 推理只保留当前超声观测、规定采集轨迹 Ξf 与噪声,经去噪解码得到预测未来。图中人体半透明示意仅表示解剖来源;推理框图不是床旁部署流程。
声学采样图
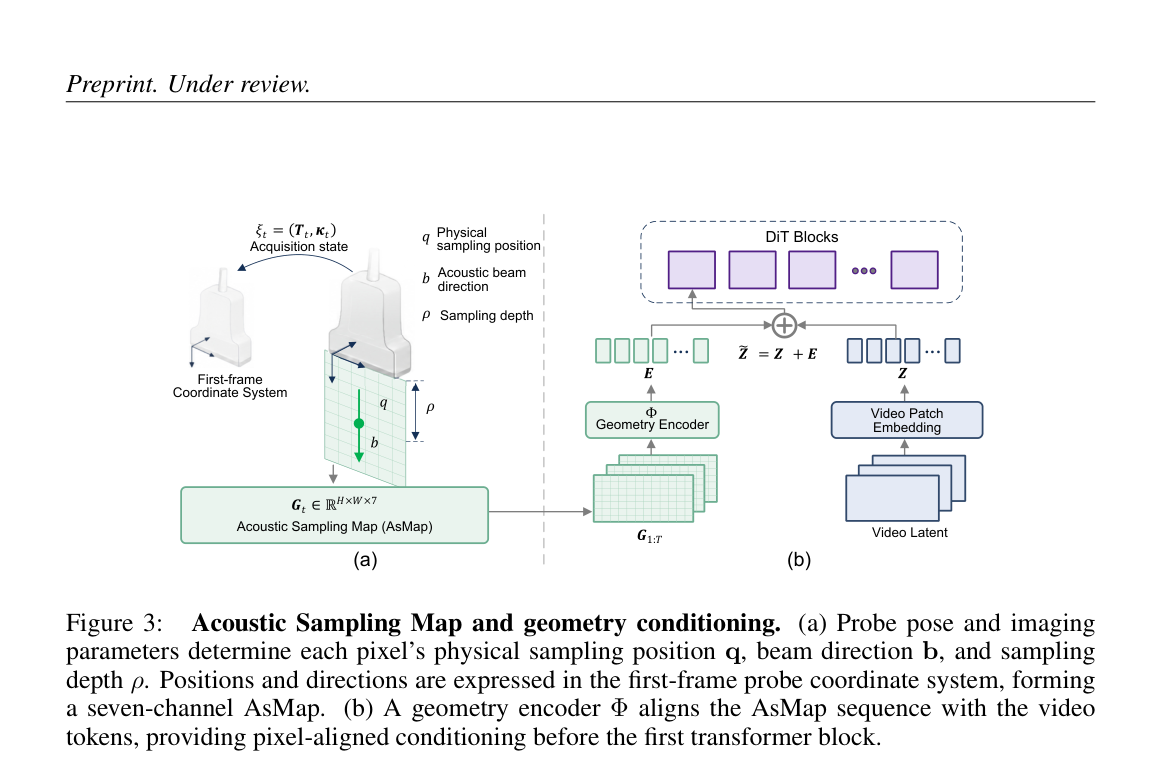
图3解释 AsMap。(a) 采集状态 ξt=(Tt, κt) 决定每个像素的物理采样位置 q、声束方向 b 与采样深度 ρ,全部写到第一帧探头坐标系,形成 Gt∈R^{H×W×7}。(b) 几何编码器 Φ 把 AsMap 序列变成与视频 token 对齐的 E,与视频潜变量的 patch 特征 Z 相加后进入 DiT。七通道来自 3+3+1;该图不编码散射或散斑,那些由临床视频先验承担。
关键证据
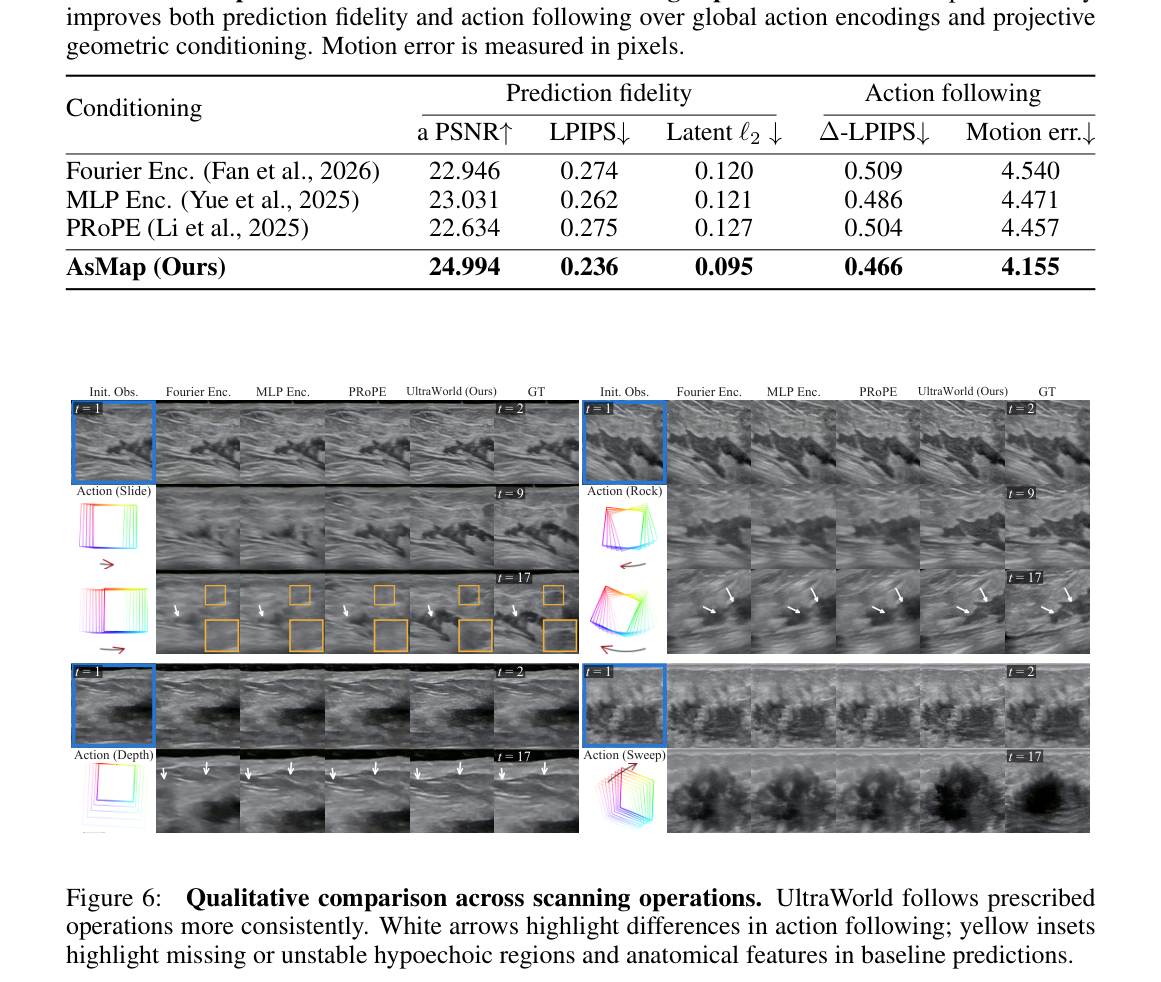
图6是四种扫描操作的定性对比,但本张裁切上方带进了 Table 1。表中 AsMap 的 PSNR 24.994、LPIPS 0.236、latent ℓ2 0.095、Δ-LPIPS 0.466、运动误差 4.155,全面优于 Fourier、MLP 与 PRoPE。图主体按 Slide、Rock、Depth、Sweep 排列,列为初帧、三种对照、Ours 与 GT。白箭头标动作跟随差异,黄框标基线缺失或不稳的低回声。参考未来来自合成轨迹,不是真实带跟踪扫描;更像 GT 也不等于临床可用。应避开另一份不完整的 figure-06-p007-02。
实验如何设计?
- 世界模型质量在成对合成轨迹上评测,参考未来与采集状态已知。保真度用 PSNR、LPIPS 与 latent ℓ2(条件帧不计入);动作跟随用四帧差分的 Δ-LPIPS 以及基于 UltraSam 病灶质心位移的像素运动误差。所有条件方法共享同一视频骨干与同一采集状态 (Tt, κt)。对照为 Fan 等的 Fourier Encoding、EchoWorld 风格 MLP,以及相机锥体几何的 PRoPE。
- 消融包括:参数量约 53.5M、并采用相同第一帧相对坐标的匹配 MLP;以及保留 AsMap 与合成监督、但改从 Wan2.1 基座初始化。真实临床侧使用患者留出的 BUV 与独立 BUSI 作为未见初帧,因为没有成对未来,只报零动作 LPIPS 与 17 帧往返 LPIPS。规划实验共九段仿真回合,对照为强度视觉伺服;终点平移与旋转误差只在固定执行预算结束时计算,目标位姿不进入候选选择。
关键结果与论文证据
- Table 1 上 AsMap 五项全优:PSNR 24.994、LPIPS 0.236、latent ℓ2 0.095、Δ-LPIPS 0.466、运动误差 4.155 像素。Fourier、MLP 与 PRoPE 的 PSNR 落在 22.6–23.0。图6把同一初帧接到 slide、rock、深度变化与 sweep:白箭头标出基线跟不上切面变化之处,黄框标出缺失或不稳的低回声区;UltraWorld 更接近参考未来。附录生成器本身 SSIM 0.4265、LPIPS 0.4071,UltraSam 分割 IoU 0.8736,掩膜可控 Dice 0.9260(真值对照 0.9538)。
- Table 2 显示匹配容量的 MLP 仍明显弱于 AsMap(PSNR 23.402),说明增益不只来自编码器大小或坐标约定。从 Wan2.1 直接初始化得到 PSNR 24.640,与完整模型接近,作者据此认为自蒸馏并不严重依赖生成器权重继承。Table 3 上 AsMap 在 BUSI 的零动作/往返 LPIPS 为 0.042/0.062,BUV 为 0.059/0.076,低于三种对照。图7九段仿真中视觉伺服终点平移 3.86 mm、旋转 5.86°,UltraWorld+CEM 为 2.75 mm 与 3.65°,与摘要中的 29% 与 38% 降幅一致。
阅读时需要注意
- 附录 E.6 写明:世界模型主要用生成器合成轨迹训练,先验误差会传到蒸馏模型;AsMap 不显式建模组织散射、衰减与散斑,其米制解释依赖探头与成像标定;真实临床没有成对未来,只能测稳定与往返;闭环规划目前只在仿真且回合有限。未来工作才考虑少量带跟踪临床数据做标定,以及实体机器人。
- 伦理声明称使用公开数据集、不涉及可识别个人信息,但公开医学影像仍有来源偏差与使用限制。代码计划在发表后放出。最关键的使用边界必须单独强调:UltraWorld 不是临床产品,不得外推为临床可用。仿真规划更低的终点误差、合成轨迹上更高的 PSNR,或真实初帧上更低的往返 LPIPS,都不能解读为床旁扫描性能或诊断效能。
关联工作
- 机器人超声长期沿视觉伺服、强化学习与演示奖励学习推进,也有把导航、探头姿态与力反馈集成的甲状腺扫描系统。世界模型是较新的一层:用预测观测做引导或给策略提供奖励。UltraWorld 不取代这些控制栈,而是试图降低动作–观测数据的采集成本。
- 超声合成方面,CT/MR 解剖仿真、SonoGym、Echo from Noise、BUSGen 以及由语义图或单帧生成心动周期的扩散模型,都说明解剖控制与合成数据有用,但视觉真实不等于忠实响应规定扫描动作。几何条件方面,超声世界模型常用学习嵌入或三角特征,相机模型则编码视线或投影关系;AsMap 把深度分辨的声学采样显式化。