快速导读:该基准用 Mitsuba 3 成对反事实渲染,把物理一致性诊断拆成违规类型、受影响区域与语言解释,并用干预机制偏移检验模型是否在走渲染捷径。
现代图像编辑常常能完成文本指令,却把场景物理弄坏:新物体不投阴影,镜子里没有该出现的几何,物体悬在本应支撑它的表面之上。arXiv:2610.09205 把问题写成接地物理一致性诊断——判断静态 RGB 图是否违反一组图像可观察的物理约束,若违反则命名类型、定位受影响区域并用语言解释。作者单位为 Georgia State University、Georgia Institute of Technology 与 Emory University 的 TReNDS 中心。选稿注释称 NeurIPS 2026 workshop,但 PDF 只标 Preprint,本文仍按预印本阅读。
受控合成部分用 Mitsuba 3 生成 500 个场景族、5,500 张图:每族一张干净图加十类匹配违规,覆盖阴影、反射、支撑接触、表面响应与遮挡。LLaVA-1.5-7B、Qwen2.5-VL-7B 与 InternVL3.5-8B 只是诊断探针,不是提出的新架构。标准留出上适配后类别宏 F1 为 64.0–67.8%;LLaVA 在干预机制偏移下掉到 40.8%。标题问题的答案因此是混合的:模型能拟合若干渲染违规标签,也明显依赖构造捷径。
英文题目:Do Vision Models Learn Physical Constraints or Rendering Shortcuts? A Counterfactual Benchmark for Grounded Physical Consistency
论文出处:arXiv 每日论文精选 · arXiv:2610.09205
原始论文:PDF / 论文页面
这篇论文解决什么问题?
物理不一致性往往稀疏、局部、难以手工标注。真实图很少告诉你被违反的是哪条规则、证据在哪个区域。更麻烦的是,若训练和测试由同一渲染管线与同一套干预规则生成,高分可能只是在认程序伪影。作者因此不用单次二分类交差,而是记录物理约束、受影响区域和构造该样本时的场景参数。
评测覆盖识别与泛化。除了留出场景实例,还改变场景外观和违规生成机制,后者更严格。外部则用 PICABench 的区域接地问答,而不是把其更广的物理分类硬塞进十个合成类别。工作明确是评测与基准研究,模型适配只为探测基准难度。
核心创新
- 为静态图接地物理一致性提供可控违规,覆盖照明阴影、反射、支撑接触、表面响应与深度顺序。
- 用渲染器导出受影响区域监督,既覆盖引入的异常线索,也覆盖缺失线索应出现的位置。
- 用外观偏移与干预机制偏移拆开“学会物理约束”和“拟合渲染捷径”。
方法概览
工作定位为评测与基准,不提出新模型。Mitsuba 3 生成 500 个场景族、5,500 张 500×500 图:每族一张干净图加十类匹配违规,覆盖阴影、反射、支撑、表面响应与遮挡。违规通过对场景参数干预或在线性辐射度下合成辅助渲染得到,并尽量保持无关配置。渲染器导出类别、受影响区域掩膜与紧包围盒、场景元数据与模板解释。划分按场景族互斥:训练 300/3,300,验证 50/550,标准留出、外观偏移、干预偏移各 50 族/550 张。诊断探针为 CLIP 零样本以及 LLaVA-1.5-7B、Qwen2.5-VL-7B、InternVL3.5-8B 的预训练与 LoRA 适配;另用过滤得到的 PICA-20K 做外部编辑图适配。输出固定为一致性、细类、归一化框与短解释。
- 任务输出写成 fθ(x)=(ŷ, ĉ, r̂, ê):是否物理一致、违规细类、归一化受影响框、自然语言解释。干净图只给 clean 标签、没有违规类。十个细标签属于五个物理族;错误阴影方向与阴影-照明不一致、悬浮物体与不可能遮挡是故意靠近的压力对,操作边界与捷径风险列在 Table 4,作者不假设标签互相独立。
- Mitsuba 3 场景由记录种子确定性生成。每族一张正确图加十张反事实:错误阴影方向、缺失投射阴影、悬浮、阴影照明不一致、缺失反射、反射角度不匹配、错误高光、错误反射物体身份、不可能遮挡顺序、缺失接触阴影。违规或改场景参数,或在线性浮点辐射度下合成辅助渲染,例如抬高物体、改光照、迁移另一灯位的阴影、替换反射内容。与目标关系无关的配置尽量保持。反射类需要反射后墙,不可能遮挡则引入不同深度的两物体,因此每类有自己的干净参照。
- 数据划分按场景族互斥:训练 300 族 3,300 张,验证 50 族 550 张,标准留出、外观偏移、干预偏移各 50 族 550 张。外观偏移换掉几何、材质与光照组合但保留干预机制;干预偏移匹配训练外观,却把每种语义违规的构造机制留出。合成测试合计 1,650 张。渲染器导出状态、类别、程序参数、干预元数据、模板解释、受影响掩膜及其紧包围盒。空间监督是干预相关定位:引入的线索标异常区,缺失的线索标本应出现的位置,不保证覆盖全部诊断证据。
- 探针包括 CLIP ViT-L/14 零样本,以及三只约 7–8B 的 VLM 的预训练与 LoRA。视觉编码器冻结,LoRA 加在语言注意力投影上。另训练只看合成数据的模型做 PICABench 零样本迁移,以及再加 PICA-20K 的混合源模型。PICA-20K 从 PICA-100K 过滤 20,000 条可见接地样本,源视频与编辑身份在适配与评测间互斥。
逐图理解论文
评测缺口
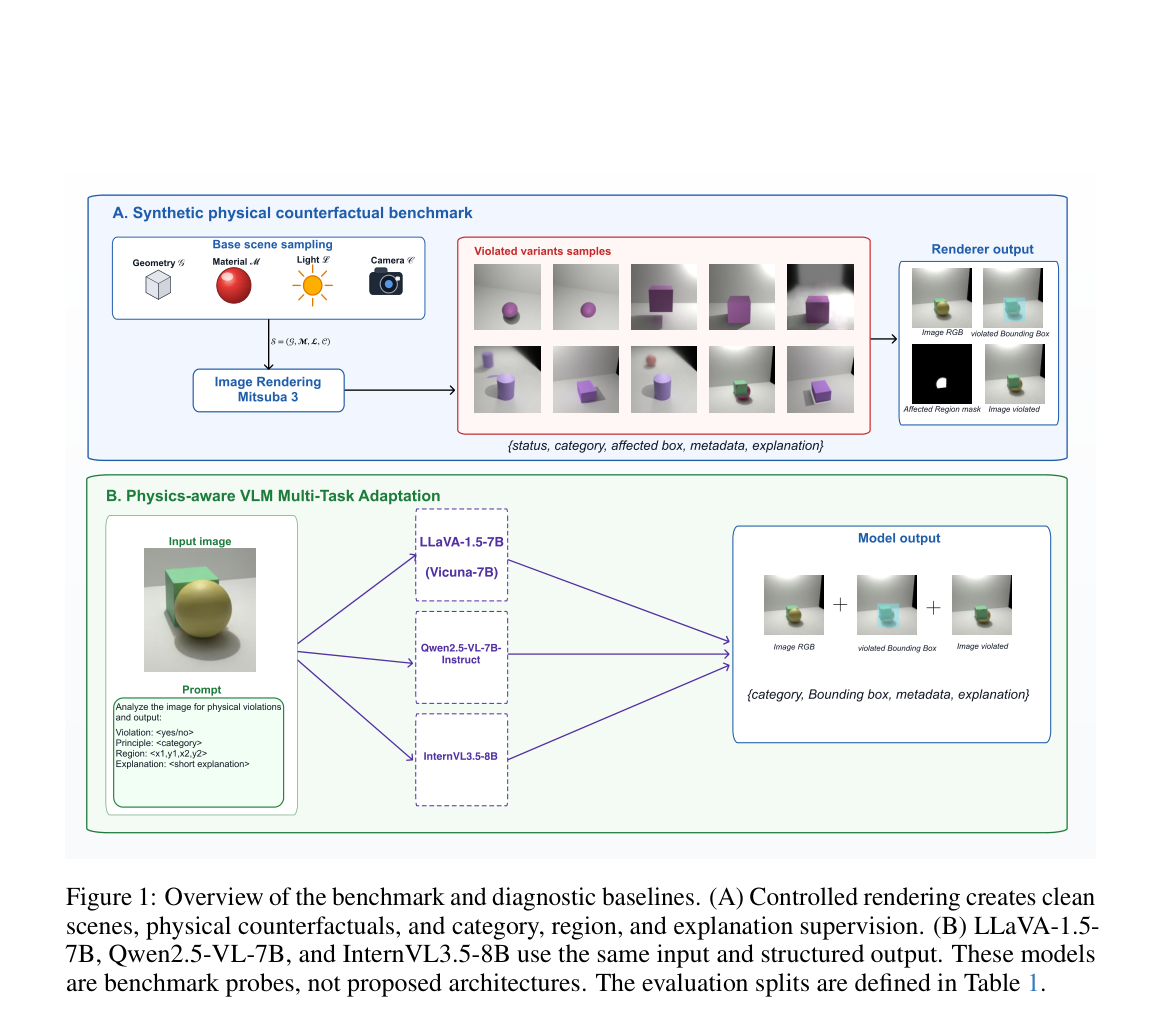
图1是基准与探针总览,比页3那张文字裁切清晰,宜作特色图。(A) Geometry、Material、Light、Camera 组成场景因子,经 Mitsuba 3 渲染;中间网格展示紫色立方体、圆柱与球体的违规变体;右侧同时给出 RGB、违规框、受影响掩膜和结构化字段。(B) 输入示例为绿色立方体加黄色球体,提示要求输出是否违规、细类、框与短解释;LLaVA-1.5-7B、Qwen2.5-VL-7B 与 InternVL3.5-8B 共用接口。图注写明这些模型是探针不是新架构。不要使用 figure-01-p003-01。
关键证据
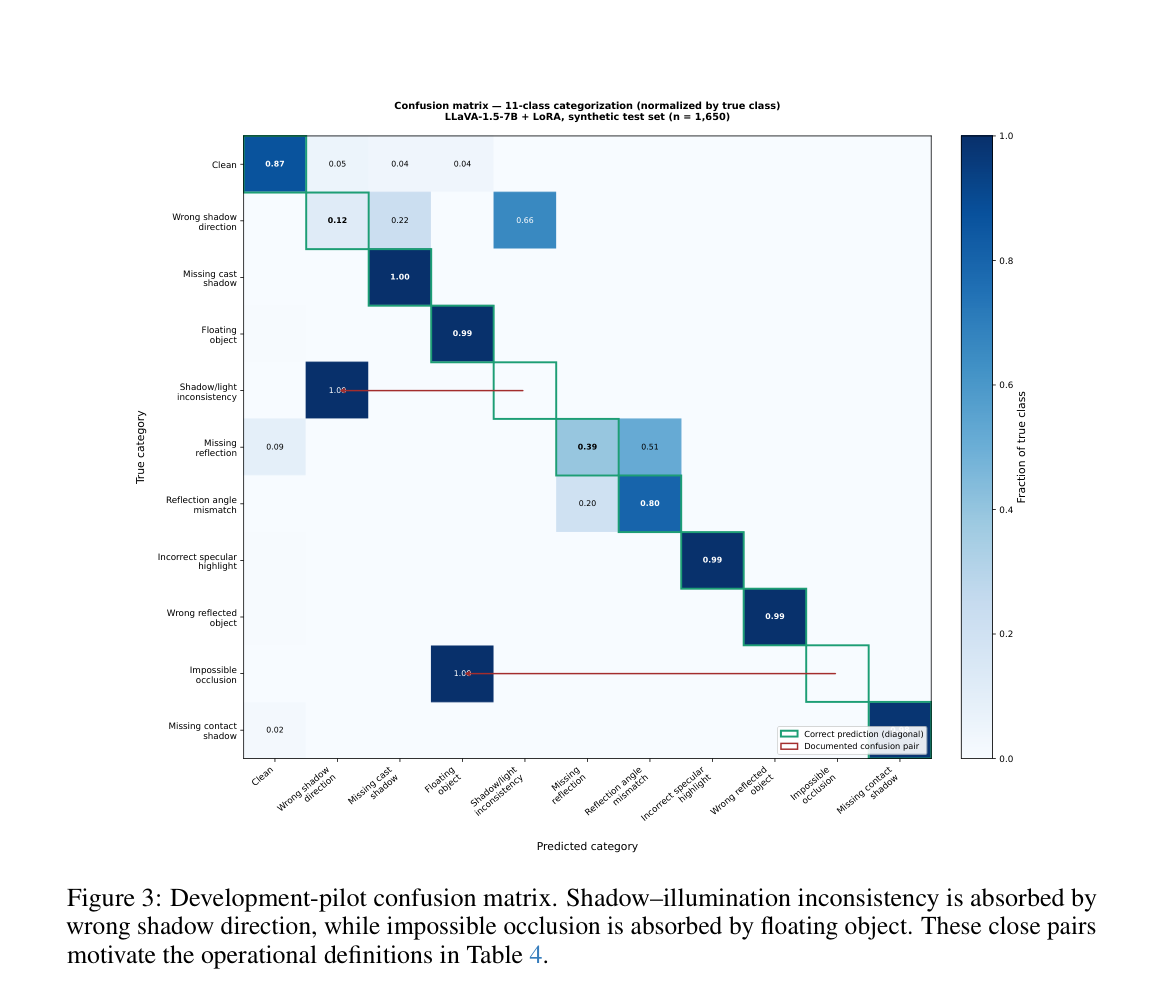
图3是开发试点混淆矩阵,LLaVA-1.5-7B+LoRA,n=1,650,按真类归一化。Clean 对角 0.87;缺失投射阴影、悬浮、错误高光、错误反射物体接近 1。红线标出的文档化混淆对:阴影-照明不一致以 1.00 被吸收进错误阴影方向,不可能遮挡以 1.00 被吸收进悬浮物体。错误阴影方向本身对角仅 0.12。该矩阵来自锁定三套测试之前,不能替代 Table 2/3 的主结果,但能解释为何细类必须成对解读。
Figure 2: Additional clean and violated examples for all ten fine-grained categories
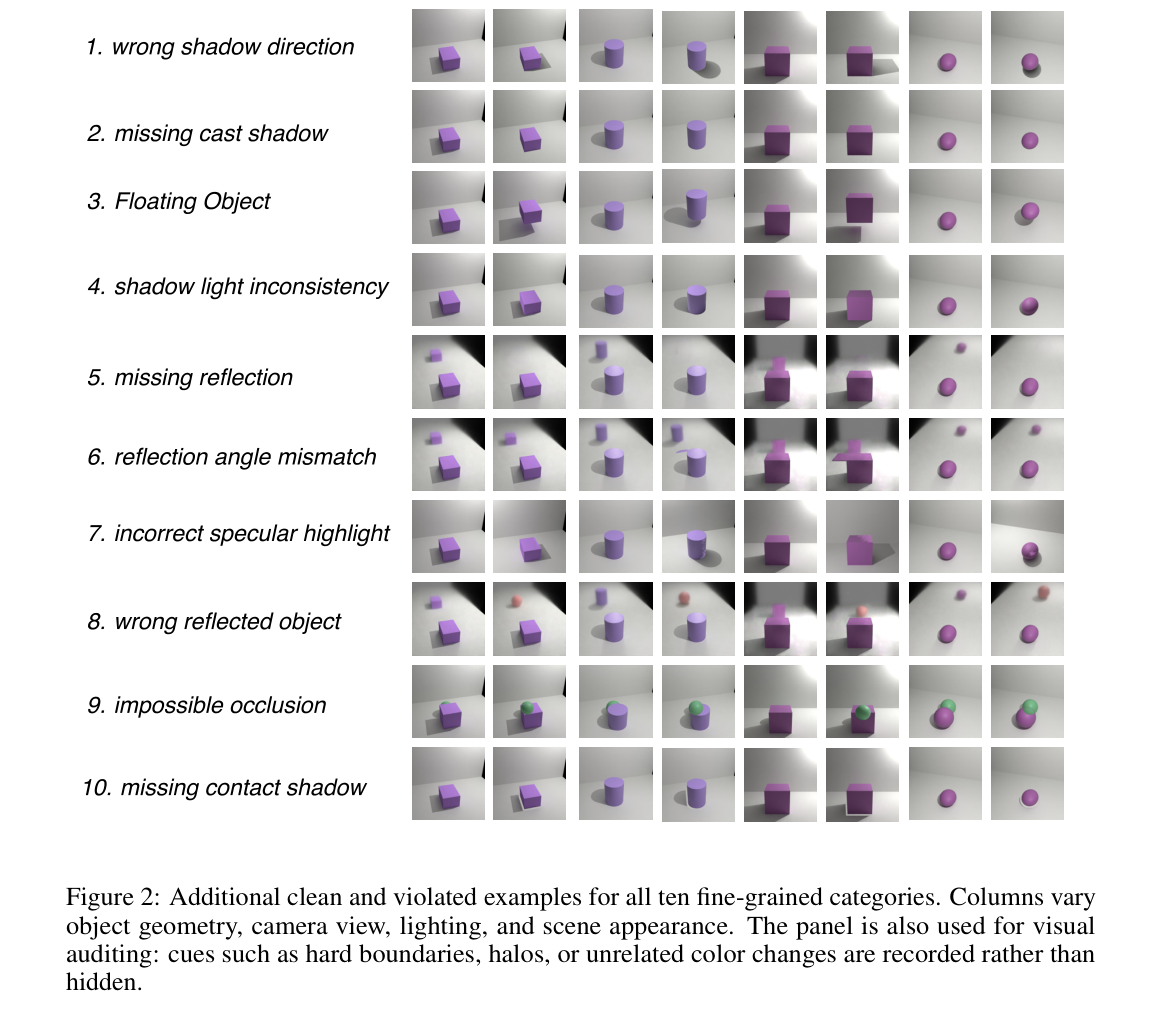
图2按十行列出细类的干净/违规样例:错误阴影方向、缺失投射阴影、悬浮、阴影照明不一致、缺失反射、反射角度不匹配、错误高光、错误反射物体、不可能遮挡、缺失接触阴影。列方向改变物体几何、相机、光照与外观。画面里能看到错位阴影、悬浮缝隙、后墙反射问题、绿色球与紫色体的遮挡顺序,以及近接触阴影被去掉。作者把硬边界、光晕或不相关变色留着做视觉审计,而不是修掉,这正是干预偏移要检验的捷径来源。
实验如何设计?
- 所有合成套件使用固定提示、解析器与检查点。从结构化文本解析二分类、11 类之一、框与解释。指标包括二分类准确率/平衡准确率/宏 F1 与两类召回、11 类准确率与宏 F1、框 IoU、非法输出率、解释正确率。非法或缺失空间输出 IoU 记零并计入非法率。适配结果三种子平均。置信区间按场景族自助,而不是按单张图,以保留干净图与其配对反事实的依赖。
- 多数类基线永远预测最频繁类,用来提醒 10:1 的违规/干净不平衡。人类参考为 220 张、每类 20 张、场景族不重复的分层子集,三名评分者拿与模型相同的任务定义但没有渲染器元数据。解释正确与否按识别违规关系及其可见后果的三级量表,由三人多数评为 correct 的比例报告,Fleiss’ κ=0.78。开发试点混淆矩阵来自锁定测试前的 1,650 张池,只用于暴露细类压力,不进入主对比。
关键结果与论文证据
- Table 2 的标准留出上,零样本 CLIP 与 LLaVA 几乎做不成 11 类:类别宏 F1 分别为 1.9% 与 1.2%,LLaVA 干净召回仅 2.0%,倾向一律报违规。多数类二分类准确率 90.9% 只是类别不平衡,类别宏 F1 仅 1.5%。LoRA 适配后三只 VLM 都变得可学,Qwen2.5-VL 类别宏 F1 最高 67.8%,LLaVA 64.0%,InternVL 66.0%。作者强调这只说明标签可学,还不能称为物理推理。
- Table 3 才对应标题。LLaVA+LoRA 的类别宏 F1 从标准 64.0% 降到外观偏移 52.4%(掉 11.6 点),再降到干预偏移 40.8%(掉 23.2 点)。框 IoU 从 60.5% 降到 50.6% 与 41.7%,解释正确率从 77.4% 降到 68.3% 与 58.9%。PICABench 上合成-only 零样本框 IoU 22.7%、问答正确 38.6%;加上 PICA-20K 后为 34.8% 与 49.1%,仍远低于合成标准划分。人类参考在标准子集上为二分类宏 F1 96.0%、类别宏 F1 82.0%、IoU 74.0%、解释 91.0%。
- 图3与 Table 5 显示开发试点里两条近邻压力对被完全吸收:阴影-照明不一致全部预测成错误阴影方向,不可能遮挡全部预测成悬浮物体,这两类 F1 为 0。错误阴影方向本身对角也弱。作者据此要求同时报告粗检测与细类,并用 Table 4 的操作定义约束解读。
阅读时需要注意
- 讨论写明:能拟合若干渲染违规标签,并不在受控变化下保持该精度。有直接视觉证据的类别更容易,靠近的阴影与几何子类更难。CLIP 零样本很差,说明需要适配;但 23.2 点的干预缺口说明适配仍在学与反事实构造绑定的线索。PICA-20K 把外部框 IoU 和问答正确率分别提高 12.1 与 10.5 点,迁移缺口仍大。
- 受影响掩膜可复现,却未必包含因果诊断所需的全部线索,例如悬浮物体的空气间隙。合成仍可能留下去接触阴影后的亮边或光晕、辅助渲染合成超出目标关系的改动。配对设计与面积匹配减弱但去不掉这些捷径,所以干预偏移与按机制拆分是主主张,而不是可选鲁棒性附录。高违规分数不能当作图像被伪造、生成或恶意编辑的证明;系统定位为编辑管线与数据审计的诊断工具,不是真实性神谕。
关联工作
- PhysBench 评物体属性、空间关系、场景推理与动态事件;HallusionBench、NaturalBench、MMMU 显示强多模态模型仍会在接地推理上失败。SPR-128K 针对空间合理性,PhyDetEx 检测并解释生成视频的物理不合理性。本文互补点是静态图、成对物理反事实,以及干预相关的空间监督。
- 编辑评测上,已有工作指出生成图即使看起来真实也可能破坏投影几何或物影关系。PICABench 用区域接地问答覆盖光学、力学与状态转移;Re-Edit 与 PhyEditBench 从推理或多阶段真实例子评估物理感知编辑。鉴伪与操作用高频伪影或光照一致性,目标是真实性;本基准标注的是受控干预改变的那条物理关系。