快速导读:OccludeBench 用完全遮挡设定比较直接物理线索与语境推断,发现模型在阴影反射上落后人类,并定位瓶颈在情境内恢复。
图里看得见的内容,现代视觉语言模型已经很强;可一旦物体被完全挡住,模型还能不能根据剩下的证据把它找回来?OccludeBench(arXiv:2610.13790,Princeton University)用人工遮挡构造同一提问下的两类图像:直接题必须读阴影或反射等物理投影,推断题则可凭更广语境作答。五模型平均在直接题 42.7%、推断题 62.7%,整整落后 20 分;人类则是 63.4% 与 68.5%,没有显著差距。
为定位失败,作者提出 OccludeTrace:把“从投影恢复物体”拆成检测线索、识别线索、映射来源、在全图情境中恢复四步。结果显示前三步在答对/答错样本上仍接近,真正拉开差距的是第四步(91% vs 50%)。延长推理、工具与少样本改进不稳定;对具备图像生成能力的模型,先补全再对照物理线索的 inpaint-then-confront 能把差距压到统计不显著。预印本尚未同行评审。
英文题目:OccludeBench: Can VLMs Find What's Missing?
论文出处:arXiv 每日论文精选 · arXiv:2610.13790
原始论文:PDF / 论文页面
这篇论文解决什么问题?
多数基准使用完整、无约束图像,模型可能混用语义先验与局部纹理,评测者很难知道它到底有没有“读证据”。完全遮挡提供了一个更干净的切口:答案已知、被藏内容可控、残留证据类型也可设计。
若把阴影反射当噪声去掉,就测不到模型是否理解这些物理投影;若只做语境推断,又可能被世界知识短路。OccludeBench 的关键设计,是让直接与推断共享同一任务句式与遮挡流程,只改变可用证据类型,从而把差距解释为推理差异而非题型差异。
核心创新
- 在同一遮挡任务下分离直接物理线索与语境推断,使二者差距成为可控诊断量。
- 提出 OccludeTrace 四阶段协议,定位失败集中在全图情境下的投影恢复。
- 系统比较多种干预,发现 inpaint-then-confront 能把直接—推断差距压到统计不显著。
方法概览
OccludeBench 含 378 张手工策展图:直接类 197(镜面反射 47.7%、漫反射 28.4%、阴影 23.9%),推断类 181(技术/家居/文化/活动/自然等)。图像来自互联网、Visual Genome 与作者自拍;标注者须一致同意类别后,用醒目框或多边形人工遮挡目标物体,避免自然遮挡带来的形变混淆。评测对五个 VLM 做开放式提问“完全被遮挡的主要物体是什么”,用 Claude Opus 4.6 与 GPT-5.4 的 LLM-as-a-judge(任一判对即对,与作者标注一致率 98%)计分,并收集 473 名英语受试者的人类基线。OccludeTrace 在直接题上拆四阶段:检测线索、识别线索内容、映射到来源区域、在全图高亮投影区内恢复物体。干预实验覆盖延长推理、工具调用、提示引导、少样本,以及先补全遮挡区再对照物理性质检验的 inpaint-then-confront。
- 数据来自互联网、Visual Genome 与作者实拍;合成图因阴影反射物理性不准而被放弃。直接类要求存在明确投影且无法单靠语境猜中;推断类则要求语境足以支持合理推断。标注者须一致同意类别,再用醒目框/多边形遮挡目标,坐标随数据发布。全集 378 张:直接 197、推断 181。
- 评测模型为 Llama 4 Maverick、Qwen3-VL-8B、Claude Opus 4.6、Gemini 3.1 Pro、GPT-5.4。提示要求尽可能具体地指出完全被遮挡的主要物体。评分采用双模型 LLM-as-a-judge,任一认为匹配真值即记对,与作者标注一致率 98%。人类基线在 Prolific 招募 473 名英语受试者,每人随机 3 直接+3 推断,零样本开放作答。
- OccludeTrace 针对直接题:分别提示模型找投影、在裁剪投影中认物体、在候选区域中选投影来源、以及在全图高亮投影区描述内容(不提示阴影/反射/遮挡词)。干预方面,除 thinking、裁剪缩放工具、短/长引导与少样本外,重点测试 inpaint-then-confront:先让模型把遮挡区补成可见物体,再问该补全是否符合反射/阴影物理,并重新命名遮挡物。
逐图理解论文
基准设计
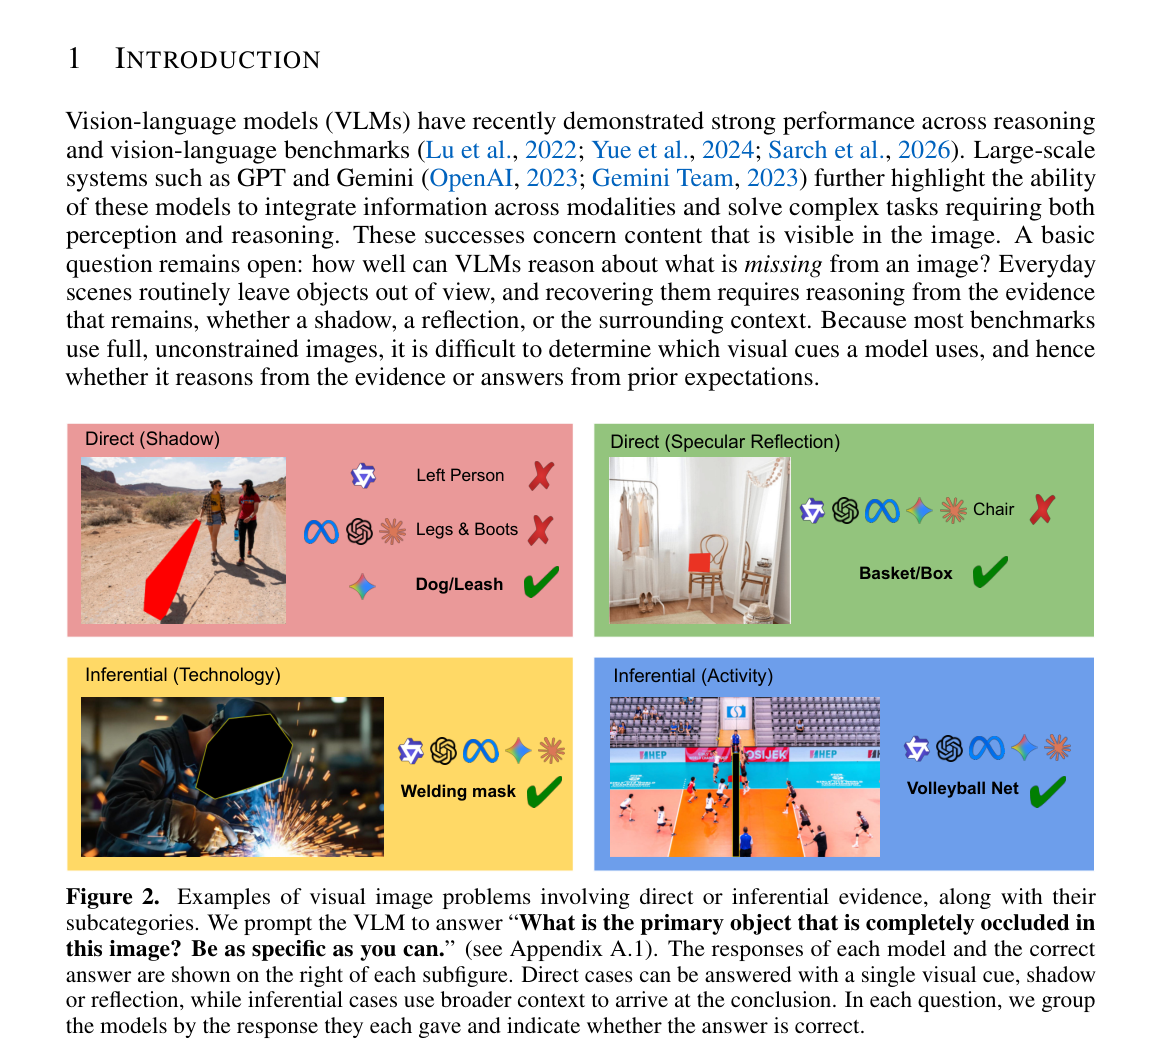
图2给四类样例。Direct Shadow:沙漠路人影,正解 Dog/Leash,多数模型答成 Left Person 或 Legs & Boots。Direct Specular:镜中反射,正解 Basket/Box,五模型都答 Chair。Inferential Technology:焊接火花场景遮住头部,全员答对 Welding mask。Inferential Activity:排球场遮住中线,全员答对 Volleyball Net。提示句为尽可能具体地说出完全被遮挡的主要物体。
失败定位
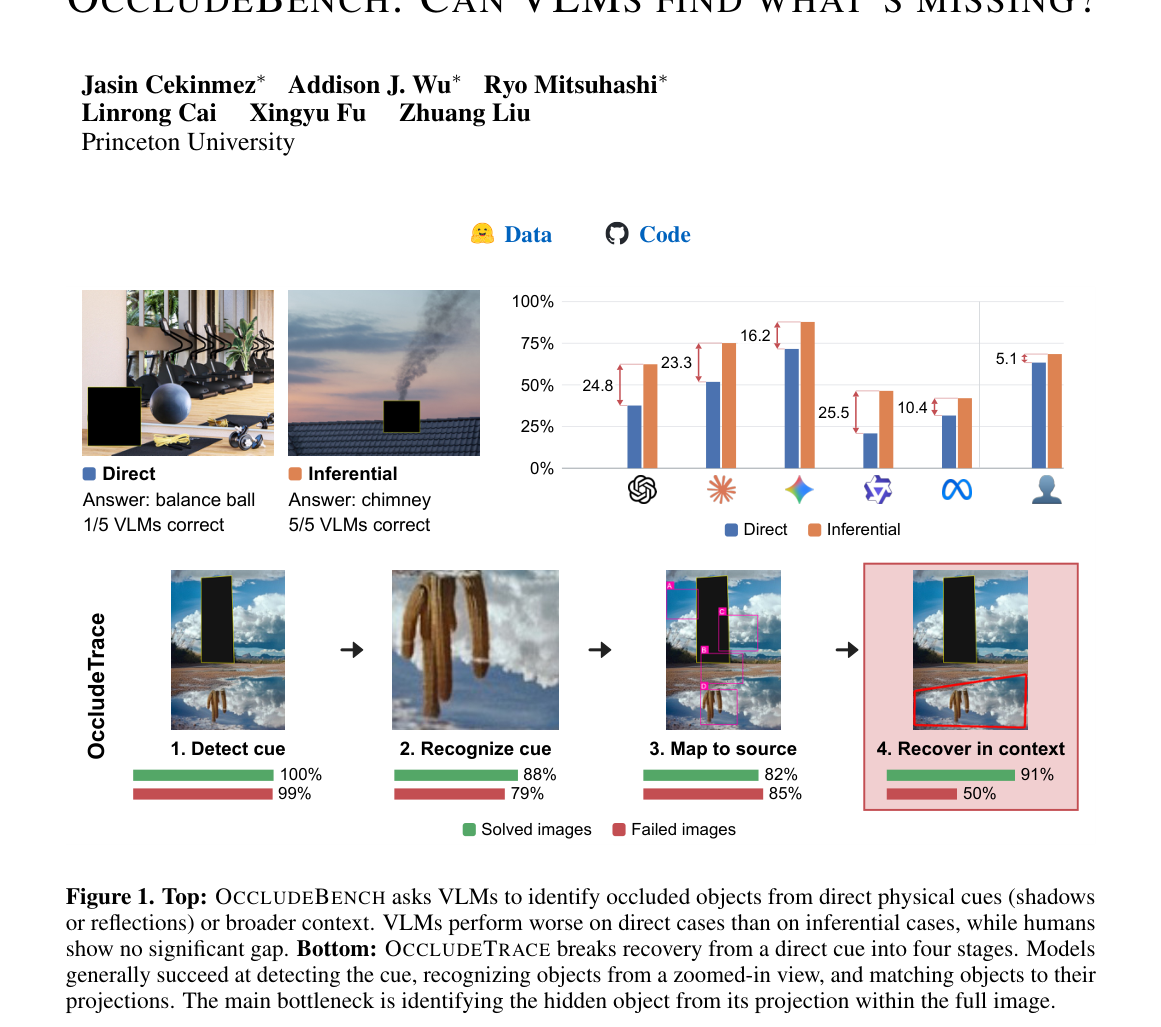
图1宜作特色图。上左直接例:健身房地面圆形阴影,遮挡物为 balance ball,仅 1/5 模型答对;推断例:屋顶黑块上方冒烟,答案 chimney,5/5 答对。上右柱状图给出五模型与人类的直接(蓝)/推断(橙)准确率及差距标签 24.8、23.3、16.2、25.5、10.4,人类差距仅 5.1。下栏 OccludeTrace 四阶段:检测约 100%/99%,识别 88%/79%,映射 82%/85%,情境恢复 91%/50%,绿为答对组、红为答错组。
Figure 3
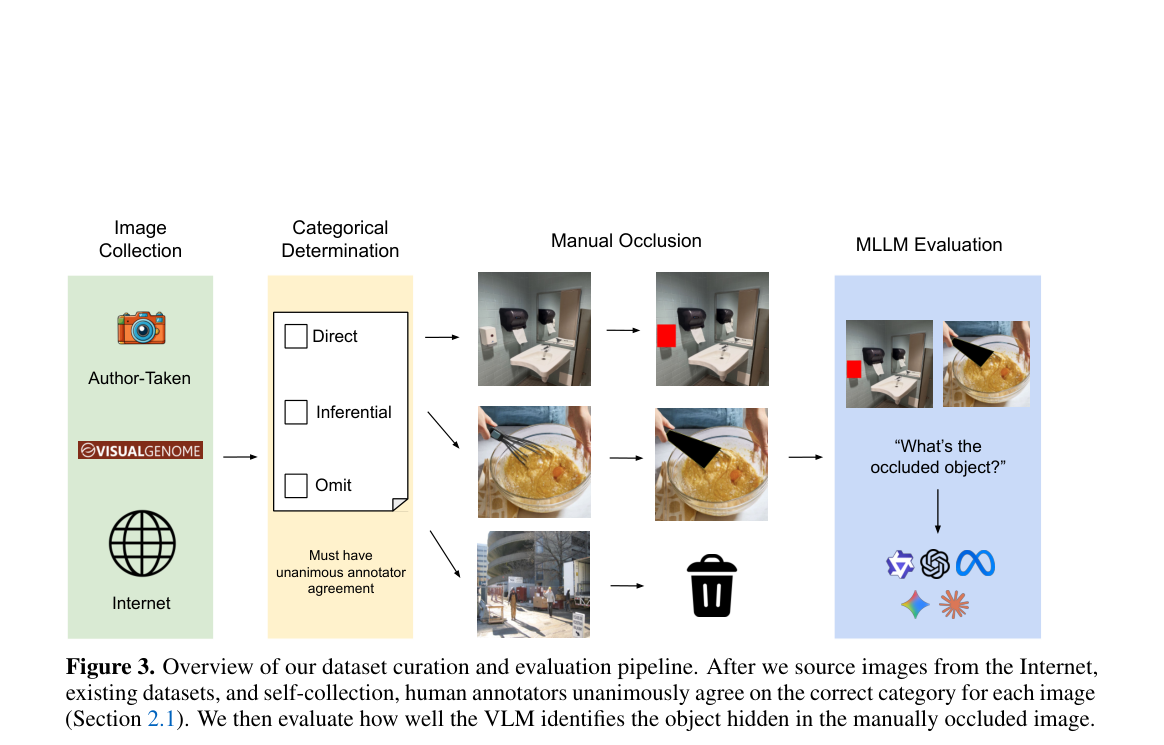
图3是数据与评测流水线。左列从作者实拍、Visual Genome、互联网收集;中列人工一致判定 Direct / Inferential,否则 Omit;再对目标做红框或黑多边形人工遮挡;右列把遮挡图送给多个 MLLM,问 What's the occluded object。底部展示洗手台皂液器被红方块盖住、搅拌器被黑多边形盖住等例子。
实验如何设计?
- 主表报告每模型直接/推断准确率与差距。难度分析把逐图人类准确率分箱,观察与模型均分的相关。OccludeTrace 在同一批直接题上按最终任务答对/答错分组报告四阶段准确率。
- 干预实验记录工具调用次数与类型,并另测 Codex/Claude Code 等更强 agent harness。inpaint 实验只在 GPT-5.4 与 Gemini 3.1 Pro 上报直接—推断差距与显著性。
关键结果与论文证据
- 五模型无一例外直接题低于推断题,差距从 Llama 的 10.4 到 Qwen3-VL-8B 的 25.5 不等;Gemini 总体最高(约 79.4%),但仍有 16.2 分差距。人类总体 65.9%,且直接/推断无显著差距。人觉得难的图模型也往往更难(r=0.44)。
- OccludeTrace 表明:模型几乎总能发现投影,也常能在裁剪视图中认出来,甚至能把投影映射回场景;失败集中在“投影仍嵌在全图里时恢复物体”——答错组仅 50%,答对组 91%。也就是说,瓶颈不是完全看不见线索,而是不会在完整场景中稳定使用它。
- 引导提示能抬高直接题,但到不了推断水平;少样本有时靠牺牲推断准确率缩小差距。工具调用更多也不等于更准。相对地,inpaint-then-confront 把 GPT-5.4 差距从 24.8 收到 8.1(p=0.12),Gemini 从 16.2 收到 5.6(p=0.15),说明一旦假设被外化为可检查的视觉候选,模型更能利用直接物理证据。
阅读时需要注意
- 人工遮挡提高了因果清晰度,却不等于自然遮挡分布。LLM judge 与生成式干预都引入额外模型依赖。378 张规模对细分子类仍偏紧。
- 作者强调:失败常不是“感知不到”,而是“抽不出并用不了该用的证据”。这限定了结论边界——提升可能来自更好的假设外化与检验,而不只是加长思维链。
关联工作
- Amodal completion 与部分遮挡工作关注残缺可见或语义补全;物理常识基准很少要求读投影。去阴影/去反射文献把投影当干扰,本文反向征用它们。
- 常识 VQA 更接近推断路径。OccludeBench 的贡献是把“缺失内容推理”做成可拆解、可干预的受控诊断,而不是又一个混合难度排行榜。