快速导读:SpatialASM 提出了一种通过训练时空间模拟将主动空间心智化(ASM)内化到大型视觉语言模型(LVLMs)中的可扩展框架,利用自心参考新视角生成器(NVG)和几何扰动(GeoP)过滤机制,生成显式推理轨迹用于 SFT 和可验证视角任务用于 RL,从而在多个空间推理基准上显著提升性能。
当前大型视觉语言模型(LVLMs)在处理涉及视角转换和未观测区域推理的空间任务时表现不佳,主要缺乏主动空间心智化(ASM)能力。SpatialASM 提出了一种通过训练时空间模拟将 ASM 内化到 LVLMs 中的可扩展框架,旨在解决这一核心问题。
该框架利用自心参考新视角生成器(NVG)和几何扰动(GeoP)过滤机制,生成显式推理轨迹用于 SFT 和可验证视角任务用于 RL。通过在训练阶段引入空间模拟,模型能够学习内部想象而非依赖外部观测,从而在多个空间推理基准上显著提升性能。
英文题目:SpatialASM: Internalizing Active Mentalization for Spatial Reasoning
论文出处:arXiv 每日论文精选 · arXiv:2610.13832
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有数据驱动方法主要提供仅答案的监督,缺乏展示如何规划视角和想象观测的 CoT 轨迹。例如,HoliSpatial 提供大规模空间 QA 数据,但主要为仅答案监督,无法引导模型学习推理过程。
推理时引入外部世界模型虽能提供视觉证据,但增加了推理时间且依赖外部模拟器。MindJourney 使用视频生成模型在推理时合成自心参考运动下的观测,属于外部世界模型辅助方法,存在冗余观测和慢推理的问题。
World2VLM 在训练时使用世界模型蒸馏运动条件视角关联,但轨迹独立于问题且无推理痕迹。APC 构建 3D 场景抽象并重投影到指定视角,属于视角想象研究,但缺乏主动规划能力。
GeoThinker 在特征检索层面内化主动推理,选择性查询几何特征,但需要架构特定的融合模块,限制了其通用性。
核心创新
- 提出 Active Spatial Mentalization (ASM) 概念,将其定义为主动规划视角和想象对应观测的联合能力。
- 设计 Allocentric Novel-View Generator (NVG),通过单步查询目标视角位置与方向,避免自心参考动作序列的多步 rollout。
- 引入 Geometry Perturbation (GeoP) 指标,通过测量渲染视图对 3D 重建的扰动来评估几何一致性,用于数据过滤。
- 构建两阶段后训练策略:SFT 使用合成的 ASM 轨迹(文本化想象观测),RL 使用自动生成的视角定位与选择任务。
方法概览
SpatialASM 使用自心参考新视角生成器(NVG)作为训练时空间模拟器。首先,微调图像编辑模型以根据查询视角渲染场景,并引入 GeoP 指标评估几何一致性。其次,合成显式 ASM 轨迹用于 SFT,其中 LVLM 规划视角,NVG 渲染视图,随后将渲染视图替换为文本描述,使模型学习内部想象而非接收观测。最后,构建自动可验证的视角任务用于 GRPO 强化学习,增强视角条件场景想象能力。
- SpatialASM 使用自心参考新视角生成器(NVG)作为训练时空间模拟器。NVG 基于图像编辑模型微调,根据查询视角直接渲染场景,避免自心参考动作序列的多步 rollout。
- 引入 GeoP 指标评估几何一致性。GeoP 通过测量渲染视图对原始观测 3D 重建的扰动程度,用于数据过滤,确保生成视图的几何准确性。
- 合成显式 ASM 轨迹用于 SFT。LVLM 规划视角,NVG 渲染视图,随后将渲染视图替换为文本描述,使模型学习内部想象而非接收观测。
- 构建自动可验证的视角任务用于 GRPO 强化学习。通过 GeoP 过滤候选视图,构造视角定位与选择任务,增强视角条件场景想象能力。
- 两阶段后训练策略:SFT 使用合成的 ASM 轨迹(文本化想象观测),RL 使用自动生成的视角定位与选择任务。
- NVG 基于 FLUX.2-Klein-9B 微调,通过位姿变换与标记点提示进入模型,MSE 对齐真值,确保渲染质量。
逐图理解论文
失败案例
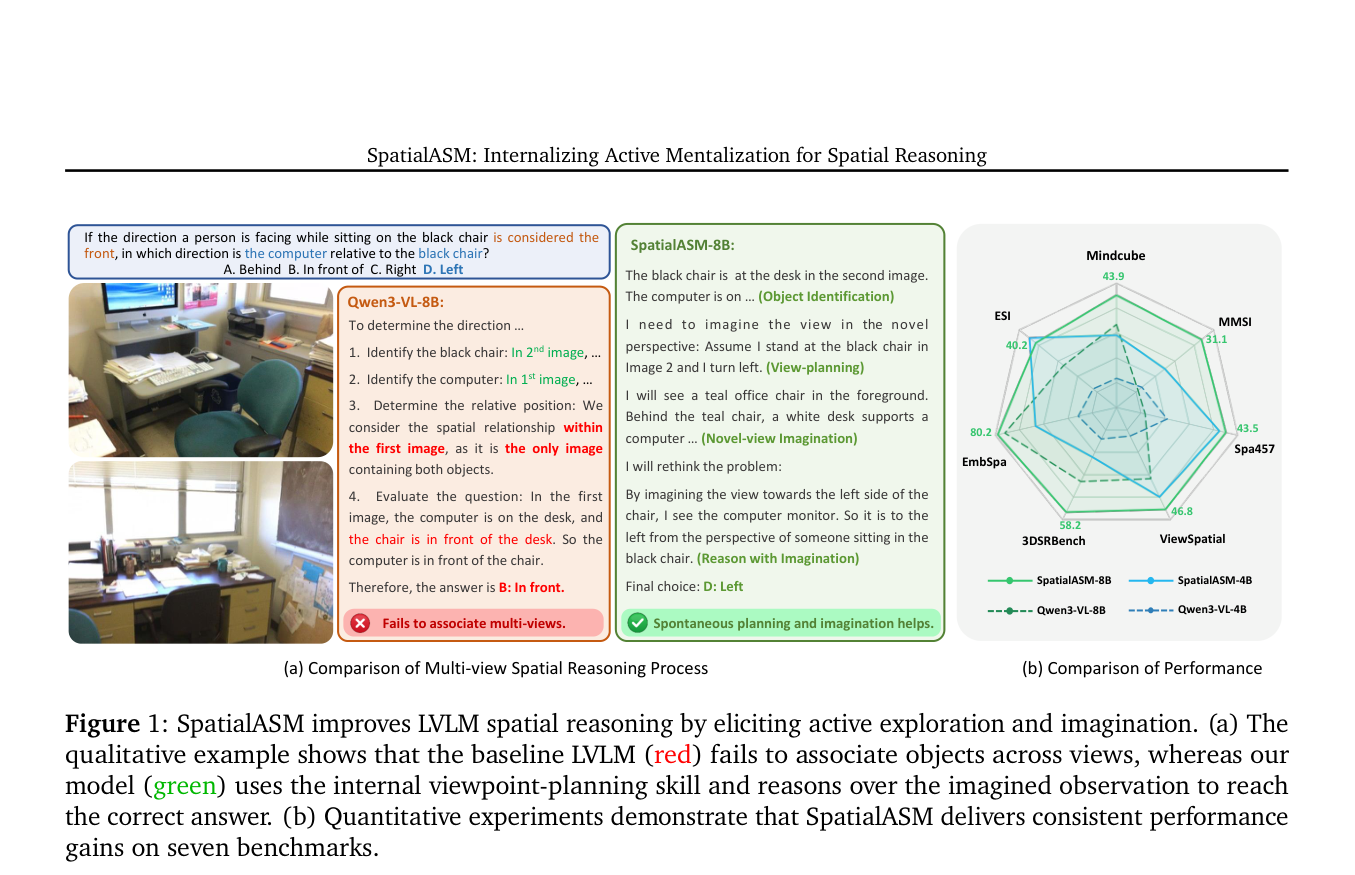
该图展示了 SpatialASM 如何通过激发主动探索和想象来改进 LVLM 的空间推理。左栏的定性示例显示基线 LVLM 无法跨视图关联对象,而 SpatialASM 使用内部视角规划技能并基于想象观测进行推理。右栏的雷达图展示了 SpatialASM 在七个基准上的一致性能提升。
研究缺口
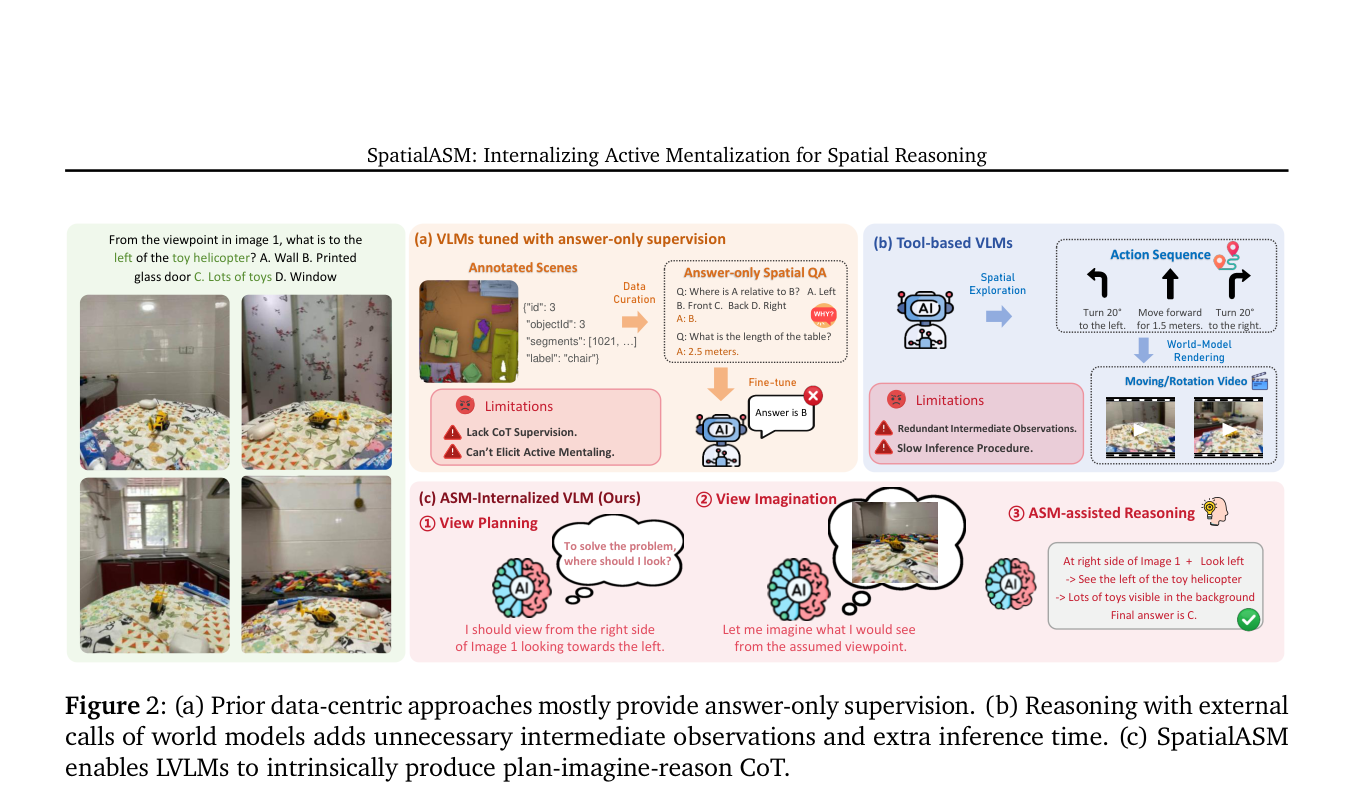
该图对比了三种范式:(a) 现有数据驱动方法主要提供仅答案监督;(b) 推理时调用外部世界模型增加不必要的中间观测和推理时间;(c) SpatialASM 使 LVLMs 能够内在产生 plan-imagine-reason CoT。
核心贡献
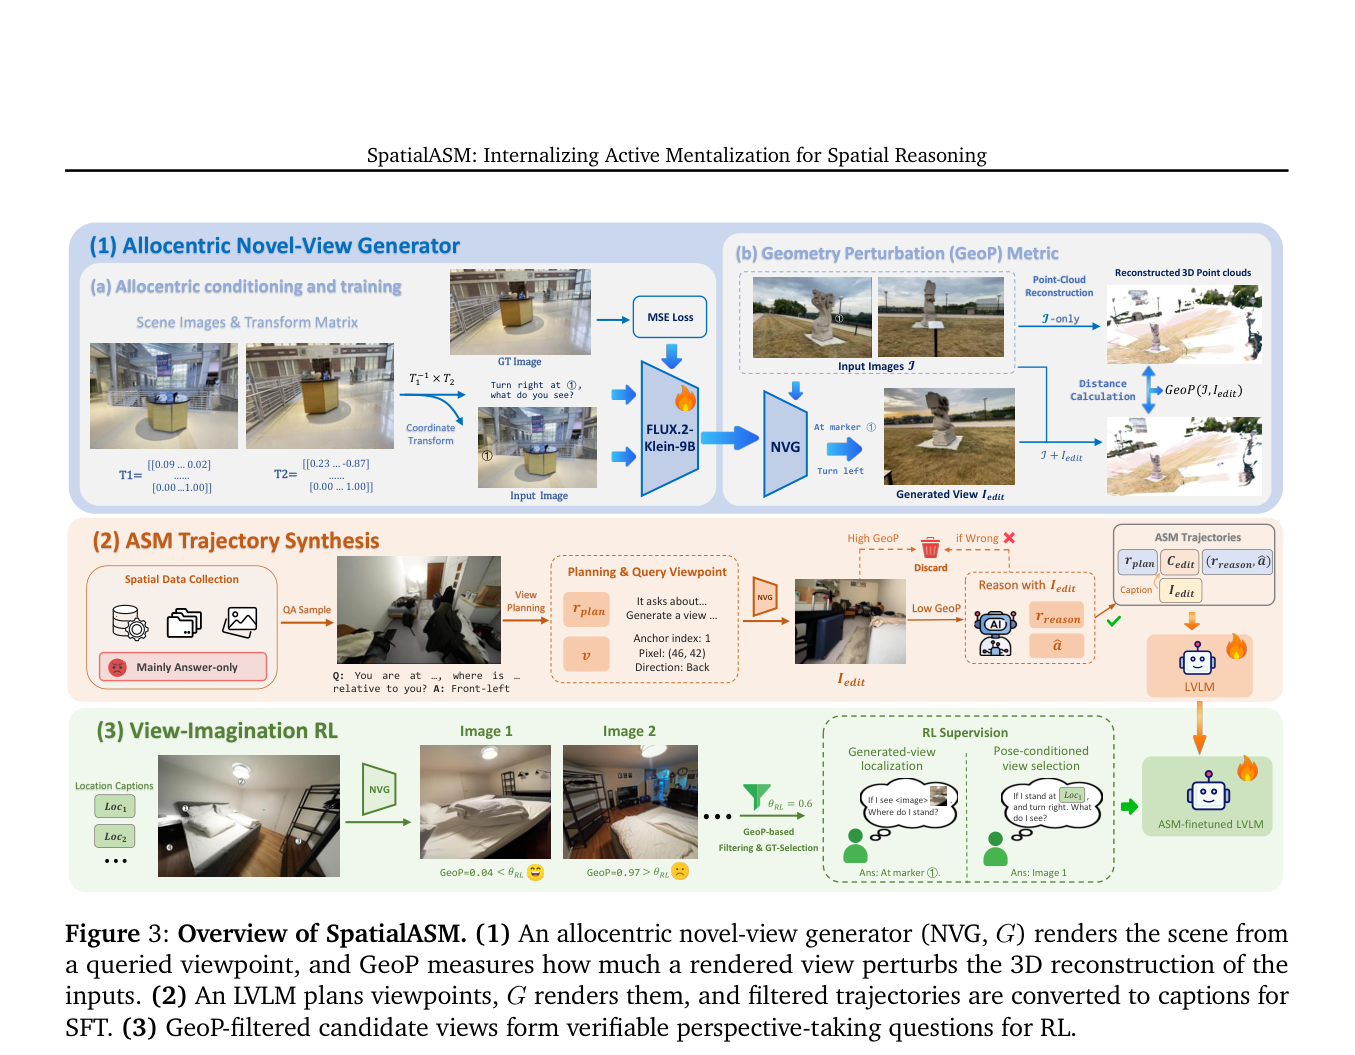
该图概述了 SpatialASM 的三个主要组件:(1) 自心参考新视角生成器(NVG)渲染场景,GeoP 评估几何一致性;(2) LVLM 规划视角,NVG 渲染视图,过滤后的轨迹转换为字幕用于 SFT;(3) GeoP 过滤的候选视图形成可验证的视角任务用于 RL。
实验验证
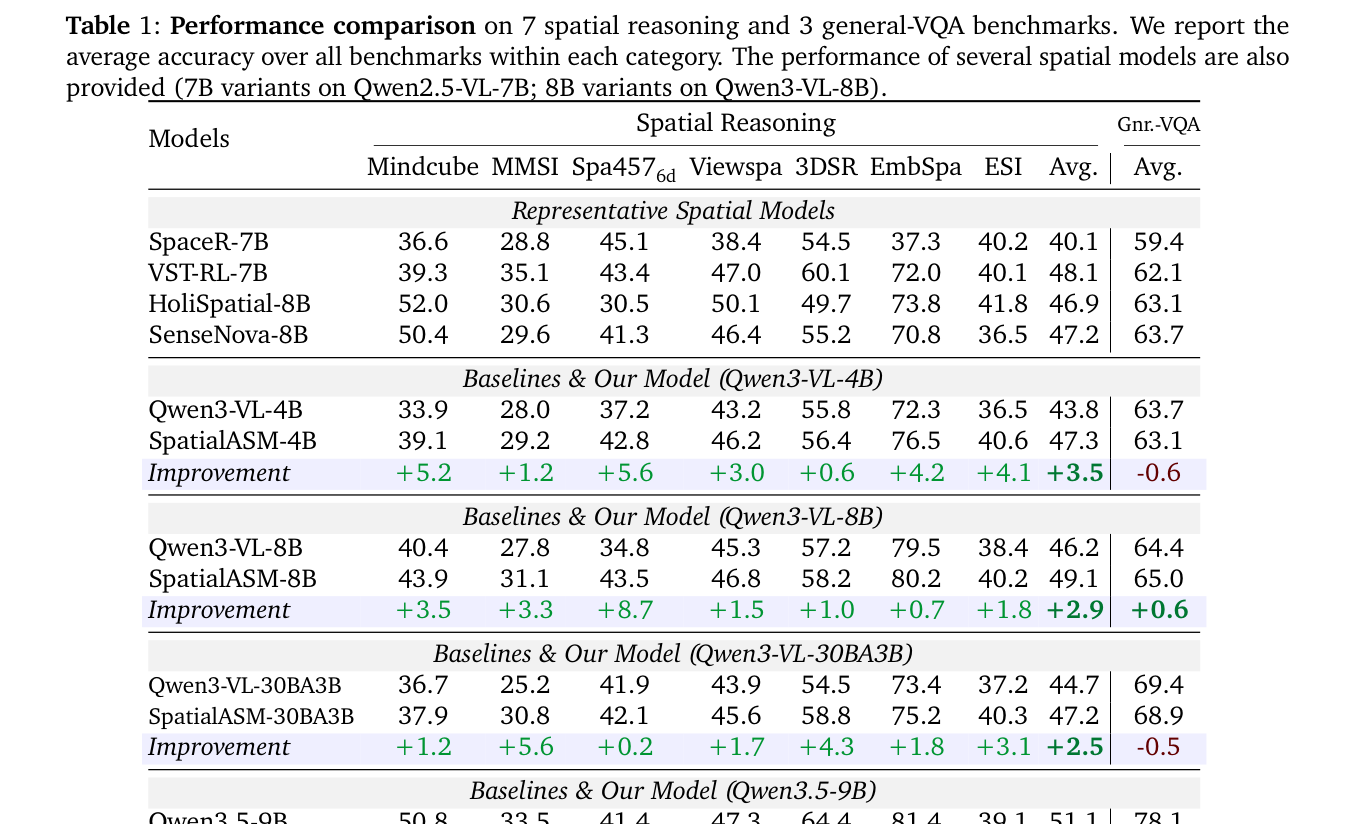
在多个空间推理基准上,SpatialASM 显著提升了性能,同时保持了通用 VQA 能力。
实验如何设计?
- 在 7 个空间推理基准和 3 个通用 VQA 基准上评估 Qwen3-VL 和 Qwen3.5 系列四个不同规模的 backbone。
- 对比 Vanilla、外部 ASM(随机规划、VLM 规划)和内部化 ASM 的性能与推理时间。
- 消融实验分析不同新视角生成器、GeoP 过滤策略以及 SFT 与 RL 阶段的独立贡献。
- 使用 SpatialASM-NVG 在外部 ASM 范式下评估不同规划策略的效果。
关键结果与论文证据
- Qwen3-VL-4B 在 7 个空间基准上平均准确率提升 +3.5%,其中 MindCube +5.2%,Spatial457 +5.6%(Page 8)。
- Qwen3-VL-8B 在 7 个空间基准上平均准确率提升 +2.9%,其中 Spatial457-6d 提升 +8.7%(Page 8)。
- 通用 VQA 性能在所有四个 backbone 上保持在基线 0.6 点以内(Page 8)。
- SpatialASM-NVG 在外部 ASM 范式下,Qwen3-VL-8B 在 MindCube Among 子任务准确率达 55.5%,Around 子任务达 70.5%(Page 10)。
- 结合 SFT 和 RL 的 SpatialASM-4B 在四个 SR 基准上平均准确率达 50.6%,优于单独 SFT (49.9%) 或 RL (48.8%)(Page 10)。
- 外部 ASM 并不总是有益的,引入冗余视觉证据或不必要的规划 CoT 可能导致性能下降(Page 9)。
阅读时需要注意
- GeoP 指标依赖于预训练的 3D 重建模型 F,是几何一致性的代理指标而非地面真值。
- 目前主要评估静态场景,未涉及动态真实世界场景或具身交互。
- NVG 基于图像编辑模型微调,可能受限于图像编辑模型本身的生成质量。
关联工作
- HoliSpatial:数据合成方法,提供大规模空间 QA 数据,但主要为仅答案监督。
- VST:数据引擎,使用模拟器生成新观测,VST-R 提供逐步推理轨迹但侧重于从给定证据推导结论。
- MindJourney:使用视频生成模型在推理时合成自心参考运动下的观测,属于外部世界模型辅助方法。
- World2VLM:在训练时使用世界模型蒸馏运动条件视角关联,但轨迹独立于问题且无推理痕迹。
- APC:无训练流水线,构建 3D 场景抽象并重投影到指定视角,属于视角想象研究。
- GeoThinker:在特征检索层面内化主动推理,选择性查询几何特征,但需要架构特定的融合模块。