快速导读:SimVTA 用 World Engine 沿当前策略候选轨迹渲染匹配未来视频,把轨迹 GRPO 与高误差视频监督接到共享表征上,弥补驾驶日志只覆盖已记录动作的缺口。
驾驶世界动作模型(WAM)一边预测未来画面,一边给出自车轨迹。强化学习能让策略在演示之外探索更高奖励的候选路径,但驾驶日志里只有已记录动作对应的未来视频:候选转弯、日志继续直行时,复用日志视频会得到错误的轨迹–视频对,去掉视频监督又让候选动作失去视觉后果。SimVTA(arXiv:2610.13781;上海创智学院、香港大学 OpenDriveLab、理想汽车、同济大学、清华大学)用 World Engine 在 3DGS 重建的真实场景里,沿当前策略的高奖励候选路径渲染匹配未来视频,把轨迹 GRPO 与流匹配视频损失接到共享表征上。项目页 https://opendrivelab.com/SimVTA/ ,代码 https://github.com/OpenDriveLab/SimVTA 。
从适配到 NAVSIM 的 Epona 初始化出发,后训练后 NAVSIM v1 的 PDMS 从 86.2 升到 91.3(+5.1),NAVSIM v2 的 EPDMS 为 88.2,HUGSIM 平均 HD-Score 为 38.8。消融表明:视频梯度必须更新共享编码器,规划才会明显受益;在高奖励渲染池里优先监督高误差子集 Q2,比扩大监督范围或加倍渲染预算更有效。推理只从观测预测轨迹,不调用仿真器、不生成视频。预印本尚未同行评审。
英文题目:SimVTA: Simulation-Grounded Video-Trajectory Alignment for Driving World Action Models
论文出处:arXiv 每日论文精选 · arXiv:2610.13781
原始论文:PDF / 论文页面
这篇论文解决什么问题?
WAM 预训练通常用地面真值轨迹与其日志未来视频成对监督。近期设定常在训练时保留视频预测、推理时只出轨迹,以节省生成开销。强化学习进一步用驾驶奖励比较候选轨迹,鼓励偏离演示的更高奖励动作。
缺口在于:日志只保存记录动作的未来画面。候选动作一旦偏离记录路径,就没有与之匹配、且独立于模型自身预测的视觉真值。模型自己的视频预测也不能当外部参照。于是后训练出现监督空缺——当前策略轨迹缺少匹配的未来视频目标,如图1所示。
核心创新
- 把策略采样、轨迹执行、3DGS 渲染与联合更新连成仿真接地的后训练框架,为日志之外的动作提供匹配视觉后果。
- 按轨迹奖励与视频预测误差选择监督目标,优先高奖励且高误差的未来,同时不限制轨迹探索。
- 让视频梯度更新共享编码器,使规划表征吃到匹配视频监督,推理仍直接出轨迹。
方法概览
从观测历史得到共享表征 F,轨迹策略用 Flow-GRPO 的 SDE 采样生成 G 条候选;NAVSIM 的 PDM 执行器把候选变成执行路径并算奖励,全部候选都可进入轨迹学习。渲染前检查执行有效性、运动条件支持与安全,再按奖励排序,在预算 K 内用 World Engine 沿最高奖励路径渲染未来视频,视频网络沿同一路径做预测。目标选择先按奖励挑渲染对象,再在已渲染集合里保留教师强制潜空间误差不低于均值的高误差子集 Q2,对其做 flow-matching 视频损失;视频误差不进入轨迹优势。总损失为轨迹 GRPO、选中视频损失与教师 TrajDiT 的行为克隆正则。训练中在线渲染以跟随策略分布变化。推理只从观测预测轨迹,不调用仿真器、不生成视频、不做视频重排序。
- 框架把策略采样、轨迹执行、3DGS 渲染与联合更新串成闭环。给定观测历史 o,共享编码器 hθ 得到表征 F;轨迹策略 πψ 用 Flow-GRPO 的 SDE 采样生成 G 条候选。NAVSIM 的 PDM 执行器把候选变成执行路径并算奖励 Ri,全部候选都可进入轨迹学习。
- 渲染前检查执行有效性、运动条件支持与安全,再按奖励排序,在预算 K 内用 World Engine 沿最高奖励路径渲染未来视频;视频网络沿同一路径做预测。教师强制流匹配在噪声与渲染潜变量之间学习速度场,视频损失同时更新视频网络与共享编码器。
- 目标选择分两步:先按轨迹奖励挑渲染对象,再在已渲染集合里保留教师强制潜空间误差不低于组内均值的高误差子集,记为 Q2,对其做视频损失。视频误差不进入轨迹优势。总损失为轨迹 GRPO、选中视频损失与冻结教师 TrajDiT 的行为克隆正则。训练中在线渲染以跟随策略分布变化;离线缓存只覆盖优化前采样的路径。推理直接出轨迹。
逐图理解论文
监督缺口
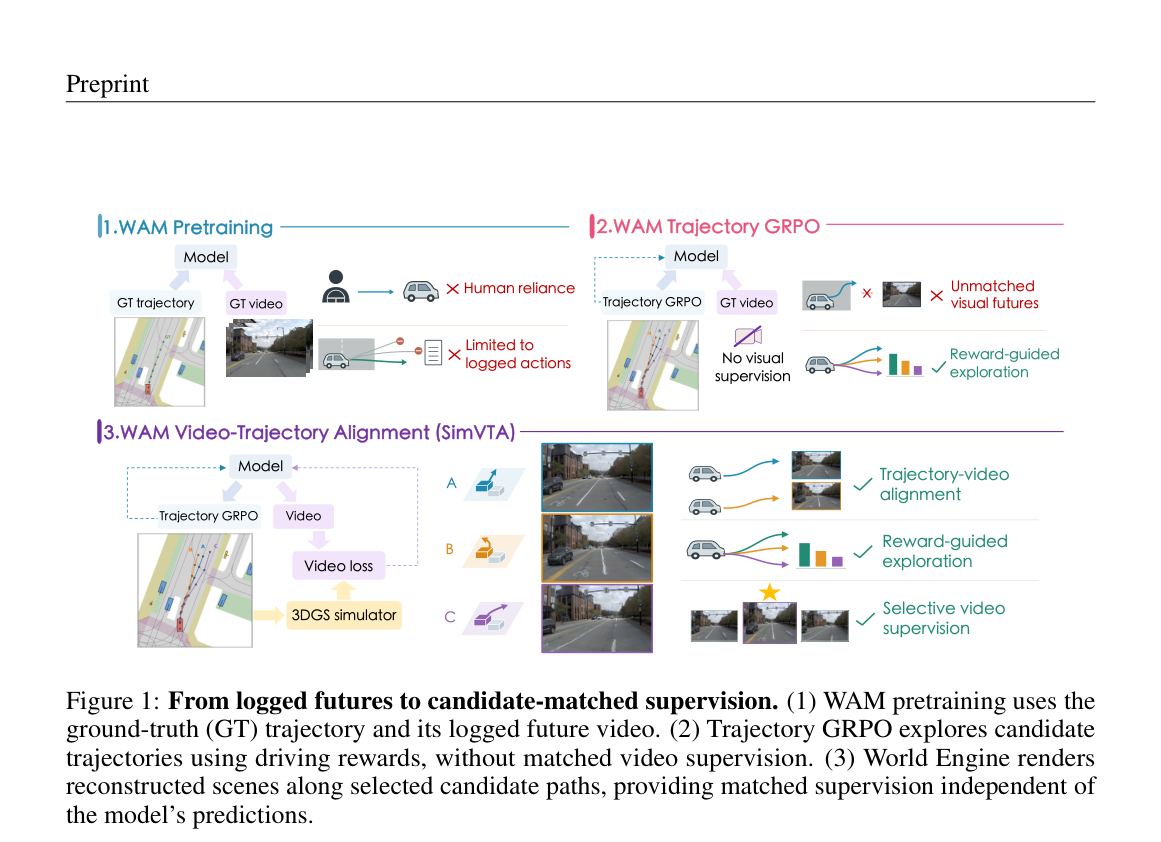
图1对比三种监督设定,宜作问题直觉图。上左 (1) WAM Pretraining:GT trajectory(BEV 红车绿路径)与 GT video(街景实拍)成对,右侧红叉标 Human reliance 与 Limited to logged actions。上右 (2) WAM Trajectory GRPO:多色候选路径进入 Trajectory GRPO,绿勾 Reward-guided exploration,但 GT video 仍只对应一条路径,红叉 Unmatched visual futures 与 No visual supervision。下栏 (3) SimVTA:Trajectory GRPO 与 Video 分支并行,3DGS simulator 沿候选 A/B/C 渲染匹配画面,绿勾 Trajectory-video alignment、Reward-guided exploration 与 Selective video supervision。图注强调 World Engine 提供独立于模型预测的匹配监督。
仿真对齐
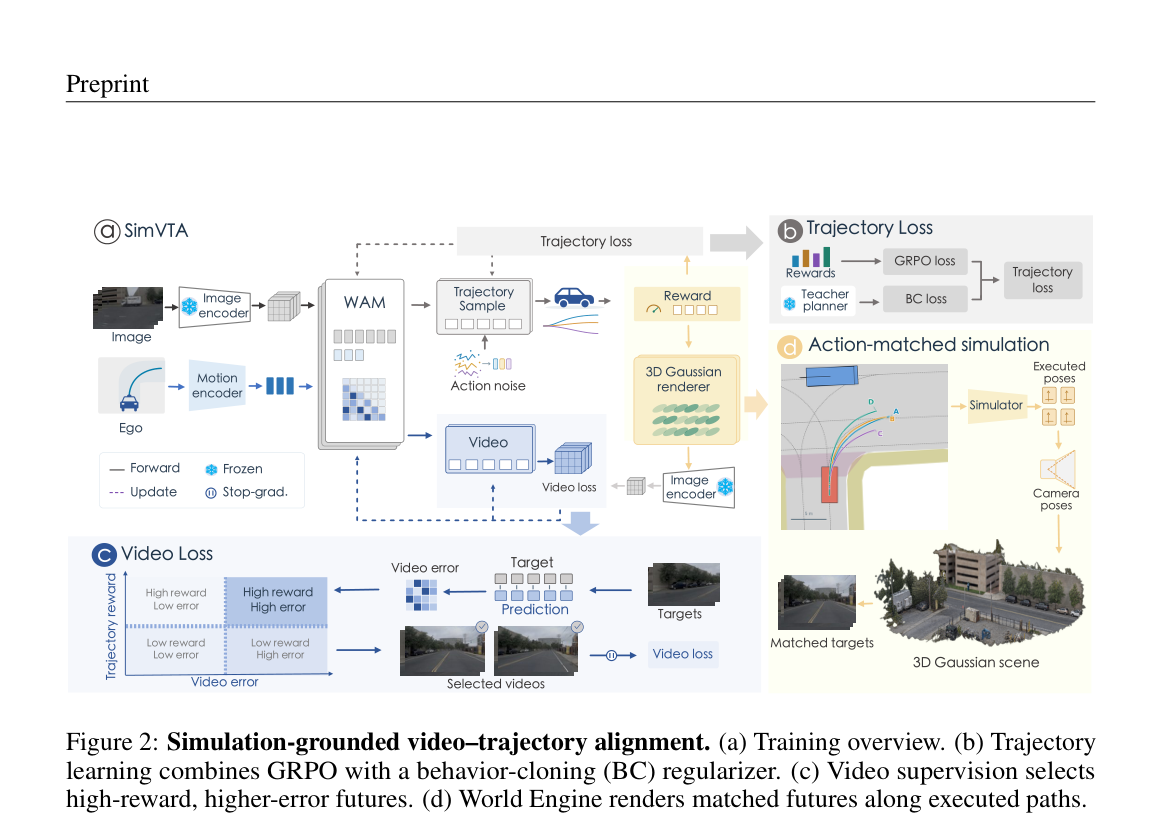
图2是方法总览,宜作特色结构图。(a) Image 经冻结 Image encoder、Ego 经 Motion encoder 进入 WAM;Trajectory Sample 加 Action noise 出候选,Video 出预测;3D Gaussian renderer 提供目标,Trajectory loss 与 Video loss 回传。(b) GRPO loss(Rewards)与 BC loss(Teacher planner)合成 Trajectory loss。(c) 奖励–误差四象限,高亮 High reward / High error,Selected videos 进 Video loss,旁有 stop-grad。(d) 交叉口候选 A–D 经 Simulator 得 Executed poses / Camera poses,再从 3D Gaussian scene 渲染 Matched targets。
关键证据
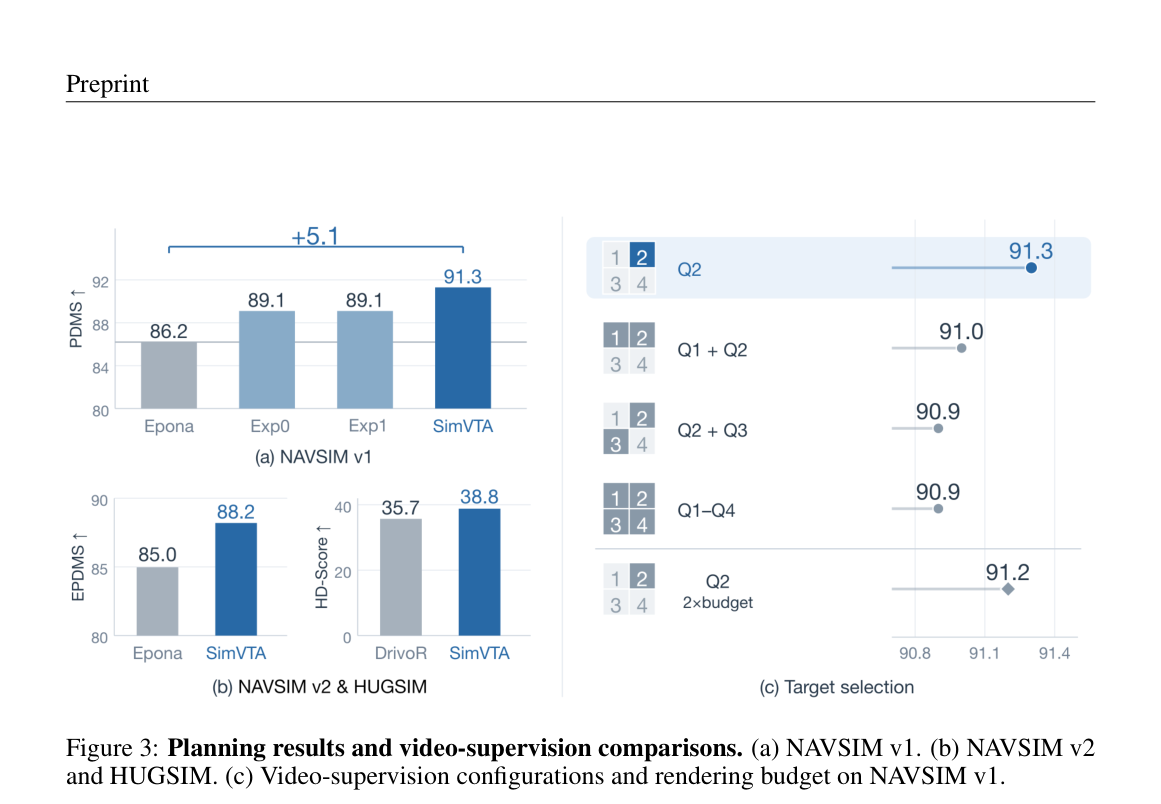
图3汇总规划与目标选择。(a) NAVSIM v1 PDMS:Epona 86.2,Exp0/Exp1 均为 89.1,SimVTA 91.3,括号标 +5.1。(b) NAVSIM v2 EPDMS:Epona 85.0→SimVTA 88.2;HUGSIM HD-Score:DrivoR 35.7→SimVTA 38.8。(c) 目标选择点图:Q2 91.3 最高;Q1+Q2 91.0;Q2+Q3 与 Q1–Q4 均为 90.9;Q2 2× budget 91.2。完整表格数字以正文 Table 1/2/3/5/6 为准。
结论与局限
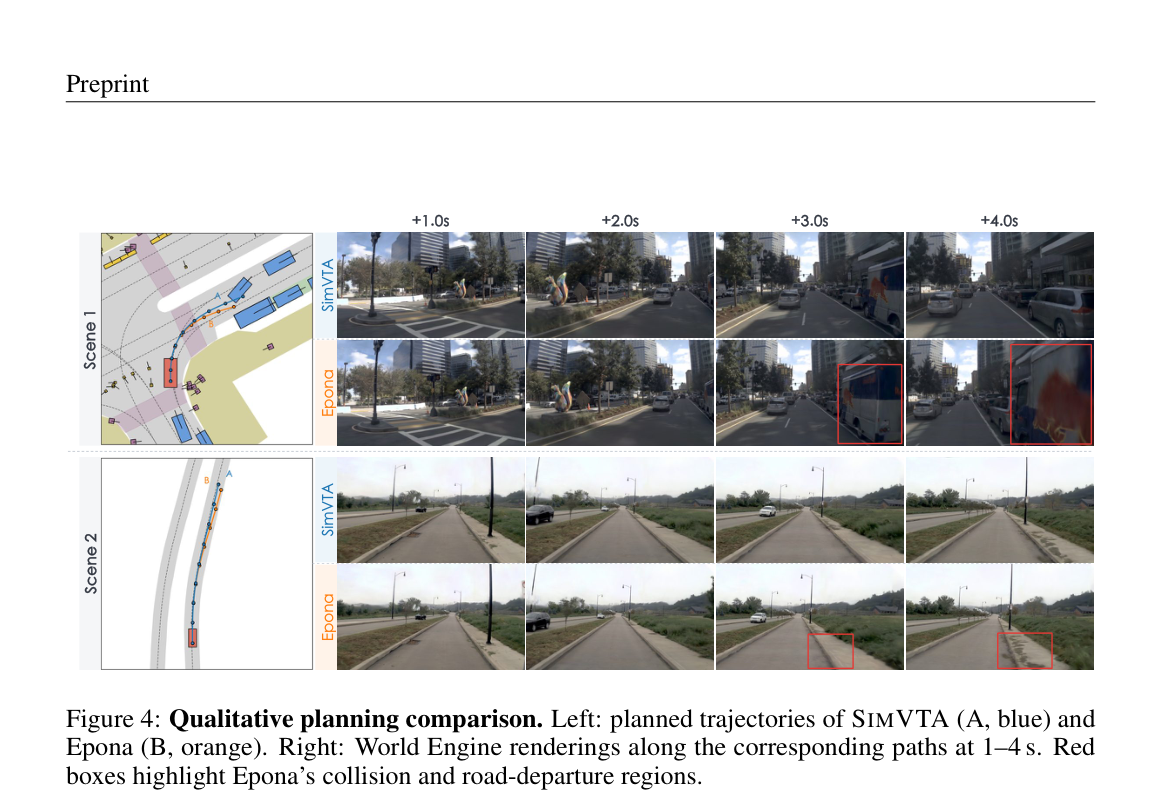
图4是定性规划对照。左列 BEV:SimVTA 路径 A(蓝)、Epona 路径 B(橙),红框为自车、蓝框为他车。Scene 1 路口右转:Epona 在 +3.0s/+4.0s 的 World Engine 渲染中撞上右侧卡车(红框标 collision);SimVTA 同序列保持通畅。Scene 2 弯道循迹:Epona 在 +3.0s/+4.0s 驶出沥青到草地(红框标 road departure);SimVTA 保持车道居中。右侧渲染仅展示规划路径视觉后果,推理本身不调用仿真器。
实验如何设计?
- 从适配到 NAVSIM 的 Epona 检查点初始化,在有 World Engine 场景重建的 NavTrain 样本上后训练。主设定 Exp2:Q2 视频目标,视频损失更新 VideoDiT 与共享编码器;消融均保留轨迹 GRPO 与 BC 正则。
- NAVSIM v1 NavTest 报 PDMS 及 NC/DAC/TTC/Comfort/EP;v2 报 EPDMS 及分项;HUGSIM 345 条预挑战场景报 RC 与 HD-Score,评测器与控制器与 Driving on Registers 一致。结果为三随机种子平均。
- 消融覆盖共享编码器是否接收视频梯度、Q1–Q4 目标选择、视频 GRPO 对比、在线与离线渲染、打乱轨迹–视频对应、加倍渲染预算。视频质量用 FID/FVD 对比 World Engine 渲染、仅轨迹 GRPO 与完整 SimVTA 的预测。
关键结果与论文证据
- Table 1 / 图3(a):Epona 86.2 PDMS,SimVTA 91.3(+5.1);EP 80.3→86.7,TTC 93.9→97.0,DAC 95.0→97.2。Table 2:Epona 85.0 EPDMS,SimVTA 88.2(+3.2),EP 90.8,DAC/TTC 均为 98.5。Table 3:平均 RC 51.5、HD-Score 38.8,高于 DrivoR 的 49.8 / 35.7;困难场景 RC 38.3、HD-Score 23.3。
- 共享编码器消融(Table 5):仅轨迹 GRPO 或视频梯度停在 VideoDiT 均为 89.1 PDMS,视频梯度进共享编码器到 91.3。目标选择(Table 6 / 图3(c)):Q2 为 91.3,Q1+Q2 为 91.0,Q2+Q3 与 Q1–Q4 均为 90.9;加倍预算为 91.2。打乱轨迹–视频对应后 PDMS 从 91.3 掉到 83.1;离线缓存 90.4,在线渲染 91.3。
- Table 4:World Engine FID 7.6 / FVD 21.8;仅轨迹 GRPO 预测 20.4 / 105.4,SimVTA 13.1 / 46.3。图4定性上,Epona 在路口右转碰撞卡车、在直道驶出可行驶区域,SimVTA 同场景保持安全路径;右侧 World Engine 渲染只用于展示规划路径的视觉后果。
阅读时需要注意
- 遮挡与位姿覆盖不足会降低偏离日志路径的渲染质量;渲染指标多在已记录视角上评估。高预测误差可能来自模型,也可能来自低质量仿真目标;教师强制选择抓不到自回归误差累积。
- 观测历史仍基于日志,渲染目标与真实图像有分布差;未评偏移观测历史与反应式交通。框架在 Epona 骨干上验证,迁到其他 WAM 结构留作未来工作;在线渲染增加训练成本。预印本未同行评审。
关联工作
- 驾驶世界模型联合未来帧与轨迹;SimWAM、Fast-WAM 等保留训练视频、推理省略生成。SimVTA 把这一设定接到驾驶后训练,并强调候选路径上的匹配视频监督。
- 3DGS 仿真器可沿指定相机位姿渲染重建场景。World Engine 提供真实场景上的仿真接地渲染;CausalDrive 等改用学习式渲染器。轨迹侧采用 Flow-GRPO 的 SDE 采样与 GRPO 组内相对优势。
- 评测用 NAVSIM 开环伪仿真与 HUGSIM 闭环 3DGS 驾驶。Table 1/2 中部分基线引自他文或按官方配方重评,跨方法数字不完全同设定。