快速导读:FAD-ViT 把全局混合改到特征轴并严格解耦空间提取,使同等 ImageNet 预训练在医学任务上带来显著更大的迁移增益。
把自然图像预训练的视觉骨干迁到医学影像,是当前很常见的路径,但域偏移、采集异构与标注稀缺仍常让迁移不稳定。标准视觉 Transformer 把全局建模压在空间 token 自注意力上,这很适合自然场景里的物体轮廓与布局,却不太贴合医学图像:病理信号往往表现为跨扫描仪仍可复现的特征相关与纹理,而精确布局随设备与协议变化。FAD-ViT(arXiv:2610.13012,University College Dublin)问的是:全局注意力究竟走空间轴还是特征轴,会不会本身就是医学迁移的设计杠杆。
作者给出严格轴解耦、通道优先的骨干:深度卷积只做局部空间提取,特征轴注意力做全局混合,并在二十三项分类、分割与低数据任务上用匹配协议评测。关键发现是——从头训练时换轴几乎不改变性能,但同等 ImageNet 预训练后,特征轴可把迁移增益放大到匹配容量空间骨干的约三倍,分割均值 Dice 也更高、参数更少。必须强调:这是研究方法与骨干设计评测,不是临床产品,不得外推为临床可用。代码见 https://github.com/aonsafdar/FAD-ViT 。
英文题目:Learning Features, Not Layouts: Feature-Axis Attention as a Transfer Prior for Medical Imaging
论文出处:arXiv 每日论文精选 · arXiv:2610.13012
原始论文:PDF / 论文页面
这篇论文解决什么问题?
医学影像分析越来越多采用“自然图像强编码器 + 下游适配”的基础模型管线,但迁移质量并不稳定。空间自注意力同时被要求提取局部结构与做全局混合,既缺少强局部先验,又随 token 数二次膨胀;混合与分层骨干改善了效率,却仍把空间注意力当作全局主操作。
通道感知模型如 XCiT、DaViT 让特征轴动态起来,却通常只改混合轴,继续继承空间分词、点式投影与局部模块,两轴纠缠。这样一来,无法干净回答:若把全局交互真正放到通道 token 上,医学迁移会不会更好。FAD-ViT 的目标正是把这个问题变成可分离变量。
核心创新
- 把空间提取与全局混合严格分给深度卷积与特征轴注意力,使注意力轴成为可分离的实验变量。
- 证明通道优先解耦设计可作为医学迁移先验:同等 ImageNet 预训练带来更大下游增益。
- 在二十三项分类、分割与低数据探测上匹配协议评测,并用迁移差距与 CKA 解释为何纹理主导模态受益最大。
方法概览
FAD-ViT 是严格轴解耦、通道优先的骨干:SFE 用深度卷积只混空间不混通道并保持二维网格;FSA 把张量从 B×N×C 转置为 B×C×N,在通道 token 上做单头自注意力,全局交互随宽度 C 而非 token 数 N 缩放。Q/K/V 仅用深度投影,避免点式投影在注意力前预混通道。三级卷积分词层次递进下采样,低分辨率处可加轻量空间注意力尾;消融显示去掉尾部约损失 1 Dice,全局混合仍由特征轴主导。分割时各编码器共享同一 U-Net 解码器,在匹配容量、分词与协议下只改变全局混合轴。
- 块内分工明确。SFE 用深度卷积在高宽维提取局部特征并保持二维网格;随后 FSA 把 B×N×C 转置为 B×C×N,让每个通道 token 成为整图特征图描述子,再做单头特征自注意力,复杂度相对空间轴更随宽度而非分辨率二次爆炸。
- 严格解耦还体现在 Q/K/V:因为哪怕 1×1 点式投影也会预混通道,作者坚持深度投影,让通道相关只发生在注意力本身。这样特征轴才真正可度量。
- 骨干分三阶段卷积分词并扩通道,最后可在最低分辨率加短空间注意力尾。作者强调尾部只是轻量 refinement;去掉后约损失一 Dice,全局混合仍由特征轴完成。分割实验中所有编码器挂同一 U-Net,保证差异归因于编码器表示。
- 研究设计(图2)固定分词、容量、解码器、优化器与日程,只改变全局混合操作,比较空间轴、通道混合体与严格解耦特征轴,再用迁移差距、CKA、模态分组与多种子统计做归因。
逐图理解论文
问题症结
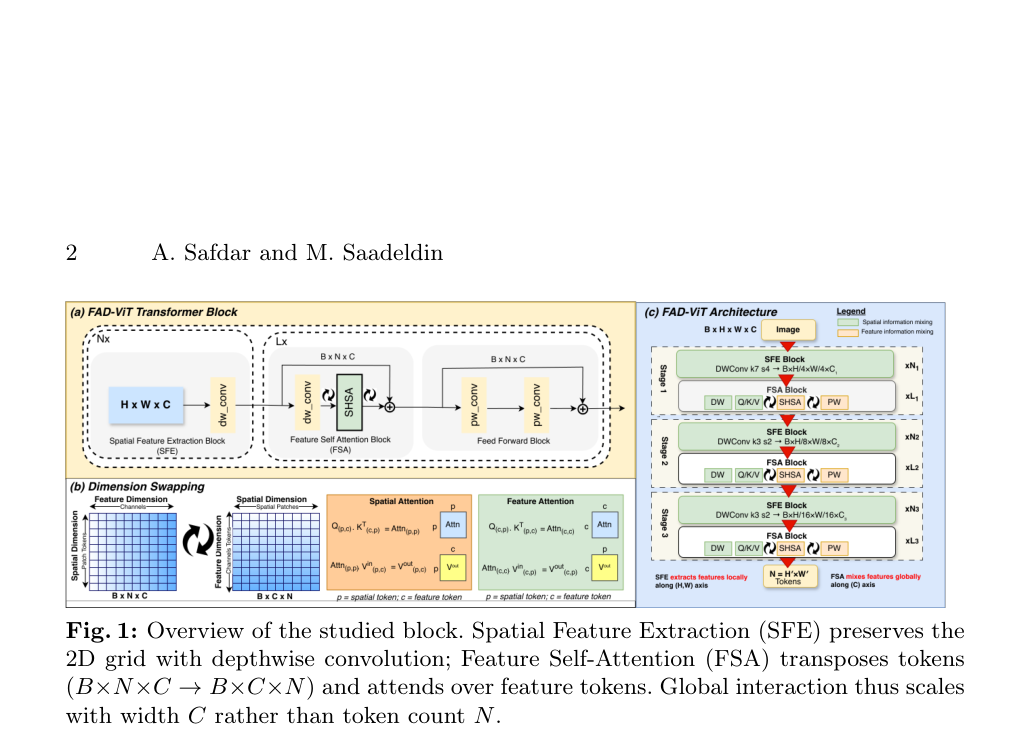
图1给出 FAD-ViT 块与整网。左侧块图可见 SFE 用深度卷积保网格,FSA 与前馈在通道侧混合;中部展示把 B×N×C 转成 B×C×N 后,注意力从空间的 p×p 变成特征的 c×c;右侧三级骨干用绿色标空间混合、橙色标特征混合。读图时应抓住“全局交互随宽度 C 而非 token 数 N 缩放”,这是后文效率与迁移叙事的结构起点。
评测设计
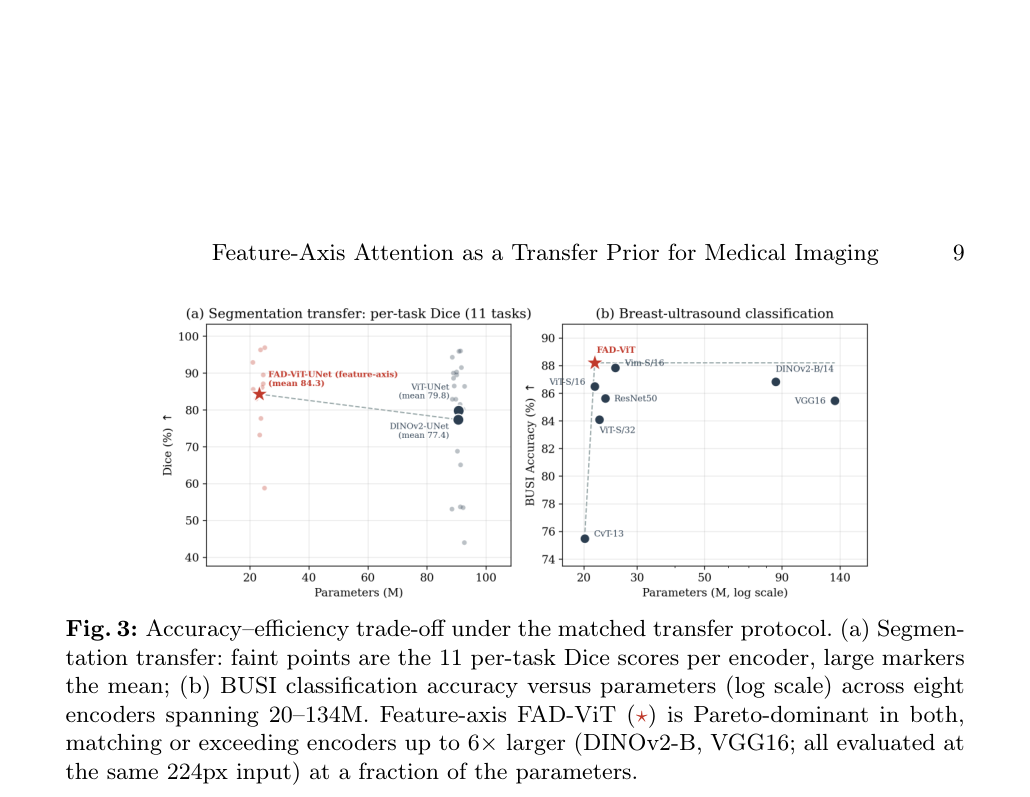
图3是匹配协议下的精度—效率权衡。(a)分割:淡点为十一项单任务 Dice,大标记为均值,FAD-ViT 星标约两千三百万参数、均值八十四点三,位于更大 ViT/DINOv2 左上方;(b)BUSI 分类准确率对参数对数坐标,FAD-ViT 再次处在高准确、低参数位置。适合用来讲 Pareto 优势,而不是单点刷榜。
关键证据
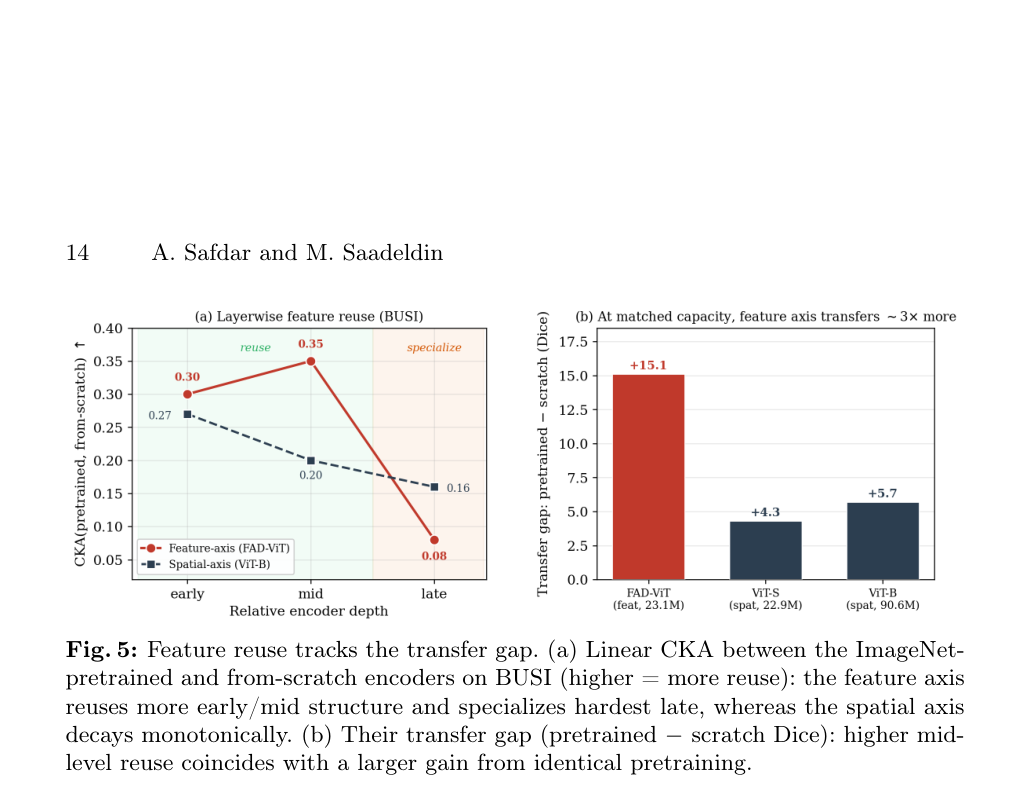
图5解释“为什么特征轴更会迁移”。(a)BUSI 上预训练与从头编码器的层间 CKA:特征轴早中层更高、末层骤降,像在复用通用通道结构后只重学任务顶层;空间轴则单调衰减。(b)匹配容量迁移差距柱状图:FAD-ViT 约十五点一,ViT-S 四点三,更大 ViT-B 五点七。可与“不是临床产品”一并提醒:这是研究指标,不是床旁性能。
实验如何设计?
- 共二十三项任务:十个 MedMNIST-2D 分类、BUSI 与数据集 B 超声分类、十一项分割(BUSI + MSD 二维切片),以及八个 MedMNIST 子集在百分之一、百分之十、百分之百标签下的线性探测。
- 输入分类多为二百二十四、分割为二百五十六;分类端到端微调,分割共享 U-Net,线性探测冻结骨干。报告 Accuracy/AUC、Dice/mIoU/HD95。
- 轴研究的核心对照是匹配容量空间 ViT,以及公开 ImageNet 权重的 XCiT 与 DaViT;另含 DINOv2、CvT、ResNet、VGG、Vim 等作为更广基线。
关键结果与论文证据
- 分类上,预训练后的 FAD-ViT 在 MedMNIST 多处于最好或次好,但差距不大;作者不把这些近饱和结果当主证据。更难的乳腺超声分类上,FAD-ViT 在 BUSI 与 B 上准确率领先,并以约两千一百万参数匹敌甚至超过更大的 DINOv2。
- 分割是主战场:FAD-ViT-UNet 在十一项中十项 Dice 最佳,均值八十四点三,对 ViT 七点九八、DINOv2 七点七四;相对 ViT 十一项全胜。超声增益最大,MRI 与 CT 更小但仍为正,符合“纹理而非几何主导时特征轴更有用”的假说。
- 与纠缠的通道模型比,三者在 BUSI 上都远超纯空间 ViT,FAD-ViT 以最少参数逼近最强耦合设计。说明收益主要来自共享的特征轴,而 FAD-ViT 是可归因、更省参数的端点。
- 迁移特异性分析更关键:匹配容量下,特征轴把 ImageNet 预训练变成约十五点一 Dice 的增益,空间 ViT-S 仅四点三,约三倍;扩到更大 ViT-B 或 ResNet 仍远小于特征轴。从头训练时换轴几乎中性,说明轴改变的是预训练可迁移性,而非网络天生更强。CKA 显示特征轴在早中层更多复用、末层更敢特化。
阅读时需要注意
- 边界必须写清:本文评测的是研究用骨干与迁移协议,不是临床产品;任何分割或分类数字都不得外推为临床可用诊断、筛查或治疗建议。
- 协议固定在 ImageNet-1K 与共享 U-Net/线性头,未验证 nnU-Net 级临床管线或医学自监督预训练是否改变结论。
- 增益随模态变化,超声最大、高对比 CT 更小;个别小测试集与近饱和任务使单任务解读受限。CKA 只是相关印证。
关联工作
- 分层 ViT 与混合骨干长期把空间注意力当作全局主操作;医学 Transformer 也常在空间骨干上附加通道或双分支 refinement。FAD-ViT 反过来让特征轴成为全局主操作,并把问题表述为迁移先验而非任务插件。
- XCiT 与 DaViT 代表通道感知两大家族,适合作为纠缠设计的对照;DINOv2 则提供高容量自监督压力测试。