快速导读:在共享训练协议下比较十三种视觉来源、五种注入机制与多源组合,得到以通用表征和通道拼接为核心的 Representation Recipe,并实例化为 R2-WAM。
世界动作模型(World Action Models,WAMs)把预训练视频生成接到机器人控制,同时预测未来画面和动作。问题是:它们继承的 VAE 潜空间是为视觉重建训练的,并不显式照顾操纵所需的物体语义与空间关系。近期工作往 WAM 里塞外部视觉特征,成功率与鲁棒性都有提升,但表征往往按“缺什么能力”来挑,又和某一种融合设计绑在一起,很难判断到底是表征本身有效,还是注入方式在起作用。
这篇 arXiv:2610.13024 来自中科院自动化所、Galbot、北京大学与中国科学技术大学,通讯作者包括董斌赵、张智铮与王鹤。作者在同一 Wan 2.2 视频专家加动作专家的骨干、同一训练预算下,对照十三种视觉来源(RQ1)、五种注入机制(RQ2)和多源组合(RQ3)。三条结论很明确:通用视觉表征应作为默认增强;通道拼接联合预测平均收益最大;追加来源必须贡献现有表征没有的任务信息。他们把配方写成 R2-WAM,在 RoboCasa GR1 Tabletop 上达到 84.7%、RoboTwin 2.0 上达到 92.8%,相对仅用 VAE 的基线分别高 5.9 和 2.2 个百分点。项目页为 https://kailiu18.github.io/R-2WAM.github.io/ 。预印本尚未同行评审。
英文题目:What Visual Representations Do World Action Models Need?
论文出处:arXiv 每日论文精选 · arXiv:2610.13024
原始论文:PDF / 论文页面
这篇论文解决什么问题?
WAM 的吸引力在于:大规模视频预训练已经学到视觉结构与时间动态,DreamZero、LingBot-VA、Fast-WAM 等把这些先验迁到控制。但 VAE 优化重建,并不保证潜变量对抓取、放置、遮挡和视角变化足够敏感。作者在 LIBERO-Plus 上量到这一点:仅用 VAE 的 WAM 在语言扰动和光照上分别有 91.1% 与 94.3% 成功率,视角、背景和噪声却掉到 51.2%、62.0%、66.6%。
已有增强路线各自绑定一种假设。LDA-1B 在 DINO 特征空间学动态,LaWAM 用预测的潜视觉子目标条件化动作,ST-WAM 把 DINO 未来预测与历史检索接到 VAE 动力学,Robust-WAM 让动作流查询对齐未来语义特征,Flex-π 联合去噪 RGB 潜变量、三维点图、DINO 与动作。它们证明“加外部特征有用”,却没有在同一协议下把表征类型和融合机制拆开。叠加多种表征也未必单调变好:语义、几何、分割、交互特征会重叠,优化时还可能互相干扰。
核心创新
- 在同一 WAM 骨干与共享训练协议下系统对照表征来源、五种注入与特征组合,把表征选择和融合机制拆开。
- 给出可操作配方:默认用通用视觉表征、通道拼接联合预测,并只在互补时追加来源。
- 把配方实例化为 R2-WAM,并在多种 WAM 形式、仿真基准与真机任务上相对仅用 VAE 的基线验证。
方法概览
基座 WAM 由 Wan 2.2 初始化的视频专家与独立动作专家组成,二者经非对称联合注意力交互:动作 token 可见视频与动作,视频 token 只见视频;语言用 T5 交叉注意力,并条件于机器人状态与 flow 时间。训练为视频与动作 flow-matching 损失加权和。十三种冻结编码器从同一 RGB 观测取特征,按预训练侧重分成通用(DINOv3、V-JEPA 2.1、VC-1、LingBot-Vision、VideoMAE V2、SigLIP 2、Qwen3.5、UniTok、C-RADIOv4)与专用(SAM 3、VGGT-Ω、HRP、DynaFLIP)。五种注入:REPA 对齐中间隐状态;门控交叉注意力把当前特征写入动作流;通道拼接把特征与 VAE 网格沿通道拼接并联合预测流速;token 拼接把特征当作独立序列共享 Transformer;特征专家用独立参数预测未来特征。组合实验固定通道拼接。R2-WAM 取 DINOv3、UniTok 与 V-JEPA 2.1 做通道拼接。
- 基座模型接收 RGB、语言指令和当前机器人状态,联合预测未来视频潜变量 zvae1:T 与动作块 a。视频专家从 Wan 2.2 初始化,动作专家独立;二者用非对称掩码做联合注意力——动作 token 能看见视频与动作,视频 token 只能看见视频。两边都通过交叉注意力读 T5 语言特征,并条件于机器人状态与 flow 时间。损失是视频与动作 flow-matching 的加权和。推理时未来视频潜变量和动作从噪声联合去噪。
- 外部编码器全部冻结,只从基座已经使用的 RGB 取特征。作者按预训练目标分成六组侧重:视觉自监督(VC-1、VideoMAE V2、V-JEPA 2.1、DINOv3、LingBot-Vision)、语言关联(SigLIP 2、Qwen3.5)、分割(SAM 3)、几何(VGGT-Ω)、交互(HRP、DynaFLIP)、多目标或多教师(UniTok、C-RADIOv4)。面向广泛视觉或视觉–语言迁移的称为通用,主要为单一能力预训练的称为专用。
- 五种注入覆盖对齐、条件化与联合预测。REPA 用可训练投影把中间隐状态映到外部特征空间,用余弦距离对齐。门控交叉注意力以动作隐状态为查询、当前观测特征为键值,可学习门控缩放后再加回动作流,并保留原有 T5 交叉注意力。通道拼接把外部特征空间对齐到 VAE 网格后沿通道拼接,扩展视频专家的输入输出投影,联合预测 VAE 与特征流速,token 布局与注意力掩码不变。token 拼接把特征做成独立序列,自带输入投影和未来特征预测头,但与 VAE token 共享 Transformer 层。特征专家则为未来外部特征配备独立 Transformer 参数,三类 token 经掩码联合注意力交互。组合实验一律用通道拼接。
- R2-WAM 的配方是:先加 DINOv3,再加 UniTok 与 V-JEPA 2.1,三者通道拼接。四源里再加 HRP 能把 LIBERO-Plus 从 87.3% 推到 87.7%,但只有 0.4 个百分点,作者为了少挂辅助编码器而停在三源。
逐图理解论文
对照缺口
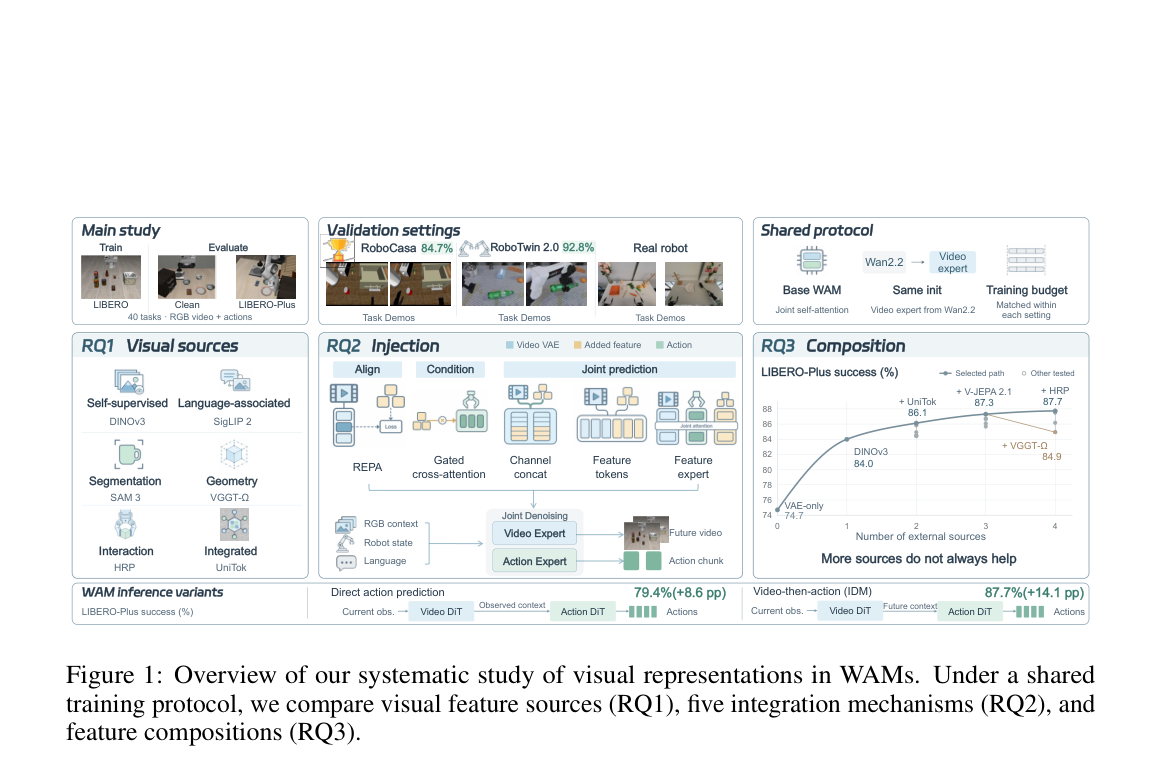
图1是全文总览,宜作特色图。上栏三块:Main study 在 LIBERO 40 任务上训练、在 Clean 与 LIBERO-Plus 上评测;Validation settings 标出 RoboCasa 84.7%、RoboTwin 2.0 92.8% 与真机;Shared protocol 写明视频专家来自 Wan2.2、同初始化、各设置训练预算对齐。中栏对应三个研究问题:RQ1 列出 DINOv3、SigLIP 2、SAM 3、VGGT-Ω、HRP、UniTok 等来源分组;RQ2 用蓝/橙/绿区分 Video VAE、Added feature 与 Action,画出 REPA、门控交叉注意力、通道拼接、特征 token 与特征专家,下方是 RGB、机器人状态、语言进入 Video Expert 与 Action Expert、输出未来视频与动作块;RQ3 是 LIBERO-Plus 成功率随外部源数量上升的曲线,VAE-only 74.7,DINOv3 84.0,+UniTok 86.1,再至 87.3,+HRP 87.7,旁标未选路径 +VGGT-Ω 84.9,并写 More sources do not always help。底栏给出两种推理变体:直接动作预测 79.4%(+8.6 pp),video-then-action(IDM)87.7%(+14.1 pp)。
五种注入
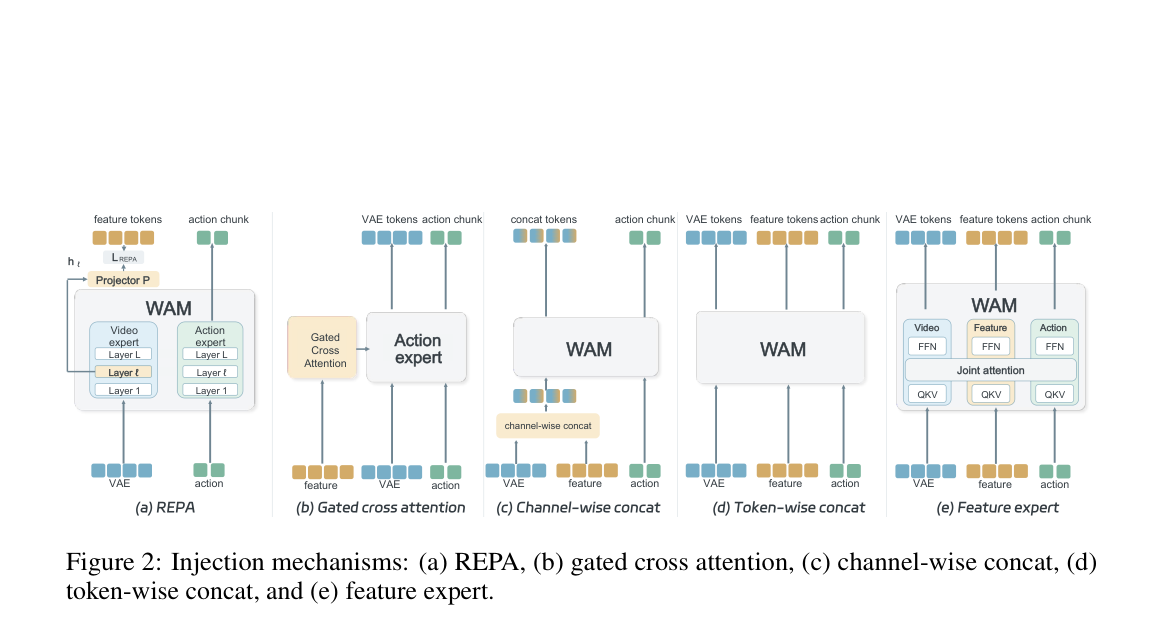
图2并排五种注入。(a) REPA:VAE 蓝块与动作绿块进入 WAM,视频专家第 ℓ 层隐状态经 Projector P 对齐到橙色 feature tokens,损失为 L_REPA。(b) 门控交叉注意力:橙色 feature 作为额外交叉注意力写入 Action expert,VAE 与 action 仍并行。(c) 通道拼接:VAE 与 feature 在进入 WAM 前沿通道拼成 concat tokens,动作块单独在右侧。(d) token 拼接:VAE、feature、action 三条序列进入同一个 WAM 框。(e) 特征专家:Video / Feature / Action 三个专家各有 QKV 与 FFN,中间是 Joint attention。读图时应抓住:只有 (c) 把特征融进 VAE 网格本身,(d)(e) 则让特征成为独立 token 流。
三条结论
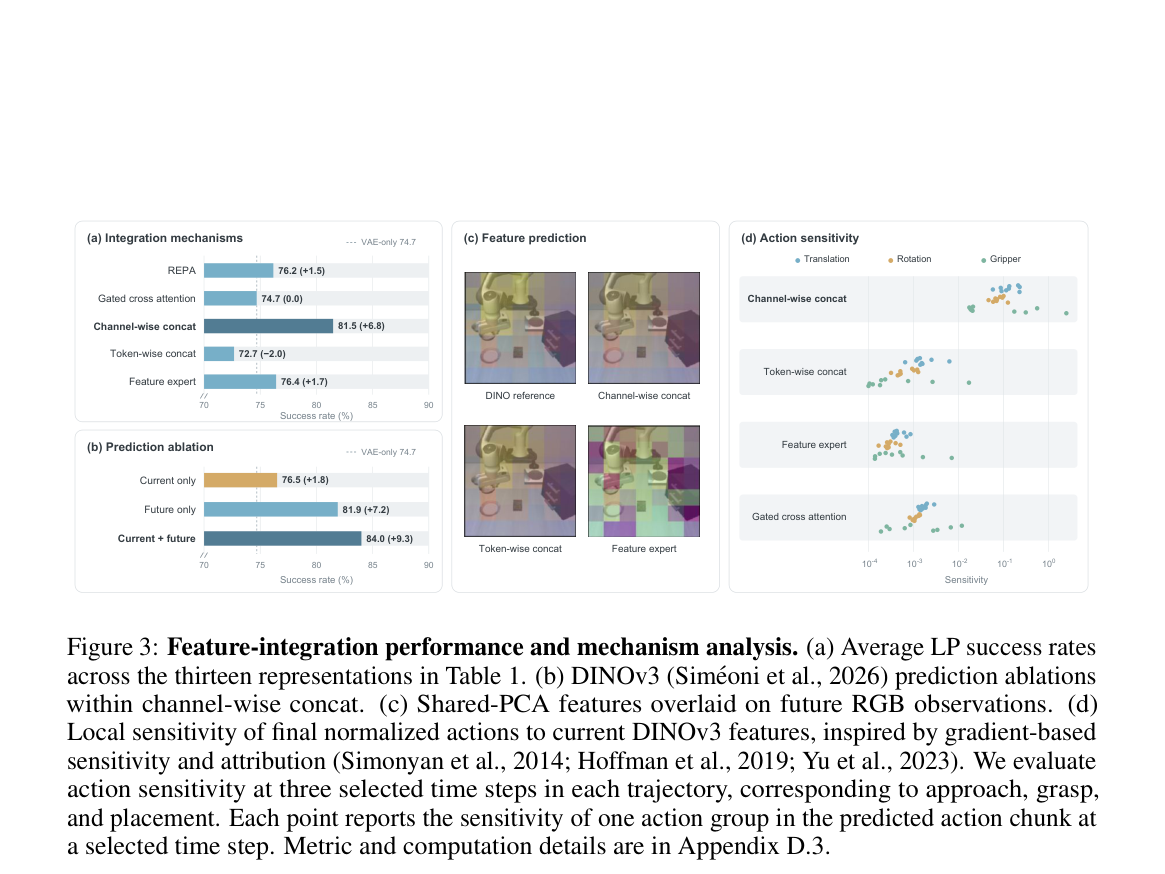
图3分析为什么通道拼接更强。(a) 十三种表征平均的 LP 成功率:通道拼接 81.5(+6.8),特征专家 76.4(+1.7),REPA 76.2(+1.5),门控交叉注意力 74.7(0.0),token 拼接 72.7(−2.0),虚线为仅 VAE 的 74.7。(b) 在 DINOv3 通道拼接内做预测消融:仅当前 76.5(+1.8),仅未来 81.9(+7.2),当前+未来 84.0(+9.3)。(c) 把共享 PCA 特征叠在未来 RGB 上:DINO 参考与通道拼接都保留桌面与物体的彩色空间结构,token 拼接仍可辨,特征专家明显更块状、更粗。(d) 动作对当前 DINOv3 的局部敏感度,蓝点平移、橙点旋转、绿点夹爪;通道拼接的点整体落在 10^-1 到 10^0,明显高于 token 拼接、特征专家与门控交叉注意力。
结论与局限
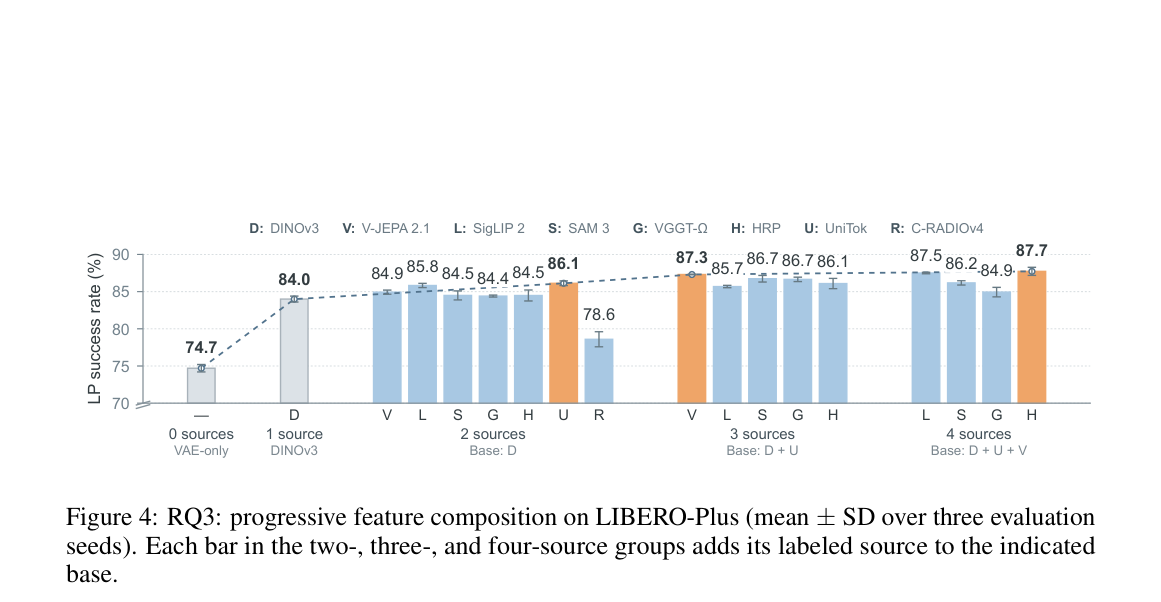
图4是 RQ3 的递进组合柱状图,误差棒为三评测种子。横轴从 0 源 VAE-only 的 74.7,到 1 源 DINOv3 的 84.0,再分别以 D、D+U、D+U+V 为底座加第二、三、四源。橙色柱是作者选中的路径:D+U 86.1,D+U+V 87.3,D+U+V+H 87.7。值得盯住的失败是 2 源组里的 R(C-RADIOv4)只有 78.6,低于单源 DINOv3。图注说明每个柱是在标明底座上再加该字母对应来源,字母表为 D DINOv3、V V-JEPA 2.1、L SigLIP 2、S SAM 3、G VGGT-Ω、H HRP、U UniTok、R C-RADIOv4。
实验如何设计?
- RQ1–RQ3 使用 Fast-WAM 提供的 LIBERO 与 RoboTwin 2.0 训练数据,以及 DIAL 所用的 RoboCasa GR1 Tabletop。LIBERO 对照中训练数据、观测、动作地平线、优化器与学习率日程固定,只改表征来源、注入机制或来源集合。LIBERO 每任务 50 次 rollout;因接近饱和,正文把完整结果放到附录,主文用 LIBERO-Plus:七类扰动、每评测种子 10,030 条、三颗种子报均值±标准差。
- RoboCasa 24 任务各 50 次;RoboTwin 2.0 的 50 任务在 clean 与 randomized 设置各 100 次。真机四任务每模型每任务 20 次。配方还接到两种额外 WAM 形式:Fast-WAM 式直接动作预测,以及 LingBot-VA 式先视频后动作的 IDM。
关键结果与论文证据
- RQ1 里,通用表征平均成功率 82.2%,专用 80.0%;七类扰动的最高均值也都落在通用源上。DINOv3 总体 84.0%,是单源最强之一,相对仅 VAE 的 74.7% 提升 9.3 个百分点。专用源并非无用:SAM 3、VGGT-Ω 都到 80.6%,但即便在分割或几何看起来更相关的扰动上,也没有稳定超过最强通用源。Takeaway 1:增强 WAM 应默认从通用视觉表征起步,而不是先假设缺某一专项能力。
- RQ2 把五种机制在十三种来源上平均:通道拼接 81.5%,比第二名高出 5.1 个百分点;门控交叉注意力几乎没有平均增益(74.7%),token 拼接甚至降到 72.7%。DINOv3 的预测消融显示,只预测未来特征就有 81.9%,接近完整的当前+未来 84.0%,远高于只条件当前的 76.5%。共享 PCA 可视化里,通道拼接能恢复未来特征的粗空间结构;动作对当前 DINOv3 的局部敏感度也是通道拼接最高。Takeaway 2:默认用通道拼接,并显式支持未来特征预测、让动作专家真正用上这些特征。
- RQ3 显示第一次加入 DINOv3 的 9.3 个百分点,是后续组合里最大的一跳。D+U 到 86.1%,D+U+V 到 87.3%。同一来源可帮可害:SigLIP 2 给 DINOv3 加 1.8 个百分点,但 UniTok 已经在场时再加 SigLIP 2 会掉 0.4;C-RADIOv4 蒸馏了 DINOv3、SigLIP 2 与 SAM 3,和 DINOv3 组合掉到 78.6%。作者因此强调互补而不是堆叠。R2-WAM 在 RoboCasa 84.7%、RoboTwin 2.0 92.8%;直接预测与 IDM 两种形式上 LIBERO-Plus 分别到 79.4% 与 87.7%;真机三项完整任务各高 10 个百分点,清扫收集率 48.3% 升到 66.7%。
阅读时需要注意
- 对照绑在 Wan 2.2 视频专家加动作专家、冻结外部编码器、以及匹配的训练预算上,不能直接外推到完全不同的 WAM 骨架或端到端微调表征。组合搜索也不是穷举,四源再加 HRP 只有 0.4 个百分点,作者主动停在三源。
- LIBERO 本身接近饱和,鲁棒性结论主要来自 LIBERO-Plus;真机只有四项、每项 20 次,统计波动仍在。Table 3 与若干已发表方法并列时,数据与评测协议未必对齐,跨论文数字应谨慎阅读。预印本尚未同行评审。
关联工作
- WAM 文献沿两条线展开:一条改视觉预测空间或监督,如 LDA-1B、LaWAM、Rep-WAM;另一条在部署时切换输入与预测流,如 Flex-π。本文不提出全新生成骨干,而是问:在继承 VAE 的前提下,外部视觉表征该怎么选、怎么接、要不要组合。
- 视觉表征本身按预训练目标形成不同能力:DINOv3 强调语义与稠密空间,SigLIP 2 强调图文对齐,SAM 3 强调区域与边界,VGGT-Ω 强调三维几何,HRP 强调手–物体–接触。作者的分组就是为了检验“专项预训练是否能对上专项扰动”,结果并不支持把专项编码器当作默认补丁。
- 评测上,LIBERO-Plus 提供相机、机器人外观、语言、光照、背景、噪声、布局扰动;RoboCasa GR1 与 RoboTwin 2.0 则把同一配方迁到不同具身。这使 R2-WAM 不只是 LIBERO 上的消融冠军,而是一条可迁移的表征配方。