快速导读:LAPT-Scale 用连续潜动作模型从大规模第一人称人体视频生成隐式动作监督,再经目标机器人对齐与任务后训练扩展具身策略。
具身策略要规模化,最贵的往往不是模型,而是带动作标签的机器人交互。人体第一人称视频记录了海量日常操作,却没有可直接下发的机器人动作。LAPT-Scale(arXiv:2610.13732;京东 Joy Future Academy、哈工大深圳、清华 SIGS、港科广)把这件事拆成两段:LAPT-Scale-LAM 在 2.33 万小时自我中心视频上学习连续潜动作,解释相邻帧的视觉转移;LAPT-Scale-Policy 再用这些隐式标签做视觉-语言-动作预训练,随后用 250 小时目标机器人数据做 embodiment 对齐,最后在仿真和真机上做任务后训练。首页虽标 CoRL 2026,本文按预印本解读,尚未视为已接收或已评审结论。
与依赖离散码本的向量量化 LAM 不同,连续潜空间用来保住精细手物动态;训练也不只靠像素重建,而是同时加入 LPIPS 感知对齐、冻结 DINOv2 语义对齐和冻结 RAFT 光流对齐。用冻结 LAM 标注清洗后的 5100 小时人体视频后,策略在 RoboTwin 2.0 Easy/Hard 达到 90.0%/89.3%,RoboCasa-GR1 平均成功率 64.8%。只增加第一阶段人体视频、机器人数据保持不变时,三件真机任务平均成功率从 1K 小时的 63.3% 升到 5K 小时的 85.0%。
英文题目:LAPT-Scale: Scaling Embodied Policies with Latent Action Pre-Training on Human Videos
论文出处:arXiv 每日论文精选 · arXiv:2610.13732
原始论文:PDF / 论文页面
这篇论文解决什么问题?
视觉和语言可以靠网络数据扩张,机器人交互却必须在物理世界或仿真器里采集。Open X-Embodiment 一类机器人语料仍然远小于人体视频。自我中心视频天然覆盖厨房、工厂、桌面装配等日常操作,但人体运动空间不能直接映射到机器人控制空间。
已有路线常把人体视频转成伪动作。VITRA 一类方法依赖显式运动估计;估计误差会写进标签,再叠加更多视频也不一定让策略变好。潜动作模型则从相邻观测端到端推断隐式动作,不必预先定义机器人动作空间。问题在于:许多 LAM 使用固定离散码本,容易把连续操作压得过粗;只做像素重建时,大面积静止背景会淹没小而关键的手物接触。作者因此要一种既能随人体视频扩展、又能保住转移结构的监督。
核心创新
- 连续潜动作空间配合感知、DINOv2 语义和 RAFT 光流对齐,从人体视频学习精细转移。
- 同一套 VLA 动作专家完成人体视频预训练、目标机器人对齐与任务后训练,不另开人体头。
- 在机器人数据固定时,仅增加 LAM 标注人体视频即可提升真机成功率,并对照手部伪动作与重建型 LAM。
方法概览
LAPT-Scale-LAM 在 2.33 万小时自我中心视频上训练时空 VAE:动作查询编码相邻帧,采样 32 维连续潜动作,解码器从当前帧与潜动作重建下一帧。损失包含像素与 LPIPS、冻结 DINOv2 特征、冻结 RAFT 光流和 KL。冻结编码器在清洗后的 5100 小时子集上写出后验均值标签。LAPT-Scale-Policy 用 JoyAI-RA 骨干与条件流匹配动作专家,三阶段共用同一专家:先预测人体潜动作块,再在 250 小时目标机器人数据上改预测可执行动作,最后做任务后训练。推理只用机器人动作。
- 数据分两层。LAM 在 2.33 万小时多样化自我中心视频上训练,强调覆盖:中等操作密度的片段仍可提供相机相对运动和外观变化。策略第一阶段只用清洗后的 5100 小时子集:去掉损坏、模糊、相机运动主导或手物交互弱的片段,留下可见手、物体交互和有意义时间变化。附录多样性审计给出 12 类场景、21 个动作标签、54 个物体标签;图2环形图中 Factory 约占 42.9%、Kitchen 15.9%、Other 20.8%、Bedroom 8.0%。缩放实验的 1K/3K/5K 小时子集尽量嵌套取样,并限制单一来源占比。
- LAPT-Scale-LAM 做成时空 VAE。对相邻帧 (xt, xt+1),可学习动作查询接到两帧补丁嵌入,经 Transformer 编码器得到对角高斯后验 qφ(zt|xt,xt+1),连续潜动作维数为 32。解码器单独接收当前视觉上下文,把 zt 注入当前帧补丁后预测 xt+1,促使 zt 刻画帧间变化而不是静态外观。对齐包含四项:像素加 LPIPS 的感知损失、冻结 DINOv2 补丁与 CLS 特征的语义损失、冻结 RAFT 光流的运动损失,以及把连续潜空间拉近先验的 KL 项。附录给出权重:KL 为 10 的负六次方,LPIPS 0.01,DINO 0.003,光流 3.3×10 的负五次方。冻结编码器随后输出后验均值,作为第一阶段确定性标签。
- LAPT-Scale-Policy 使用与 JoyAI-RA 相同的视觉语言模型骨干和 Perceiver 风格动作专家,用条件流匹配训练。三个阶段共用同一动作专家、不另加人体视频头或重初始化:第一阶段在人体视频上下文上预测潜动作块;第二阶段把目标换成 250 小时目标机器人动作块做 embodiment 对齐;第三阶段在任务数据上后训练。推理时只输出可执行机器人动作,LAM 编码动作只作可扩展的第一阶段监督。
逐图理解论文
连续潜动作
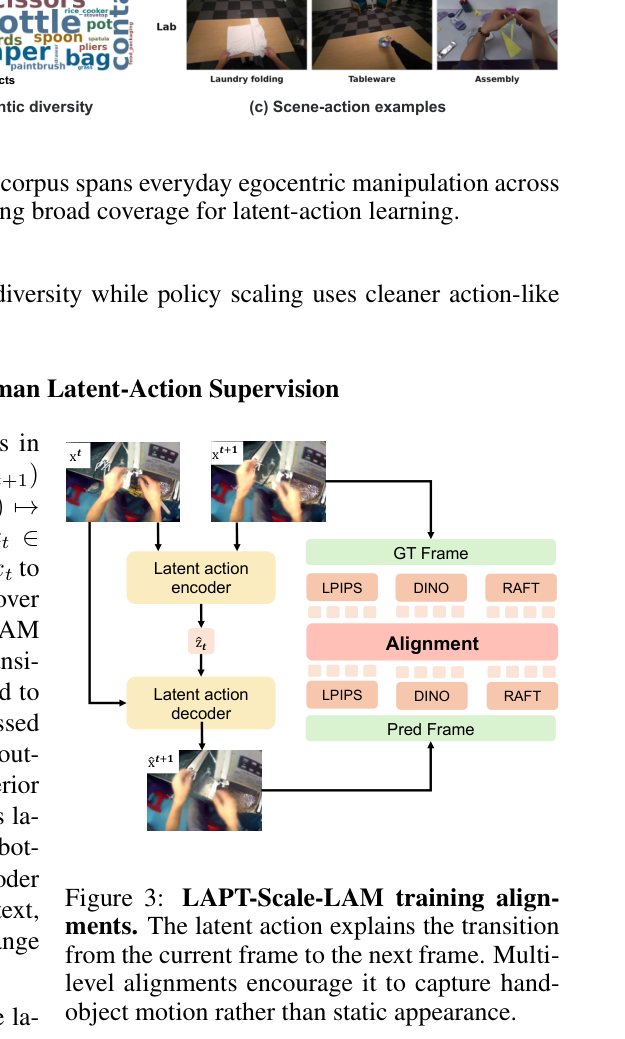
图3是 LAPT-Scale-LAM 训练对齐。上方裁切残留了图2词云与 Laundry folding / Tableware / Assembly 示例,讲图时忽略。主体流程图:xt 与 xt+1 两帧(水槽边双手操作)进入黄色 Latent action encoder,输出 ẑt;当前帧与潜动作进入 Latent action decoder,得到预测帧 x̂t+1。右侧 GT Frame 与 Pred Frame 分别接到 LPIPS、DINO、RAFT,再汇总到红色 Alignment 块。图注强调潜动作解释当前帧到下一帧的转移,多级对齐促使模型抓住手物运动而非静态外观。
三阶段策略
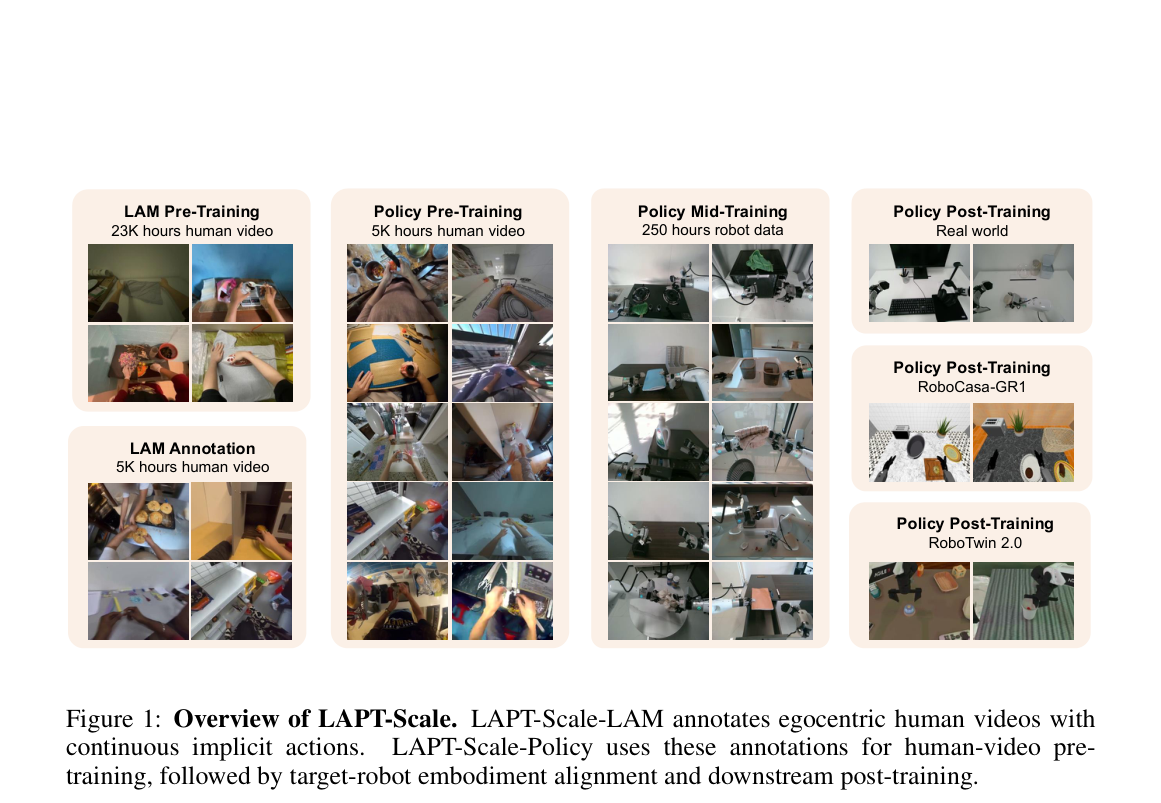
图1是方法总览,宜作特色图。左列 LAM Pre-Training 标 23K hours human video,四张厨房/桌面第一人称手部操作;其下 LAM Annotation 标 5K hours human video,同样是自我中心操作。中列 Policy Pre-Training 为 5K hours human video 的八宫格,Policy Mid-Training 为 250 hours robot data 的机器人工作台俯视与侧视。右列 Policy Post-Training 分三块:Real world 真实桌面(显示器、杯子、耳机),RoboCasa-GR1 仿真厨房俯视,RoboTwin 2.0 双臂桌面仿真。图注写明 LAM 用连续隐式动作标注人体视频,策略再经人体视频预训练、目标机器人对齐和下游后训练。
关键证据
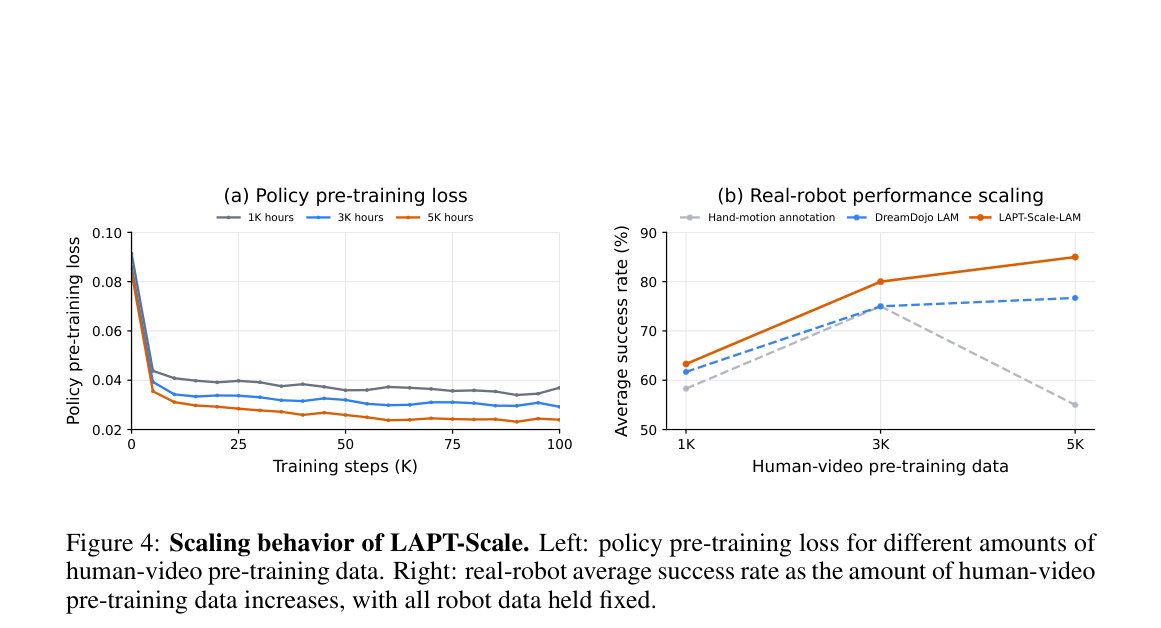
图4是缩放行为。(a) Policy pre-training loss:灰/蓝/橙分别对应 1K、3K、5K hours,损失在约 10K step 内陡降后进入平台,5K 小时曲线最低,约在 0.02 附近。(b) Real-robot performance scaling:横轴人体视频预训练数据 1K/3K/5K,纵轴平均成功率。橙色 LAPT-Scale-LAM 持续上升,约 63%、80%、85%;蓝色虚线 DreamDojo LAM 在 5K 约 77%;灰色 Hand-motion annotation 在 3K 接近 75% 后掉到约 55%。图注写明机器人数据全程固定。
结论与局限
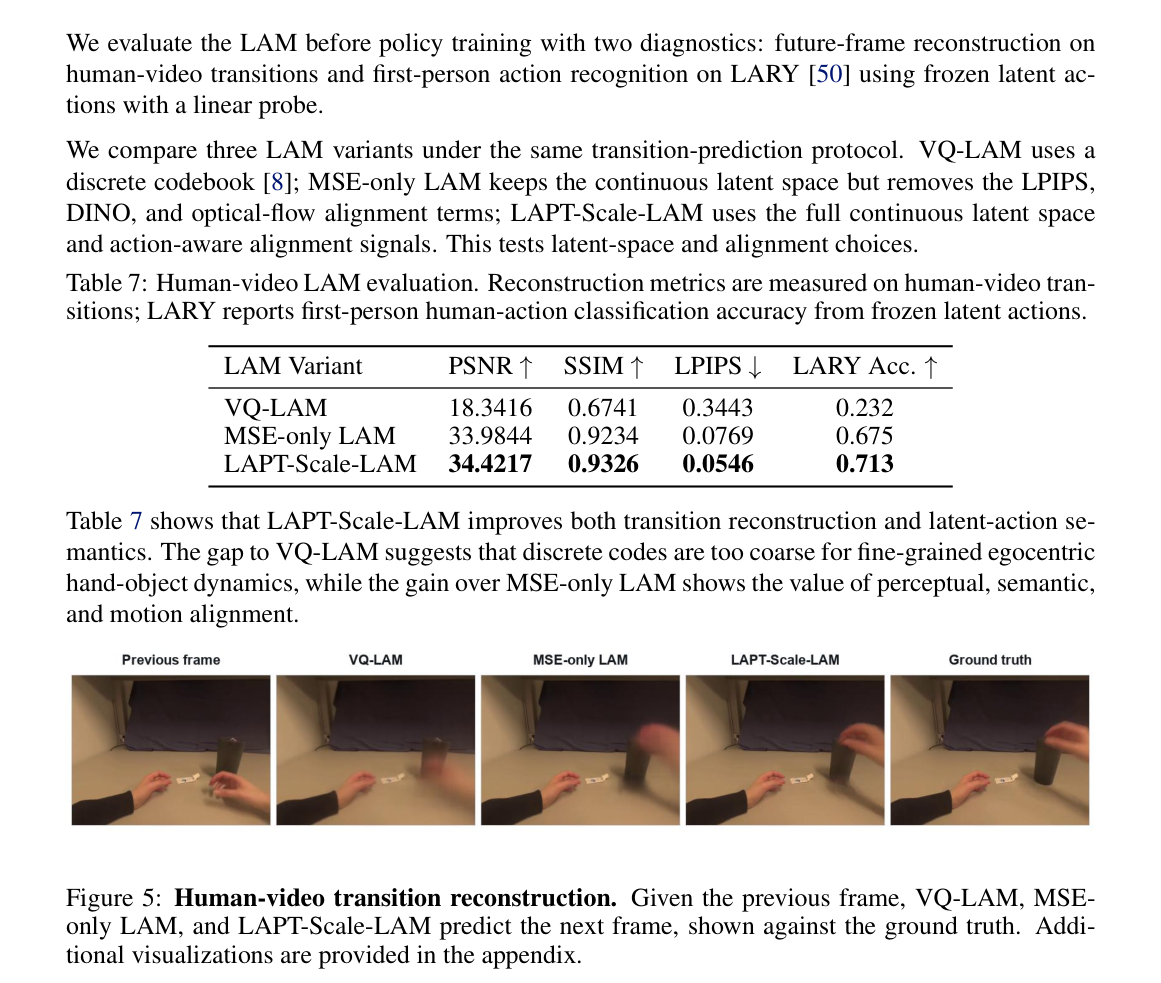
图5给出人体视频转移重建。裁切上部含 Table 7:VQ-LAM 的 PSNR/SSIM/LPIPS/LARY 为 18.3416 / 0.6741 / 0.3443 / 0.232;MSE-only LAM 为 33.9844 / 0.9234 / 0.0769 / 0.675;LAPT-Scale-LAM 为 34.4217 / 0.9326 / 0.0546 / 0.713。底部五行图像从左到右为 Previous frame、VQ-LAM、MSE-only LAM、LAPT-Scale-LAM、Ground truth:场景是桌面上的深色圆柱与小白卡片,双手从左侧伸向物体。VQ-LAM 手部发糊、位置偏;MSE-only 仍糊;完整模型更接近真值。讲数字以 Table 7 为准,图像只作定性对照。
实验如何设计?
- 下游评测三条线:RoboTwin 2.0 仿真(Easy/Hard 平均成功率)、RoboCasa-GR1 桌面操作,以及 AgiBot G1 上的真机任务。主策略跑完 5100 小时 LAM 标注预训练、250 小时对齐和任务后训练。对照包括 π0、π0.5、Motus、LingBot-VLA、JoyAI-RA、GR00T-N1.6、Qwen3PI、ABot-M0 和同机器人语料的 Diffusion Policy。真机三件原始任务(鼠标垫、耳机、杯子)每任务 20 次试验。
- 缩放实验固定 LAM(始终在 2.33 万小时上训练)、机器人数据、策略结构和评测协议,只改变第一阶段清洗标注人体视频的量。三种人体监督对照:显式手部伪动作、官方预训练 DreamDojo LAM,以及完整对齐的 LAPT-Scale-LAM。另有去掉第一阶段、以及把第二阶段算力对齐延长的控制。LAM 诊断比较 VQ-LAM、仅 MSE+KL 的连续 LAM 与完整模型,报告 PSNR、SSIM、LPIPS 和 LARY 线性探测准确率。
- 更难的四任务覆盖纸团丢弃、笔与自遮挡橡皮抓取、多阶段书本收纳。一个联合策略每任务 200 条演示,也用于后训练 π0.5。评测包含已见条件以及未见位置、光照、背景,每任务每域 20 次。
关键结果与论文证据
- Table 1 中 LAPT-Scale 在 RoboTwin Easy/Hard 为 90.0%/89.3%,高于所列最强对照(Motus Hard 87.0%,JoyAI-RA Hard 87.2%)。Table 2 在 RoboCasa-GR1 为 64.8%,略高于 JoyAI-RA 的 63.2%。Table 3 真机三任务平均 85.0%(鼠标垫 85.0、耳机 95.0、杯子 75.0),高于 JoyAI-RA 的 80.0% 和 π0.5 的 56.7%;同 250 小时机器人语料的 Diffusion Policy 平均仅 45.0%。
- 图4是缩放主证据。左图第一阶段预训练损失随人体视频增加而下降,5K 小时最低。右图在机器人数据固定时,LAPT-Scale-LAM 真机平均成功率从 1K 的 63.3% 升到 3K 的 80.0%、5K 的 85.0%。DreamDojo LAM 在 5K 为 76.7%;手部伪动作从 1K 升到 3K 后在 5K 掉到 55.0%,接近零小时控制的 55.0%。作者把后一现象归因于遮挡、相机运动和手可见性变化下的估计噪声不会被下游训练改正。
- Table 4 去掉第一阶段后真机平均 55.0%,算力对齐延长第二阶段为 53.3%,都低于完整 5K 小时设定的 85.0%。Table 5 去掉光流对齐后 RoboTwin Hard 从 89.3% 掉到 77.8%(降 11.5 点),尽管 PSNR 仍高,说明像素保真不能代替运动结构。Table 7 中完整 LAM 的 PSNR 34.4217、SSIM 0.9326、LPIPS 0.0546、LARY 0.713,均优于 MSE-only 与 VQ-LAM。图5里 VQ-LAM 手部位置发糊,MSE-only 仍糊,完整模型更接近真值。四任务泛化上,已见条件与 π0.5 同为 85.0%,但位置/光照/背景下 LAPT-Scale 保持 75.0/70.0/70.0%,平均 75.0%,π0.5 平均 55.0%。
阅读时需要注意
- 核心假设是:人体视频里学到的视觉潜动作,经 embodiment 对齐后可以变成有用的机器人策略监督;它们并不保证对应独立可控的机器人自由度,因此目标机器人对齐仍然必要。视频若操作信号弱、形态差距大、遮挡重,或变化主要由自我相机运动主导,方法可能失效。
- 真机研究覆盖七个任务、一台 AgiBot G1,每条件 20 次试验,成功率估计精度有限,不能外推为部署鲁棒性。缩放曲线只改第一阶段人体视频量,不是同时扫模型规模和机器人演示量的完整标度律。首页 CoRL 2026 字样按预印本处理,不作会议接收结论。
关联工作
- VLA 工作用网络知识、机器人数据、流式动作建模和跨形态训练扩展策略,但仍受带动作标签轨迹约束。EgoScale、VITRA 把人体视频转成类动作目标,依赖显式运动估计或重定向;也有仿真中介把重建人体演示转成物理校验的机器人轨迹。LAPT-Scale 改为用 LAM 隐式动作标注人体视频。
- 人体视频资源从 Something-Something、EPIC-KITCHENS 到 Ego4D 及后续 ego-exo、工厂与灵巧操作数据,提供视觉经验但不给出可执行动作。LAM/世界模型路线(Genie、LAPO、UniVLA、Motus 等)常用离散或向量量化潜变量;LAOF 用光流增强重建以抵抗干扰。LAPT-Scale-LAM 把连续潜空间与感知、语义、光流对齐合在一起,专为人体视频策略预训练服务。