快速导读:Block3D将Cube的逐token自回归生成改为块级自回归+块内并行去噪,并引入置信度引导的块内修正,在保持几何质量的同时将平均生成时间从25.71秒降至4.99秒。
Block3D解决的核心问题是:文本到3D生成中,自回归模型顺序解码无法修正错误,而扩散模型反复处理完整表示导致推理成本过高。论文的答案是块级扩散——把Cube的1024个VQ形状码分成16个连续块,块与块之间保持自回归的因果依赖,块内部则用双向注意力并行去噪,同时引入置信度引导的块内修正机制。
这一设计的关键洞察在于:3D形状的局部token之间存在强双向依赖,但全局结构仍需要从左到右的因果约束来保证一致性。Block3D在冻结的Cube表示上验证了这一假设,将平均端到端生成时间从25.71秒压缩到4.99秒,同时几何指标与Cube相当甚至更好。
英文题目:Block3D: Efficient Text-to-3D Generation via Block-Wise Diffusion
论文出处:arXiv 每日论文精选 · arXiv:2608.19567
原始论文:PDF / 论文页面
这篇论文解决什么问题?
Cube用固定长度1024个VQ码表示网格,逐token自回归生成。这种顺序解码有两个问题:一是每个token只能看到左侧前缀,无法利用右侧上下文;二是生成错误无法回退修正,曝光偏差会沿序列累积。
扩散模型和流模型虽然能并行处理完整表示,但每次去噪都要对全部1024个token做前向计算,推理成本随序列长度线性增长。对于交互式应用来说,25秒以上的延迟意味着用户无法实时迭代设计。
Block Diffusion提出了块级自回归分解的思路:将序列分为连续块,块间保持因果顺序,块内用双向注意力并行去噪。这为Block3D提供了理论框架,但如何将这一框架适配到3D形状的离散VQ表示,以及如何在块内引入有效的修正机制,仍是未解决的问题。
LLaDA2.1的M2T/T2T可编辑解码提供了块内修正的工具:M2T将掩码位置填充为具体token,T2T将已填充的低置信度token替换为新候选。Block3D将这一机制与置信度门控结合,在块冻结前完成修正。
核心创新
- 将Cube的逐token因果依赖改为块级因果依赖,块内并行去噪,大幅减少顺序解码步数
- 提出置信度引导的块内修正机制,结合M2T填充与T2T替换,在块冻结前修正低置信度token
- 设计编辑感知训练:样本级M2T/T2T腐蚀流选择、一次无梯度模型rollout、仅对残差token的监督损失
- 确定性揭示配额保证每块在T步内完成,同时允许置信度门控的T2T编辑在每次迭代可用
方法概览
将1024个形状码分为K=16个连续块(B=64),块从左到右自回归生成,当前块内所有token在双向注意力下并行去噪T=4步。训练时采用clean/corrupted双流注意力,以M2T或T2T(各50%概率)腐蚀块内token,经一次无梯度模型rollout后仅对残差位置计算交叉熵损失。推理时用CFG(g=3.0,线性衰减至0.75)提出候选码,条件logits给出置信度,M2T阈值0.95、T2T阈值0.9,确定性配额保证每块最多T步完成。
- 块分解:将1024个形状码分为K=16个连续块,每块B=64个token。块从左到右自回归生成,当前块内所有token在双向注意力下并行去噪T=4步。
- 训练注意力:采用clean/corrupted双流注意力。已完成块作为clean前缀,当前块内token以M2T或T2T方式腐蚀(各50%概率),模型学习在双向上下文中恢复被腐蚀的token。
- 编辑感知训练:对腐蚀后的块进行一次无梯度模型rollout,得到模型自己的预测结果,然后仅对残差位置(即模型预测与真实token不一致的位置)计算交叉熵损失。这迫使模型关注它最容易出错的位置。
- 推理时的CFG:使用无分类器引导(g=3.0,线性衰减至0.75)提出候选码。条件logits给出每个位置的置信度,M2T阈值0.95、T2T阈值0.9决定哪些位置需要更新。
- 确定性揭示配额:每块最多T步完成,保证推理延迟有上界。同时置信度门控的T2T编辑在每次迭代都可用,允许在块冻结前持续修正低置信度token。
- 前缀缓存:已完成块作为冻结的因果前缀,其注意力键值可以缓存复用,避免重复计算,这是块级设计相比全序列扩散的额外效率优势。
逐图理解论文
失败案例与直觉
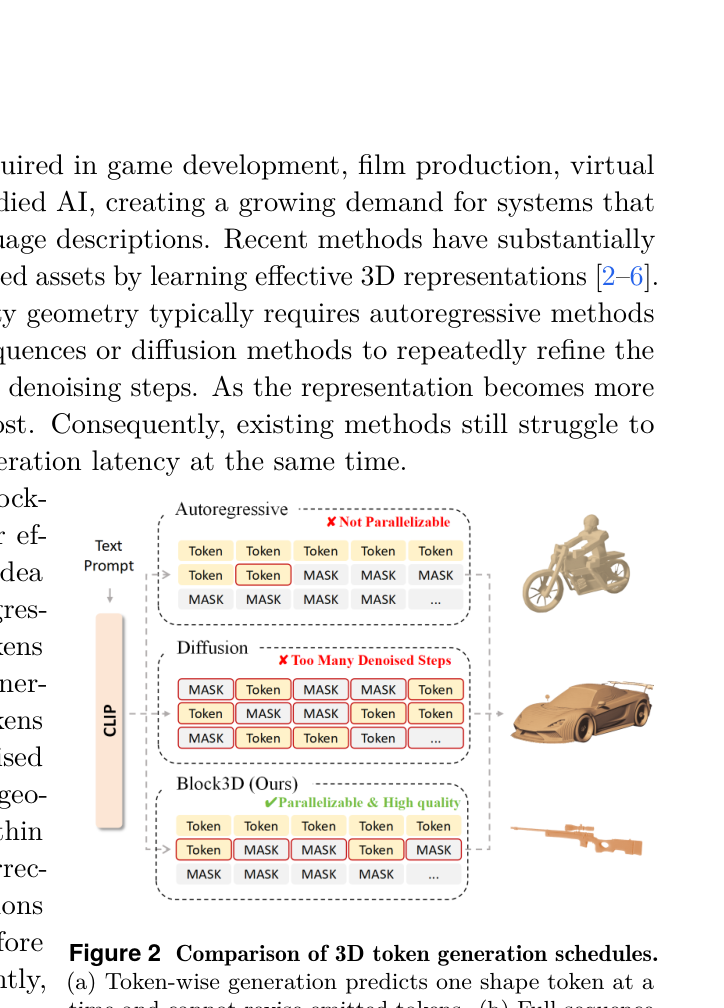
这张图对比了三种生成调度:逐token自回归、全序列扩散、块级扩散。重点观察块级扩散如何在因果约束和并行效率之间取得平衡——块间保持顺序依赖,块内允许双向注意力。
核心贡献
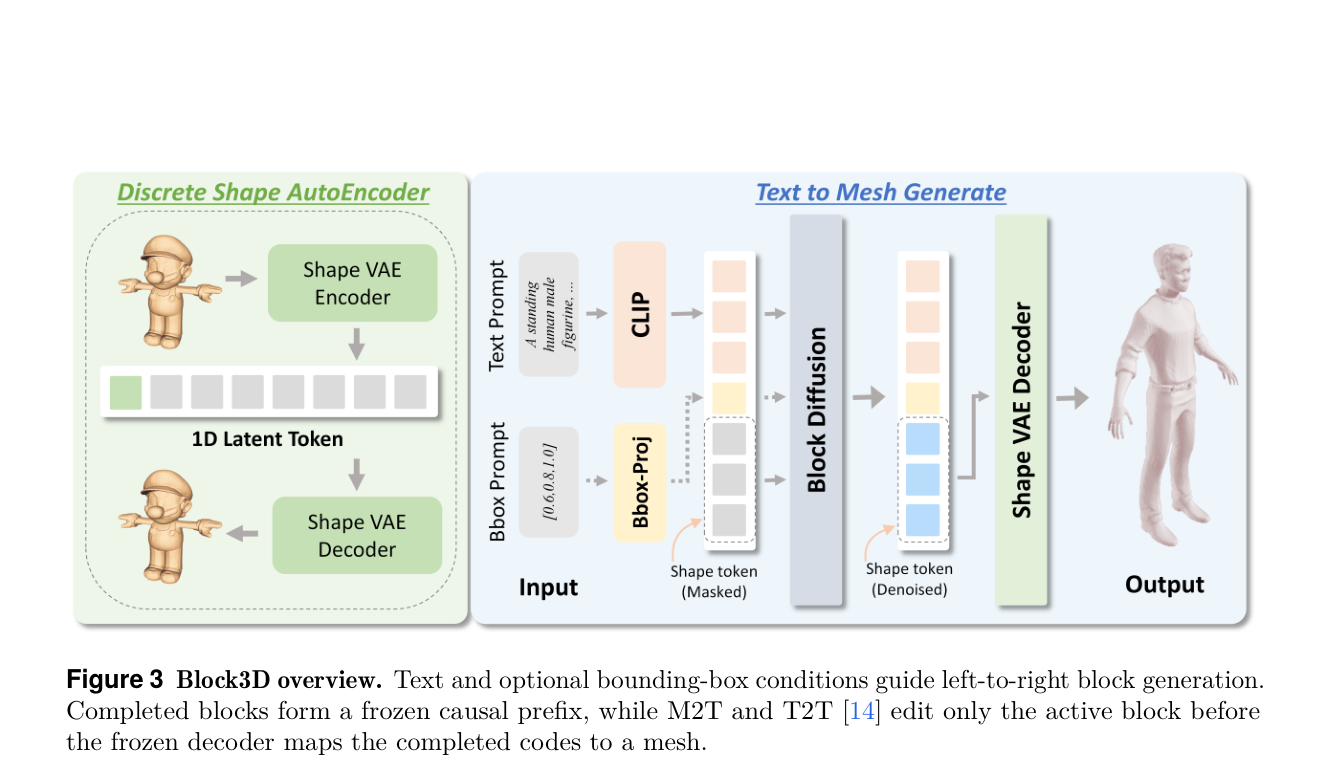
Block3D的整体架构图。注意已完成块形成冻结的因果前缀,M2T和T2T只编辑当前活动块,冻结解码器将完成的码映射为网格。这解释了为什么前缀缓存能带来效率优势。
验证与证据
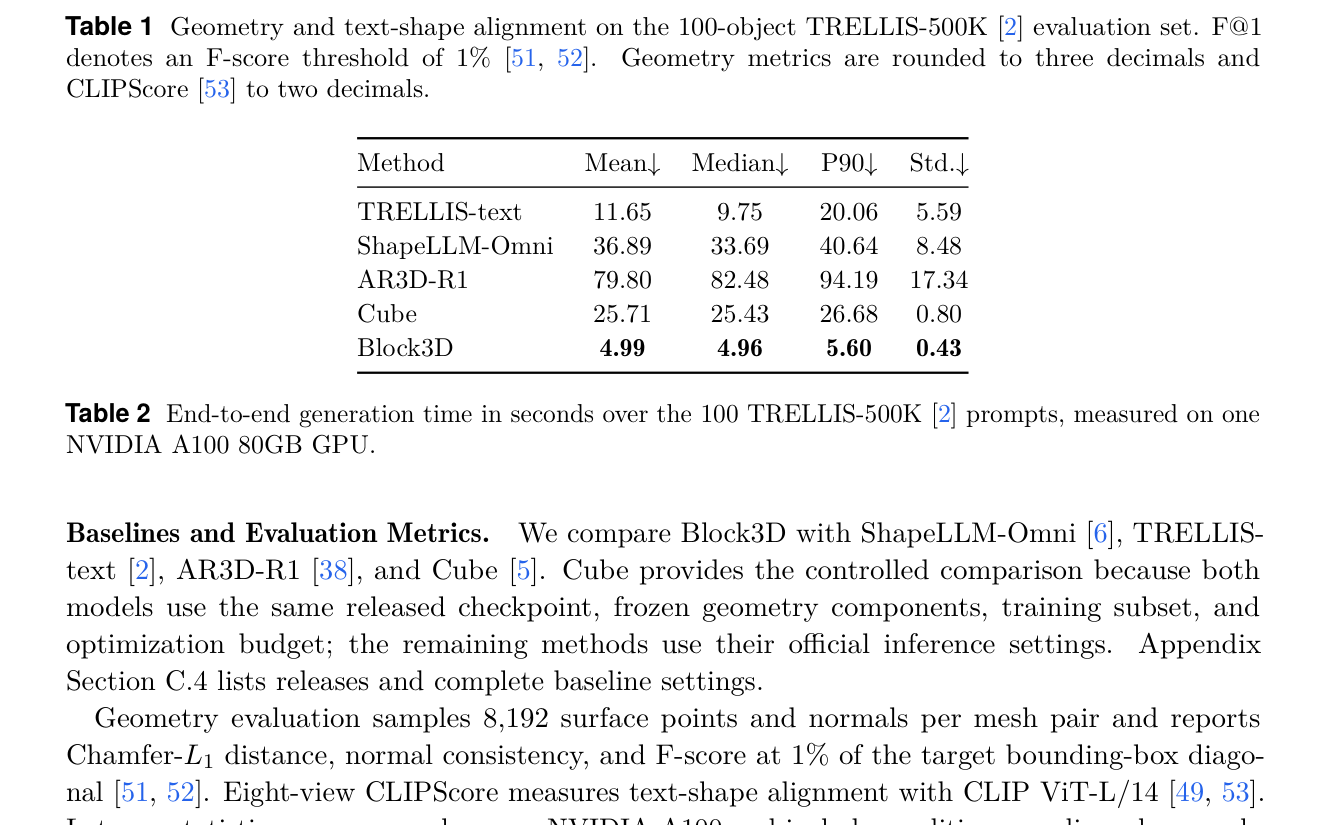
主结果表。Block3D在CD-L1、NC、F@1%上均优于Cube,但CLIPScore略低。这说明几何质量的提升以轻微的文本对齐下降为代价。
结论与局限
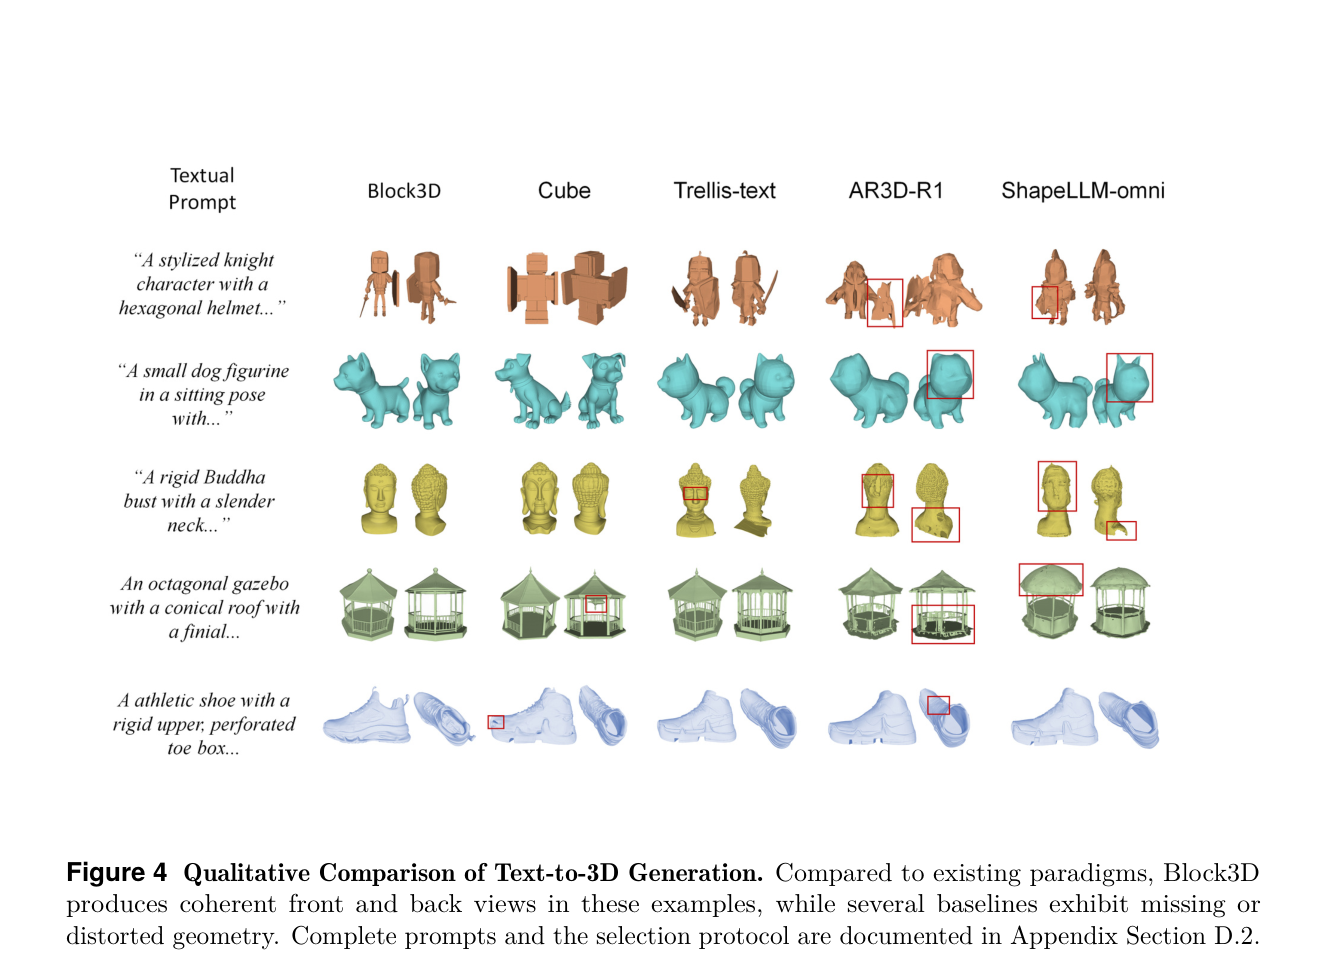
定性对比结果。Block3D生成的前后视图更连贯,而几个基线出现缺失或扭曲的几何。这支持了块内双向注意力能更好利用局部上下文的主张。
实验如何设计?
- 在TRELLIS-500K的100个留出对象上评估,对比ShapeLLM-Omni、TRELLIS-text、AR3D-R1、Cube四个基线。
- 几何指标包括CD-L1(Chamfer-L1距离)、NC(法线一致性)、F@1%(阈值为目标包围盒对角线1%的F-score),文本对齐用CLIPScore。
- 端到端延迟在单张NVIDIA A100 80GB GPU上测量,覆盖从文本输入到网格输出的完整流程。
- 消融实验:块大小B∈{32,64,96,128,256}、每块去噪步数T∈{4,8,12,20}、T2T编辑的有无。所有消融配置均独立训练。
关键结果与论文证据
- 主结果(第9页):Block3D的CD-L1=0.078、NC=0.668、F@1%=0.309,均优于Cube的0.094、0.632、0.219,说明块级扩散在几何质量上不降反升。
- 延迟(第9页):Block3D平均端到端时间4.99秒(中位数4.96秒,P90=5.60秒),Cube为25.71秒,加速约5.15倍。
- CLIPScore(第9页):Block3D为23.24,略低于Cube的23.87,说明文本-形状对齐并非全面领先,这是需要诚实面对的权衡。
- 块大小消融(第10页):B=64时F@1%=0.309、时间4.99秒;B=256时F@1%骤降至0.103、时间2.15秒。块内并行去噪的能力有限,块过大时质量显著下降。
- 去噪步数消融(第10页):T=4时F@1%=0.309、时间4.99秒;T=20时F@1%=0.303、时间13.66秒。增加去噪步数没有单调的质量收益,说明4步已接近饱和。
- T2T消融(第10页):加入T2T后CD-L1从0.081降至0.078(降4.7%),F@1%从0.287升至0.309,CLIP从22.74升至23.24,证明块内修正机制对质量有实质贡献。
阅读时需要注意
- 已完成块不可修正,跨块曝光偏差仍然存在:训练用teacher-forced clean prefix,推理用token-causal generated prefix,分布不一致。
- 块顺序沿用Cube的一维码序,不针对语义部件结构。PartDiffuser已经展示了语义部件分组的好处,Block3D尚未利用这一信息。
- 仅在Cube的固定长度VQ表示上验证,未扩展到其他3D表示(如隐式场、高斯泼溅)。
- 评估集仅100个对象,统计范围有限,结论的外推需要谨慎。
关联工作
- Cube(第3页):提供冻结的VQ形状表示(N=1024, V=16384)、DualStream RoFormer生成器初始化及受控基线。Block3D的所有改进都建立在这个冻结表示之上。
- Block Diffusion(第4页):提供块级自回归分解、块内双向去噪、clean/noisy训练注意力和前缀缓存机制。Block3D将其从文本域迁移到3D形状域。
- LLaDA2.1(第4页):提供M2T/T2T可编辑解码机制与多轮前向增强,Block3D采用其置信度阈值默认值(M2T=0.95, T2T=0.9)。
- PartDiffuser(第3页):以语义部件为因果组进行部件内去噪。Block3D与其不同在于使用无部件的固定长度Cube码,不依赖部件分割。
- TSSR(第3页):全局离散mesh-token生成后remasking细化。Block3D在块内而非全局进行修正,修正范围更局部、更高效。