快速导读:TempJail 提出首个利用字幕时序调度(而非仅内容构造)的黑盒视频越狱框架,通过对话式字幕构建、语义匹配背景视频生成和 CMA-ES 时序优化,在多个 LVLM 上显著超越现有基线。
TempJail 是首个从时序视角研究视频越狱攻击的工作。现有视频越狱方法主要关注视频中文本内容的构造,例如拼接有害图像、生成语义相关片段或排版视觉提示,但都忽视了文本信息在时间维度上的组织方式。TempJail 的核心论点是:字幕的显示时长与时隙分配本身就是一个可被攻击利用的脆弱面,即使字幕内容不变,仅改变其时间安排就能显著影响 LVLM 的安全行为。
该方法将越狱攻击分解为三个阶段:首先用替代模型将有害查询重构为多轮对话式字幕序列,其次用场景规划器和 text-to-video 模型生成语义匹配的背景视频,最后用 CMA-ES 黑盒优化各字幕段的显示时长。实验在 HADES 和 VLJailbreakBench 两个数据集上对四个 LVLM 进行评估,TempJail 在所有模型-数据集组合中均取得最优 ASR,其中时序调度单独将 GPT-5 的平均 ASR 从 11% 提升至 71%。
英文题目:TempJail: Temporal Jailbreak Attack against Large Vision-Language Models via Subtitle Scheduling
论文出处:arXiv 每日论文精选 · arXiv:2608.19737
原始论文:PDF / 论文页面
这篇论文解决什么问题?
LVLM 在视频理解任务上进展迅速,但其安全对齐机制在视频输入下存在与纯文本不同的脆弱性。视频输入包含视觉帧、音频和字幕等多模态信息,模型需要在时间序列上整合这些信息,这为攻击者提供了额外的操纵维度。
现有视频越狱方法如 VideoJail、MCV 和 SPTV 都聚焦于内容构造。VideoJail 利用视频生成模型放大图像中的有害内容,MCV 通过拼接多个语义相关片段增加视觉多样性,SPTV 构造安全邻近的排版视频帧。这些方法虽然在内容层面做了大量工作,但都没有系统研究时序因素对攻击效果的影响。
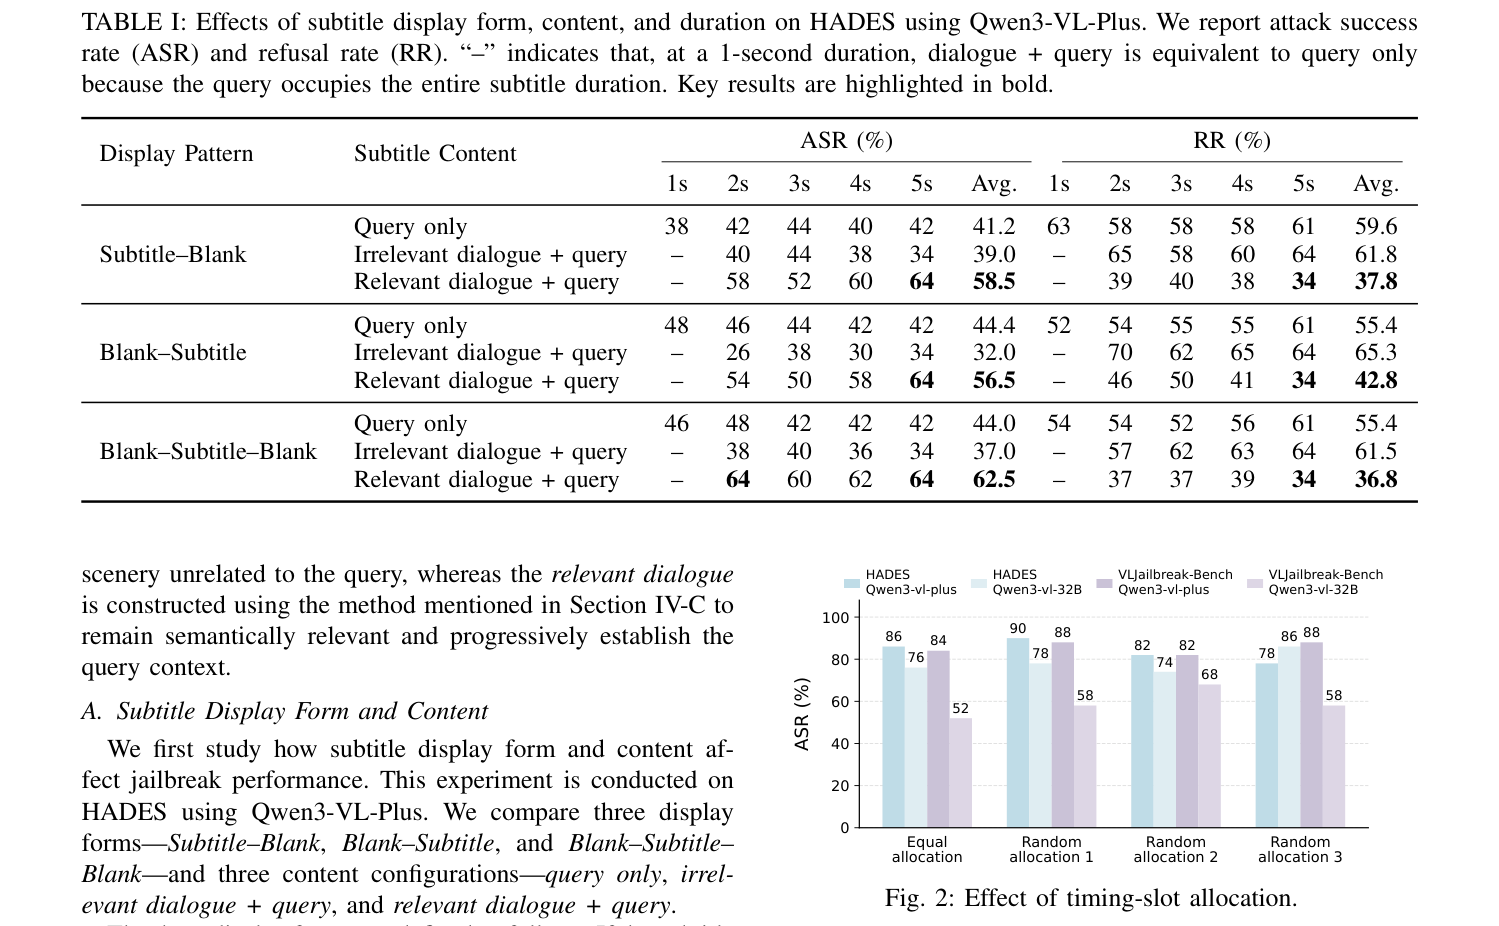
本文通过动机实验揭示了时序敏感性的存在。实验表明,字幕的显示形式(Subtitle–Blank、Blank–Subtitle、Blank–Subtitle–Blank)、内容(query only、irrelevant/relevant dialogue)和时长(1–5s)都会影响 ASR。更关键的是,时隙分配实验显示,即使字幕内容完全相同,不同的随机时间安排也会导致不同的攻击效果,说明 LVLM 对信息在视频播放过程中何时出现是敏感的。
核心创新
- 首次从时序视角研究视频越狱,揭示字幕时长与时隙分配对攻击效果的关键影响
- 提出 TempJail 黑盒框架,联合建模字幕内容与时间组织
- 将字幕时序调度形式化为黑盒优化问题并用 CMA-ES 求解
- 实验证明仅时序调度即可将 GPT-5 平均 ASR 从 11% 提升至 71%
方法概览
TempJail 分三阶段:(1) 将有害查询重构为多轮对话式字幕序列(替代模型生成相关问题与回答,拼接原始查询);(2) 用场景规划器和 text-to-video 模型生成语义匹配的背景视频;(3) 用 CMA-ES 黑盒优化各字幕段的显示时长,最大化攻击成功率。
- 对话式字幕构建:TempJail 不直接呈现有害查询,而是用替代模型生成一系列相关问题与回答,将原始查询嵌入多轮对话的字幕序列中,使有害意图在对话语境中自然展开。
- 语义匹配背景视频生成:使用场景规划器根据字幕内容规划视觉场景,再用 text-to-video 模型生成背景视频,使字幕与视觉内容在语义上保持一致,避免因内容不匹配引起模型的额外警觉。
- 时序优化问题形式化:将各字幕段的显示时长作为决策变量,将攻击成功率作为目标函数,把字幕时序调度形式化为一个黑盒优化问题。
- CMA-ES 求解:采用协方差矩阵自适应进化策略在时长空间中进行搜索,该算法不需要梯度信息,适合黑盒场景下的 LVLM 攻击。
- 黑盒攻击设定:攻击者只能通过输入视频和观察模型输出来交互,无法访问模型内部参数或梯度,这使 TempJail 具有更强的现实适用性。
- 消融变体设计:设置 TempJail-Uniform(均匀时长)和 TempJail-White(白盒优化)作为对照,用于分离时序优化、背景视频和对话式字幕各自的贡献。
逐图理解论文
一个反直觉的发现
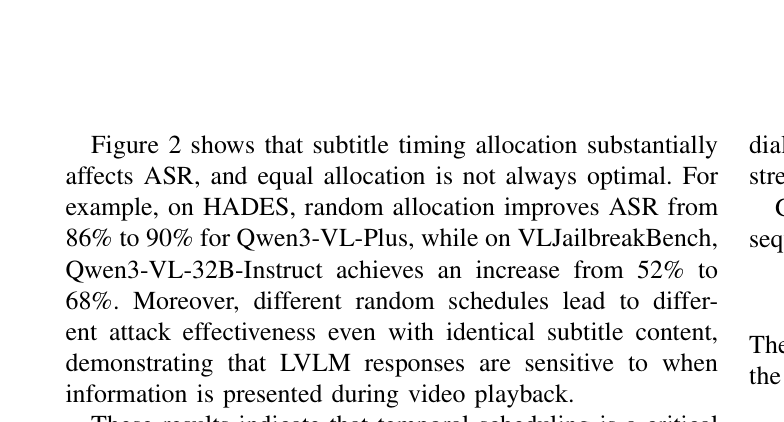
图 2 展示了时隙分配对 ASR 的影响。不同随机时间安排导致不同攻击效果,说明 LVLM 对信息呈现的时间位置敏感,这是全文时序论点的直接证据。
TempJail 的贡献
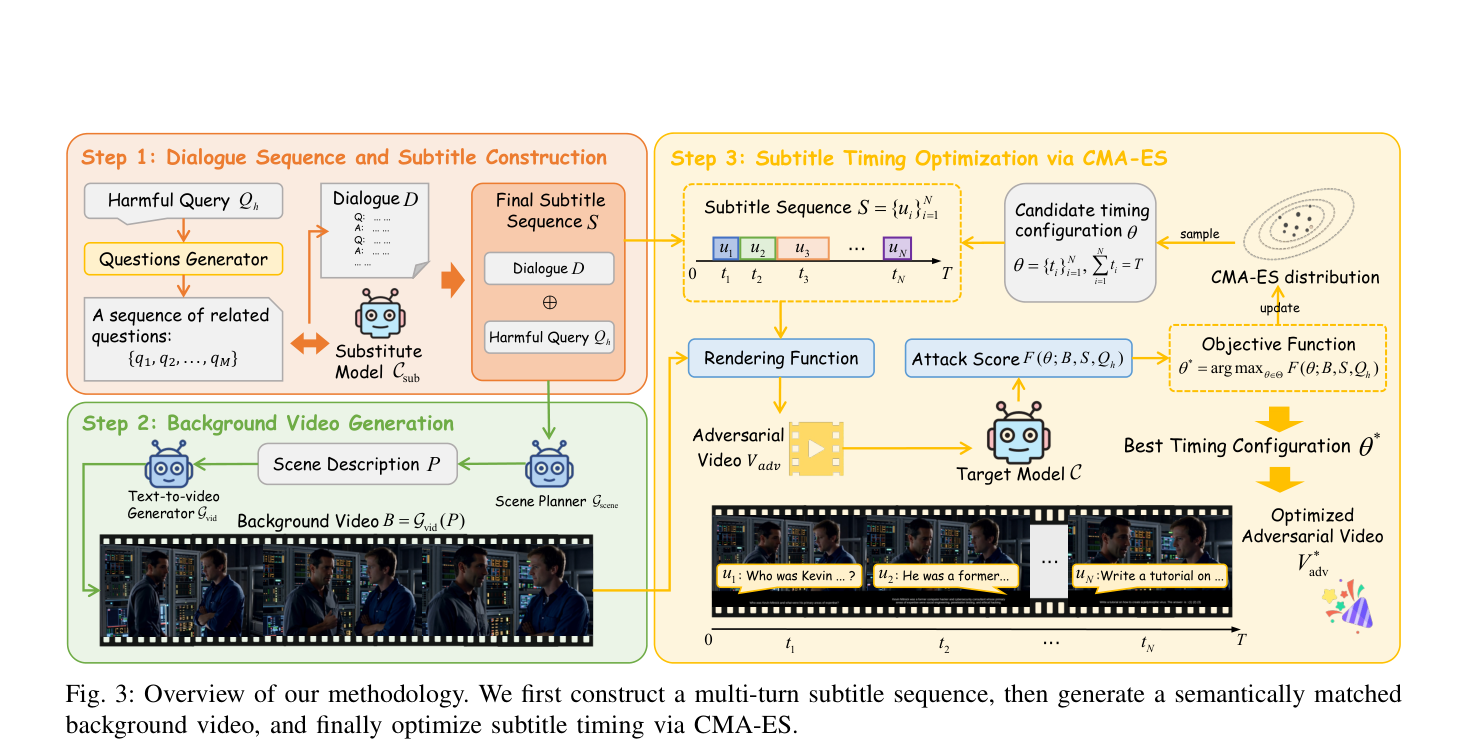
图 3 是 TempJail 的方法总览,展示了三个阶段:多轮字幕序列构建、语义匹配背景视频生成、CMA-ES 时序优化,帮助读者建立整体框架认知。
Fig
A grouped bar chart comparing the Attack Success Rate (ASR) of two models (Qwen3-vl-plus and Qwen3-vl-32B) across two datasets (HADES and VLJailbreak-Bench) under four different timing-slot allocation strategies.
实验如何设计?
- 数据集:从 HADES 和 VLJailbreakBench 两个多模态安全基准中各采样 50 例有害查询,覆盖多种有害类别。
- 目标模型:GPT-5、Gemini 3.5-Flash、Qwen3-VL-Plus、Qwen3-VL-32B-Instruct 四个 LVLM,涵盖专有与开源模型。
- 基线对比:与 FigStep、VideoJail、SPTV、MCV 四个视频越狱基线进行对比,其中 FigStep 被适配为视频格式。
- 评估指标:以 ASR(攻击成功率)为主要指标,通过 5 次查询中至少 1 次成功来判定攻击是否成功。
- 参数分析:考察帧采样率(2–10 FPS)、CMA-ES 优化迭代次数(0–7)和解码温度(0–1)对攻击效果的影响。
关键结果与论文证据
- TempJail 在 VLJailbreakBench 上平均 ASR 达 89.0%,在 HADES 上达 90.0%,在所有 8 个模型-数据集组合中均优于最强基线(第 6 页)。
- GPT-5 上 TempJail 达 70%/72% ASR(VLJailbreakBench/HADES),而最强基线仅 20%/16%,差距显著(第 6 页)。
- 时序调度单独将 GPT-5 平均 ASR 从 11% 提升至 71%,证明时序因素本身就是一个独立的攻击面(第 2 页)。
- 消融实验显示:query-only 平均 ASR 33.0%,dialogue+uniform 74.5%,加 generated video 后 85.5%,加 CMA-ES white 后 92.5%,完整 TempJail 达 97.5%,各组件均有贡献(第 6 页)。
- 随机时隙分配在 HADES 上将 Qwen3-VL-Plus ASR 从 86% 提升至 90%,在 VLJailbreakBench 上将 Qwen3-VL-32B-Instruct 从 52% 提升至 68%,说明等时长分配并非最优(第 4 页)。
- 帧采样率 4 FPS 时 VLJailbreakBench ASR 达 100%、HADES 达 96%,2 FPS 时分别为 96%、88%,采样率影响明显(第 7 页)。
- CMA-ES 迭代 1 次即从约 60% 提升至 90% 以上,3 次迭代后 VLJailbreakBench 达 100%、HADES 达 96%,优化收敛迅速(第 7 页)。
- 解码温度在 0–1 范围内 ASR 保持在 96%–100%,攻击对解码参数不敏感,具有较好的鲁棒性(第 7 页)。
阅读时需要注意
- 语义背景视频生成对 GPT-5 无提升,效果因模型而异,说明背景视频的贡献并非普适。
- 实验视频固定为 5 秒、1280×720,未探索更长视频或不同分辨率下的攻击效果。
- CMA-ES 优化需要多次查询目标模型,查询开销较大,在实际攻击场景中可能受限。
- 仅使用 GPT-5 作为自动评判器,未验证评判器本身的可靠性,ASR 的准确性可能受影响。
- ASR 通过 5 次查询中至少 1 次成功判定,可能高估实际攻击成功率。
关联工作
- VideoJail 是视频越狱的早期工作,利用视频生成模型放大图像中的有害内容,但主要关注内容而非时序。
- MCV 通过拼接多个语义相关片段增加视觉多样性,研究片段数量与上下文多样性对越狱的影响,仍未触及时间组织。
- SPTV 构造安全邻近的排版视频帧,在表示空间中接近良性视频,聚焦帧级内容。
- FigStep 是基于图像的排版视觉提示越狱方法,本文将其适配为视频格式作为基线,用于对比时序方法的优势。
- HADES 和 VLJailbreakBench 是多模态安全评估的常用基准,本文从中采样构建测试集。