快速导读:本文提出在训练分布仅覆盖评测集25%的PhysAI Dynamic 4D Reconstruction Challenge中,冻结预训练4RC骨干、仅通过三种推理时解码配置的凸融合取得第三名(0.58356 APD),并系统记录了13次微调中12次在挑战指标上退化的负结果。
Gallileo-4D 是 PhysAI Dynamic 4D Reconstruction Challenge 的第三名方案。该挑战要求从单目视频恢复场景的3D几何及其时间演化,在128条合成序列上评测512个查询点在32个时间戳的世界坐标定位精度。本文的核心发现是:当训练数据仅覆盖评测分布的25%时,基于局部验证的微调会系统性地破坏预训练特征在其余75%数据上的泛化能力,而局部验证无法检测这种退化。
作者因此采取了一条反直觉的路线:完全冻结预训练的4RC骨干,不做任何梯度更新,仅通过三种推理时解码配置的凸融合来提升性能。整个系统唯一拟合的参数是三个融合权重,通过公开榜上的二维网格搜索确定。最终以0.58356 APD获得第三名,融合增益+0.01344 APD超过了所有13次训练运行中任何一次的正贡献。
英文题目:Gallileo-4D: Frozen Backbone Ensemble for Dynamic 4D Reconstruction
论文出处:arXiv 每日论文精选 · arXiv:2608.19743
原始论文:PDF / 论文页面
这篇论文解决什么问题?
挑战的训练数据只包含 syn4d_sim 一个渲染变体,而评测集均匀分布在四个渲染变体上,其中三个没有训练对应物。这意味着任何基于训练集或局部验证的模型选择,都只在25%的评测分布上有信息量。
作者通过三个校准点验证了局部代理与挑战分数之间的不一致性:一个检查点替换在挑战榜上的增益是局部增益的4.2倍;一个 SlotTABA 时序聚合模块让局部分数提升+0.0129,却让挑战分数从0.512暴跌至0.1677;微调运行的平均局部改善与挑战退化方向相反。
这种不一致的根源在于分布偏移。Kumar 等人的工作已经指出,微调会在分布偏移下扭曲预训练特征。本文的13次微调实验为这一理论提供了具体的实证记录:11次运行局部验证改善的同时挑战分数退化。
作者由此提出一条操作规则:当验证分布只覆盖评测分布的少数时,局部验证只能用作否决——即如果局部分数大幅下降则拒绝该方案——而不能用作晋升门槛,因为局部改善无法预测挑战表现。
核心创新
- 系统记录了13种微调配置中12种在挑战指标上退化、同时局部验证改善的完整负结果(含学习率、损失、分数)
- 提出'局部验证仅作回归否决、不作晋升门槛'的操作规则,适用于验证分布仅覆盖评测分布少数时的场景
- 构建纯推理时冻结骨干集成Gallileo-4D,仅拟合3个融合权重即获第三名,融合增益+0.041 APD超过所有训练运行
- 表征了分辨率从512px升至1008px时几何头输出尺度坍缩30×的失效模式
方法概览
冻结4RC骨干(geofinetune检查点+train_v2头部),在512px分辨率、W=48滑动窗口下,以三种解码配置——stride-3(跨144帧长时上下文,权重0.60)、水平翻转TTA(权重0.25)、stride-1(全48帧密集时序,权重0.15)——分别前向推理,将三组世界坐标点图按固定凸权重融合。融合权重通过公开榜上的二维网格搜索确定,全程无梯度更新。
- 骨干网络是冻结的4RC,使用 geofinetune 检查点加 train_v2 头部,在512px分辨率、W=48滑动窗口下前向推理。
- 三种解码配置分别是:stride-3,每三帧取一帧,跨144帧的长时上下文,权重0.60;水平翻转TTA,对stride-3模式做镜像输入并镜像回预测点图,权重0.25;stride-1,全48帧密集时序,权重0.15。
- 三组世界坐标点图按固定凸权重融合。由于三者共享同一个冻结骨干,因此共享同一尺度约定,在世界坐标中直接平均是有意义的。
- 融合权重通过公开榜上的二维网格搜索确定,最优配置为(0.60, 0.25, 0.15),表面平坦——8个最优配置之间的差距小于0.0015 APD。
- 整个系统没有任何梯度更新,唯一拟合的量就是这三个融合权重。训练消耗约1000 GPU-hours,推理168 GPU-hours。
- 作者还尝试了1008px分辨率分支,但发现几何头输出的中位数尺度从期望的3.5坍缩至0.117,约30倍缩小,中位数对齐无法修复这种非全局一致的坍缩,因此该分支被排除。
逐图理解论文
一个具体的失败案例
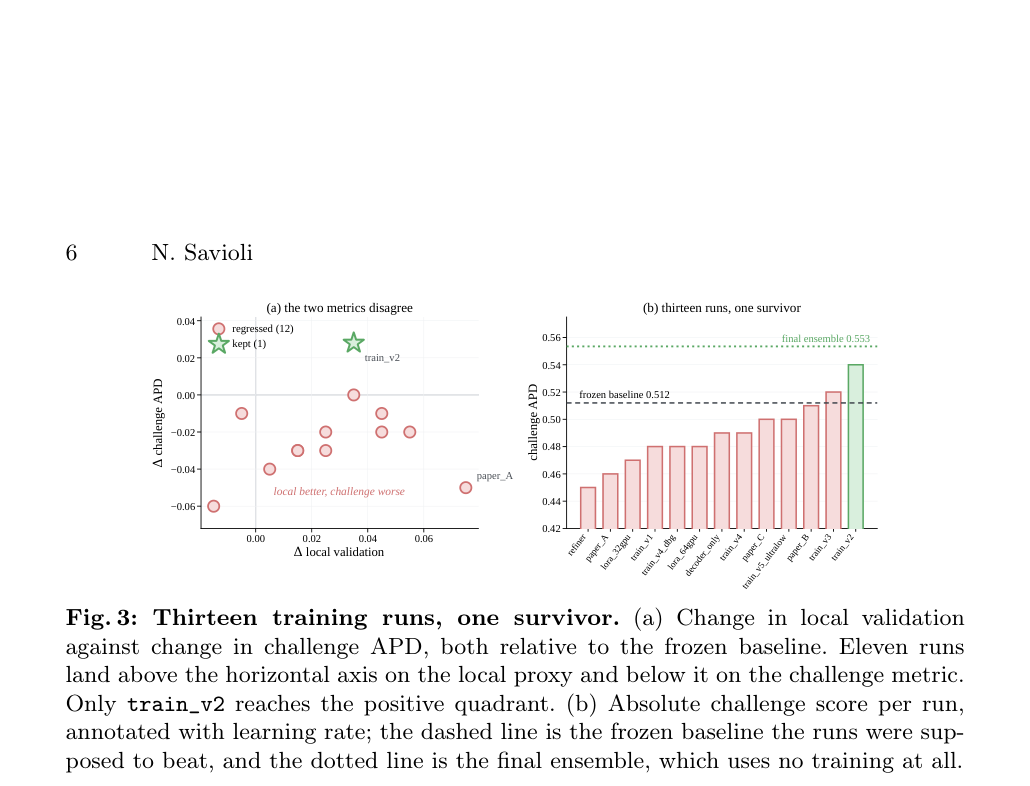
左图显示11次微调运行落在局部改善但挑战退化的象限,右图显示只有train_v2超过了冻结基线。这张图直观呈现了'局部验证不可信'的核心发现。
研究缺口:局部验证的盲区
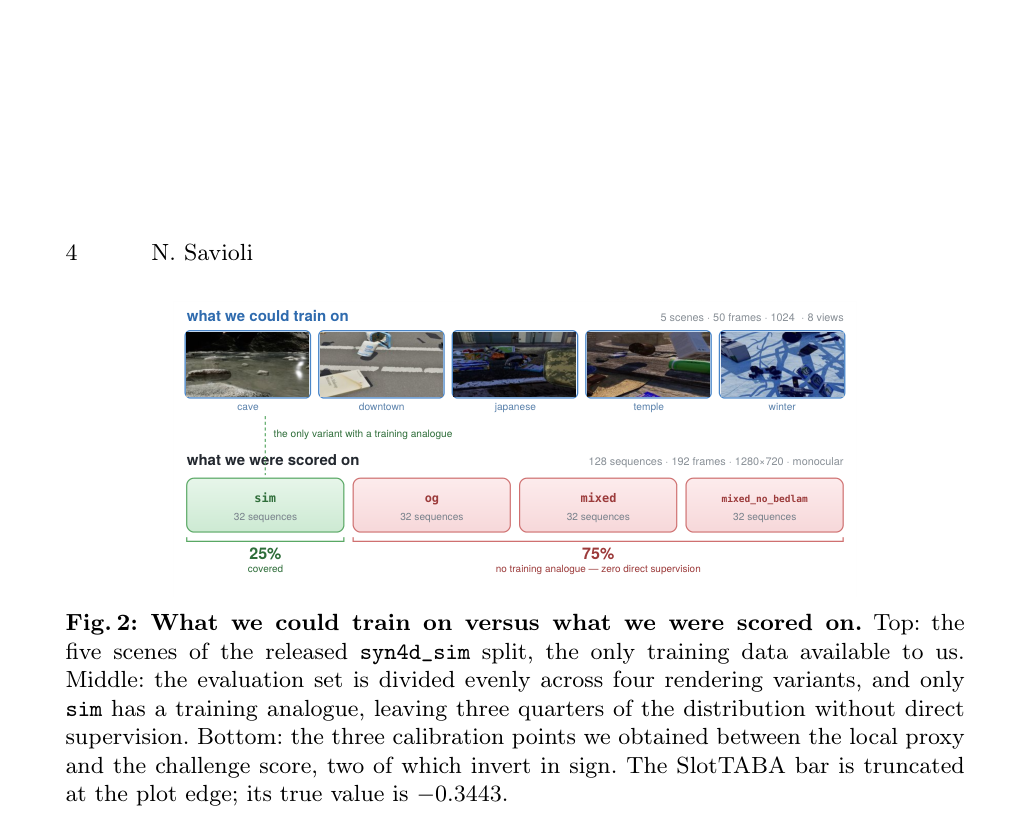
这张图展示了训练分布与评测分布的错位:训练只有sim一个渲染变体,评测均匀分布在四个变体上。底部的三个校准点显示局部代理与挑战分数之间有两个符号反转,这是本文核心论点的直接证据。
方法:冻结骨干加推理时集成
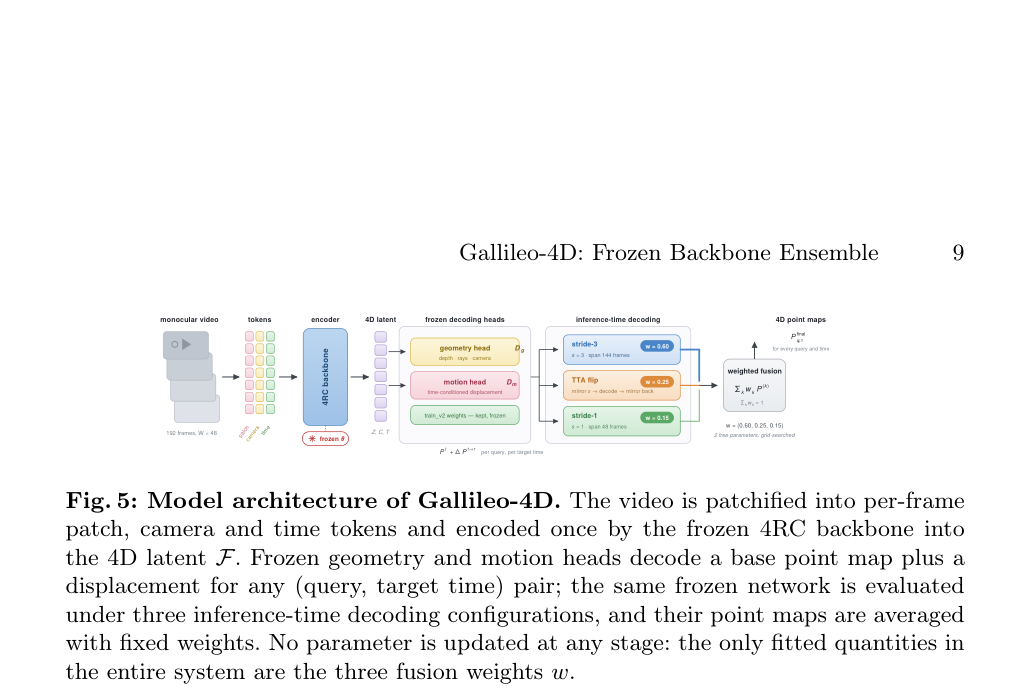
架构图展示了冻结骨干被三种解码配置共享,唯一拟合的参数是三个融合权重w。注意图中没有任何梯度回传路径,这是理解本文方法的关键。
证据:融合增益超过所有训练
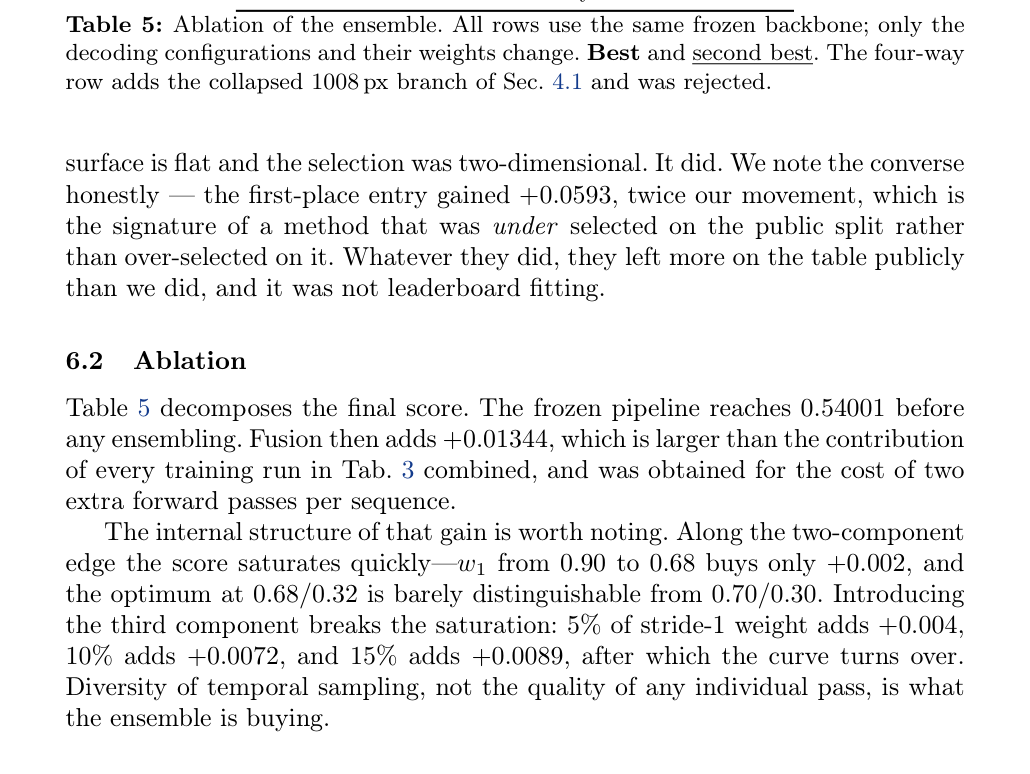
结果很干脆:冻结基线0.512,集成后0.553,融合增益加0.0134,超过了13次训练运行中任何一次的正贡献。最终榜上拿到第三名。作者还发现一个有意思的失效模式:把分辨率从512升到1008,几何头输出的尺度直接坍缩了约30倍,中位数对齐也救不回来。
结论与意义
这篇论文最有价值的不是第三名,而是那条操作规则:当验证分布只覆盖评测的少数时,局部验证只能用来否决,不能用来晋升。冻结骨干加推理时集成,成本只是多跑两次前向,却比任何微调都可靠。当然,结论只来自一个基准和一个骨干,推理成本也是单次前向的三倍。以上就是这篇论文的核心内容,感谢收听。
实验如何设计?
- 13种微调配置对比,包括全网络微调、激进调度、LoRA、轻量细化,以冻结基线0.512 APD为参照。
- 三种解码配置的消融:stride-3单独0.54256,加TTA达0.54455,再加stride-1达0.55345。
- 融合权重的二维网格搜索,在公开榜上评估。
- 1008px分辨率分支的加入测试,分数从0.55345降至0.54923,被拒绝。
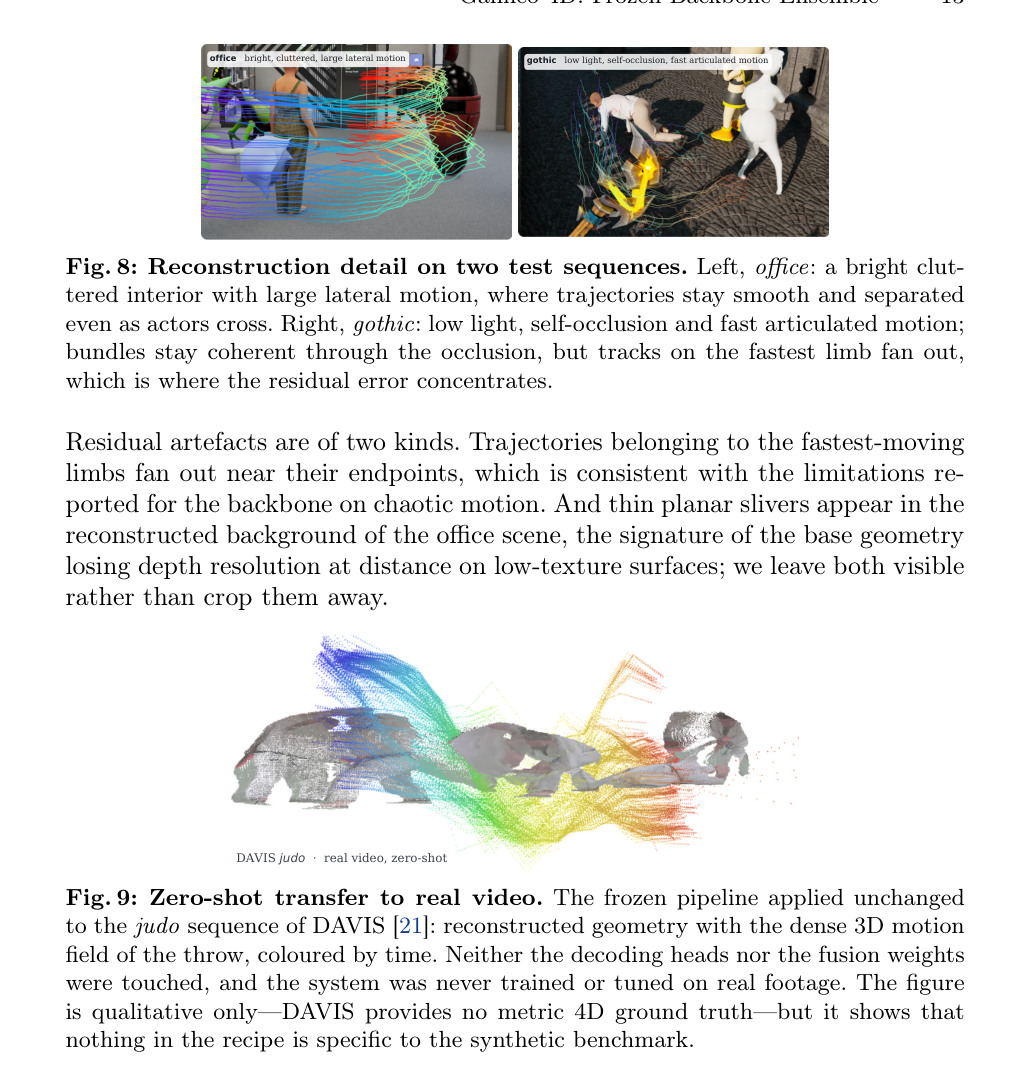
- DAVIS真实视频的零样本定性迁移实验,验证方法不依赖合成基准。
关键结果与论文证据
- 最终榜第三名,0.58356 APD,27支队伍参赛(第11页)。
- 冻结基线0.512 APD,集成后0.55345 APD,融合增益+0.01344(第12页)。
- 13次微调中12次挑战分数退化,其中11次局部验证同时改善(第6页)。
- SlotTABA模块局部+0.0129,挑战榜−0.3443,是负结果中最极端的案例(第5页)。
- train_v2(lr=5×10⁻⁶,1 epoch)挑战+0.028,是唯一显著正收益的训练运行(第7页)。
- paper_A(lr=1×10⁻⁴,5 epochs)取得局部最优0.48,但挑战分数0.46,相对基线−0.052(第7页)。
- 1008px分辨率下中位数尺度从3.5坍缩至0.117,约30倍(第8页)。
- 公开榜与最终榜的所有条目在私有75%上均高于公开25%,说明两个分布不可互换(第11页)。
阅读时需要注意
- 系统需要对每条序列运行骨干3次,推理成本约为单次前向的3倍,不适合部署场景。
- 结论来自单一基准(Syn4D)和单一骨干(4RC),泛化性未经验证。
- 融合权重在公开榜上选择,存在自适应数据分析的残余风险,虽然权重空间是二维的且表面平坦。
- 未尝试WiSE-FT式权重插值、变体条件自适应或合成缺失变体等替代方案。
- 本文报告的微调失败不构成'微调不可能成功'的证明,仅覆盖13种配置。
关联工作
- 4RC是本文使用的骨干网络,以冻结方式作为固定函数。DUSt3R和MASt3R奠定了单次前向稠密立体几何回归的基础,VGGT、Pi3、Depth Anything 3将其扩展到多视图。
- Kumar等人的工作解释了微调在分布偏移下破坏预训练特征的理论机制,本文的负结果为这一理论提供了竞赛场景下的实证。
- WiSE-FT通过向零样本权重插值修复微调损伤,是本文未尝试但值得探索的替代方案。
- TAPVid-3D是挑战指标最接近的3D点跟踪基准,继承了中位数尺度对齐的设计。