DINO
SemanTok:面向高效自回归视频生成的可预测语义token
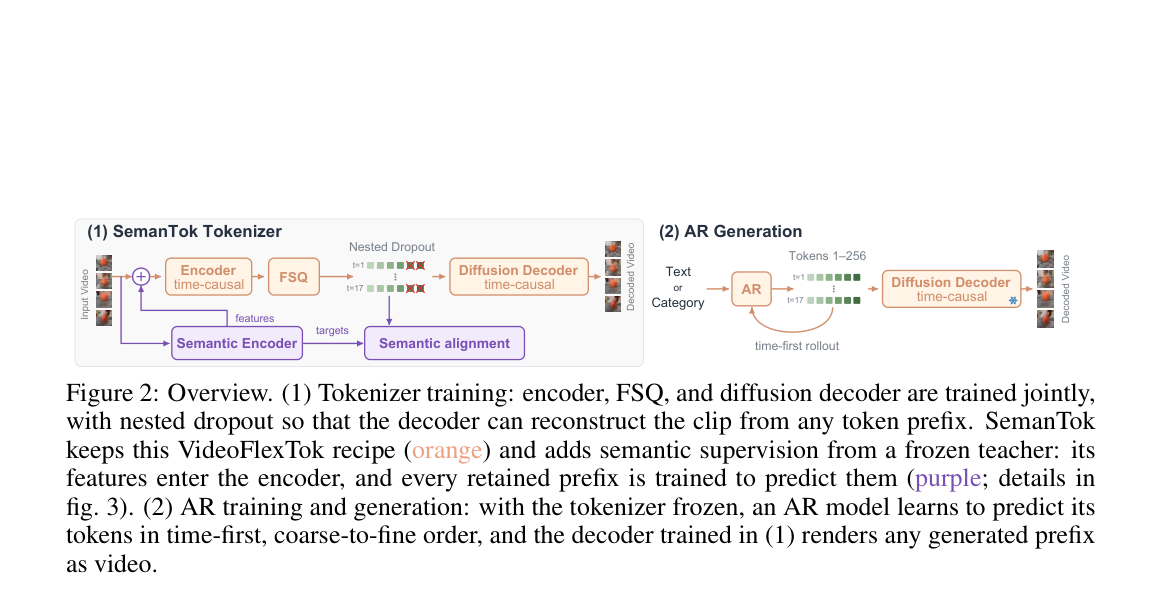
SemanTok 在灵活视频分词器上加入冻结 DINO 的编码器输入与前缀级语义头,让短 token 前缀先锁定片段语义,从而用更小的自回归模型达到更高生成保真与对齐。
PixRestore:无VAE像素扩散如何让统一图像复原既快又真
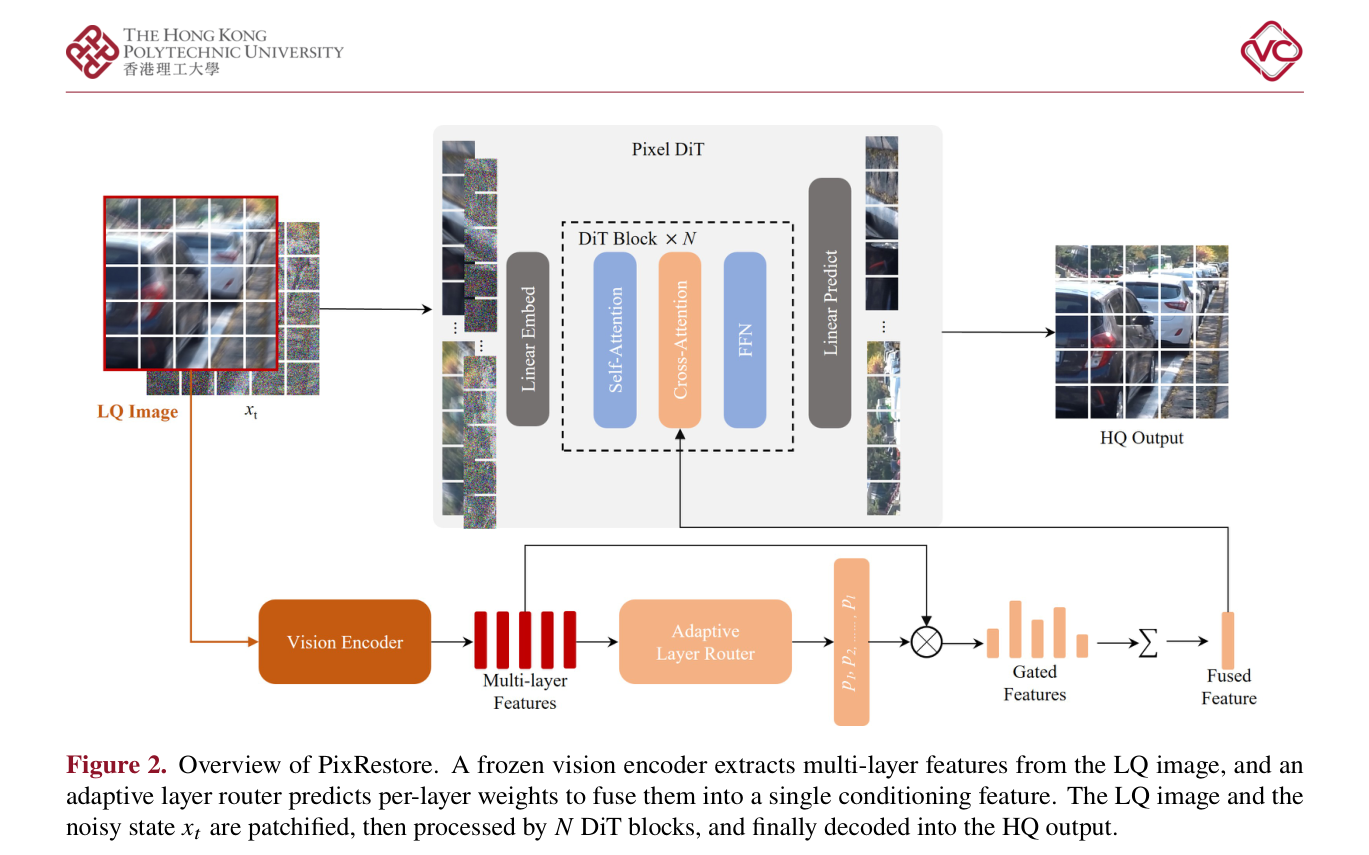
PixRestore提出一种无VAE的像素空间DiT统一图像复原模型,结合DINO自适应分层视觉引导与单步对抗微调,以约50M参数和44ms延迟在八类退化任务上取得最佳综合质量与效率。
EgoMonth:月级第一视角视频如何暴露多模态模型的长期记忆断层
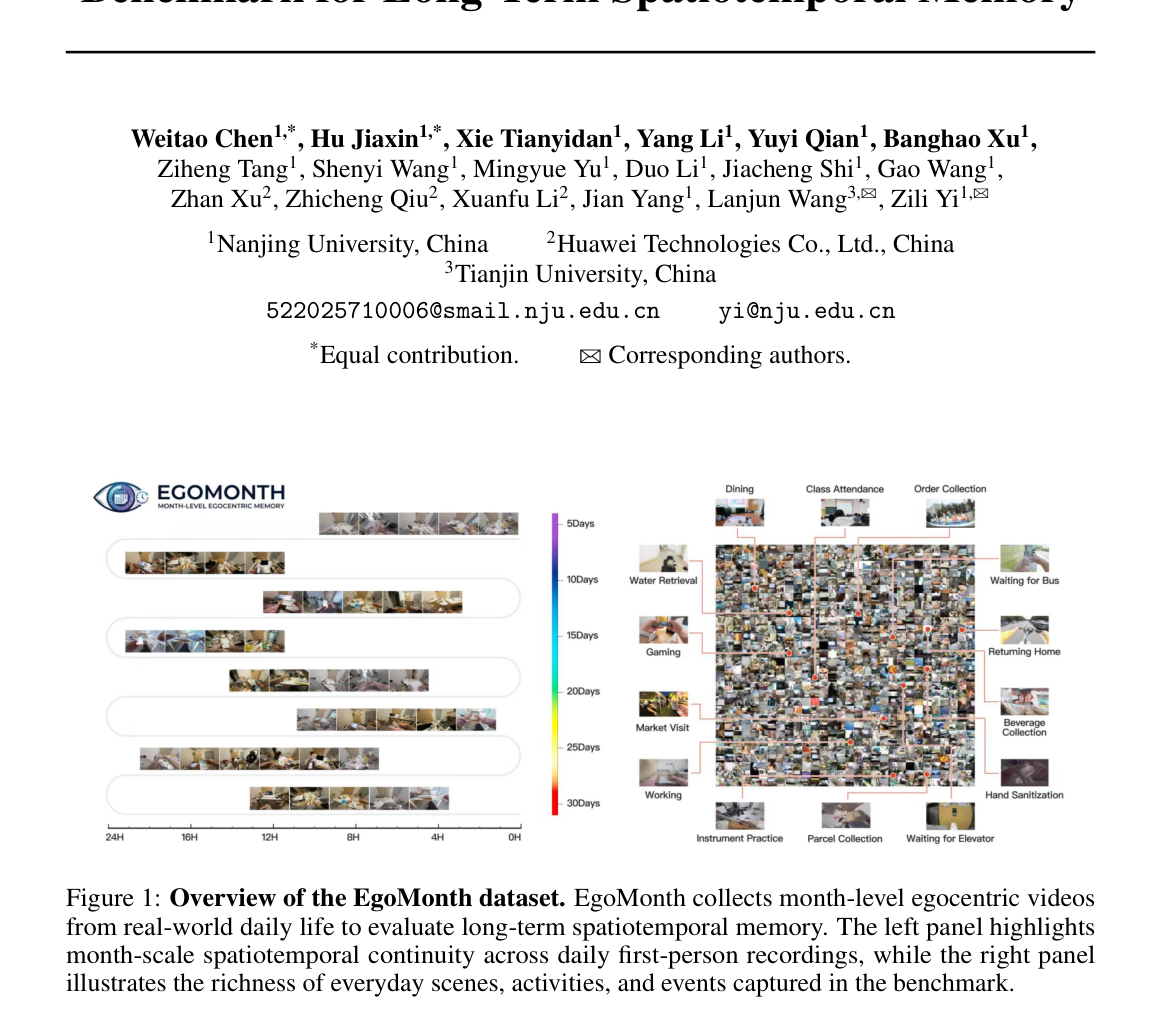
EgoMonth 提出首个跨 20–120 天、301 小时第一视角日常视频的月级基准,用 1,443 个人工 QA 和 14 任务三层认知框架评估 MLLM 的长期时空记忆,发现最强模型 Gemini 2.5 Pro 仅 71.8%,比人类低 22.4 个百分点。
测试时原型自适应:一个与模型架构无关的开放词汇分割即插即用模块
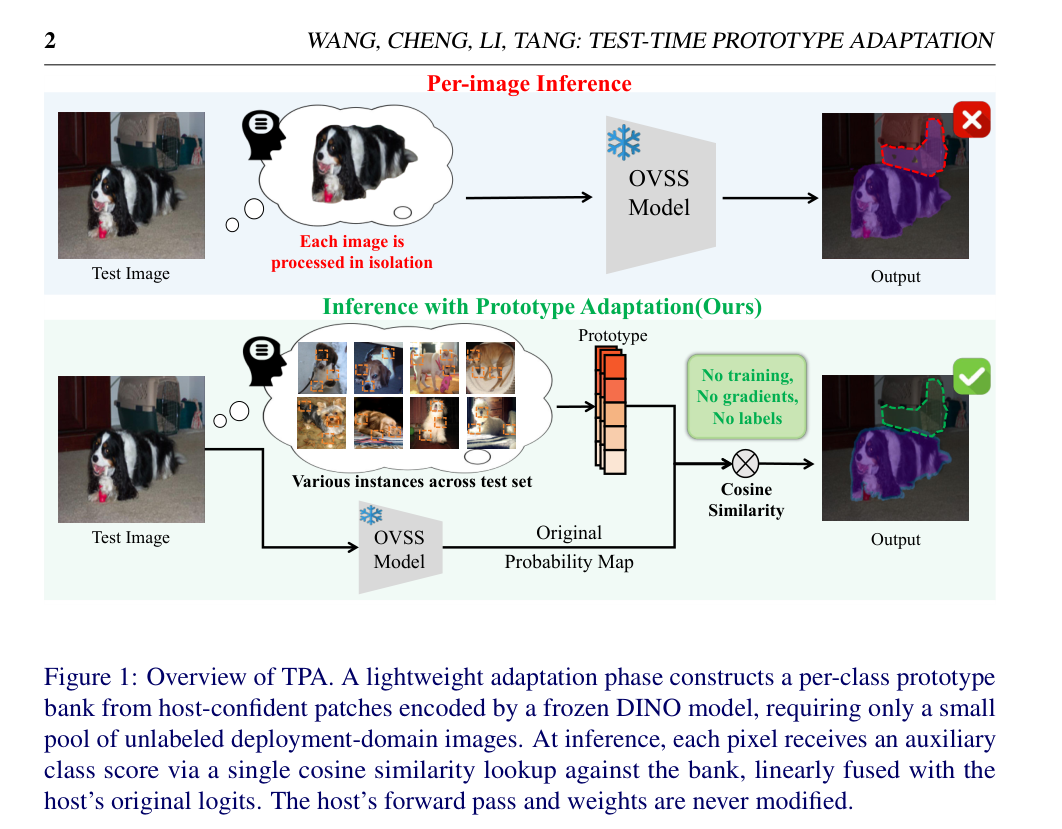
提出一种无需训练的即插即用模块TPA,在测试时利用少量无标签部署域图像构建DINO特征原型库,通过余弦相似度查找与主机logits线性融合,以输出级操作一致提升多种OVSS模型的精度。