快速导读:本文通过构造性分离实验证明,在统一多模态模型中,新概念绑定的跨任务可用性由其在共享计算中的入口深度和语义格式决定,而非由训练目标或参数共享程度决定。
统一多模态模型在同一骨干中同时处理理解与生成任务,但新概念绑定能否在两个方向间迁移,此前缺乏干净的测量。联合训练研究无法分离架构通道与数据监督的贡献,受控消融对生成目标是否帮助理解也存在分歧。本文的核心问题是:当新概念仅通过一个任务方向绑定到冻结模型时,未训练方向能否获得该概念?
作者设计了一个无污染协议:将新视觉实体(3D资产渲染加无行为伪词)仅通过生成或理解方向注入,测量相反方向的准确率。结果表明,跨任务可用性由绑定的入口深度和语义格式决定,而非训练目标或参数共享程度。这一发现直接挑战了'统一权重即统一能力'的直觉。
英文题目:Where a New Concept Must Enter: Entry Point Gates Cross-Task Usability in Unified Multi-modal Models
论文出处:arXiv 每日论文精选 · arXiv:2608.17564
原始论文:PDF / 论文页面
这篇论文解决什么问题?
统一多模态模型的吸引力在于共享计算,理论上理解与生成可以互相增强。但现有证据混乱:Janus的受控消融发现生成目标对理解有4.4点代价,解耦编码器后中性;UniToken在匹配每任务数据下发现生成对理解增益接近零;MetaMorph的数据比例网格显示生成增益随理解数据量增加而缩小。这些研究都以模型为分析单位,无法定位失败发生在哪一层、哪个模块。
更根本的问题是联合训练的混淆:当模型同时看到理解和生成数据时,无法判断跨任务能力来自架构通道还是来自数据监督。本文的切入点是构造性分离——只在一个方向注入概念,测量另一个方向,从而把架构通道单独暴露出来。
此外,现有评估存在一个隐蔽的陷阱:多选探针把候选词放在提示里,模型只需做匹配操作即可通过,而匹配能力并不等于生产能力。本文用无候选词的生产探针作为仲裁指标,区分了这两种能力。
核心创新
- 提出无污染的跨任务通道测量协议,分离架构通道与数据监督
- 发现生成训练只安装匹配能力而理解训练安装生产能力,多选探针无法区分二者
- 发现入口深度门控跨任务可用性:激活编辑在layer 7有效、layer 14起失效;权重编辑峰值在layers 10-14
- 发现语义格式要求:窗口仅出现在理解通路为语义视觉编码器的模型中,统一权重不充分
- 提出Mid-stack Semantic Anchoring方法:无生成梯度的对齐目标,以0.1%通用能力损失获取概念
方法概览
设计无污染协议:将新视觉实体(3D资产渲染+无行为伪词)仅通过一个任务方向绑定到冻结模型,测量未训练方向的能力;系统变化绑定的入口深度、载体基质和干预介质(激活编辑vs权重编辑),并跨四种架构验证。
- 无污染协议:每个新概念绑定到冻结模型的单一任务方向(G-inject用rectified flow目标,U-inject用语言模型交叉熵),未训练方向不接收任何梯度或数据,共享块是唯一的跨任务通道。
- 载体基质消融:在共享MLP、共享注意力和私有专家三种基质上分别注入,比较导出准确率,发现共享MLP是唯一有效的导出基质。
- 恒定预算容量分配扫描:固定80.74M可训练参数,在共享与私有专家之间滑动分配,观察迁移效率的变化。
- 深度扫描:激活编辑在12个位点、权重编辑在9个位点进行,用双编码器(CLIP和DINOv2)评分生成图像的身份一致性。
- 四架构观察性研究:在BAGEL-7B-MoT、Janus-Pro-1B、Lumina-DiMOO-8B、Omni-Diffusion-7B上复现激活编辑,按理解通路编码类型分组(语义视觉编码器vs重建码本)。
- 参数共享测量:用hook-only、gradient-only和intersection三种估计器测量跨任务参数共享,发现前两种严重偏差。
- Mid-stack Semantic Anchoring:在layer 14将名称状态通过InfoNCE拉向冻结的视觉地址,不计算任何flow-matching梯度。
- 协议级控制:derangement placebo、quarter-magnitude、shuffled pairing、text-only injection等对照排除伪影。
逐图理解论文
一个失败案例
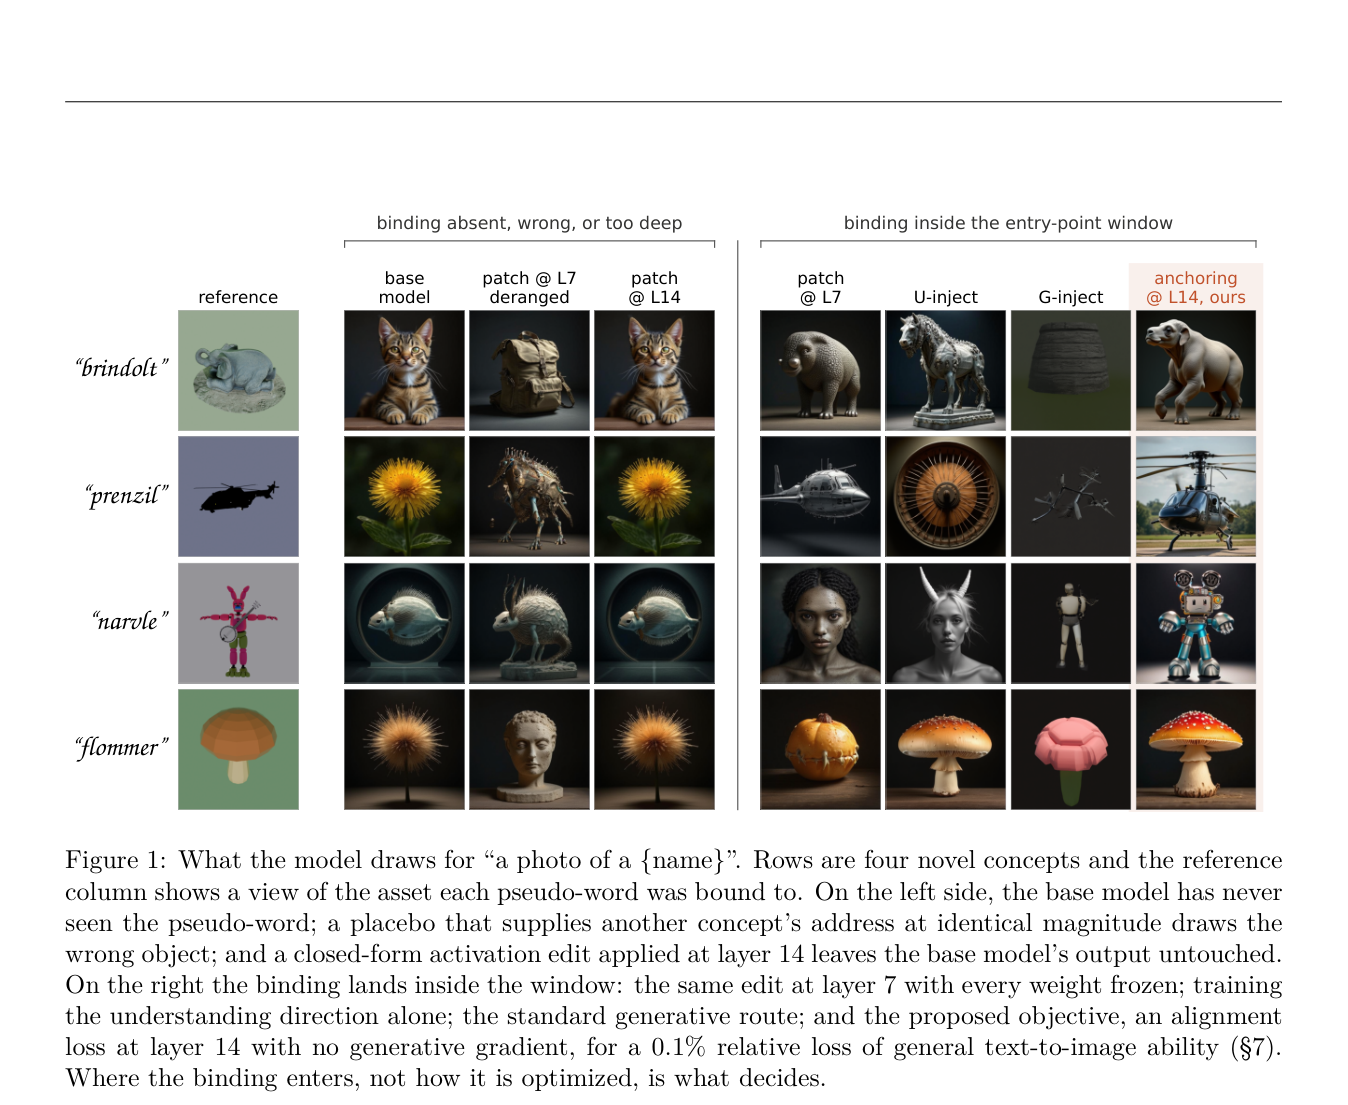
这张图直观展示了入口点的决定性作用:同一激活编辑在layer 14完全无效,在layer 7却能让冻结模型画出正确对象。右侧对比了理解训练、生成训练和语义锚定三种路线,说明优化方式不是关键,入口位置才是。
研究缺口
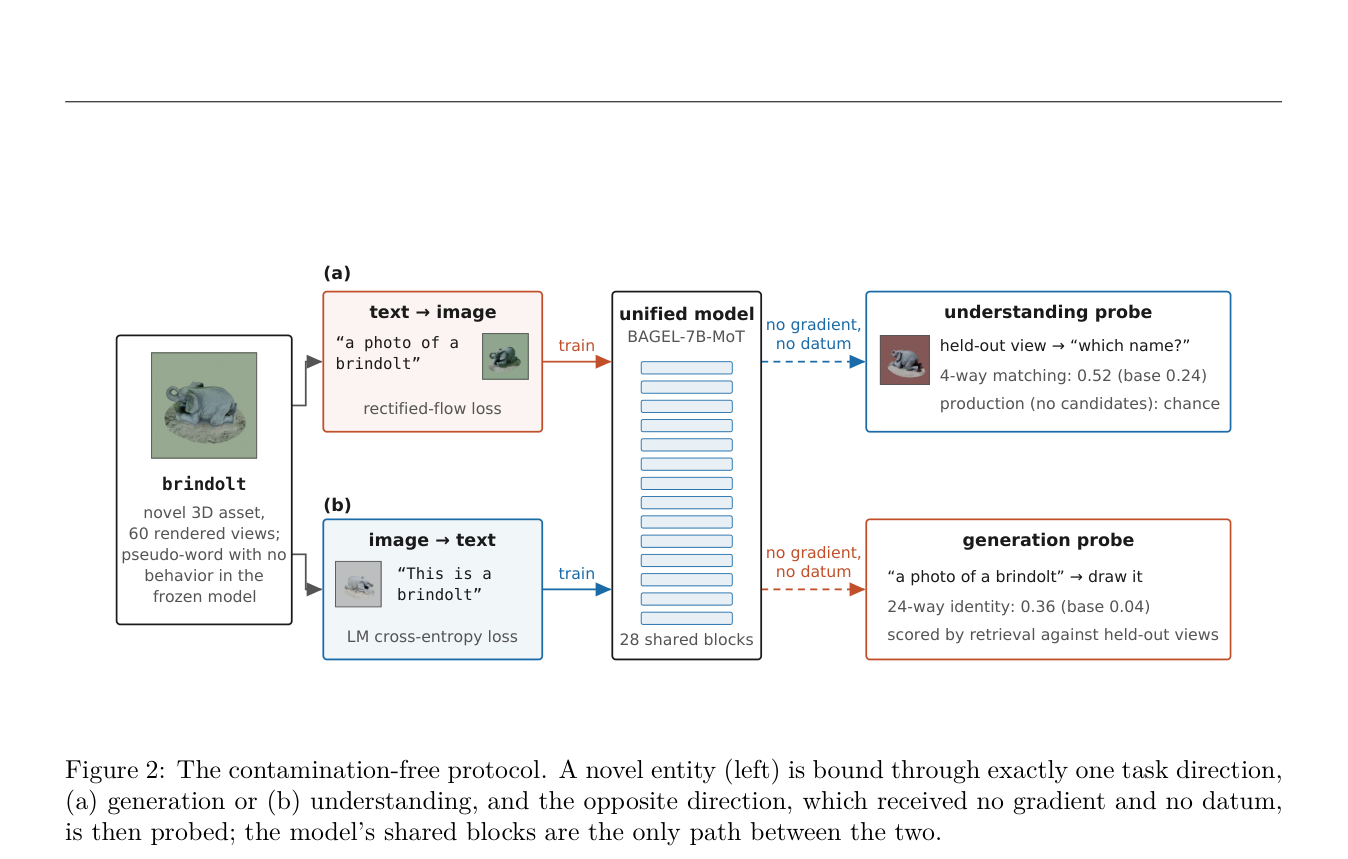
协议示意图展示了无污染设计的核心:概念只通过一个方向注入,相反方向不接收任何梯度或数据,共享块是唯一的跨任务通道。这排除了数据监督的混淆。
核心发现
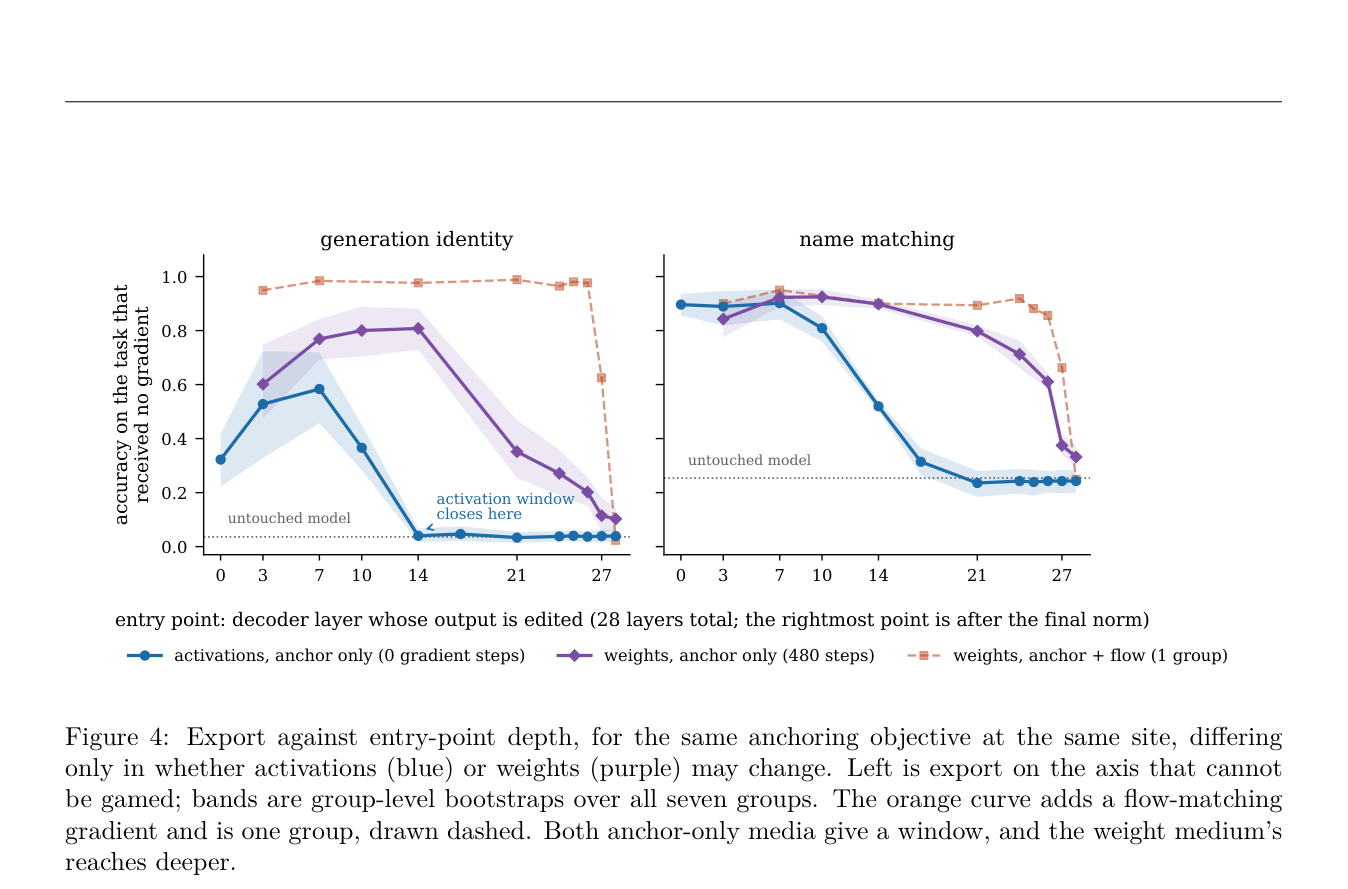
深度扫描曲线展示了窗口的存在:激活编辑在浅层有效、深层失效,权重编辑的窗口更深。橙色虚线显示flow-matching梯度掩盖了深度依赖性,使identity在layer 3-26全部平坦。
方法贡献
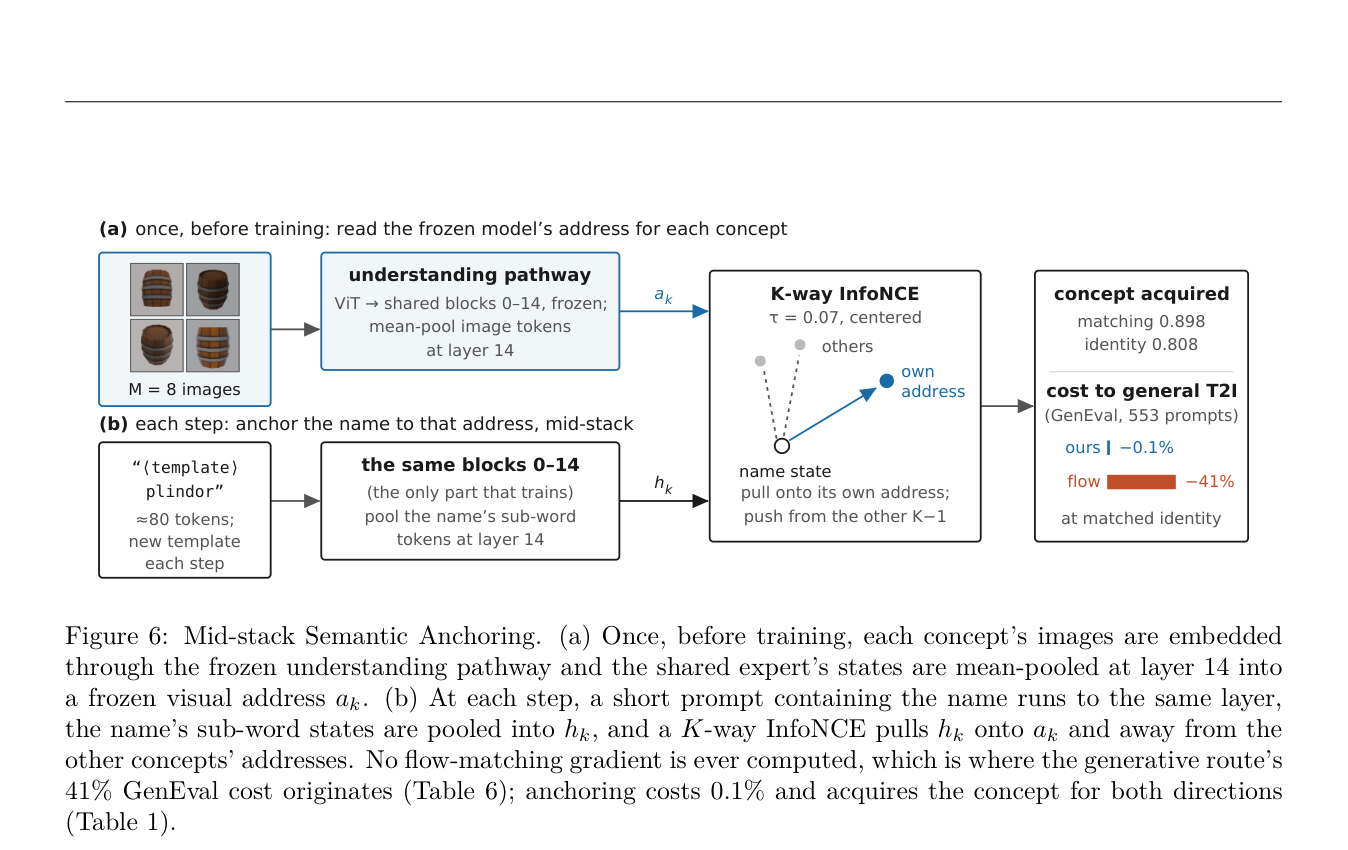
Mid-stack Semantic Anchoring的机制图:名称状态在layer 14被拉向冻结的视觉地址,不计算flow-matching梯度。这解释了为何通用能力代价仅0.1%,而生成路线为41%。
实验如何设计?
- 56个概念分7组,每组8个,480步双向注入,bootstrap区间覆盖所有概念和组间变异。
- 身份指标基于自动编码器检索:生成图像经冻结编码器嵌入后与参考资产比对,避免人类判断偏差。
- 生产探针为无候选词的上下文自由生成,首子词作为预指定仲裁指标,免疫匹配捷径。
- GenEval通用能力测量用553个提示、每提示两图、相同种子,OWLv2检测器替代官方Mask2Former,所有声明均为相对同一基线的差值。
- 同类别兄弟对测试用24个概念12对,检验细粒度身份区分能力。
- 发现组g0与确认组g1-g6分离,报告发现到确认的效应比。
关键结果与论文证据
- G→U TransferRate为0.36 [0.23, 0.49],U→G为0.54 [0.41, 0.67],理解方向注入的跨任务导出更强(第6页)。
- U-inject的上下文自由生产准确率0.938,G-inject仅0.141,与base的0.141无差异;多选探针无法区分二者(第7页)。
- 共享MLP导出0.339,共享注意力仅0.078,配对优势+0.261 [+0.16, +0.38],7/7组一致(第7页)。
- SAR与export的Spearman ρ=+0.68,但readout处SAR达1.000时export无变化,SAR可排序但不可作为干预目标(第8页)。
- 激活编辑峰值在layer 7,identity 0.584 [0.46, 0.72];layer 14起降至0.040,与base的0.039无差异。权重编辑峰值在layers 10-14,identity 0.800-0.808,layer 27降至0.115(第10页)。
- 四架构中,语义视觉编码器模型(BAGEL、Janus-Pro)在浅层出现窗口,重建码本模型(Lumina-DiMOO、Omni-Diffusion)无窗口;Janus-Pro复现峰值0.583,恢复LoRA训练上限0.625的93%(第12页)。
- BAGEL权重共享0.500但TransferRate最高,Janus-Pro共享0.873但TransferRate更低,参数共享程度不预测跨任务可用性(第13页)。
- Mid-stack Semantic Anchoring在layer 14单独使用:matching 0.898 [0.84, 0.94],identity 0.808 [0.72, 0.89];GenEval代价0.1%相对损失,而生成默认路线为41.0%(第14页)。
阅读时需要注意
- 入口点后计算量仅以层数操作化,块删除实验只能部分分离'深度'与'后续计算量'两种解释。
- 四架构观察性研究中编码器类型与骨干、规模、生成机制共变,缺乏受控训练对比。
- 身份指标基于自动编码器检索而非人类判断,可能低估或高估语义一致性。
- BAGEL的私有生成专家太弱无法独立持有概念,强私有分支是否隔离知识未测试。
- 每组仅8个概念,数百个绑定同时存在时窗口行为未知。
关联工作
- ROME/MEMIT定位事实在MLP层,与本文共享MLP为导出基质的发现一致,但本文进一步区分了激活编辑与权重编辑的深度窗口差异。
- REPA发现对齐深度影响扩散训练,但效应渐进且以生成质量评分,本文的截止窗口和未训练任务评分揭示了更锐利的边界。
- LatentUMM并发论证共享潜在空间本身不够,需对齐变换,本文的语义格式要求与之呼应。
- DreamBooth和Textual Inversion仅做生成侧概念注入,本文测量发现嵌入级干预与base模型无差异。