快速导读:DistScan 通过度量模型 NMS 前预测类别分布与训练数据类别频率之间的 Jensen-Shannon 散度来检测目标检测模型中的后门,无需触发器知识、权重访问或额外训练。
目标检测模型在自动驾驶、安防监控等安全关键场景中广泛部署,但其后门攻击的检测仍是一个开放问题。本文介绍的 DistScan 提出了一种全新的检测视角:不关注触发器本身,而是关注模型在 NMS 之前的原始预测类别分布是否偏离训练数据的类别频率。这一视角的转变使得检测不再依赖攻击的具体形态,从而覆盖了此前方法无法应对的场景级攻击。
DistScan 的核心操作极为简洁:用少量干净样本构建与模型架构对齐的验证集,提取 NMS 前的预测类别分布,计算其与训练数据类别频率之间的 Jensen-Shannon 散度,超过阈值即判定为后门模型。整个过程无需权重访问、无需触发器知识、无需额外训练,在计算成本和部署门槛上都显著优于现有方法。
英文题目:Detecting Backdoors in Object Detection via Pre-NMS Prediction Distribution Shift
论文出处:arXiv 每日论文精选 · arXiv:2608.19088
原始论文:PDF / 论文页面
这篇论文解决什么问题?
目标检测后门攻击的检测面临一个根本性困难:攻击者可以在训练阶段注入任意形态的触发器,而防御者无法预知触发器的外观、位置或作用方式。现有的检测方法大多建立在特定的攻击假设之上。ODSCAN 假设后门触发器具有局部性,即触发器只影响特定区域内的目标,并通过触发器重建来识别后门。这一假设在场景级攻击下完全失效——场景级攻击的单个触发器会同时影响画面中的所有对象,不存在可重建的局部模式。
MIA 则利用两阶段检测器中区域提议网络(RPN)与分类头之间的行为不一致性来检测后门。其逻辑是:后门攻击通常只破坏分类头而保留 RPN 的正常行为,因此两个模块的输出会出现可检测的偏差。然而,场景级攻击同时破坏两个分支,使得这种不一致性信号消失。论文的实验显示,ODSCAN 在所有场景级设置下准确率恒为 50%,等同于随机猜测;MIA 的 AUROC 在某些设置下甚至降到 0.00。
这些失败案例揭示了一个更深层的问题:现有方法都在寻找后门攻击的"副作用",但这些副作用本身依赖于特定的攻击实现方式。一旦攻击者改变了攻击策略,副作用就消失了。因此,需要一种不依赖攻击实现细节的检测信号。
DistScan 的回答是:回到模型最原始的输出行为。无论攻击者如何设计触发器,后门最终都会改变模型在干净样本上的预测行为。而这种行为变化,在 NMS 之前的原始预测分布中最为明显——因为 NMS 会过滤掉大量低置信度预测,掩盖了后门造成的系统性偏移。
核心创新
- 首次识别并表征后门模型与良性模型在 NMS 前预测类别分布上的偏移,作为检测信号
- 提出 DistScan 框架,仅需少量干净样本和训练类别分布,无需权重访问、触发器知识或额外训练
- 针对单阶段和两阶段架构设计差异化验证集构建策略,对齐分类头训练分布
方法概览
DistScan 分三步:根据模型架构范式构建验证集(单阶段用全图,两阶段用裁剪单目标图);提取 NMS 前预测类别分布(置信度阈值 δ=0.0005 过滤);计算与训练数据类别频率的 JS 散度,超过阈值 τ 则判定为后门模型。
- 验证集构建策略:DistScan 根据模型架构范式差异化构建验证集。对于单阶段模型(如 YOLOv5),直接使用全图作为输入,因为其分类头在全图特征上训练。对于两阶段模型(如 Faster R-CNN),则从干净样本中裁剪出单目标图,使输入分布与分类头在 RoI-pooled proposal features 上的训练分布对齐。这一设计是方法有效性的关键前提。
- NMS 前预测提取:从模型的中间输出中提取所有候选框的类别预测,使用置信度阈值 δ=0.0005 过滤掉纯噪声预测。这个极低的阈值确保几乎所有有意义的预测都被保留,从而完整捕捉后门对分类头决策边界的影响。
- 参考分布构建:使用训练数据的类别实例频率统计作为参考分布。论文强调,这只需要类别级别的频率统计,不需要完整训练数据集的访问权限,这在实际部署中是一个重要的可操作性优势。
- Jensen-Shannon 散度度量:选择 JS 散度而非 KL 散度,因为 JS 散度是对称的且值域有限,更适合作为检测统计量。当模型为良性时,其 NMS 前预测类别分布应与训练数据频率接近,JS 散度较小;后门模型则产生显著偏移。
- 检测阈值 τ:在评估模型池上优化选择检测阈值。论文在消融实验中展示了不同阈值对检测准确率的影响,并给出了经验推荐值。
- 模型池构建:参考 MNTD 的元分类器方法,论文构建了包含良性模型和多种后门攻击模型的评估池,用于验证检测方法的判别能力。
逐图理解论文
场景级攻击让现有方法失效
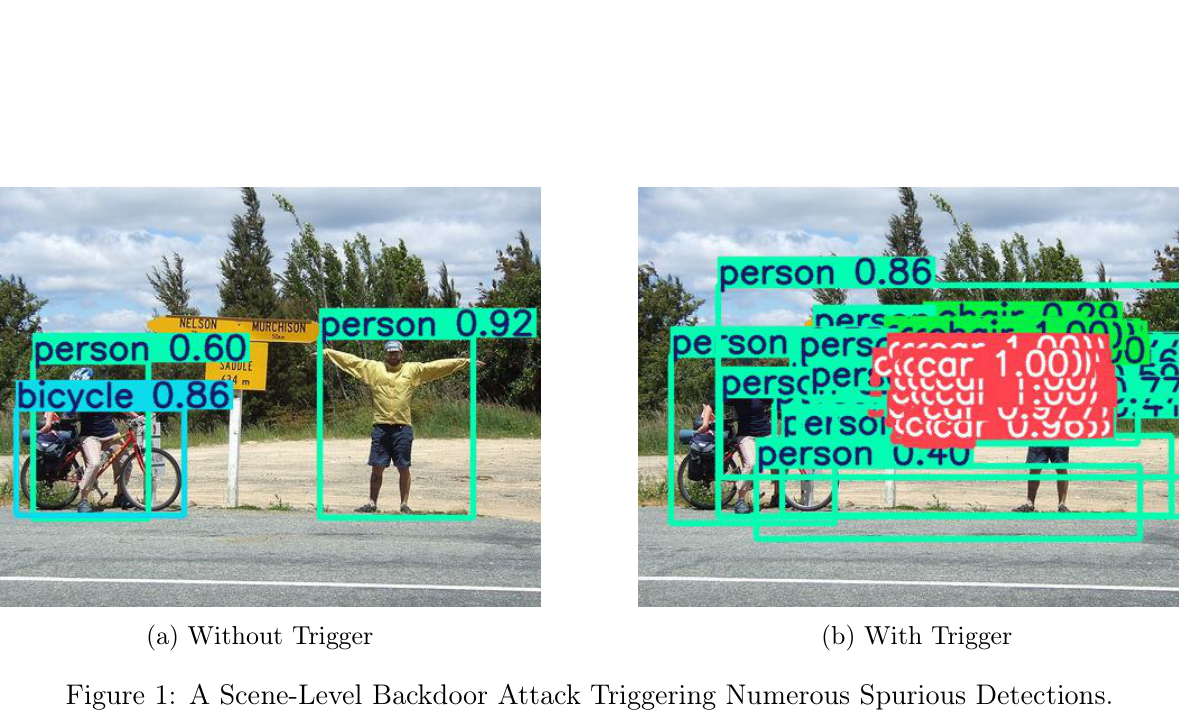
该图展示了一个场景级后门攻击的实例:单个触发器导致检测器产生大量虚假检测框。观察此图时应注意,触发器并不局限于某个局部区域,而是影响了整个场景中的所有对象,这正是现有局部性假设方法失效的根本原因。
核心洞察:NMS前的分布偏移
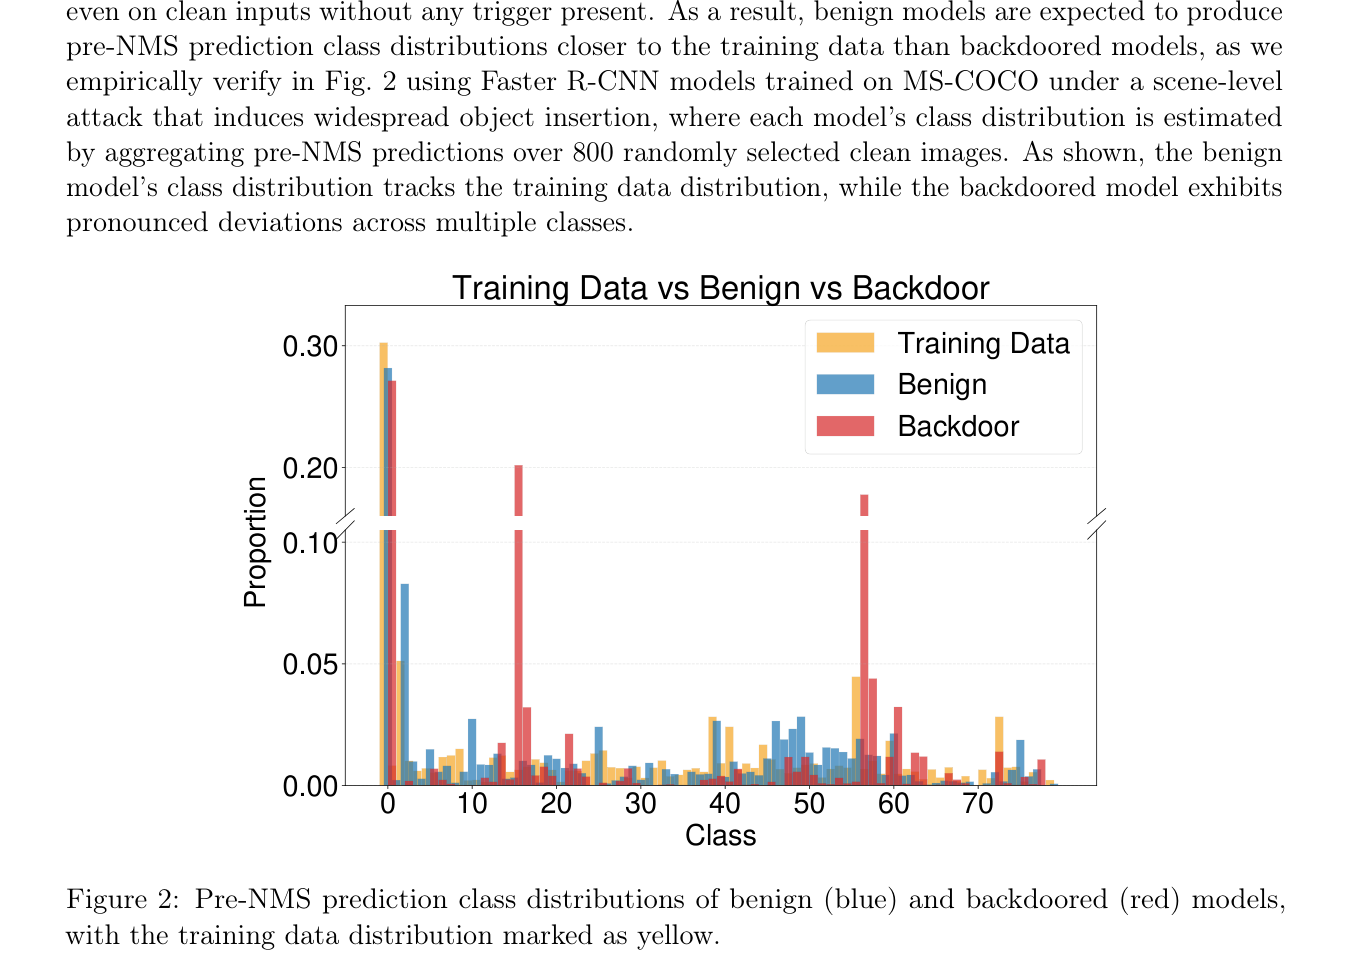
该图对比了良性模型(蓝色)和后门模型(红色)的 NMS 前预测类别分布,黄色标记为训练数据分布。重点观察良性模型分布与训练数据分布的接近程度,以及后门模型分布的系统性偏移——这种偏移正是 DistScan 的检测信号来源。
实验证据与泛化表现
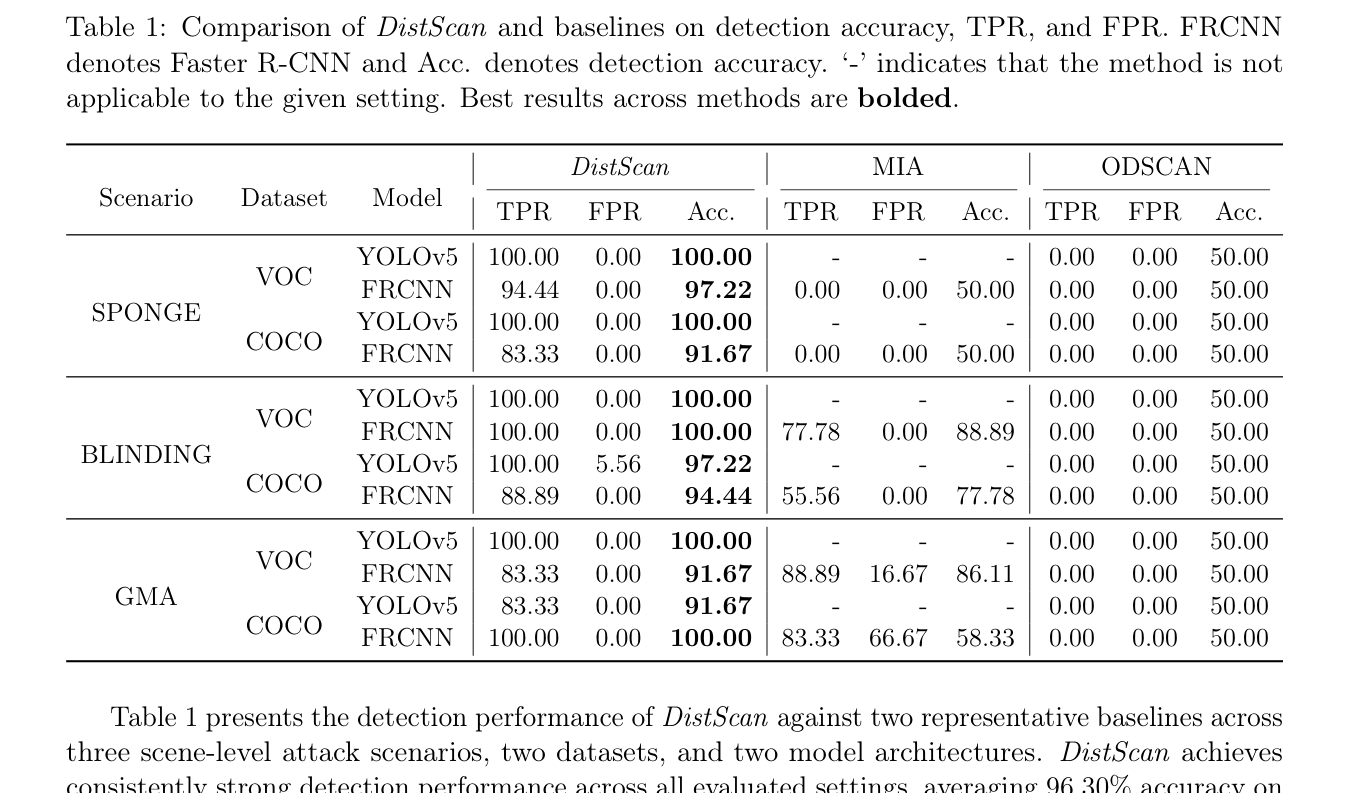
该表对比了 DistScan 与 ODSCAN、MIA 在检测准确率、TPR 和 FPR 上的表现。重点观察 ODSCAN 在所有场景级设置下恒为 50% 的准确率,以及 DistScan 在各设置下的一致高性能。
结论与局限
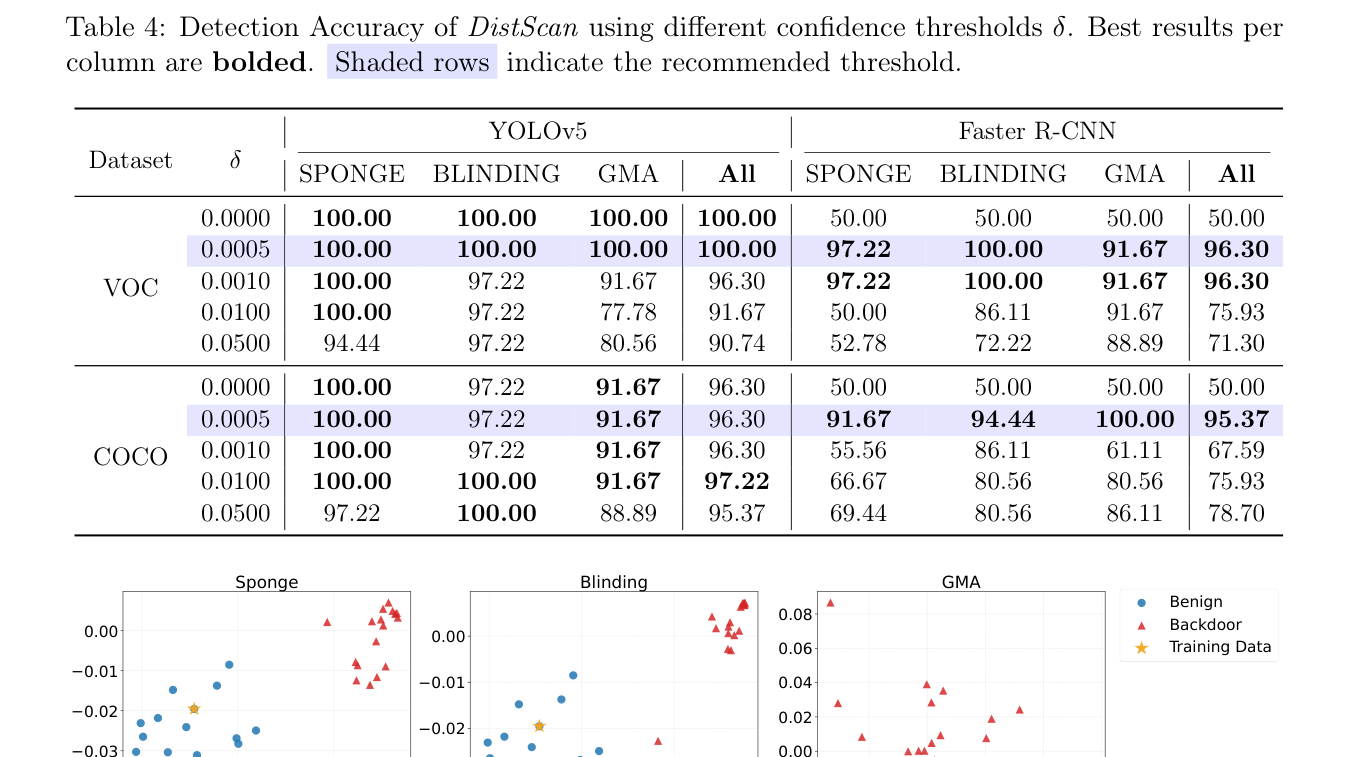
该表展示了不同置信度阈值 δ 对检测准确率的影响。注意 δ=0.0000 时准确率降至 50%,说明完全不设阈值会导致判别信号丧失,而推荐阈值 δ=0.0005 在多数设置下表现最佳。
实验如何设计?
- 主实验在 PASCAL VOC 和 MS-COCO 两个数据集上进行,覆盖 YOLOv5(单阶段)和 Faster R-CNN(两阶段)两种架构,评估 SPONGE、BLINDING、GMA 三种场景级攻击,共 288 个模型。
- 基线对比:与 ODSCAN 和 MIA 两种代表性检测方法比较,评估指标包括检测准确率、TPR、FPR 和 AUROC。
- 消融实验一:验证集构建策略对比,包括 Equal Number、Equal Size 和 Random 三种策略,考察验证集构建对检测性能的影响。
- 消融实验二:置信度阈值 δ 的影响,从 0.0000 到更高值扫描,分析阈值选择对检测信号的敏感性。
- 泛化测试:扩展到 BadDet 的 OGA、RMA、ODA 三类攻击以及 YOLOv8、DETR 架构,新增 360 个模型,验证方法在非场景级攻击和新型架构上的适用性。
- 可视化分析:使用 PCA 将 NMS 前预测类别分布投影到二维空间,直观展示良性模型与后门模型的分离程度。
关键结果与论文证据
- DistScan 平均检测准确率达到 96.99%,比最佳适用基线高出 27.32 个百分点(第 3 页),在场景级攻击场景下表现出一致的强检测能力。
- ODSCAN 在所有场景级设置中准确率恒为 50%(第 9 页),证实了触发器局部性假设在场景级攻击下的根本性失效。
- DistScan 在多数设置下 AUROC 达到 1.00,最低为 SPONGE+Faster R-CNN+COCO 的 0.91(第 10 页),表明其判别性能接近完美。
- MIA 的 AUROC 范围从 0.91(GMA+Faster R-CNN+VOC)到 0.00(SPONGE)(第 10 页),显示出极强的不稳定性,进一步验证了架构不一致性信号的脆弱性。
- 泛化测试中 DistScan 平均 AUROC 为 0.87,优于 ODSCAN 的 0.58 和 MIA 的 0.73(第 10 页),表明方法在非场景级攻击上仍保持优势,但性能有所下降。
- Faster R-CNN 在 δ=0.0000 时准确率降至 50%(第 12 页),说明完全不设置信度阈值会导致均匀分布、丧失判别信号,验证了阈值过滤的必要性。
- Faster R-CNN 使用 Equal Size 验证集在 VOC SPONGE 上达到 97.22%,而 Equal Number 和 Random 策略仅 55.56%(第 11 页),证明验证集构建策略对两阶段模型至关重要。
- PCA 可视化(第 12 页,图 4)显示良性模型(蓝色圆圈)和后门模型(红色三角形)的 NMS 前类别分布在投影空间中形成清晰分离,训练数据分布(黄色星形)与良性模型聚类接近。
阅读时需要注意
- 需要训练数据的类别频率统计作为参考分布,虽然不需要完整数据集访问,但在数据分布未知或训练数据不可追溯的场景下,这一前提可能不成立。
- 在 COCO 上部分设置性能下降(如 GMA+YOLOv5 为 91.67%),可能因为 COCO 类别数量多且存在视觉相似类对,导致分布偏移信号被稀释。
- BLINDING+YOLOv5+COCO 设置出现 5.56% 的 FPR,表明在特定攻击与架构组合下存在误报风险。
- 检测阈值 τ 需要在评估模型池上优化选择,实际部署时如何在没有后门模型样本的情况下确定阈值仍是一个开放问题。
- 泛化测试的 AUROC(0.87)低于主实验(多数 1.00),说明方法对非场景级攻击的检测能力有所下降,其优势主要体现在场景级攻击场景。
关联工作
- ODSCAN 是触发器重建类的目标检测后门检测方法,其核心假设是后门触发器具有局部性且涉及 victim-target 类转换。这一假设在场景级攻击下完全失效,论文的实验结果(恒 50% 准确率)为此提供了直接证据。
- MIA 利用两阶段模型中 RPN 与分类头的行为不一致性进行检测,但仅适用于两阶段架构,且场景级攻击同时破坏两个分支导致信号消失。
- BadDet 是目标检测后门攻击的系统性研究,探索了误分类、消失和插入三类攻击。本文的 GMA 攻击实现参考了此工作,泛化测试也直接使用了 BadDet 的攻击设置。
- Detector Collapse 是场景级后门攻击的代表性工作,包含 BLINDING 和 SPONGE 两种攻击。本文的主要评估场景即来源于此,填补了该攻击场景下检测方法的空白。
- Neural Cleanse 是图像分类领域的触发器反演防御方法,但其单标签假设无法迁移到目标检测任务,因为目标检测中一个触发器可能影响多个对象和多个类别。
- MNTD 是元分类器后门检测方法,本文在模型池构建策略上参考了此工作,但避免了元分类器需要大量训练样本和额外训练的高成本。