快速导读:DiGS-Avatar将单图像3D人体重建重构为规范UV空间中的2D扩散补全任务,通过多视角教师-学生蒸馏框架和GASA语义聚合模块,在0.71秒内生成可动画的3D Gaussian Avatar。
单图像3D人体重建的核心矛盾在于:前馈回归器推理快但不可见区域过度平滑,多视角扩散方法纹理丰富但视角不一致且成本高,原生3D扩散方法几何一致但推理需数十秒。DiGS-Avatar的答案是把这个3D问题重新表述为规范UV空间中的2D扩散补全任务——因为UV参数化中每个像素唯一对应一个表面点,在2D latent上做扩散天然保证3D一致性,同时继承了2D扩散的生成先验和推理效率。
具体而言,DiGS-Avatar训练一个多视角教师网络生成几何对齐的伪真值UV latent,再用它监督一个单视角学生网络。学生网络通过SMPL-X逆纹理映射获得部分UV latent,用2D扩散模型补全缺失区域,再经GASA模块注入DINOv3外观特征,最终解码为3DGS原语并通过LBS驱动动画。整个推理流程只需0.71秒,训练成本约60 GPU小时。
英文题目:DiGS-Avatar: Single-Image Animatable 3D Human Reconstruction via UV-Space Diffusion
论文出处:arXiv 每日论文精选 · arXiv:2608.20759
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有单图像3D人体重建方法大致分为三类。前馈回归器如IDOL和LHM直接回归3D表示,推理快,但缺乏生成先验,对不可见区域只能输出过度平滑的估计。多视角扩散方法如Human3Diffusion先生成多视角图像再重建,虽然纹理更丰富,但多视角生成成本高,且各视角之间缺乏严格几何约束,容易产生视角不一致。
原生3D扩散模型如TRELLIS和SyncHuman在3D体素网格上做扩散,几何严格一致,但3D体素处理极其昂贵,SyncHuman推理一张图需要51秒,难以实用化。
SIFU尝试在像素域对UV纹理做扩散细化,但它只细化纹理,无法修正底层几何误差,且效率低。E3Gen虽然结合了UV图与Gaussian splatting,但受限于任意图像输入。
这些方法的共同困境是:要么牺牲生成先验换速度,要么牺牲速度换一致性。DiGS-Avatar的关键洞察是,UV空间本身就是一个天然对齐的2D表示——如果能在UV latent上做扩散,就能同时获得2D扩散的效率和3D表面的一致性。
核心创新
- 将单图像3D人体重建重构为2D UV-latent补全任务,因每个UV像素唯一映射到表面点,纯2D公式天然保证3D一致性
- 提出多视角教师-单视角学生蒸馏框架,用几何对齐的伪真值UV latent监督扩散学生,避免推理时多视角生成
- 提出GASA模块,通过三阶段渐进式交叉注意力将DINOv3高层语义特征注入几何一致的VAE latent骨架,恢复VAE压缩丢失的纹理细节
方法概览
将单图像3D人体重建重构为规范UV空间中的2D扩散补全任务。多视角教师网络通过UV-Alignment Transformer融合多视角VAE特征,生成几何对齐的伪真值UV latent;单视角学生网络基于SMPL-X逆纹理映射获得部分UV latent,用2D扩散模型补全缺失区域。GASA模块将DINOv3外观特征通过渐进式交叉注意力注入结构骨架,最终解码为3DGS原语并通过LBS驱动动画。
- UV-latent补全范式:将单图像3D人体重建重构为规范UV空间中的2D扩散补全任务。每个UV像素唯一映射到人体表面点,因此在UV latent上做2D扩散天然保证3D一致性,无需显式3D约束。
- 多视角教师网络:教师网络通过UV-Alignment Transformer融合多视角VAE特征,生成几何对齐的伪真值UV latent。教师只在训练时使用,推理时完全移除。
- 单视角学生网络:学生网络基于SMPL-X逆纹理映射,将单张图像的VAE特征映射到UV空间,获得部分UV latent(可见区域有值,不可见区域缺失),然后用2D扩散模型补全缺失区域。
- GASA模块:Geometry-Aligned Semantic Aggregation模块将DINOv3提取的768维语义特征,通过三阶段渐进式交叉注意力注入几何一致的VAE latent骨架,恢复VAE压缩过程中丢失的纹理细节。
- 3DGS解码与动画:补全后的UV feature map解码为3D Gaussian原语,通过LBS线性混合蒙皮驱动动画。
- 扩散骨干:采用SANA的VAE编码器(AE-F32C32P1)和1.6B参数Linear DiT扩散骨干,配合CFG无分类器引导。
逐图理解论文
失败案例与直觉
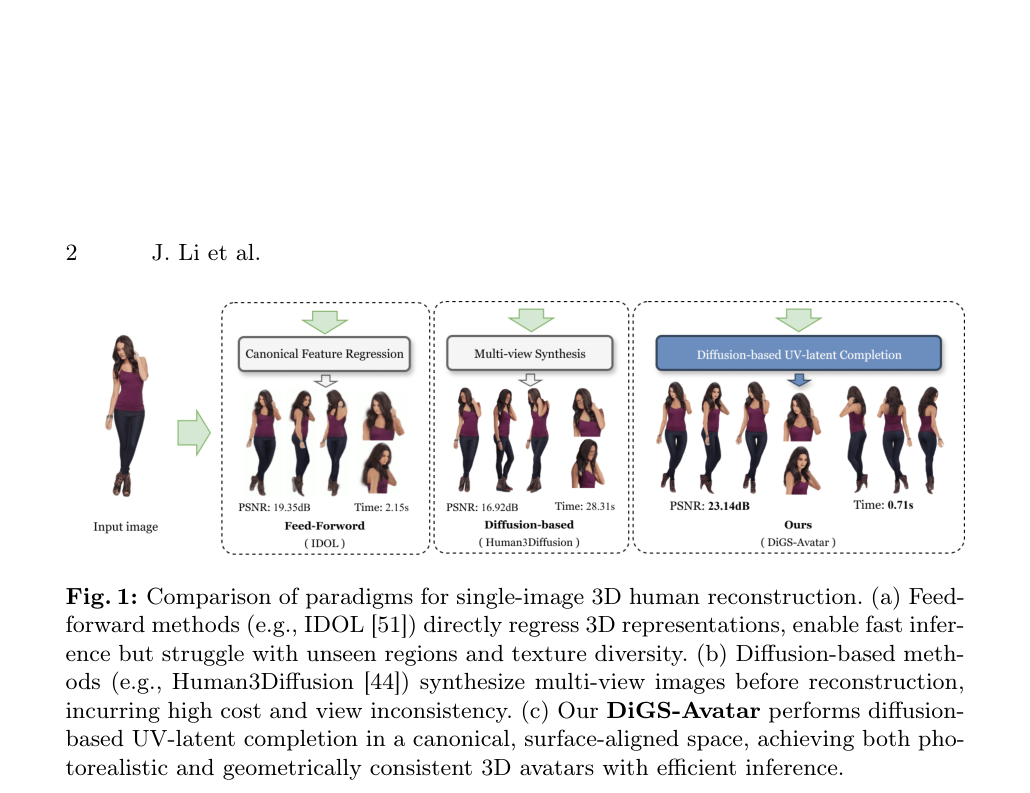
图1对比了三种范式:前馈回归器直接回归但不可见区域平滑,多视角扩散方法成本高且视角不一致,DiGS-Avatar在UV空间做扩散补全,同时获得真实感和几何一致性。注意(c)中UV latent补全的流程示意,这是理解全文核心思想的关键。
核心区分:UV空间的关键性质
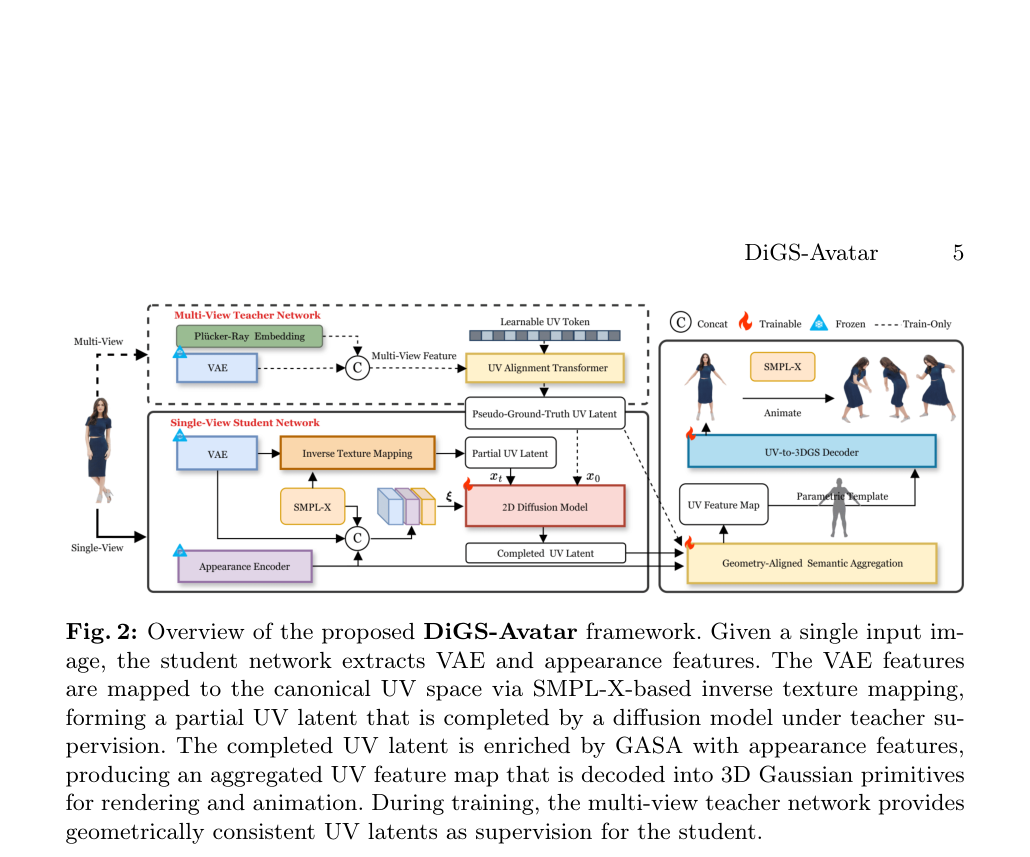
图2展示完整框架:学生网络提取VAE和外观特征,VAE特征经SMPL-X逆纹理映射形成部分UV latent,扩散模型补全后经GASA注入外观特征,解码为3DGS原语。训练时多视角教师提供几何一致的UV latent监督。
验证与证据
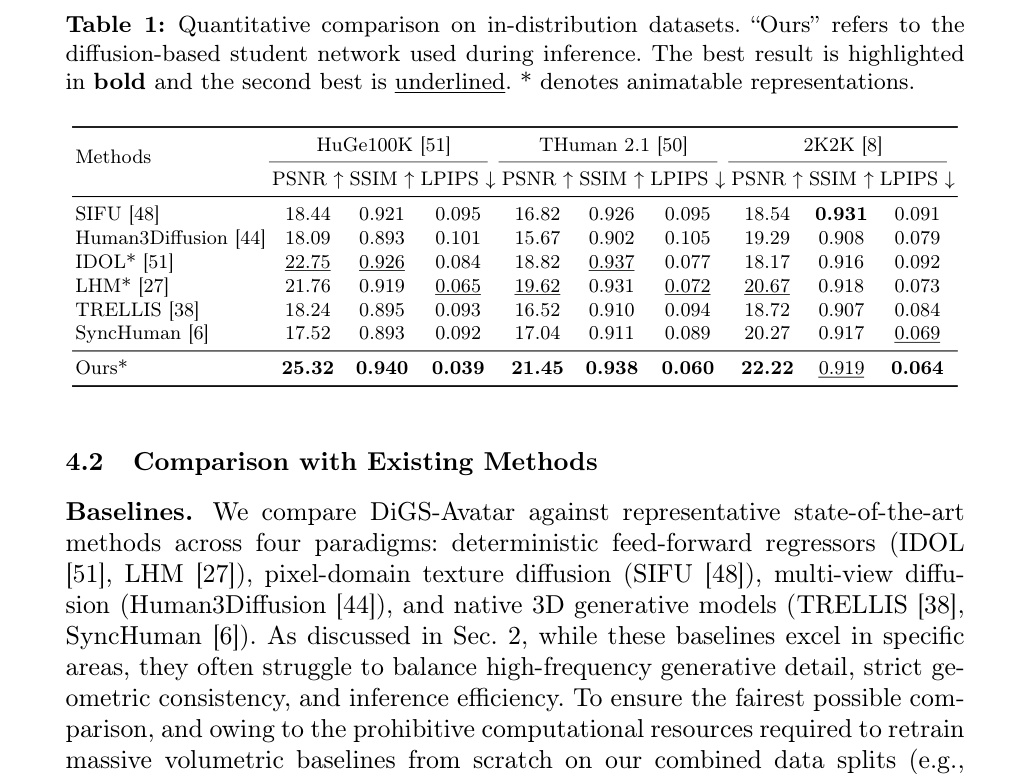
这套设计在三个分布内数据集上全面超越六种基线,在SIZER零样本测试中是唯一能保留宽松衣物复杂几何的方法。消融实验显示,移除教师监督后PSNR骤降,移除GASA后纹理质量明显退化,证明两个组件的关键作用。用户研究也表明,评估者在几何一致性和纹理清晰度上显著偏好DiGS-Avatar。
结论与局限
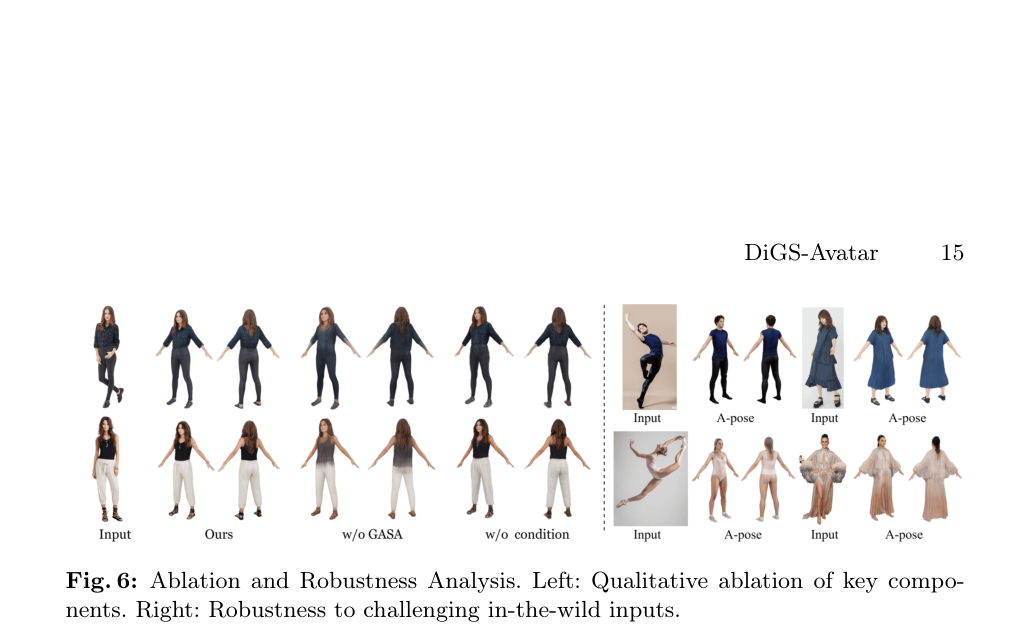
图6左侧展示消融的定性效果,移除教师监督或GASA后纹理质量明显下降;右侧展示对挑战性in-the-wild输入的鲁棒性分析。
实验如何设计?
- 在HuGe100K、THuman 2.1、2K2K三个分布内数据集上与SIFU、Human3Diffusion、IDOL、LHM、TRELLIS、SyncHuman六种基线进行定量和定性对比。
- 在SIZER数据集上进行零样本泛化评估,测试对分布外宽松衣物的处理能力。
- 在DeepFashion和互联网图像上进行in-the-wild测试,使用Multi-HMR自动估计SMPL-X参数。
- 消融实验验证多视角教师监督、扩散先验、GASA模块和条件分支的各自贡献。
- 用户研究:30名评估者在50个挑战性案例上对DiGS-Avatar与IDOL、LHM进行几何一致性、纹理清晰度和动画质量偏好投票。
关键结果与论文证据
- 在HuGe100K上,DiGS-Avatar达到PSNR 25.32、SSIM 0.940、LPIPS 0.039,全面优于所有基线(第10页,表1)。
- 在THuman 2.1和2K2K上同样取得最优结果,PSNR分别为21.45和22.22(第10页,表1)。
- 在SIZER零样本测试中,DiGS-Avatar是唯一能保留宽松衣物复杂几何的方法,PSNR 23.54(第12页,表2)。
- 推理时间仅0.71秒,训练成本约60 GPU小时,远低于多视角扩散和原生3D扩散方法(第12页,表2)。
- 消融实验显示,移除教师监督后PSNR降至19.03、LPIPS升至0.168,移除GASA后PSNR降至22.52、LPIPS升至0.084,证明两个组件的关键作用(第12页,表3)。
- 用户研究中,DiGS-Avatar在几何一致性上获得66.6%偏好、纹理清晰度60.0%、动画质量56.6%、总体偏好63.3%(第25页)。
- 定性结果显示,确定性基线在不可见区域过度平滑,多视角扩散方法存在几何不一致,而DiGS-Avatar产生清晰且3D一致的细节(第11页,图3)。
阅读时需要注意
- 严格绑定SMPL-X拓扑,极端宽松或非刚性衣物(如及地长裙)超出Gaussian原语的偏移容量,导致纹理扁平化或几何裁剪。
- SMPL-X姿态/形状估计不准确时,UV latent从错误空间位置采样,导致特征错位、身份退化、面部模糊。
- 严重姿态估计失败时,扩散模型回归到'平均人体',产生与输入不一致的体型和肢体比例。
- 基线方法使用官方预训练权重评估,未在相同数据上重新训练;2K2K数据集用于最终微调,而单图像回归基线未使用该数据,可能带来数据分布优势。
- 用户研究仅与可LBS动画的确定性回归基线比较,未包含扩散原生方法。
关联工作
- IDOL:前馈回归器基线,DiGS-Avatar沿用其UV对齐3DGS表示和训练目标,但用扩散先验替代确定性回归。
- LHM:Transformer架构的前馈回归器,在canonical空间解码3DGS属性,推理快但纹理平滑。
- Human3Diffusion:多视角扩散基线,联合多视角合成与3DGS重建,存在视角不一致问题。
- TRELLIS与SyncHuman:原生3D扩散生成模型,几何一致但推理极慢,SyncHuman需51秒/图。
- SANA:提供VAE编码器和1.6B参数Linear DiT扩散骨干,是DiGS-Avatar的扩散基础设施。
- DINOv3:预训练ViT外观编码器,提供768维语义特征供GASA注入。