快速导读:提出跨轴路由诊断方法 CARD,在新型合作网格世界基准 Relay Chain 上发现四个开源 VLM 虽线性可解码伙伴信念,却未将该信念用于行动预测的结构性路由失败。
视觉语言模型(VLM)在人类-AI 合作场景中需要推断伙伴所见、所知、所想,这是心理理论(Theory of Mind, ToM)能力的核心。已有研究通常用线性探针(linear probe)验证心理状态表征是否被编码,或用激活引导(activation steering)验证该表征是否驱动同轴预测。但一个关键问题被忽略了:即使表征存在,下游不同轴的预测是否真的读取了它?
本文提出 Cross-Axis Routing Diagnostic(CARD),在新型合作网格世界基准 Relay Chain 上对四个开源 VLM 进行诊断。结果发现:信念表征可以被线性解码,且能驱动 belief 与 knowledge 预测,但几乎完全无法驱动 intent 预测。这一“信念到行动的路由失败”是结构性的,不因主角、prompt 变体或引导方式而改变。
英文题目:CARD: Diagnosing Belief-to-Action Routing Failures in Vision–Language Models
论文出处:arXiv 每日论文精选 · arXiv:2608.20763
原始论文:PDF / 论文页面
这篇论文解决什么问题?
在合作任务中,一个智能体需要根据伙伴的感知状态来预测其行动意图。例如,若伙伴看不到某个事件发生,其行动不应以该事件为条件。传统行为基准只能观察到最终行为是否合理,无法区分两种失败模式:模型根本没有编码伙伴的信念,还是编码了却没有在行动预测中使用。
线性探针可以回答“表征是否存在”,但探针准确率高并不保证下游预测读取了该表征。同轴激活引导(如沿 belief 方向引导 belief 预测)只能证明表征对同轴输出有因果作用,无法诊断跨轴路由。这正是本文要填补的方法论空白。
作者在 BDI(belief–desire–intention)框架下将问题形式化:percept→belief→intention 的因果链中,belief 表征是否被 intention 预测实际读取?CARD 的设计目标就是直接回答这个问题。
核心创新
- 提出 Cross-Axis Routing Diagnostic (CARD):沿一轴引导、读取另一轴预测,区分“特征缺失”与“已编码但未使用”
- 提出 Relay Chain 合作网格世界基准,含 success/counter 四元组判别签名与 TB/FB 感知最小对
- 引入 projection-removal 负向控制、CLEVR 非 ToM 正向控制、分布式 token 引导控制、12 变体 prompt 抵抗测试等消融
- 发现并量化 VLM 中信念到行动的路由失败:信念方向可驱动 belief/knowledge 预测但几乎不驱动 intent 预测
方法概览
CARD 三步:对每个轴(belief/intent/knowledge)在配对 True/False 激活上训练线性探针得到单位方向 va;在推理时于同层残差流加 αva(α∈{−10,+10});读取不同轴 b 的答案头,以跨轴 gap-shift 判断特征是否被路由使用。Relay Chain 为三智能体合作网格世界,含 success/counter 四元组与 TB/FB 感知布局。
- CARD 三步流程:对每个轴 a(belief/intent/knowledge)在配对 True-Belief/False-Belief 激活上训练线性探针,得到单位方向 va;在推理时于同层残差流加 αva(α∈{−10,+10});读取不同轴 b 的答案头,以跨轴 gap-shift 判断特征是否被路由使用。
- Relay Chain 基准:三智能体合作网格世界,含两个 lever-operator(a1、a2)和一个 traveller(a3)。主角 a1 的视野半径为 5 格,视野外为 fog of war。TB(True-Belief)布局中主角能感知事件,FB(False-Belief)布局中不能。
- 四元组判别签名:每个场景有 success/counter 两个世界状态与 TB/FB 两个感知布局的交叉,共四种条件。行为模式可区分世界状态追踪者(world-state tracker)、信念条件化(belief-conditional)与常量先验(constant-prior)。
- projection-removal 负向控制:从残差流减去探针方向的投影,验证引导效应确实来自该方向而非任意扰动。
- CLEVR 非 ToM 正向控制:在 CLEVR 的 count/shape/colour 轴上使用相同 hook,确认引导机制本身有效,排除 hook 失效的替代解释。
- 分布式 token 引导控制:在 18 组(探针源×位置)上测量,验证引导效应不依赖单一 token 位置。
- 随机标签探针控制:真标签探针准确率 91.6–100%,随机标签 47.4–52.0%,排除探针表达力伪影。
- 12 变体 prompt 抵抗测试:覆盖 cost framing、chain-of-thought、perception-first、rule-based、in-context exemplars 四族,检验路由失败是否可通过提示工程修复。
逐图理解论文
一个具体失败案例
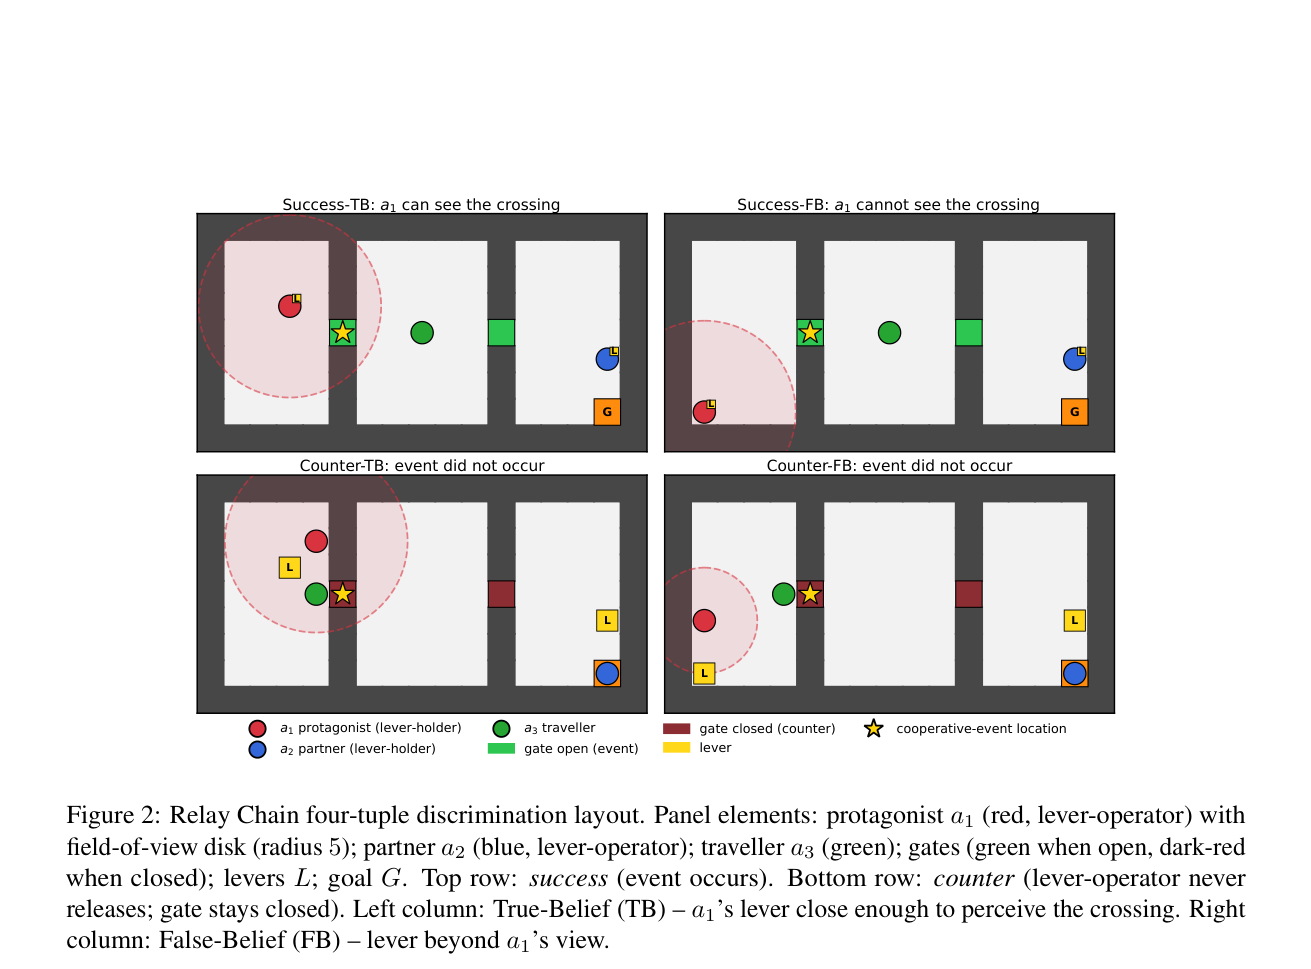
观察四元组布局:上排 success、下排 counter,左列 TB、右列 FB。主角 a1 的视野圆盘在 TB 中覆盖事件,在 FB 中不覆盖,这是感知最小对的核心设计。
研究空白:表征存在不等于被使用
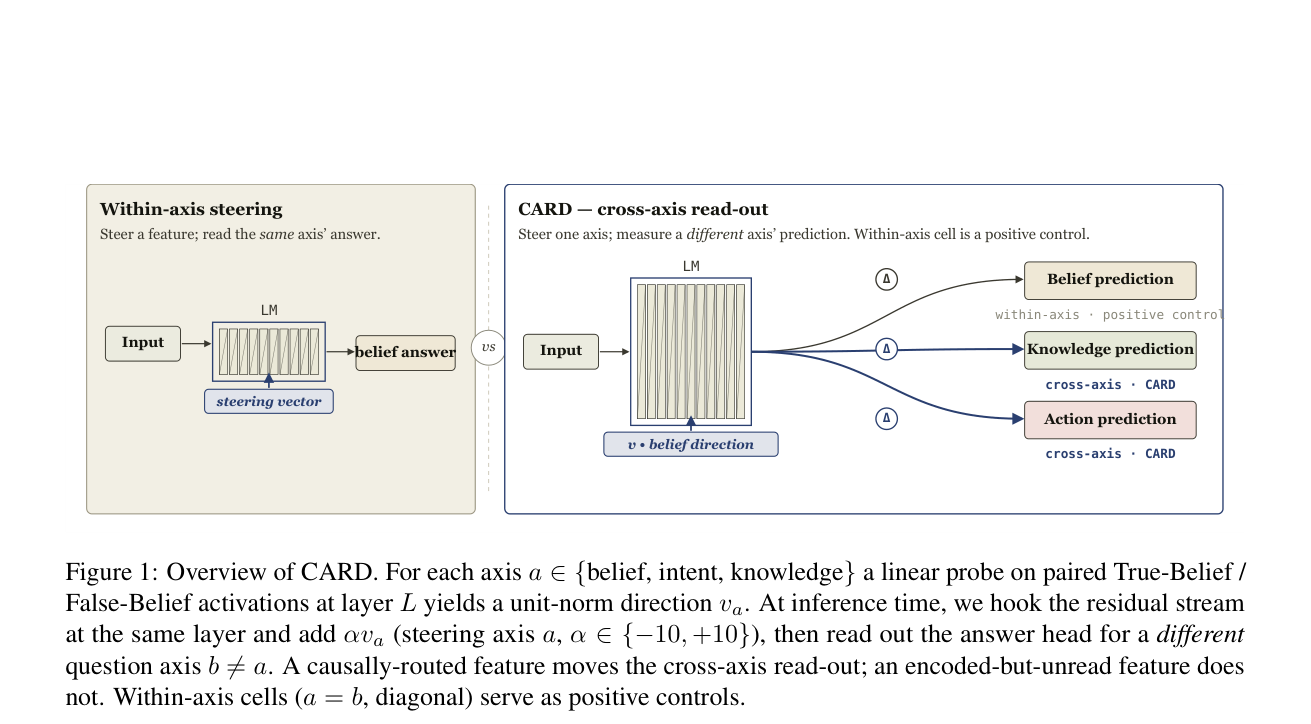
观察 CARD 的三步流程:探针训练得到方向 va,推理时加 αva 引导,再读取不同轴 b 的答案头。注意对角线(a=b)是正控制,非对角线才是跨轴诊断的关键。
核心发现:intent 列几乎全零
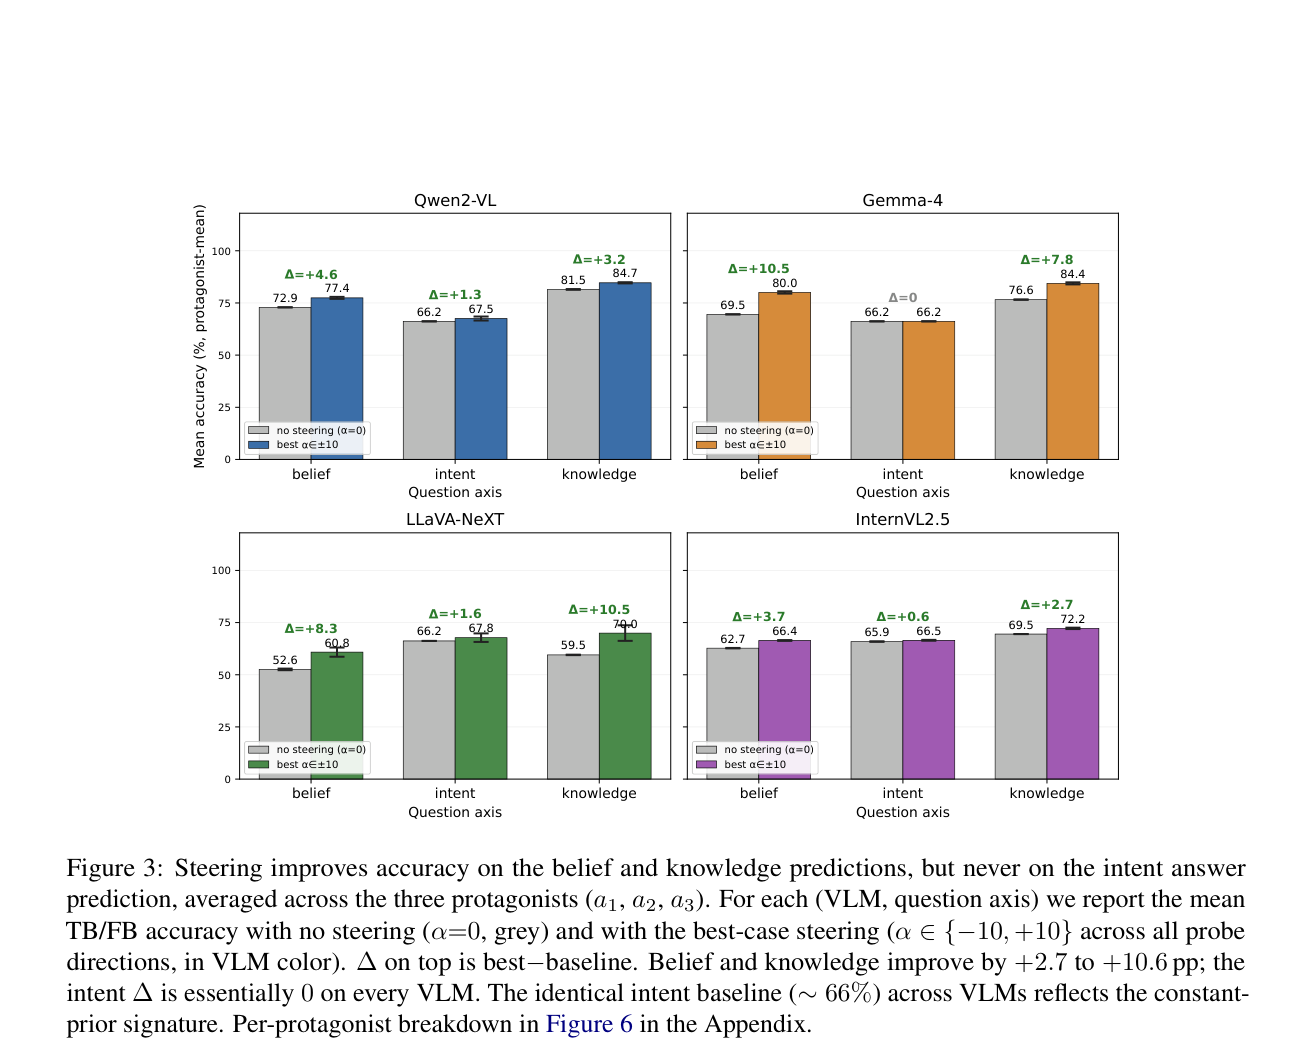
观察 intent 列的 ∆ 在所有 VLM 上基本为 0,而 belief 和 knowledge 列有 +2.7 至 +10.6 pp 的提升。intent 基线一致约 66% 是常量先验签名。
结论与意义
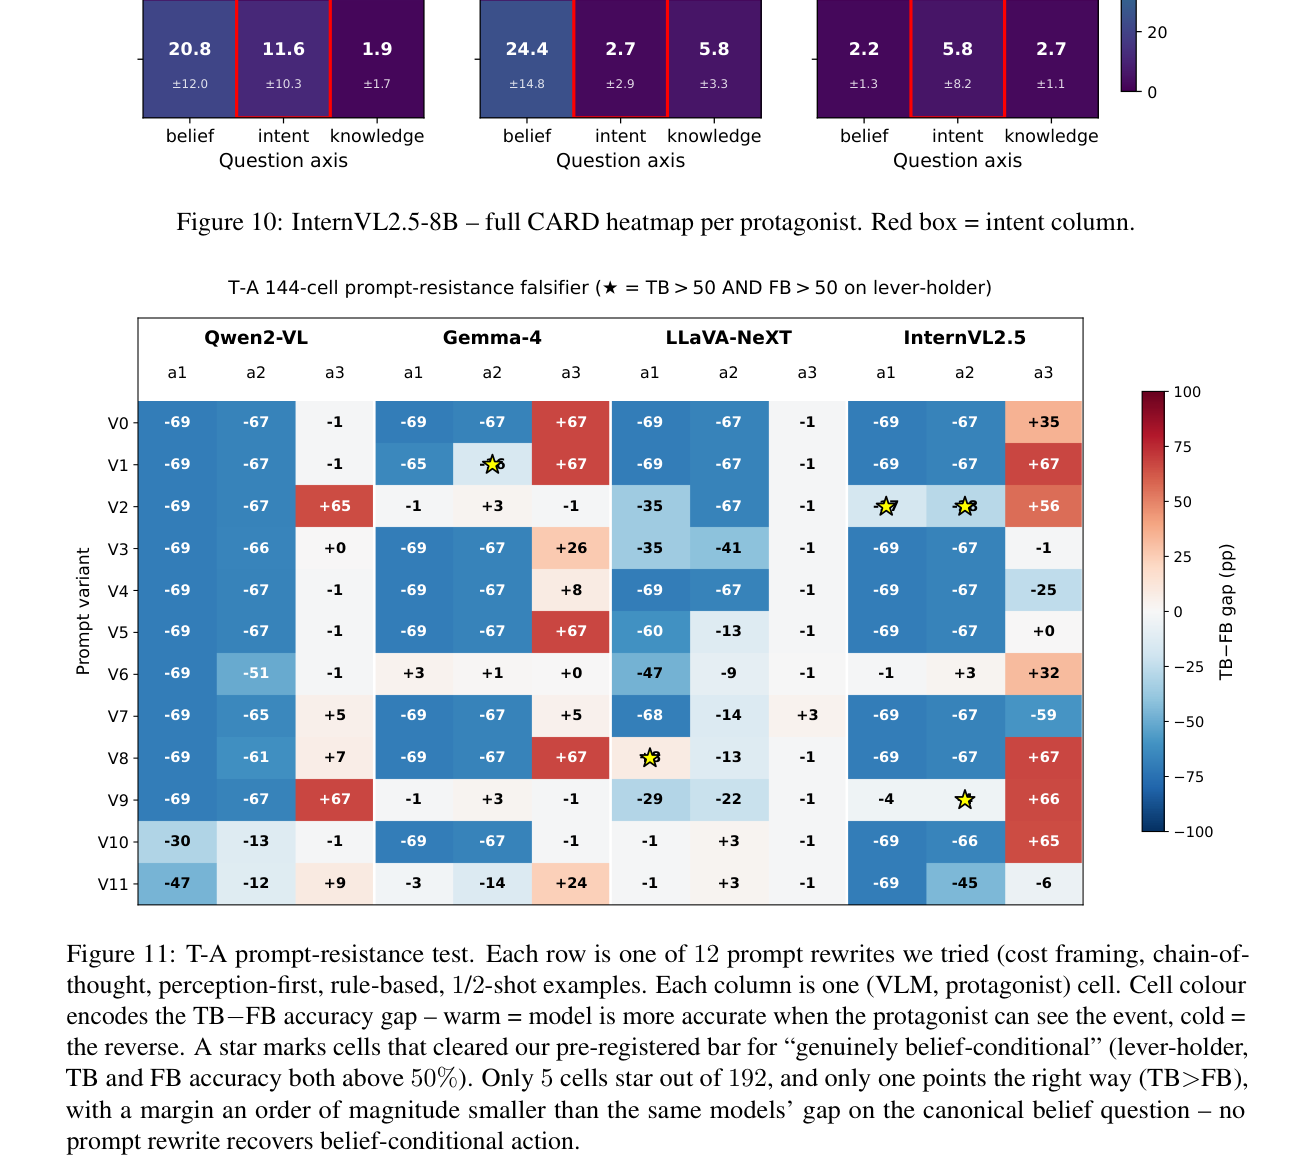
观察 192 格中仅 5 格带星(过预注册标准),且仅 1 格方向正确。暖色表示 TB>FB,冷色相反;没有 prompt 变体能恢复信念条件化行动。
实验如何设计?
- 四个开源 VLM:Qwen2-VL-7B、Gemma-4-E4B、LLaVA-NeXT-Video-7B、InternVL2.5-8B,覆盖不同架构与训练管线。
- Relay Chain 数据集按主角与 world-state outcome 划分,每个条目为 4–8 帧多帧轨迹,三轴(belief/intent/knowledge)共享同一场景基础。
- 线性探针在配对 TB/FB 激活上训练,chance=50%,三个随机种子报告均值与标准差。
- CARD 全矩阵扫描:4 VLM × 3 主角 × 3 探针方向,共 36 格,报告 gap-shift 与 mean-accuracy shift。
- T-A 预注册扫描:12 prompt 变体 × 4 VLM × 4 主角条件,共 192 格,预注册标准为 TB 与 FB 准确率均高于 50%。
- 时间探针消融:在 Qwen2-VL 上按轨迹分数 t 测量探针准确率,验证表征从何时起可解码。
关键结果与论文证据
- 信念探针正控制:belief 线性探针准确率 78.1–94.5%,行为 TB/FB 准确率呈世界状态追踪签名(Table 1, p5)。
- 三轴行为分离:belief-Q 读世界状态、knowledge-Q 读观察、intent-Q 两者皆不读,坍缩为常量先验,四 VLM 的 intent 基线一致约 66%(Table 6, p17)。
- CARD 主结果:belief/knowledge 引导精度提升 +2.7 至 +10.6 pp,intent 的 ∆ 在所有 VLM 上基本为 0(Figure 3, p7)。
- a1 上 intent 列 9/12(VLM, probe)格翻转率恰为 0,非零格 ≤15.3% 且方向平衡抵消(Table 2, p6)。
- 108 个 intent 测量中 95 个恰为 0,最大均值精度提升的 95% 置信上界为 18.7 pp,对比 belief 正控制的 22.9 pp(Table 7, p17)。
- projection-removal 控制:c∈{0.5,1,2,5} 下 intent gap 恒定,belief gap 如预期向 chance 移动(Figure 12, p22)。
- CLEVR 正控制:同 hook 在非 ToM 任务上产生 +6 至 +60 pp 增益,排除 hook 失效(Table 10, p22)。
- prompt 抵抗测试:192 格中仅 5 格过预注册标准,仅 1 格方向正确(TB>FB),且幅度比同模型在 belief 问题上的 gap 小一个数量级(Figure 11, p21)。
阅读时需要注意
- 仅在 Relay Chain 一个 2D 网格世界任务族上验证,未推广到更大模型规模(40–400B)、非合作 ToM 或真实视频。
- CARD 与 projection-removal 需要激活流访问,无法用于闭源 VLM。
- 仅使用线性探针,非线性探针可能发现行动预测读取的线性探针遗漏子空间。
- 时间探针消融仅限 Qwen2-VL 单模型,非普适性结论。
- 四 VLM 样本不足以做架构与 rigidity 的定量回归。
关联工作
- GridToM(Li et al., 2025)是最接近的多模态 ToM 工作,将探针与激活干预配对用于网格世界,但仅同轴诊断,无合作行动轴。
- SimpleToM(Gu et al., 2024)揭示文本 LLM 显式与隐式 ToM 差距,CARD 在 VLM 合作行动上补充机制层面证据。
- ToM-SSI(Bortoletto et al., 2025)报告 percept→belief→intention 行为下降,CARD 为其提供机制解释。
- MindPower(Zhang et al., 2025)用 ToM 感知提示提升具身 VLM 合作成功率,与 CARD 的 prompt 抵抗测试形成对照。
- Hewitt & Liang(2019)的随机标签探针控制方法被 CARD 用于验证信念方向非探针表达力伪影。
- Activation addition/steering(Turner et al., 2024; Rimsky et al., 2024)是 CARD 的引导机制基础,但 CARD 扩展为跨轴读出。