快速导读:EditStream 提出一个统一的 DiT 视频生成与编辑框架,通过双类型条件接口融合六类任务,并以 Velocity Moment Matching (VMM) 蒸馏将双向教师模型转换为少步自回归流式学生模型。
EditStream 要回答的核心问题是:能否在一个统一的视频扩散框架里,同时支持文本生成、图像生成、视频编辑、参考引导编辑、首帧编辑传播和相机位姿控制六类任务,并且以少步自回归方式流式输出?论文的答案是肯定的,但它真正的贡献不在任务列表本身,而在蒸馏路径的设计。
现有流式视频模型大多沿用 DMD 类分布匹配蒸馏,容易出现过锐化、塑料感、运动退化和时间不稳定。EditStream 提出 Velocity Moment Matching(VMM),在速度输出空间匹配教师与辅助模型的残差矩,并配合 Energy Annealing 与 VMM-forcing 全展开蒸馏,把双向教师压缩为因果学生,同时保留多任务控制能力。
英文题目:EditStream: A Unified Autoregressive Framework for Interactive Video Generation and Editing
论文出处:arXiv 每日论文精选 · arXiv:2608.21424
原始论文:PDF / 论文页面
这篇论文解决什么问题?
视频扩散模型在生成质量上已经很强,但创意工作流需要的是交互式流式体验:用户输入一个编辑指令,模型应当尽快吐出第一段结果,而不是等整段视频离线渲染完成。Diffusion Forcing、CausVid、Self-Forcing 等工作已经探索了自回归视频扩散与蒸馏,但普遍存在多阶段流程复杂、难以复现的问题,尤其在统一多任务场景下更明显。
一个关键矛盾在于:强教师模型为了质量通常采用双向注意力,可以看到未来帧;而流式推理必须是因果的,只能看到历史帧。直接把教师因果化会损失容量,而用 DMD 类方法蒸馏又容易陷入模式坍缩和过饱和。EditStream 的立场是:教师保持双向,只通过训练模式适配来配合蒸馏,而不是牺牲教师质量。
此外,多任务统一本身也有设计难点。像素对齐条件(源视频、mask、相机重投影)如果全部走 token 拼接,会显著拉长注意力序列;非对齐参考信号(参考图、首帧)如果强行通道拼接,又会破坏语义对齐。EditStream 用双类型条件接口分别处理这两类信号,这是它统一任务空间的基础。
核心创新
- 提出双类型条件接口,以通道拼接处理像素对齐条件、token 拼接处理非对齐参考信号,在统一多任务的同时控制注意力序列长度
- 提出 Velocity Moment Matching (VMM) 蒸馏算法,在速度空间匹配教师-辅助残差矩,并修改时间步采样以对齐推理调度,加速收敛
- 提出 Energy Annealing (EA) 策略,在 x0 空间对 CFG 引导输出做逐通道均值/标准差重标定以缓解过饱和
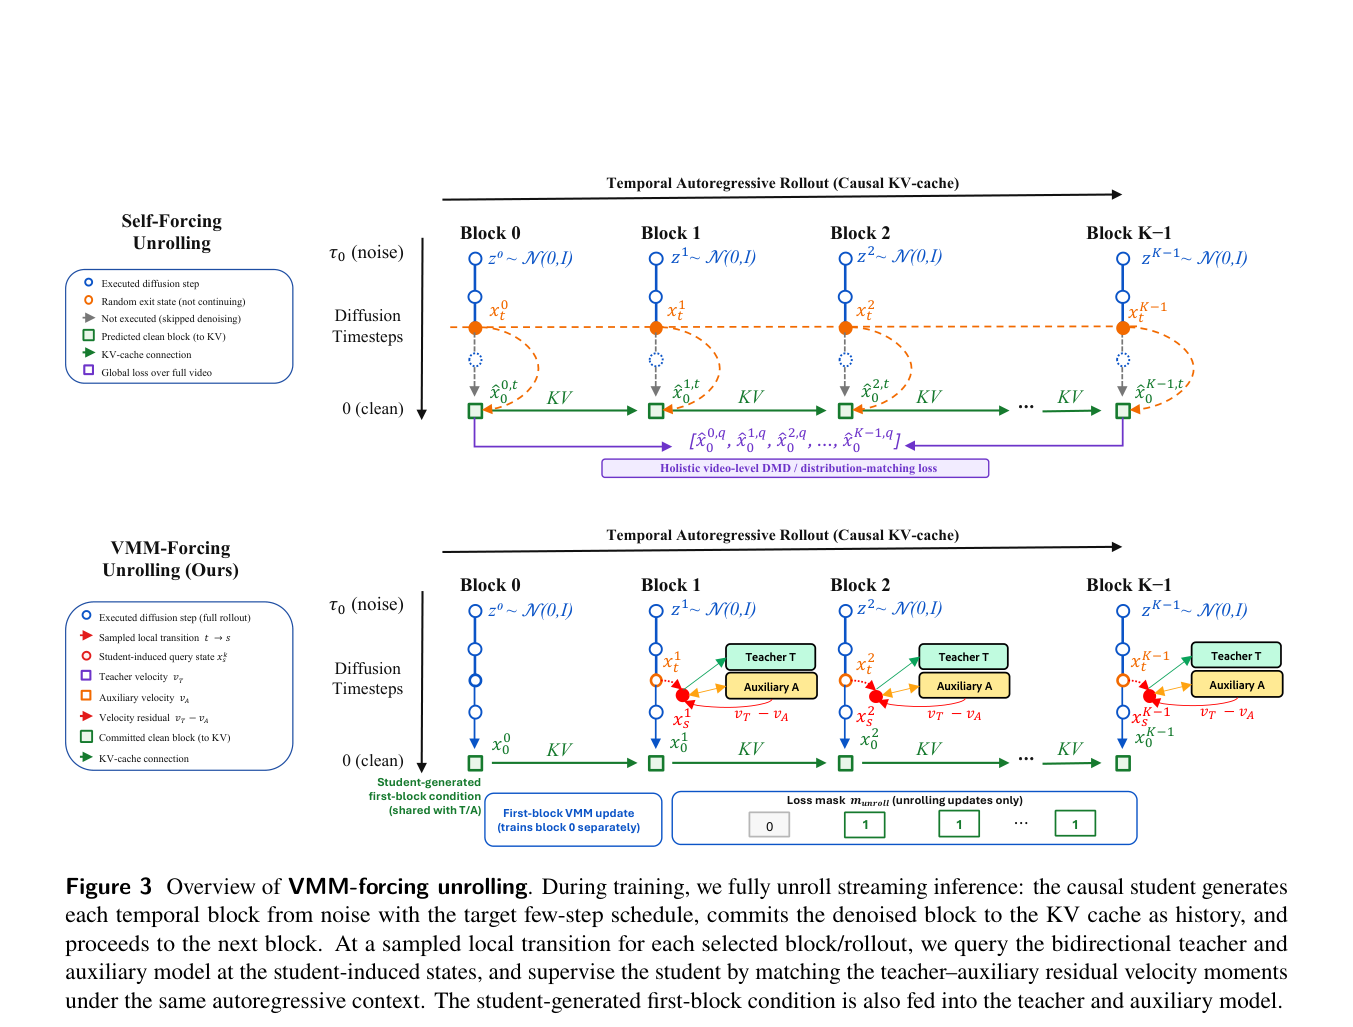
- 提出 VMM-forcing 全展开蒸馏,在自回归 rollout 的学生诱导状态上查询双向教师与辅助模型进行矩匹配,缩小 train-inference 曝光偏差
- 教师保持双向注意力,仅通过 first-block cold-start 与 prefix-suffix teacher forcing 训练模式适配块级蒸馏,避免因果化教师带来的容量损失
方法概览
EditStream 以双类型条件接口统一 T2V、I2V、V2V、EditProp、refV2V、ReShoot 六类任务:像素对齐条件(源视频、mask、相机重投影)通过通道拼接注入,非对齐参考信号(参考图、首帧)通过 token 拼接注入。蒸馏采用 Velocity Moment Matching (VMM),在速度输出空间匹配教师-辅助模型残差矩,结合 Energy Annealing (EA) 缓解过饱和;转换流程包含教师块级 teacher forcing 微调、warm-up 蒸馏与 VMM-forcing 全展开蒸馏三个阶段。
- 双类型条件接口:像素对齐条件(源视频 latent、mask、相机重投影)通过通道拼接注入,不增加注意力序列长度;非对齐参考信号(参考图、首帧 latent)通过 token 拼接注入,保留语义对齐能力。
- 任务空间统一:T2V、I2V、V2V、EditProp、refV2V、ReShoot 六类任务共享同一视频扩散主干,仅条件输入和特殊任务 token 不同,模型需要学会何时保留、何时修改、如何平衡输入控制。
- Velocity Moment Matching(VMM):在速度输出空间匹配教师与辅助模型的残差矩,而不是在干净样本空间匹配条件均值;同时修改时间步采样以对齐推理调度,加速收敛。
- Energy Annealing(EA):在 x0 空间对 CFG 引导输出做逐通道均值/标准差重标定,以缓解蒸馏后的过饱和问题;ηEA 因子需要针对不同模型手动调参。
- 教师适配:教师保持双向注意力,仅通过 first-block cold-start 与 prefix-suffix teacher forcing 两种训练模式适配块级蒸馏,避免因果化教师带来的容量损失。
- 三阶段转换流程:教师块级 teacher forcing 微调、warm-up 蒸馏、VMM-forcing 全展开蒸馏,逐步把学生从干净真值上下文条件过渡到自回归 rollout 条件。
- VMM-forcing 全展开蒸馏:在自回归 rollout 的学生诱导状态上查询双向教师与辅助模型进行矩匹配,学生生成的首块条件也喂给教师和辅助模型,缩小 train-inference 曝光偏差。
逐图理解论文
失败案例与直觉
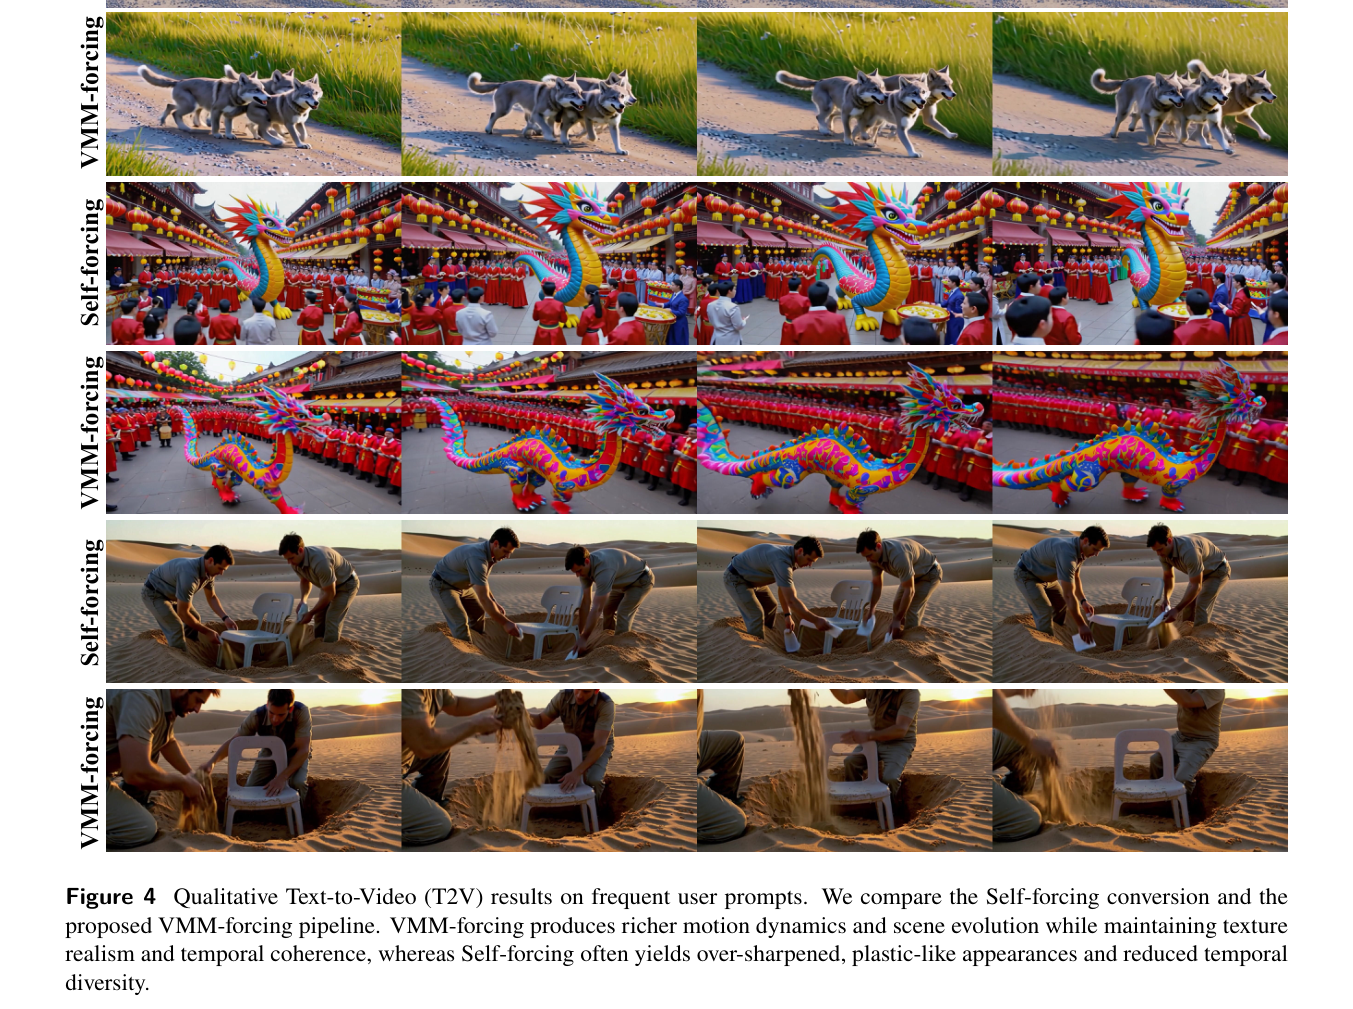
这张图对比 Self-forcing 与 VMM-forcing 的 T2V 定性结果。注意 Self-forcing 常出现过锐化、塑料感外观和时序多样性下降,而 VMM-forcing 产生更丰富的运动动态和场景演化,同时保持纹理真实感与时间连贯性。
研究缺口
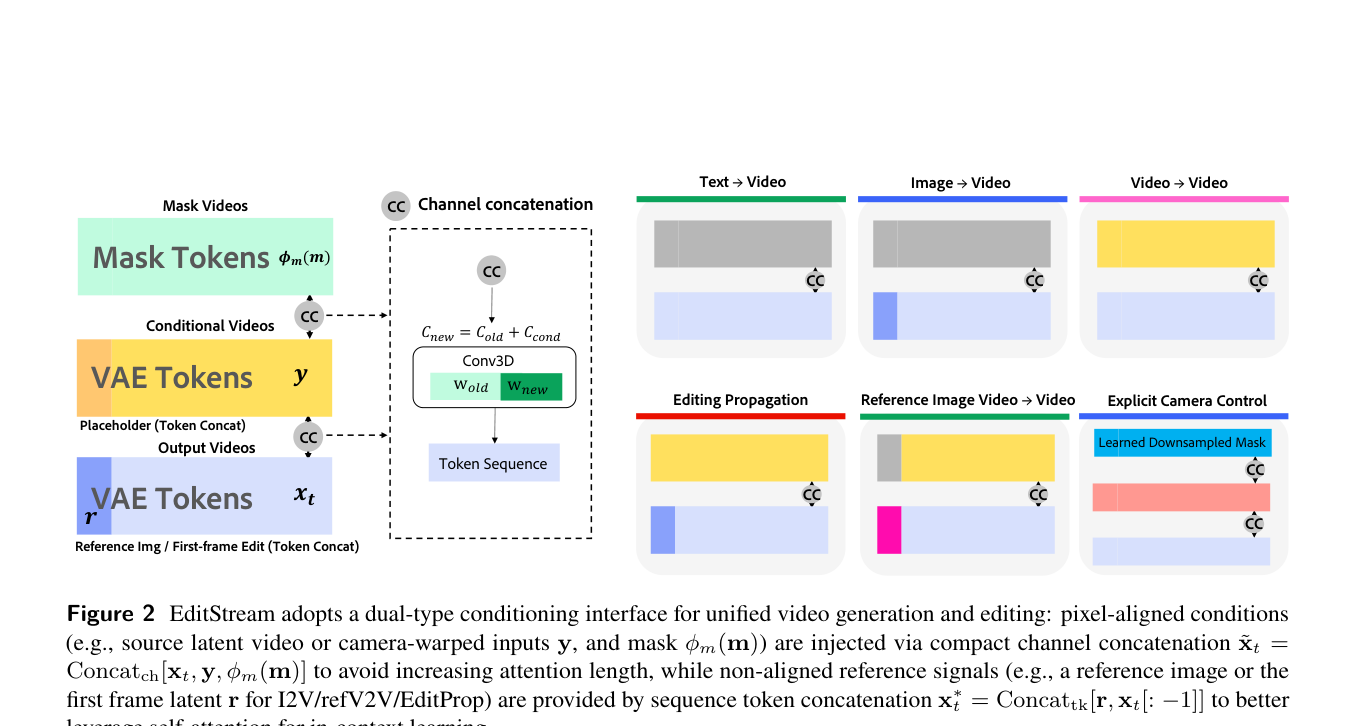
这张图说明双类型条件接口的核心设计:像素对齐条件走通道拼接,非对齐参考信号走 token 拼接。注意通道拼接如何避免注意力序列膨胀,以及 token 拼接如何保留参考图的语义对齐能力。
最强结论
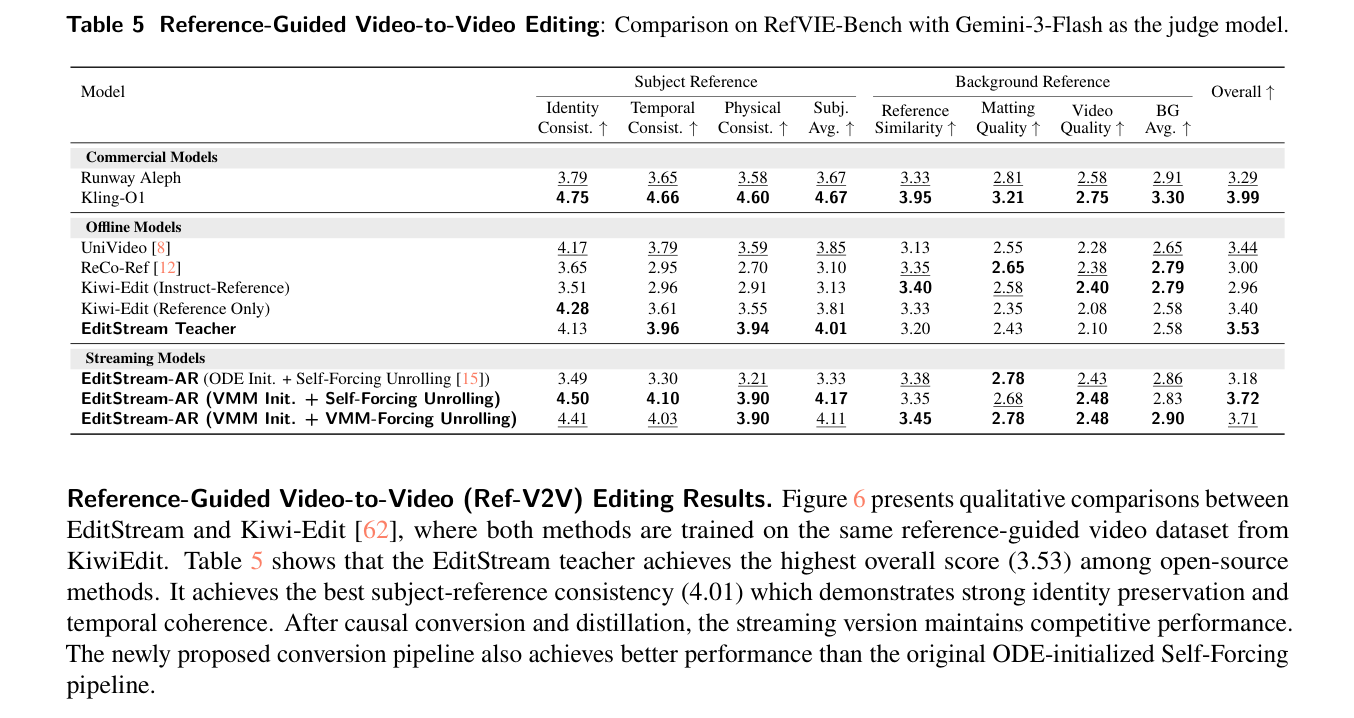
最强的结论是:流式学生不仅能追平双向教师,在参考引导编辑上甚至超过教师和离线方法 Kiwi-Edit。这说明,只要蒸馏目标选对,因果流式推理不必以牺牲多任务控制能力为代价。
意义与局限
这项工作的意义在于,它为交互式视频创作提供了一条可复现的流式化路径。一个诚实的局限是,720p 下十点五六 FPS 仍未达到实时播放速度,需要更强的推理硬件和工业级优化。以上就是这篇论文的核心内容,感谢收听。
实验如何设计?
- VBench 文本到视频基准评测,衡量 T2V 生成质量与流式推理性能(表3,第13页)。
- EditVerse 视频到视频编辑基准评测,使用 GPT-4o 作为 VLM 评判模型(表4,第15页)。
- RefVIE-Bench 参考引导视频编辑评测,使用 Gemini-3-Flash 作为评判模型(表5,第17页)。
- V2VCameraPose 相机位姿控制基准评测,包含 472 个样本,评估去遮挡区域补全质量与观察区域保真度(表6,第17页)。
- EgoEditBench 自我中心视频编辑定性对比(图8,第20页)与编辑传播定性对比(图9,第20页)。
- HOI 训练数据消融(图10,第21页)、颜色质量与 Energy Annealing 消融(表7、图11,第22页)、训练策略消融(表8,第23页)。
关键结果与论文证据
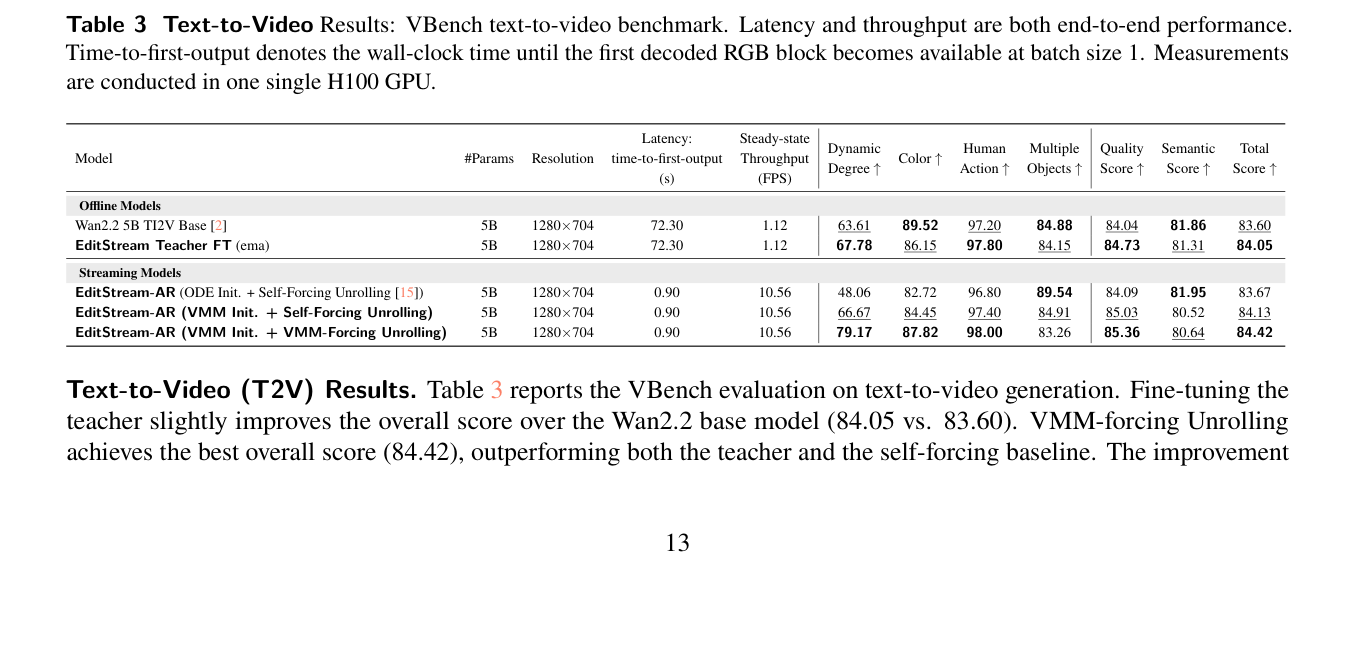
- EditStream-AR(VMM Init. + VMM-Forcing Unrolling)在 VBench T2V 总分为 84.42,超过教师(84.05)与 Self-Forcing 基线(83.67/84.13),说明流式学生可以在质量上追平甚至略超双向教师(第13页)。
- 流式模型 time-to-first-output 为 0.90s,单 H100 GPU 稳态吞吐 10.56 FPS;双 GPU 并行 VAE 解码可达 16.10 FPS,证明少步自回归推理具备实用延迟(第13页)。
- EditVerse V2V 基准上 EditStream-AR(VMM-Forcing)Video Quality 达 7.35,为流式模型中最高;教师为 7.52,差距很小(第15页)。
- RefVIE-Bench 上 EditStream-AR 总体 3.72(VMM Init. + Self-Forcing)与 3.71(VMM-Forcing),均超过教师(3.53)与 Kiwi-Edit(2.96/3.40),说明流式学生甚至优于离线参考编辑方法(第17页)。
- V2VCameraPose 上 VMM-Forcing 的 Hole Complete. 达 97.48、Hole Temp. Stab. 84.03、Gated Hole Fill Qual. 36.27,优于 Self-Forcing 变体,但 Gated Hole Fill Qual. 仍明显低于离线方法 Vista4D(51.25)与 TrajCrafter(39.06)(第17页)。
- 消融显示移除 warm-up 或初始化组件使 T2V 总分从 84.42 降至 84.07(E6)与 83.87(E7),但视频编辑任务性能基本不变,说明这些设计对生成任务影响更大(第24页)。
- VMM-forcing 在 VBench multiple_objects 指标(83.26)低于 Self-Forcing 基线(89.54),部分因更强运动导致物体移出画面,检测器也存在局限性(第13页)。
- 定性对比显示 VMM 输出比 DMD 类基线更少塑料感、材质更真实,但略欠锐度;EgoEdit 结果复用自官方项目网站,非本工作复现(图8,第20页)。
阅读时需要注意
- 720p 下 10.56 FPS 尚未达到实时播放速度,需要更多工业级优化与更强推理硬件。
- VMM-forcing 在 VBench multiple_objects 指标低于 Self-Forcing 基线,部分因更强运动导致物体移出画面。
- V2VCameraPose 上 Gated Hole Fill Qual. 仍明显低于离线方法 Vista4D 与 TrajCrafter。
- Energy Annealing 的 ηEA 因子需要针对不同模型手动调参。
- 与 LiveEdit、SANA Streaming 等基线的定性对比受训练数据差异影响,不能单独归因于架构或蒸馏策略。
关联工作
- Diffusion Forcing 首次结合 next-token 预测与全序列扩散训练,为流式生成奠定基础;CausVid 将双向视频扩散模型转换为少步因果学生,采用 DMD 蒸馏;Self-Forcing 通过展开学生自身生成历史序列减小 train-inference 差距,是本文对比的基线蒸馏方案。
- Causal Forcing / Causal Forcing++ 强调教师因果性的重要性并改进初始化策略;VACE 与 EditVerse 分别以共享条件接口和 token 拼接统一多模态生成与编辑任务。
- Moment Matching Distillation(MM)是 VMM 的基础,在干净样本空间匹配条件均值;DMD 是分布匹配蒸馏方法,VMM 与其对比并指出其模式坍缩问题。