快速导读:提出MSM-Mem框架,将临床经验分解为语义、情景和视觉三类持久记忆,通过增量写回使医学AI智能体随使用逐步提升推理能力。
MSM-Mem(Medical Structured Multimodal Memory)针对医学多模态大语言模型(MLLM)在临床场景中的根本缺陷提出:现有智能体大多是无状态推理系统,每次查询都从零开始,无法利用患者历史、多模态证据和累积诊断经验。论文的核心主张是,临床决策本质上是经验驱动的,医生通过综合病史、影像观察和既往诊断逐步完善推理,而智能体若缺乏持久记忆,就必然陷入幻觉和纵向推理不足。
MSM-Mem将临床经验分解为三类互补的持久记忆:语义记忆存储患者级纵向诊断摘要,情景记忆存储时间索引的患者-临床医生交互记录,视觉记忆存储细粒度影像证据。框架通过离线循环构建基础记忆,在线循环执行检索、提示构建和自适应路由推理,并根据新颖性阈值、长度约束和临床关键词门控进行结果驱动的增量写回。
英文题目:MSM-Mem: A Universal Medical Structured Multimodal Memory Framework for Medical AI Agents
论文出处:arXiv 每日论文精选 · arXiv:2608.21810
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有RAG(检索增强生成)方法仅做外部知识检索,无法积累和内部化经验知识。检索到的内容用完即弃,智能体不会因为处理过类似病例而变得更擅长处理下一个病例。这与临床医生的成长路径形成鲜明对比:医生的价值恰恰在于经验的内化。
已有智能体记忆方法各有缺陷。语义记忆压缩会丢失视觉细节;图像-描述记忆存在描述偏差,因为描述文本无法完整还原影像信息;纯视觉记忆缺乏语义和时间结构,难以支撑纵向推理;LLM策展记忆可能引入幻觉和记忆漂移,因为让模型自己决定记住什么本身就不可靠。
论文指出的研究空白是:缺少一个同时具备语义结构、时间结构、视觉保真度和可控写回机制的医学记忆框架。这正是MSM-Mem试图填补的位置。
核心创新
- 提出语义+情景+视觉三类互补的医学结构化多模态记忆框架
- 设计结果驱动的增量写回机制,使智能体随使用持续积累经验并自我进化
- 引入基于MoE门控权重的自适应路由,仅微调路由网络而冻结专家参数
- 在检索中采用FAISS余弦相似度排序与患者ID一致性约束
方法概览
MSM-Mem将多模态临床证据分解为语义记忆(患者级纵向诊断摘要)、情景记忆(时间索引的患者-临床医生交互记录)和视觉记忆(细粒度影像证据),通过离线循环构建基础记忆,在线循环执行检索、提示构建和自适应路由推理,并根据新颖性阈值、长度约束和临床关键词门控进行结果驱动的增量写回。
- 三类记忆模块:语义记忆(semantic memory)存储患者级纵向诊断摘要,提供压缩但语义完整的病史;情景记忆(episodic memory)存储时间索引的患者-临床医生交互记录,保留诊断过程的时间线索;视觉记忆(visual memory)存储细粒度影像证据,避免描述偏差。
- 离线循环(offline loop):在部署前对历史病例进行编码,通过记忆构建器(memory builder)构建基础世界记忆,为在线推理提供初始知识库。
- 在线循环(online loop):执行查询后,先检索基础记忆,再经过融合写回阶段(fused writeback stages),访问微调后的基础模型,并通过自适应路由选择MoE专家。
- 增量写回机制:根据新颖性阈值、长度约束和临床关键词门控决定是否将新经验写回记忆。写回是结果驱动的,即只有对推理结果有贡献的经验才会被保留,避免记忆膨胀和噪声累积。
- 自适应路由(adaptive routing):基于记忆特征选择MoE专家,仅微调路由网络(MoE-FT)而冻结专家参数,在保持模型泛化能力的同时让记忆特征影响专家选择。
- 检索采用FAISS余弦相似度排序,并施加患者ID一致性约束,确保检索到的记忆属于同一患者,避免跨患者记忆污染。
逐图理解论文
失败案例:无状态推理的困境
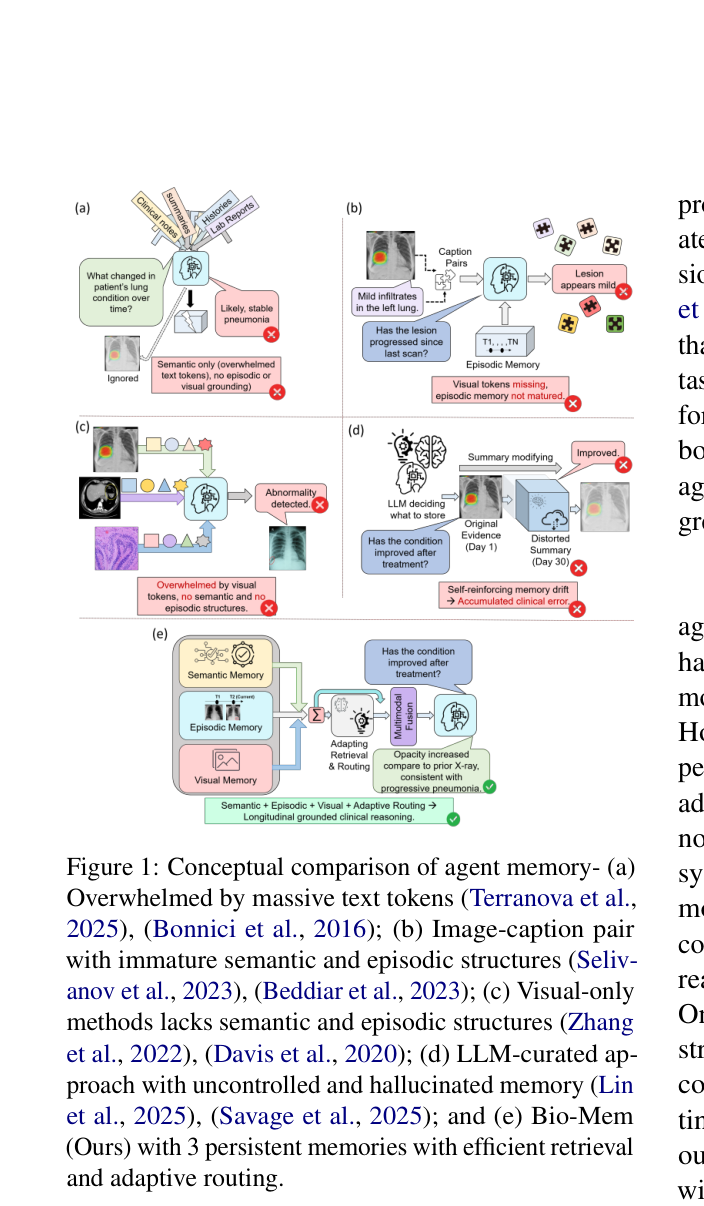
图1对比了五类记忆方法:文本token过载、图像-描述对、纯视觉、LLM策展和本文的Bio-Mem。重点观察(e)中三类持久记忆如何通过高效检索和自适应路由协同工作,这是本文区别于前四类的核心。
MSM-Mem的贡献:三类记忆与增量写回
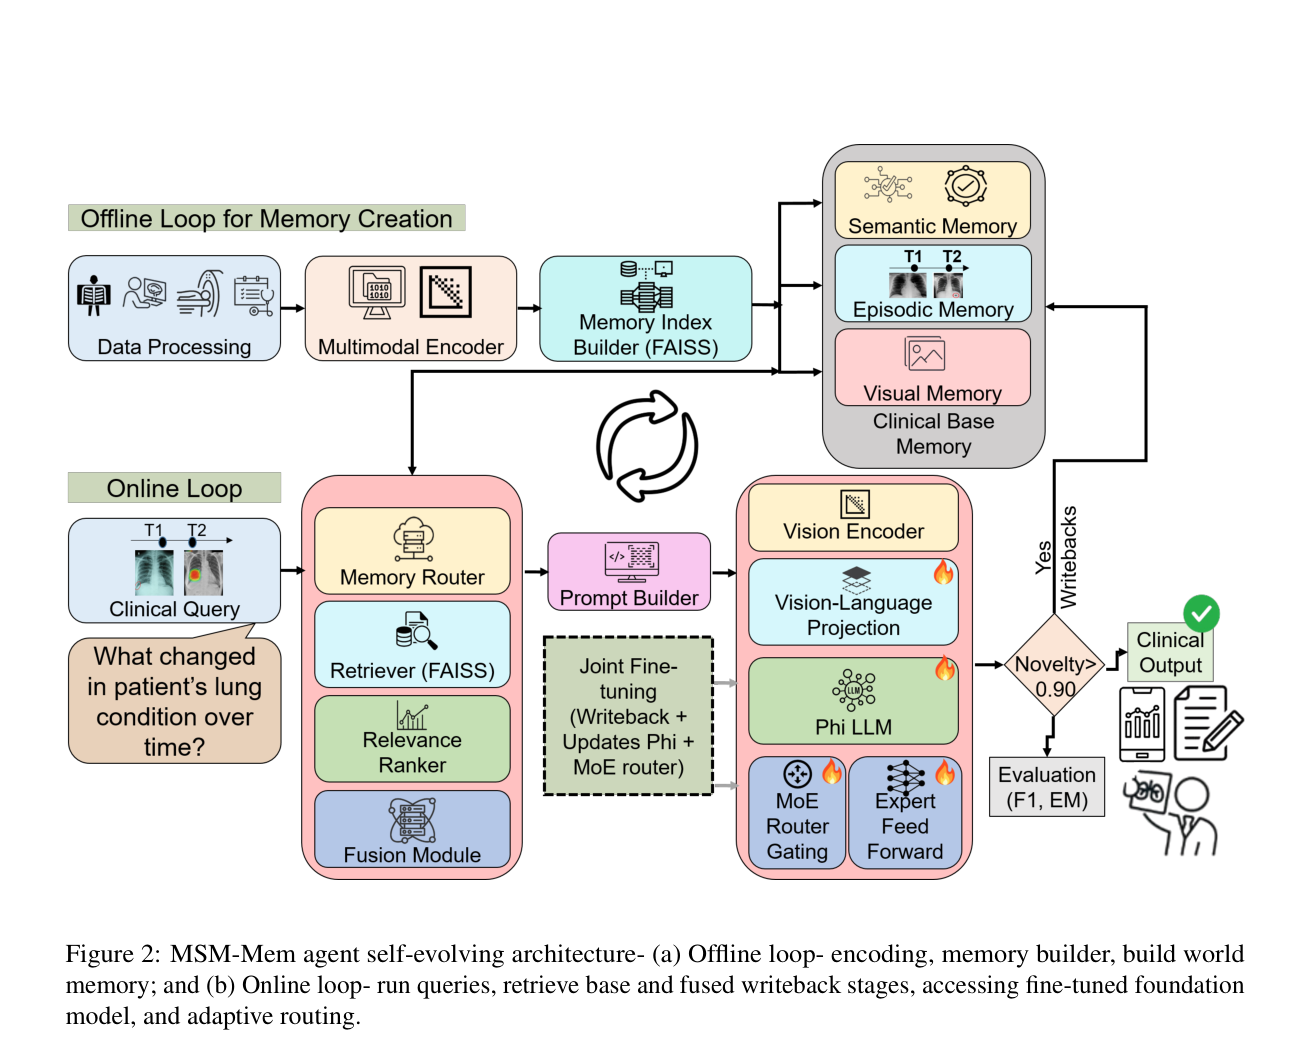
图2展示MSM-Mem的自进化架构,分离线循环和在线循环两部分。注意离线循环负责构建基础世界记忆,在线循环负责查询、检索、融合写回和自适应路由,两个循环的衔接是理解增量写回的关键。
证据:记忆让智能体持续进化
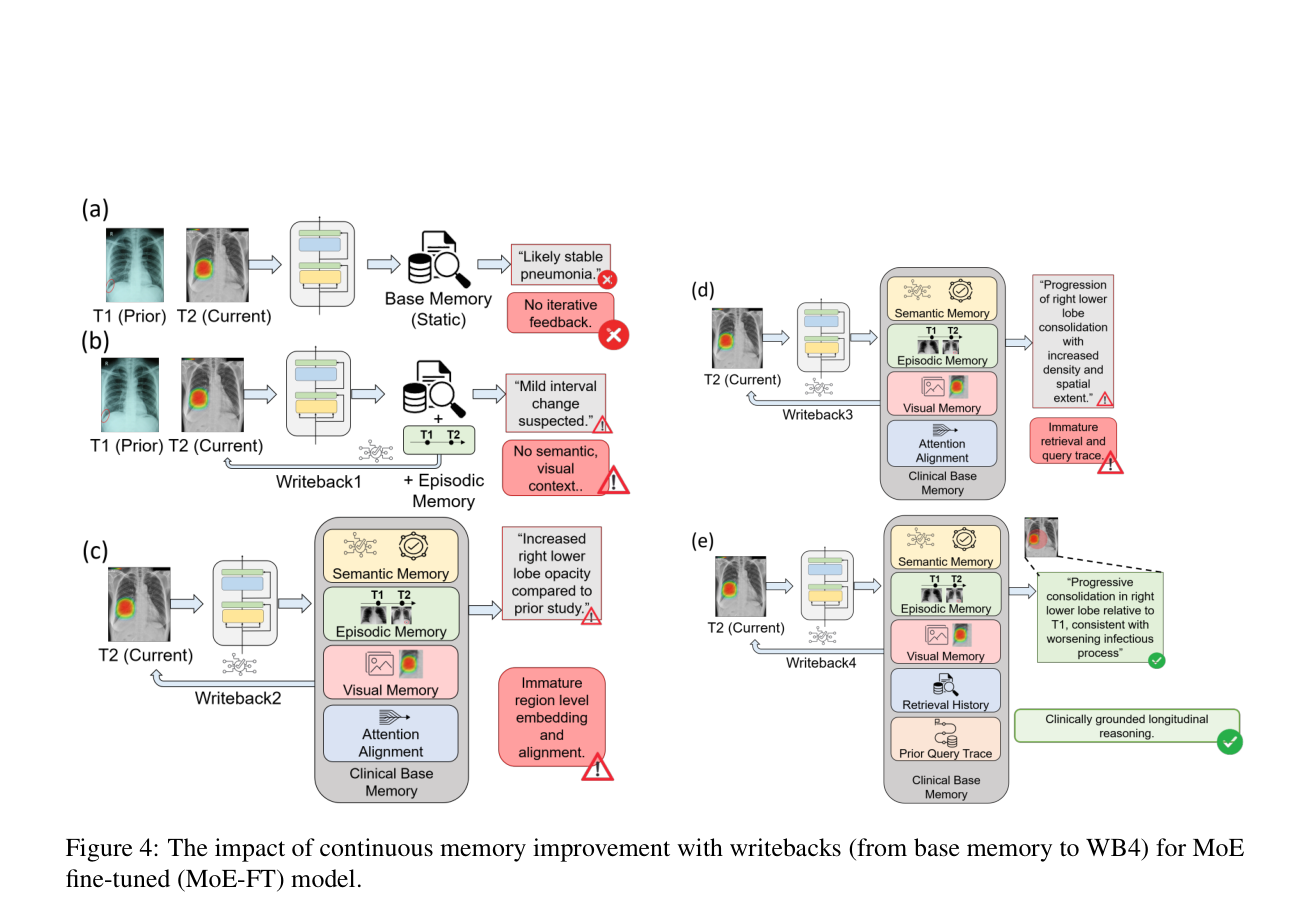
图4展示从基础记忆到WB4的连续改进。重点观察性能是否单调上升,以及哪一阶段增益最大,这反映了增量写回的实际贡献节奏。
实验如何设计?
- 数据集为人工整理的MIMIC-CXR子集,按受试者划分:30%用于记忆构建,60%用于微调,10%用于验证。注意这不是标准基准,结果可比性有限。
- 对比三种骨干:MoE-LLaVA Base(无微调)、Fine-tuned(FT,全参数微调)和MoE-layered Fine-tuned(MoE-FT,仅微调MoE门控权重)。
- 消融研究覆盖七种记忆组合:S、E、V、S+E、S+V、E+V、S+E+V,在WB4阶段评估。
- 评估指标为impression-level F1和EM(Exact Match),在最终写回阶段(WB4)报告。
- 连续写回分析从Base到WB4共五个阶段,观察性能随写回轮次的演化。
关键结果与论文证据
- 全记忆配置(S+E+V)在MoE-FT骨干上达到F1 54.92%、EM 51.50%,较无记忆基线(18.43/16.37)提升约36.5/35.1个百分点(Table 1, p.7)。
- 单模块中情景记忆增益最大:MoE-FT下F1从18.43提升至28.53(Table 1, p.7)。
- E+V组合在MoE-FT下F1达44.80,较单E(28.53)提升16.27个百分点,说明视觉记忆与情景记忆有强互补性(Table 1, p.7)。
- MoE-FT较non-MoE-FT在E、V、E+V、S+E+V模态下分别增益8%、7.66%、7.16%、7.25%,说明自适应路由对记忆利用有稳定贡献(Figure 7, p.8)。
- 连续写回分析显示性能从Base到WB4持续提升,证明增量写回机制确实让智能体随使用逐步进化(Figure 4, p.5;Figure 6, p.7)。
- 代表性案例显示:静态基础记忆(WB0)无法将新影像发现置于时间脉络中,而完整记忆配置(WB4)能整合检索历史和先前查询痕迹,实现临床上有根据的疾病进展解读(Figure 4, p.7)。
阅读时需要注意
- 遇到不相关既往病例、过时患者状态或噪声情景嵌入时可能产生幻觉。
- 写回错误可能传播并放大,导致长期级联幻觉,这是增量记忆系统的固有风险。
- 临床模式变化不可预测,新旧证据矛盾时需大量人工干预。
- 可能存在潜在空间错位、记忆检索不稳定和写回窗口饱和问题。
- 数据集为人工整理的MIMIC-CXR子集,非标准基准,结果可比性有限;仅评估胸部X光单一模态,泛化性未经验证。
- 论文中图1标注为'Bio-Mem (Ours)'而正文框架名为MSM-Mem,命名不一致。
关联工作
- MoE-LLaVA(Lin et al., 2024a)作为本文的MLLM骨干模型,提供混合专家架构基础。
- ImageBind(Girdhar et al., 2023)用于视觉嵌入提取,为视觉记忆提供编码能力。
- RAG(Lewis et al., 2021)作为对比基线,仅做外部知识检索而无法积累经验。
- A-MEM(Xu et al., 2025)是现有智能体持久记忆方法,但仍难以完全整合多模态时间线索。
- Medical Graph RAG(Wu et al., 2025)基于知识图谱的生物医学智能体,存在稀疏覆盖和纵向推理不足。