快速导读:提出BreMRIs-VQA多序列乳腺MRI问答基准与SeVeR框架,通过原型选择与门控检索在暴露更少视觉token的同时提升3D医学VQA性能。
多序列MRI诊断要求模型同时整合T1w、T2w、DWI、ADC、DCE等互补模态证据,但现有医学视觉问答方法仍以单模态输入为主,且缺乏大规模多序列3D问答数据。本文提出BreMRIs-VQA基准与SeVeR框架,直面冗余视觉暴露导致的信号稀释问题。
SeVeR的核心主张是:不是所有视觉token都值得暴露给解码器。通过贪心原型选择压缩冗余token,再以变化感知门控注意力按需检索多层特征,SeVeR在暴露更少视觉token的同时超越了全token基线,并在公共3D基准上验证了迁移能力。
英文题目:SeVeR: Selective Visual Exposure and Retrieval for 3D Medical Image Question Answering
论文出处:arXiv 每日论文精选 · arXiv:2608.25630
原始论文:PDF / 论文页面
这篇论文解决什么问题?
医学VQA正从单图识别走向复杂影像研究推理。多序列MRI的临床价值在于互补性:DCE揭示血流动力学,DWI/ADC反映细胞密度,T1w/T2w提供解剖结构。但将六种模态的3D体积直接送入视觉编码器会产生海量token,其中大量背景体素重复出现,关键病灶信号被稀释。
现有视觉token剪枝方法如VisionZip、DivPrune采用不可逆删除策略,一旦token被移除,其视觉内容无法在解码阶段恢复。MMToK虽然使用覆盖最大化选择token,但其选择策略独立于语言条件,无法根据问题动态调整。
数据层面,现有3D医学VQA基准如3D-RAD、DeepTumorVQA规模有限且以CT为主,缺乏多序列MRI的问答数据。这导致模型无法学习跨序列证据整合的能力。
因此,本文面临双重挑战:一是构建多序列乳腺MRI问答基准,二是在不牺牲精度的前提下减少视觉暴露,同时保留按需恢复细节的能力。
核心创新
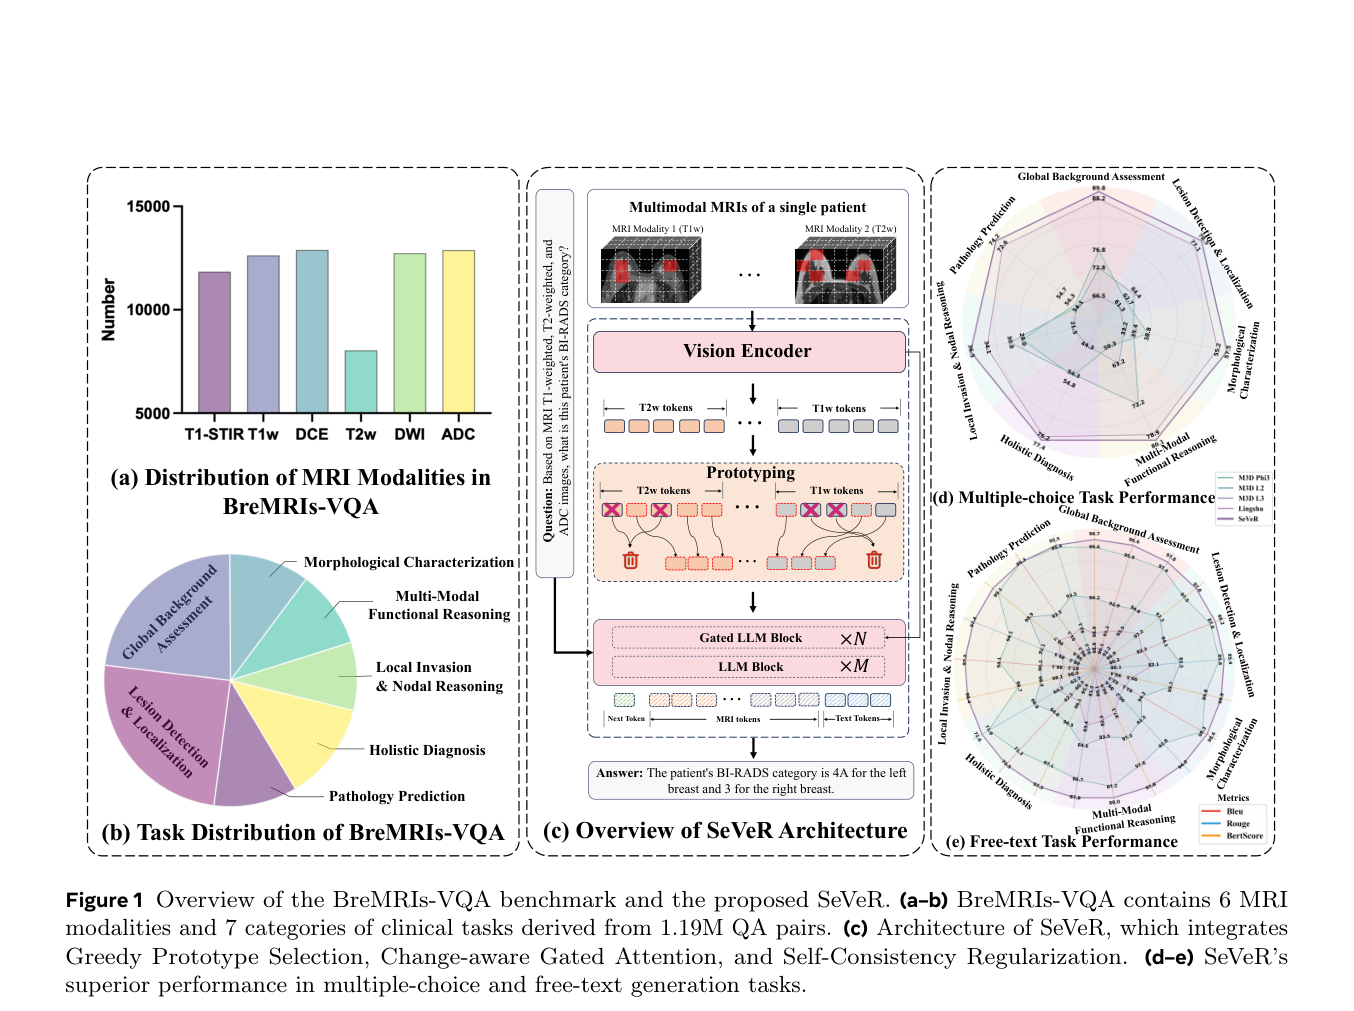
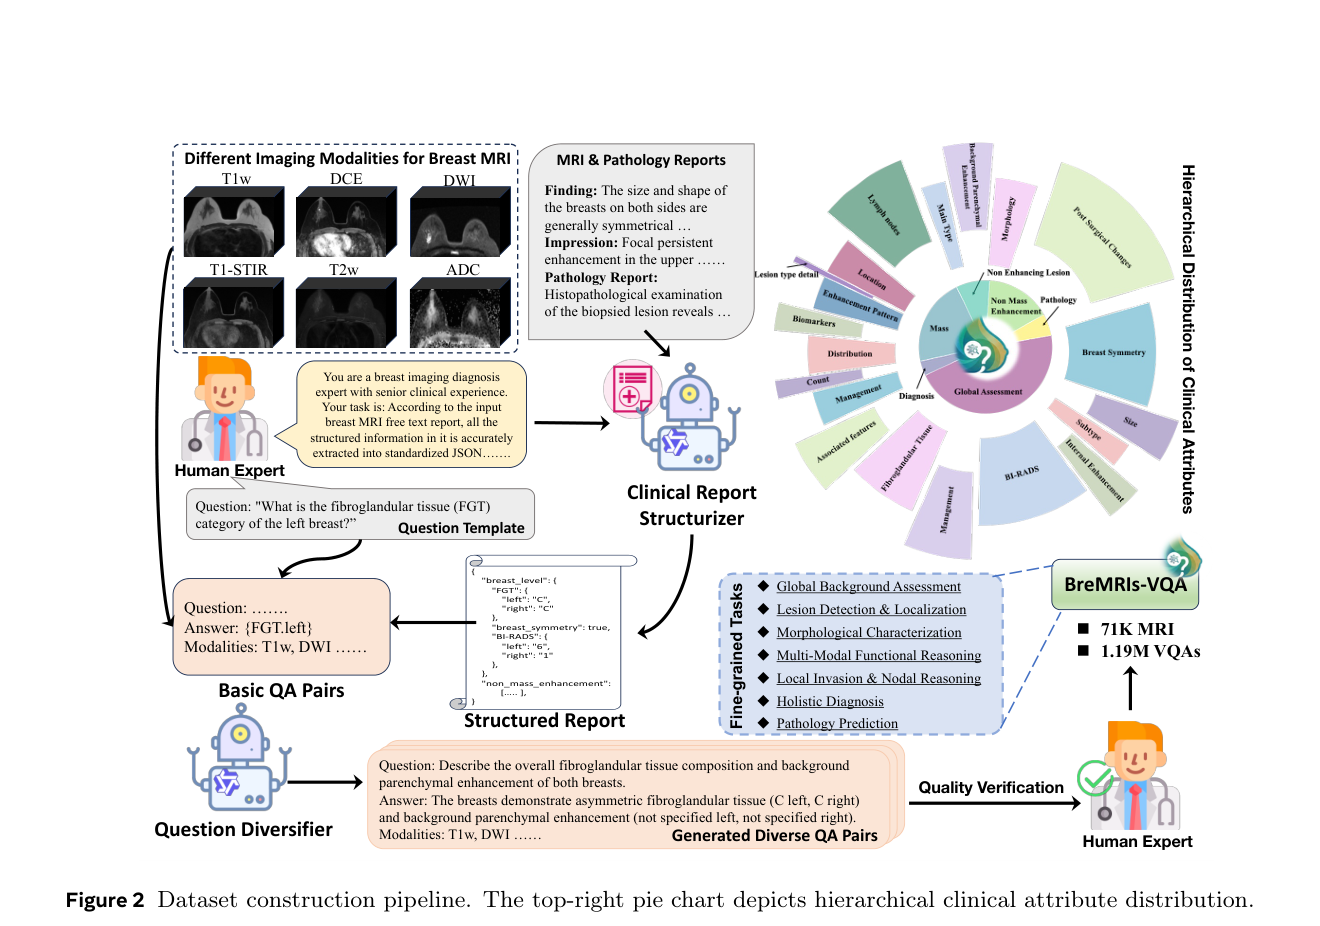
- 构建BreMRIs-VQA:71.0K序列、12.9K患者、1.19M QA对的多序列乳腺MRI基准,覆盖7类临床工作流任务
- 提出GPS(Greedy Prototype Selector):以全局亲和度覆盖最大化的贪心算法压缩冗余3D token为模态级原型
- 提出CaGA(Change-aware Gated Attention):基于层间余弦相似度变化门控,按需从多层特征库检索互补证据
- 提出SCR-MU(Self-Consistency Regularization with Marginal Utility):边际效用损失抑制无益检索,防止门控退化为常开/常关
方法概览
SeVeR先用共享3D ViT编码各模态体积,GPS通过全局亲和度贪心选择紧凑原型;解码时CaGA利用语言条件隐状态从多层特征库检索互补证据,并以SCR-MU边际效用自一致性正则抑制无益检索。
- BreMRIs-VQA构建:从12.9K患者的71.0K个MRI序列出发,基于BI-RADS结构化报告生成1.19M QA对,覆盖7类临床工作流任务,包括全局背景评估、病灶检测定位、形态学表征、多模态功能推理、局部侵犯与淋巴结推理、整体诊断和病理预测。
- 共享3D ViT编码:所有模态体积通过共享的3D视觉Transformer编码为密集token序列,保证模态间特征空间对齐。
- GPS贪心原型选择器:以全局亲和度矩阵为基础,贪心选择能最大化覆盖剩余token的原型,将冗余3D token压缩为紧凑的模态级原型。与MMToK的区别在于GPS仅准备候选空间,而非独立的选择策略。
- CaGA变化感知门控注意力:在解码阶段,利用语言条件隐状态计算层间余弦相似度变化,当变化超过阈值时触发门控,从多层特征库中检索互补证据注入解码器。
- SCR-MU边际效用自一致性正则:通过边际效用损失抑制无益检索,防止门控退化为常开或常关状态,保证检索行为与问题需求对齐。
- 训练策略:使用straight-through estimator处理离散门控的梯度回传,使CaGA可端到端训练。
逐图理解论文
失败案例与直觉
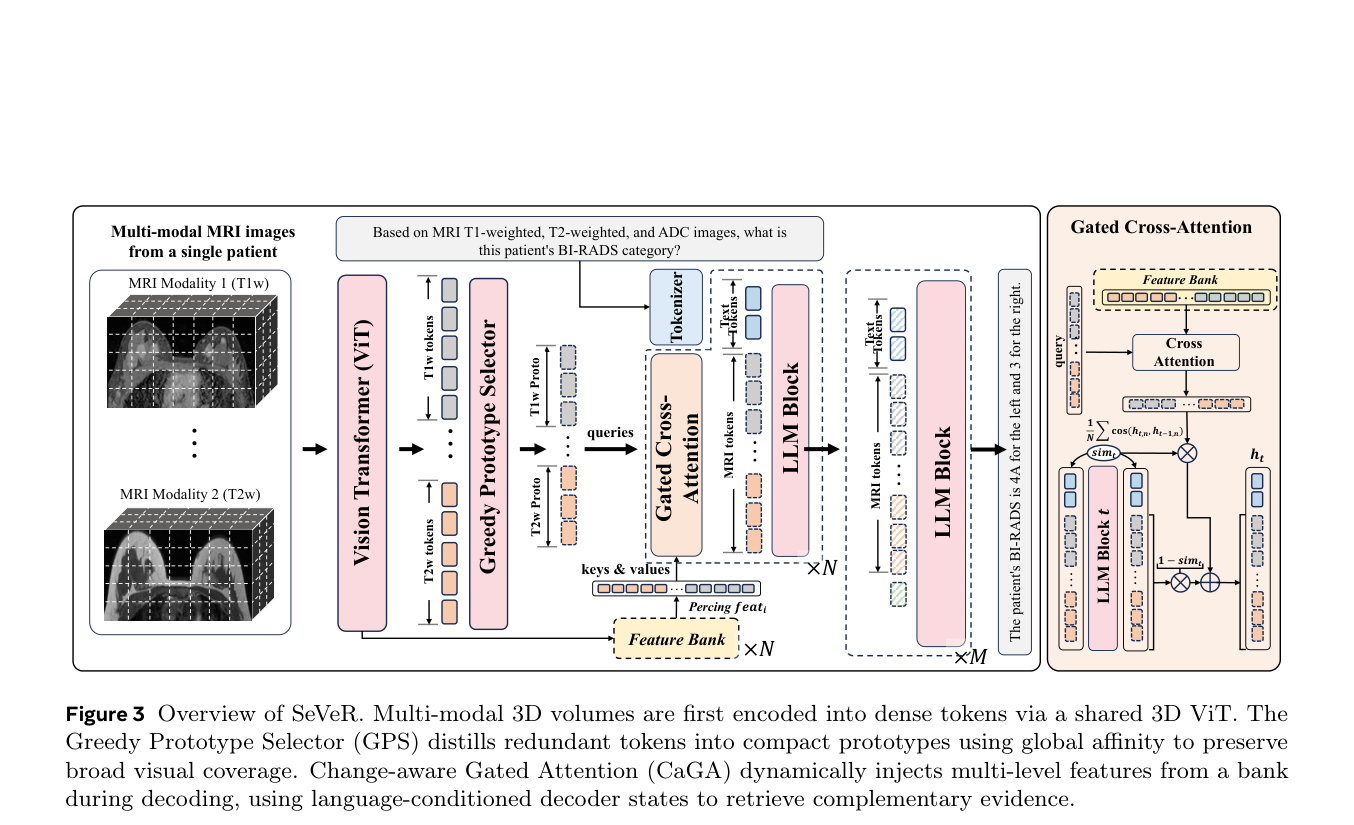
图3详细展示SeVeR的GPS与CaGA机制。注意GPS如何从密集token中选出紧凑原型,以及CaGA如何从多层特征库中按需检索,这是理解选择性暴露的关键。
研究缺口
现有方法陷入两难:全token暴露导致信号稀释和延迟过高,不可逆剪枝则永久丢失可能关键的视觉内容。更根本的问题是,现有3D医学VQA基准缺乏多序列MRI数据,模型从未学习过跨序列证据整合。
验证与证据
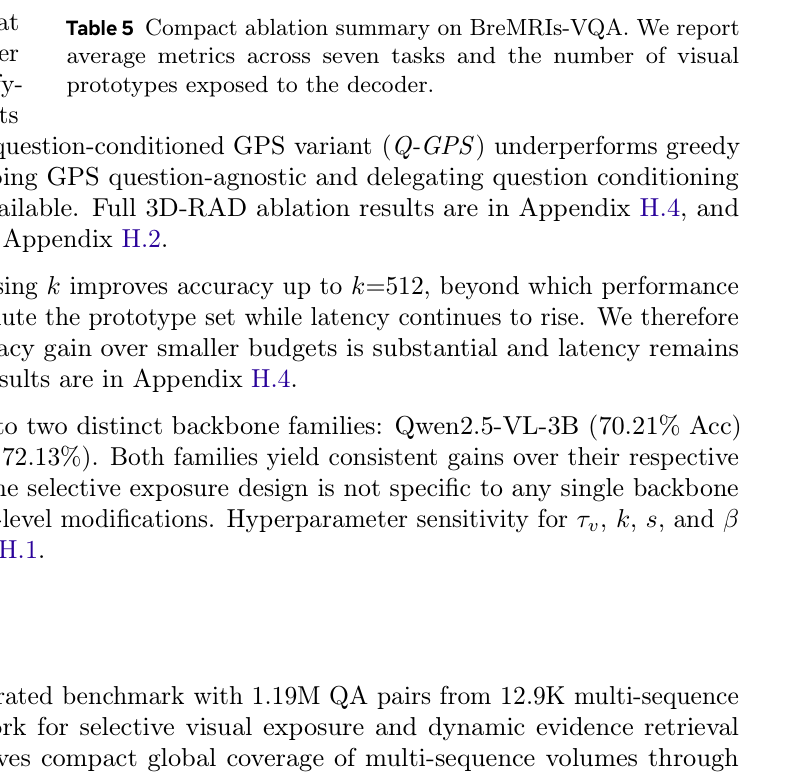
在BreMRIs-VQA上,SeVeR以512个原型token超越了全token基线,同时延迟降低约三分之一。消融显示,去除CaGA导致准确率下降超过6个百分点,去除SCR-MU使BLEU下降超过4个百分点。在公共基准3D-RAD和DeepTumorVQA上,SeVeR同样取得领先,甚至超过13B参数的RadFM。
结论与局限
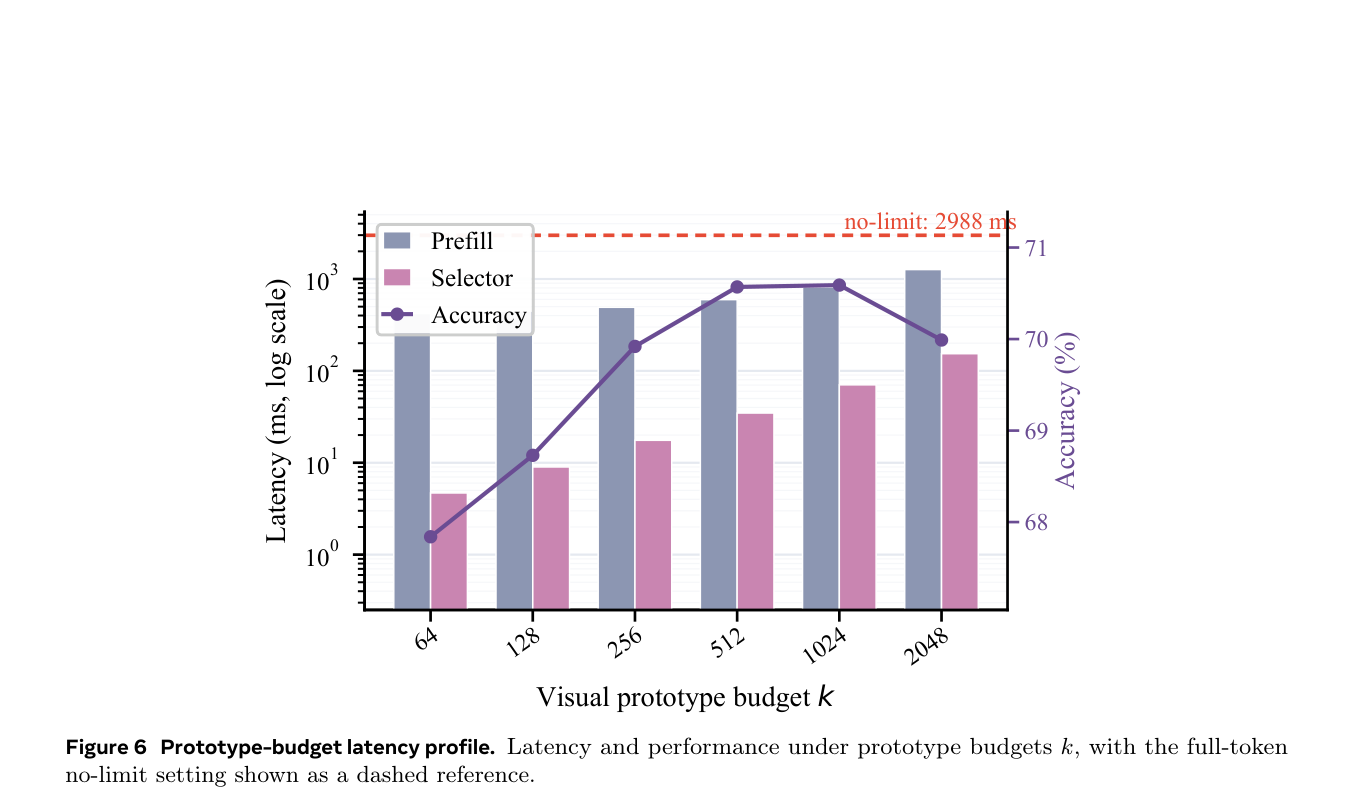
图6展示原型预算k与延迟、性能的关系。注意k增大时性能趋于饱和而延迟上升,说明存在最优预算区间,支持选择性暴露的效率主张。
实验如何设计?
- BreMRIs-VQA主实验:对比零样本通用MLLM、医学VLM、3D专用模型(M3D、Lingshu)与微调基线(Qwen2.5-VL、Qwen3-VL),评估多选准确率与自由文本生成指标。
- 效率分析:在相同骨干(Qwen2.5-VL)和token预算下,对比VisionZip、DivPrune、MMToK的延迟与精度。
- 缺失模态鲁棒性:六种模态设置(S1–S6)下对比SeVeR与无原型选择变体,验证对不完整输入的鲁棒性。
- 公共基准迁移:在3D-RAD与DeepTumorVQA上进行零样本与微调评估,验证跨数据集泛化能力。
- 消融研究:组件贡献、原型预算k、骨干兼容性(3B/4B/8B)、超参数敏感性。
- 可解释性分析:可视化层间模态贡献与token级门控注意力稀疏化。
关键结果与论文证据
- BreMRIs-VQA上SeVeR-4B(k=512)平均准确率70.57%,超过全token基线69.18%,同时延迟从953ms降至644ms(第6-7页)。
- 去除CaGA导致准确率下降6.21pp(69.45→64.36),BERTScore下降3.16pp,证明门控检索是核心贡献(第9页)。
- 去除SCR-MU后BLEU下降4.04pp(91.08→87.04),说明边际效用正则有效抑制无益检索(第9页)。
- 3D-RAD上SeVeR在Existence Detection(82.62)、Static Temporal Diagnosis(51.77)、Longitudinal Temporal Diagnosis(75.28)均获最高准确率(第8页)。
- DeepTumorVQA上SeVeR总体MC 0.687、FT 0.599,超过13B RadFM(0.662/0.555),证明选择性暴露优于大规模预训练(第9页)。
- SeVeR-8B平均准确率72.13%,较4B提升1.56pp,且任务排序在3B/4B/8B间保持一致,说明机制与骨干无关(第29页)。
- Morphological Characterization任务上SeVeR多选准确率57.45略低于微调Qwen3-VL的57.68,提示紧凑原型可能无法完整保留细粒度形状信息(第6页)。
- BreMRIs-VQA质量验证:平均总体评分2.85/3,专家审核通过率97.5%(第18页)。
阅读时需要注意
- 自由文本生成仅用自动语言指标评估,缺乏放射科医生主导的人工评估,临床可用性尚未充分验证。
- GPS采用固定原型预算,未根据序列复杂度自适应调整压缩比,可能对信息密度高的序列欠压缩或过压缩。
- 未在真实放射科工作流中进行集成验证,部署可行性有待临床环境测试。
- DeepTumorVQA的Measurement和Recognition子类中,大规模CT预训练模型RadFM优于SeVeR,说明跨模态迁移仍有局限。
关联工作
- VisionZip与DivPrune是视觉token剪枝基线,采用不可逆删除策略,在效率对比中精度均低于全token基线。
- MMToK使用覆盖最大化选择token,但GPS与其区别在于GPS仅准备候选空间,选择策略由CaGA的语言条件门控动态决定。
- M3D预训练于单模态CT数据,在多序列MRI上表现受限,说明单模态预训练无法直接迁移到多序列场景。
- RadFM作为13B放射学基础模型,在DeepTumorVQA上作为强基线,但SeVeR以4B规模超越之,证明选择性暴露的效率优势。