快速导读:GLAD 提出信息受限的全局-局部多视角融合框架,通过 OGA 和 MMA 模块防止跨视角信息泄漏导致的重建差距坍缩,在多视角异常检测上取得 SOTA 性能。
多视角异常检测的直觉很诱人:一个视角看不到的缺陷,另一个视角或许能补上。但 GLAD 这篇论文揭示了一个反直觉的现象——把多个视角的信息直接融合,反而会让检测变差。原因在于,正常视角的线索会通过融合模块传播到解码器,使解码器获得足够信息去忠实重建异常区域,导致正常与异常输入之间的重建差距坍缩。
GLAD 的核心贡献是把这个问题命名为 cross-view information leakage,并设计了一套信息受限的融合框架来对抗它。框架由两个模块组成:Object-Guided Attention(OGA)负责全局物体级融合,Multi-view Merging Attention(MMA)负责局部 token 级融合。两者都刻意限制信息流动,以保持重建差距这一检测核心信号。
英文题目:See More, Detect Less? Taming Information Leakage in Multi-View Anomaly Detection
论文出处:arXiv 每日论文精选 · arXiv:2608.25168
原始论文:PDF / 论文页面
这篇论文解决什么问题?
工业视觉检测中,单视角重建式异常检测方法(如 Dinomaly、ViTAD)已经相当成熟。它们基于一个简单假设:在正常样本上训练的重建模型,遇到异常区域时会重建失败,从而产生大的重建误差。这个重建差距正是检测的核心信号。
当输入从单视角扩展到多视角时,一个自然的想法是把所有视角的特征融合起来再重建。但论文指出,这种朴素融合会带来严重问题:如果某个视角恰好能看到异常区域,而其他视角是正常的,那么正常视角的特征会通过融合传播到解码器,帮助它重建出异常区域的内容。结果就是,异常被'洗掉'了,重建差距消失,检测失效。
现有方法对这个问题的处理并不充分。MVAD 采用 patch 级交叉注意力,但缺乏全局物体级表示,且内存开销大;IDIF 把视图内特征解耦到共享体素空间,但类别特定设计难以扩展。更重要的是,此前没有人明确把信息泄漏当作多视角重建式 AD 的根本性挑战来形式化。
GLAD 的定位由此清晰:不是简单地'融合更多信息',而是'在融合的同时限制信息泄漏'。这个区分是理解整篇论文的关键。
核心创新
- 首次识别并形式化 cross-view information leakage 这一多视角重建式 AD 的根本性挑战
- 提出 OGA 模块:聚合全局物体 token,通过 token replacement、sigmoid 门控、温度锐化、不回传 CLS token 四种信息限制机制保持重建差距
- 提出 MMA 模块:基于 ReLU² 线性注意力核的 O(N) 复杂度跨视角 token 级融合,含可学习视角重要性矩阵和 token-wise 门控
- 首个同时满足统一模型、多视角输入、视觉基础模型、token 级和物体级跨视角融合五个特性的多视角 AD 框架
方法概览
GLAD 采用冻结的 DINOv2 ViT-Base/16 编码器逐视角提取特征,经 OGA 全局融合和 MMA 局部融合后,通过 MLP bottleneck 进入 Transformer 解码器重建。OGA 聚合所有视角的 CLS token 为全局物体 token,以温度缩放 sigmoid 门控交叉注意力广播到 patch token,并采用 token replacement 而非残差加法。MMA 使用 ReLU² 线性注意力核、可学习视角重要性权重和 token-wise 门控,实现 O(N) 复杂度的局部跨视角融合。异常分数基于编码器与解码器输出的余弦距离。
- 整体架构:GLAD 使用冻结的 DINOv2 ViT-Base/16 编码器逐视角提取特征,特征经过 OGA 全局融合和 MMA 局部融合后,通过 MLP bottleneck 进入 Transformer 解码器重建。异常分数基于编码器与解码器输出的余弦距离。
- OGA 的全局融合:聚合所有视角的 CLS token 为全局物体 token,通过温度缩放 sigmoid 门控的交叉注意力广播到 patch token。关键设计是 token replacement——用交叉注意力输出直接替换原始 patch token,而非残差加法,这限制了原始信息的直接回流。
- OGA 的四种信息限制机制:token replacement 阻断残差捷径;sigmoid 门控替代 softmax,使每个 patch 独立决定融合比例;温度锐化让门控更接近二值决策;全局 token 不回传各视角 CLS token,防止全局信息污染视角级表示。
- MMA 的局部融合:使用 ReLU² 线性注意力核实现 O(N) 复杂度的跨视角 token 级融合,包含可学习视角重要性矩阵和 token-wise 门控。相比 Deformable Attention 和 MVAS Block,它在精度和效率之间取得了更好的平衡。
- 信息受限的设计哲学:两个模块的共同原则是'融合但不泄漏'。OGA 在全局层面限制信息回流,MMA 在局部层面用门控控制融合比例。这种设计保证了重建差距不会因多视角信息而坍缩。
逐图理解论文
一个反直觉的失败案例
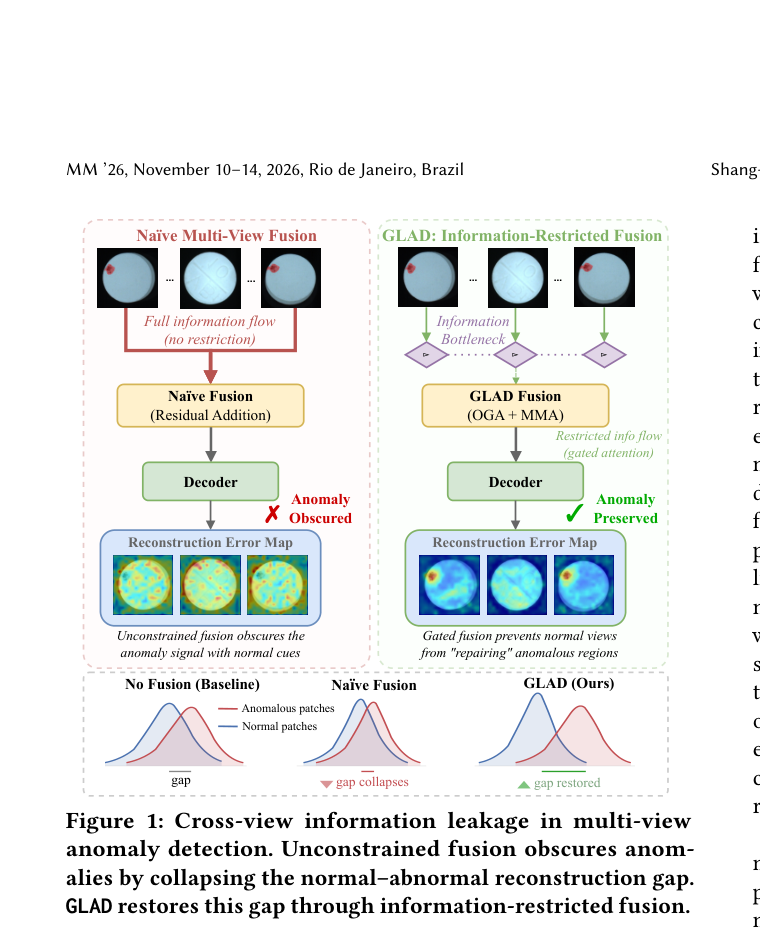
这张图直观展示了 cross-view information leakage 的机制:无约束融合时,正常视角线索传播到解码器,使异常区域被忠实重建,重建差距坍缩;GLAD 通过信息受限融合恢复了这一差距。观察正常与异常输入的重建误差差异即可理解核心问题。
研究空白
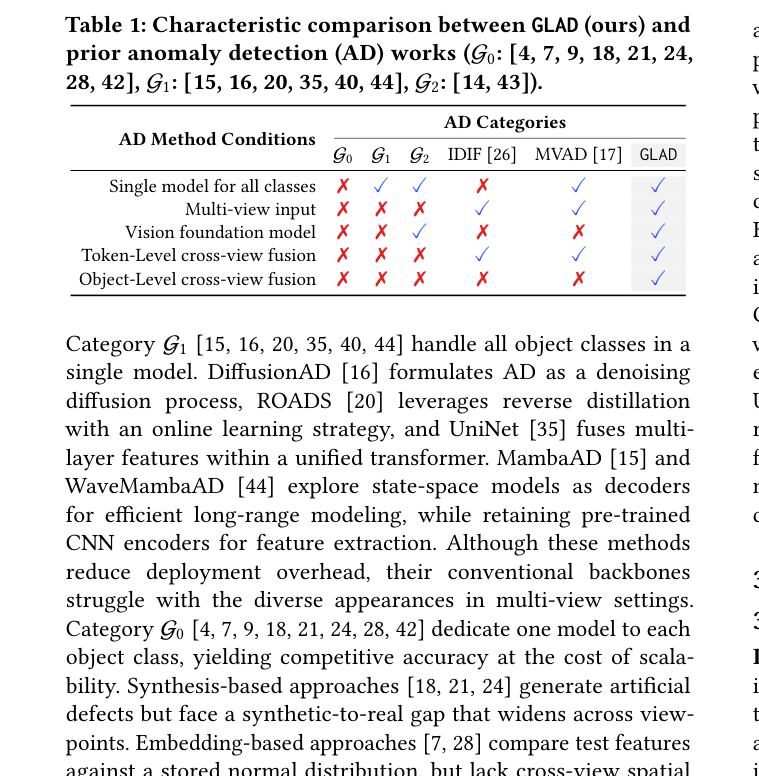
这张表对比了 GLAD 与先前 AD 工作的五个特性:统一模型、多视角输入、视觉基础模型、token 级融合、物体级融合。GLAD 是唯一同时满足全部五项的方法,这一定位是论文新颖性的直接证据。
GLAD 的解决方案
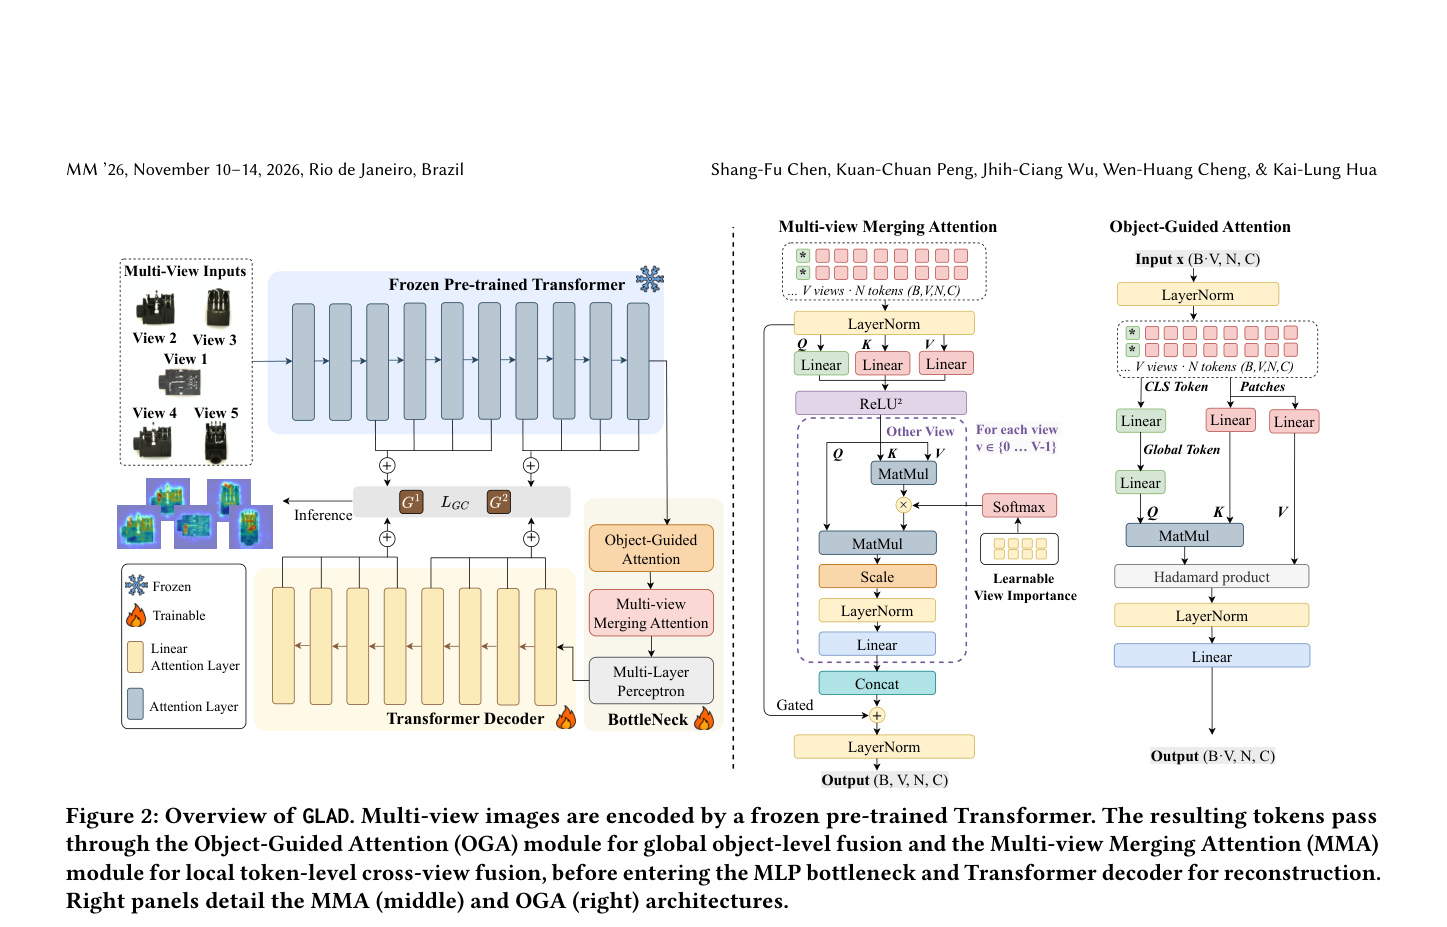
这是 GLAD 的整体架构图。左侧展示多视角图像经冻结 Transformer 编码后依次通过 OGA 和 MMA 再进入解码器的流程;右侧两个面板分别展示 MMA 和 OGA 的内部结构。重点观察 OGA 中 token replacement 和 sigmoid 门控的位置,以及 MMA 中线性注意力的数据流。
消融验证了设计哲学
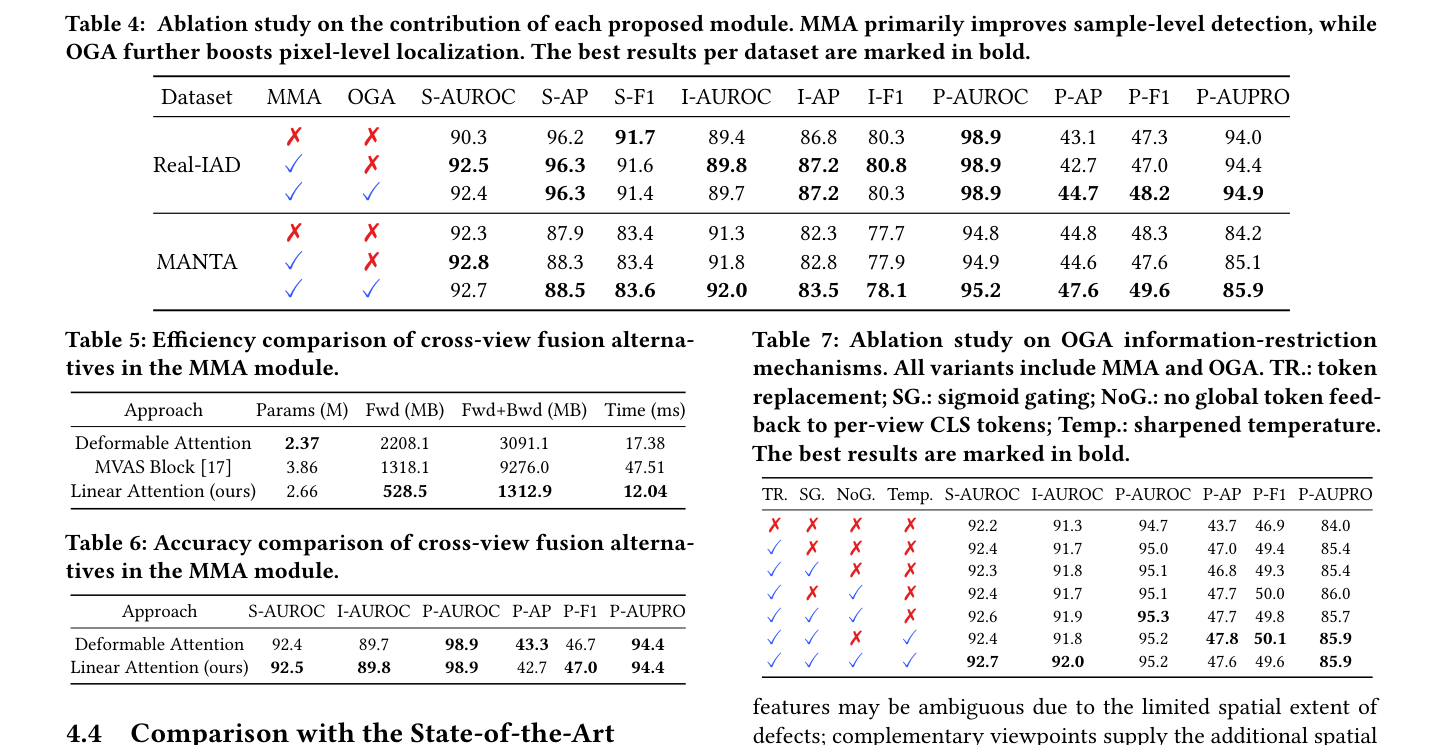
消融表显示 MMA 和 OGA 的独立贡献:单独加入 MMA 主要提升 sample-level 指标,再加入 OGA 后 pixel-level 指标显著改善,验证了两模块的互补性。
结论与局限
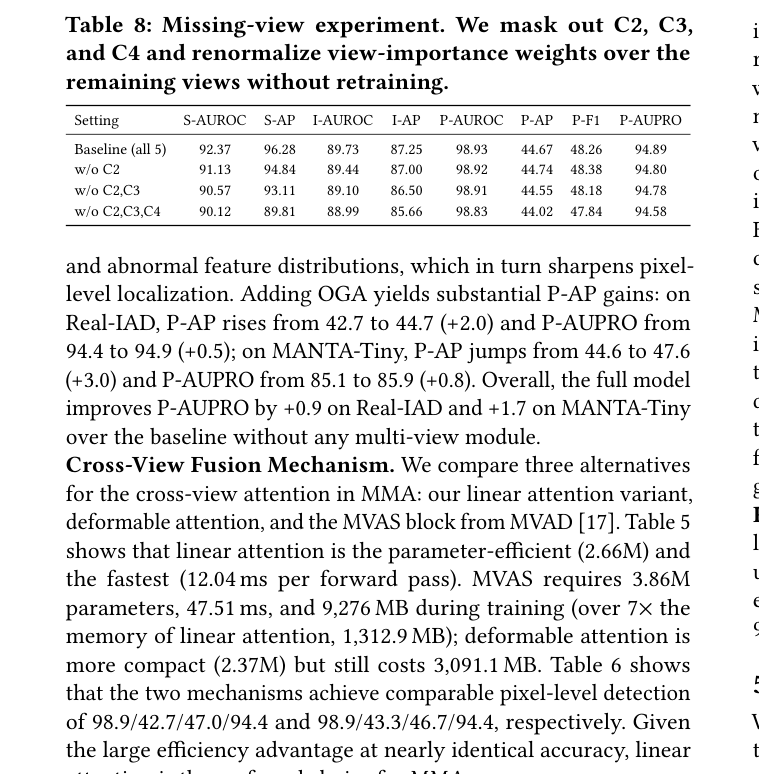
缺失视角实验。掩蔽三个视角后不重训练直接推理,性能仅小幅下降,说明视角重要性权重的重新归一化策略在推理阶段是有效的。
实验如何设计?
- 主实验在 Real-IAD 数据集上进行,与 RD4AD、UniAD、RD++、SimpleNet、DeSTSeg、RealNet、ViTAD、MVAD、Dinomaly 等九种方法对比。除 MVAD 外,所有方法均在多视角设定下重新复现。
- 在 MANTA-Tiny 数据集上进行第二组主实验,验证方法的跨数据集泛化能力。
- 消融实验分别考察 MMA 和 OGA 各模块的贡献,以及 OGA 四种信息限制机制各自的作用。
- 效率对比实验在 MMA 模块内比较线性注意力、Deformable Attention 和 MVAS Block 三种融合方案的参数、前向时间和训练内存。
- 缺失视角鲁棒性实验:掩蔽 C2、C3、C4 视角后,仅对剩余视角的 importance weights 重新归一化,不重训练直接推理。
关键结果与论文证据
- Real-IAD 上 GLAD 取得 S-AUROC 92.4、I-AUROC 89.7、P-AUROC 98.9、P-AP 44.7、P-AUPRO 94.9,10 项指标中 9 项最优(第 6 页 Table 2)。
- MANTA-Tiny 上 GLAD 全部 10 项指标最优,S-AUROC 92.7、I-AUROC 92.0、P-AUROC 95.2、P-AP 47.6、P-AUPRO 85.9(第 6 页 Table 3)。
- 相比最强单视角基线 Dinomaly,Real-IAD 上 P-AP 提升 1.6(43.1→44.7),P-AUPRO 提升 0.9(94.0→94.9);MANTA 上 P-AP 提升 2.8(44.8→47.6),P-AUPRO 提升 1.7(84.2→85.9)(第 7 页)。
- 相比 MVAD,Real-IAD 上 P-AP 提升 14.4,P-F1 提升 11.4,说明全局物体级融合的缺失是 MVAD 的主要短板(第 7 页)。
- 消融显示 MMA 主要提升 sample-level 检测,OGA 进一步改善 pixel-level 定位,两者互补(第 7 页 Table 4)。
- 效率对比中,MMA 线性注意力仅 2.66M 参数、前向 12.04 ms、训练内存 1312.9 MB,而 MVAS Block 为 3.86M、47.51 ms、9276.0 MB,线性注意力在精度相当的前提下大幅降低开销(第 7 页 Table 5)。
- 缺失视角实验:移除 C2、C3、C4 后 S-AUROC 仍保持 90.12,P-AUROC 98.83,说明视角重要性权重的重新归一化策略在推理阶段具备鲁棒性(第 8 页 Table 8)。
阅读时需要注意
- 仅在 Real-IAD 和 MANTA-Tiny 两个数据集上验证,未在完整 MANTA 数据集上评估,结论的泛化性有待进一步检验。
- 依赖固定五视角采集协议,未探索任意视角数量或无序视角输入的场景。
- 缺失视角实验仅验证推理阶段的鲁棒性,未探索训练阶段视角缺失的情况。
- 未与基于 CLIP 等文本-视觉多模态的零样本或少样本 AD 方法对比。
- 除 MVAD 外所有对比方法均在多视角设定下重新复现,复现质量可能影响对比公平性。
关联工作
- Dinomaly 是最强单视角基线,GLAD 在其重建范式基础上引入多视角融合,因此与 Dinomaly 的对比最能体现多视角融合的净增益。
- MVAD 是首个多视角 AD 方法之一,采用 patch 级交叉注意力,但缺乏全局物体级表示且内存开销大,GLAD 的 OGA 正是针对这一缺陷的改进。
- ViTAD 属于基于 DINO 特征的 ViT 特征回归方法,代表统一基础模型路线,GLAD 在表 1 中将其归为 G2 类。
- IDIF 将视图内特征解耦到共享体素空间,但类别特定设计不可扩展,GLAD 的类别无关设计更具通用性。