快速导读:本文提出CoverPruner,一种无需训练的视觉Token剪枝方法,通过最大化目标VLM投影空间中的表示覆盖(Representational Coverage Maximization, RCM)并引入指令条件需求权重,在激进压缩率下显著优于现有剪枝基线。
视觉语言模型(VLM)的推理成本随视觉Token数量二次增长,Token剪枝成为降低延迟和计算开销的关键技术。然而,现有方法大多基于局部分数或外部代理信号,未能直接在目标LLM的输入空间定义覆盖需求,导致在激进压缩下丢失关键视觉证据。本文提出CoverPruner,一种无需训练的视觉Token剪枝方法,通过最大化目标VLM投影空间中的表示覆盖(Representational Coverage Maximization, RCM)并引入指令条件需求权重,在激进压缩率下显著优于现有剪枝基线。
CoverPruner的核心贡献在于将剪枝问题从“保留哪些高重要性Token”重构为“如何最大化被丢弃Token在保留集中的覆盖”。它在Projector输出空间计算Token间余弦相似度,通过均值中心化和截断生成非负覆盖效用;利用LLM第一层注意力探针估计指令相关的Token需求权重;最后通过贪心算法选择能最大化加权总覆盖的原始Token子集。这一方法在LLaVA-1.5-7B、LLaVA-NeXT-7B、Qwen2.5-VL-7B及13B版本上,于多个基准测试不同压缩率下均展现出显著优势。
英文题目:Who Speaks for the Pruned? Visual Token Pruning as Coverage Optimization
论文出处:arXiv 每日论文精选 · arXiv:2609.03158
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有视觉Token剪枝方法主要分为三类:Token评分(如FastV)、Token合并(如ToMe)和集合级方法(如DivPrune)。这些方法大多基于局部分数或外部代理信号,未直接在目标LLM的输入空间定义覆盖需求。例如,FastV基于注意力信号进行Token评分,但在激进压缩下容易丢失小文本和背景区域等关键证据;ToMe通过合并相似Token减少冗余,但可能稀释细粒度证据;DivPrune基于多样性选择子集,但未在目标VLM投影空间定义覆盖。
这种局限性在激进压缩率下尤为明显。当保留Token数量极少时,高分Token往往集中在显著区域,而低分但关键的证据(如小文本、背景区域)被丢弃,导致模型无法准确回答依赖这些证据的问题。CoverPruner通过引入覆盖优化框架,确保每个被丢弃Token在保留集中有合适的代表,从而在激进压缩下保持更高的性能。
核心创新
- 提出RCM框架,将剪枝标准从“保留者重要性”转变为“需求覆盖”,确保每个被丢弃Token在保留集中有最佳代表。
- 设计LLM锚定的信号构建机制,在Projector输出空间定义相似度,并使用第一层注意力作为指令条件需求信号,无需外部模型或额外训练。
- 证明覆盖目标具有单调次模性(monotone submodular),支持使用标准贪心算法获得近似最优解。
方法概览
CoverPruner将剪枝重构为RCM问题。它在Projector输出空间计算Token间余弦相似度,通过均值中心化(mean-centering)和截断生成非负覆盖效用;利用LLM第一层注意力探针(first-layer attention probe)估计指令相关的Token需求权重;最后通过贪心算法选择能最大化加权总覆盖的原始Token子集。
- RCM框架:将剪枝标准从“保留者重要性”转变为“需求覆盖”,确保每个被丢弃Token在保留集中有最佳代表。
- 信号构建:在Projector输出空间计算Token间余弦相似度,通过均值中心化和截断生成非负覆盖效用。
- 需求权重:利用LLM第一层注意力探针估计指令相关的Token需求权重,无需外部模型或额外训练。
- 贪心选择:通过贪心算法选择能最大化加权总覆盖的原始Token子集,利用单调次模性保证近似最优解。
- 空间选择:在Projector输出空间定义相似度,比在Encoder空间更贴近目标LLM的输入分布。
- 温度参数:引入温度参数τ调节需求权重的锐度,平衡覆盖均匀性和指令相关性。
逐图理解论文
研究缺口
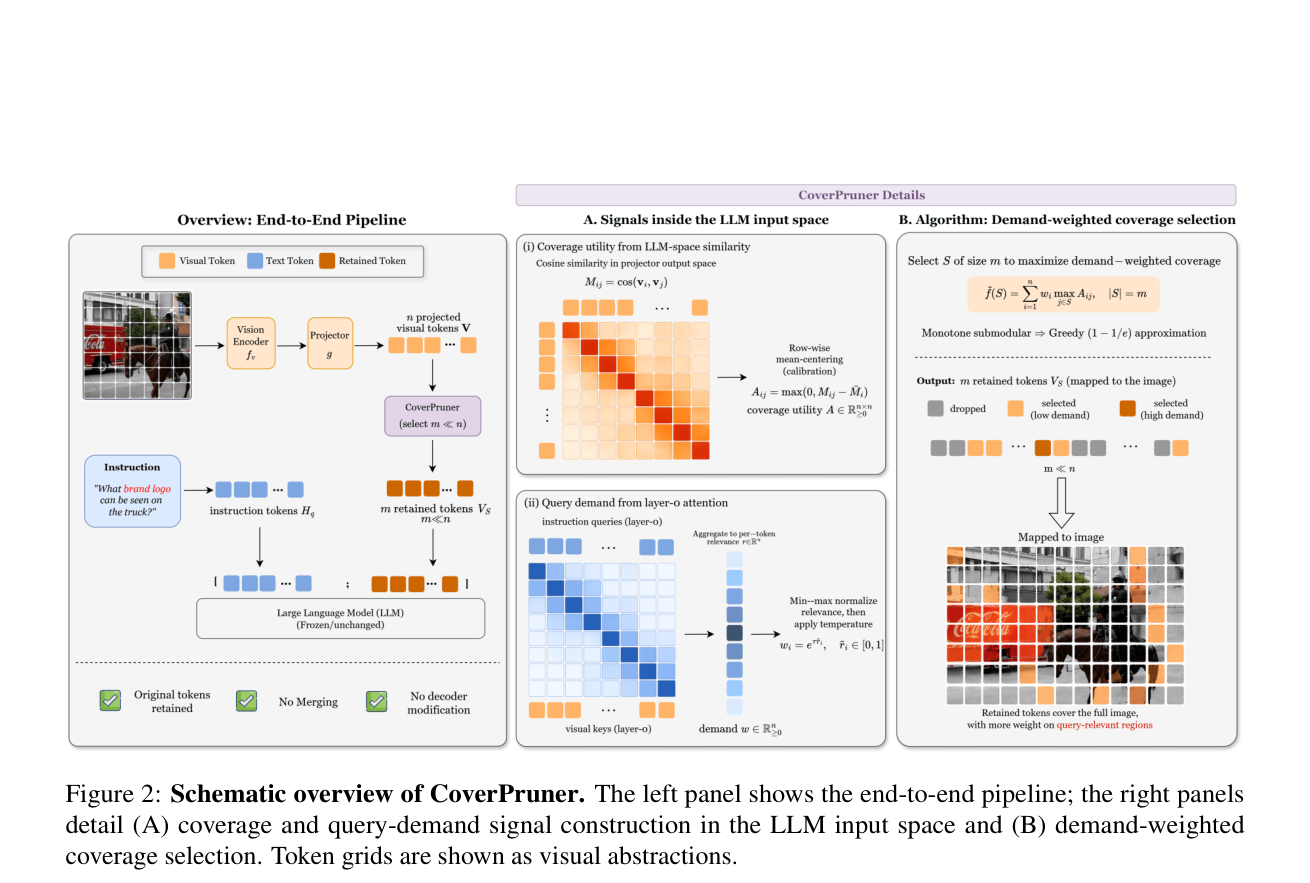
该图展示了CoverPruner的端到端流程。左图展示了整体流程,右图详细展示了信号构建和选择细节。Token网格以视觉抽象形式展示,帮助理解覆盖和查询需求信号的构建过程。
实验验证
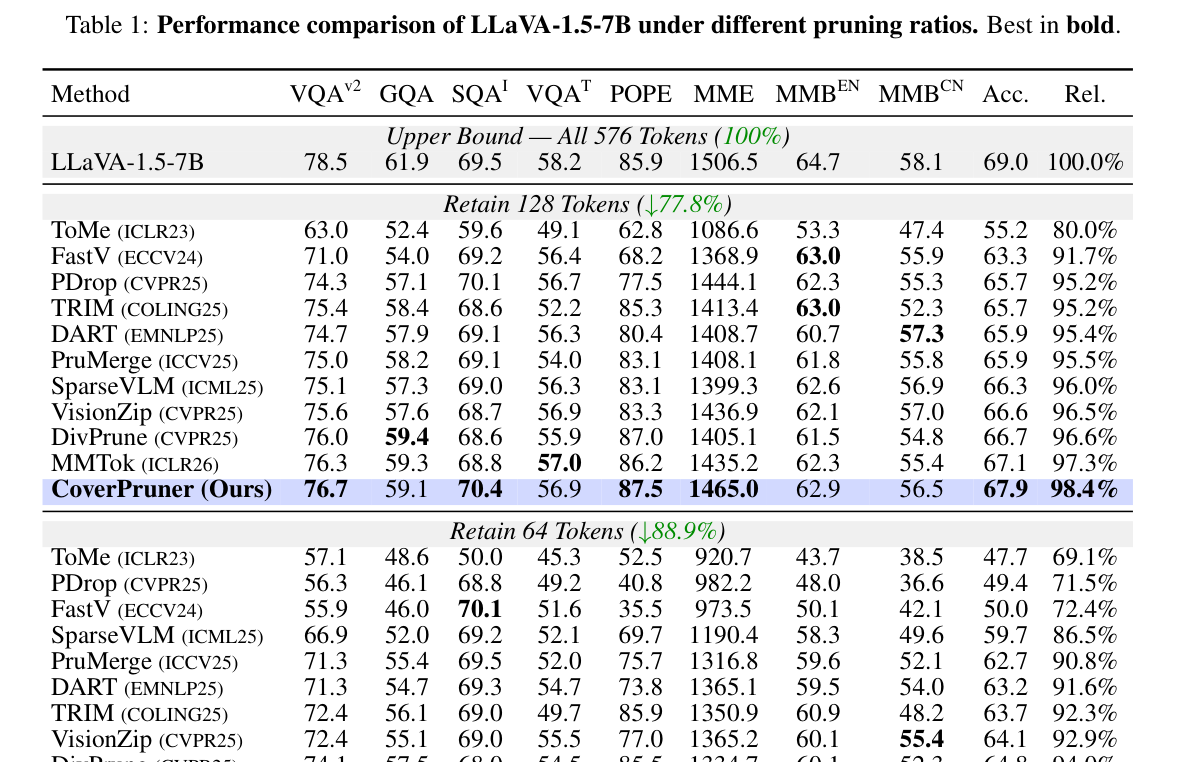
该表展示了LLaVA-1.5-7B在不同剪枝率下的性能对比。CoverPruner在多数基准和压缩率下表现最优,尤其在激进压缩下优势明显。
核心结论
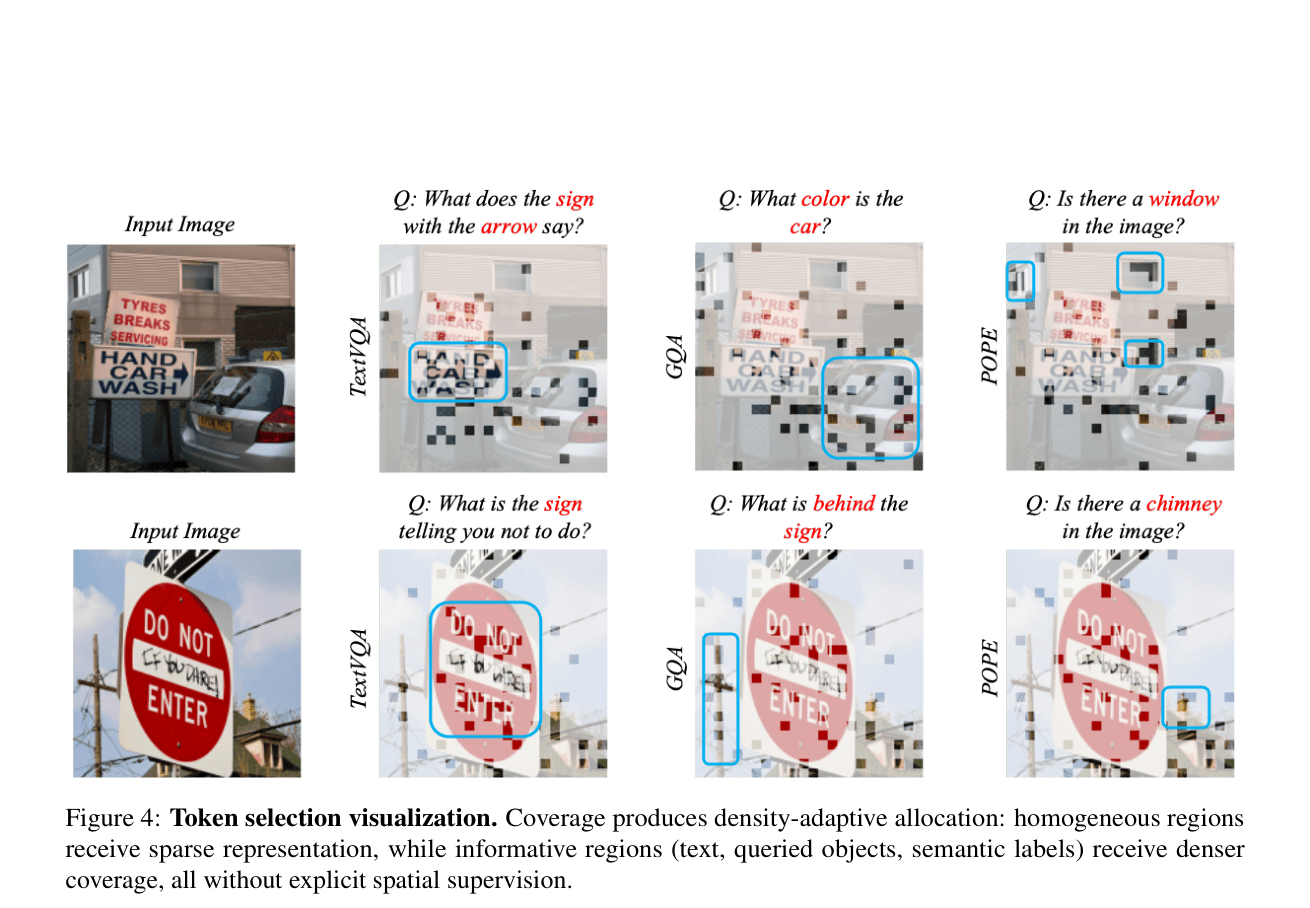
该图可视化了CoverPruner的Token选择模式。覆盖产生密度自适应分配:同质区域接收稀疏表示,信息丰富区域(文本、查询对象、语义标签)接收更密集的覆盖,无需显式空间监督。
实验如何设计?
- 模型:LLaVA-1.5-7B、LLaVA-NeXT-7B、Qwen2.5-VL-7B及13B版本。
- 基准:VQAv2, GQA, TextVQA, POPE, MME等8-10个基准。
- 压缩率:测试不同压缩率(77.8%-94.4%)下的性能。
- 消融实验:分析覆盖目标与相关性信号的作用,以及相似度空间和温度参数的影响。
- 效率分析:比较Prefill/Decode延迟和FLOPs,以及定性可视化Token选择模式。
关键结果与论文证据
- 在LLaVA-1.5-7B上,CoverPruner在保留32 tokens (94.4% pruning) 时,平均准确率64.6 (Rel. 93.7%),优于最强基线DivPrune (62.5, Rel. 90.6%)。
- 在LLaVA-NeXT-7B上,CoverPruner在保留160 tokens (94.4% pruning) 时,平均准确率67.3 (Rel. 96.6%),优于DivPrune (65.0, Rel. 93.4%)。
- 在Qwen2.5-VL-7B上,CoverPruner在保留128 tokens (90.1% pruning) 时,平均准确率59.3 (Rel. 88.0%),优于FastV (56.6, Rel. 83.9%)。
- 在POPE基准上,CoverPruner将LLaVA-NeXT-7B的Prefill延迟降低7.5倍,FLOPs降低10.7倍,同时F1分数从86.8提升至87.3。
- 消融实验显示,使用Projector输出空间相似度比Encoder空间在TextVQA上高7.3分,在POPE上高4.6分。
- 定性可视化表明,CoverPruner的Token选择模式更集中于文本区域和查询对象,避免单一显著性聚类。
阅读时需要注意
- 需要访问Projector视觉Token和早期解码器信号,限制了其在仅API闭源MLLM上的直接应用。
- 对于依赖小物体、OCR细节、精确计数或空间关系的任务,当投影Token相似度高但实际证据不可替换时,覆盖效果较弱。
- 成对相似度计算复杂度为O(n^2),在更高分辨率输入下需要更细致的工程优化。
- 图像级覆盖直接应用于视频Token可能导致对持久背景证据的过度表示和对时间稀疏事件的表示不足。
关联工作
- DivPrune:基于多样性选择子集,但未在目标VLM投影空间定义覆盖。
- MMTok:在共享编码器空间形式化多模态覆盖,CoverPruner在消费VLM输入空间定义覆盖。
- CROP:使用查询条件上下文区域定位,CoverPruner使用第一层注意力探针估计需求。
- FastV:基于注意力信号的Token评分剪枝,CoverPruner在激进压缩下显著优于其。
- ToMe:通过合并相似Token减少冗余,CoverPruner保留原始Token表示以避免稀释细粒度证据。