快速导读:FAVE 提出了一种保留原始几何结构的变分辨率 ViT 编码器,通过对外部选定的局部区域进行高清晰度自适应编码,在保持全局上下文的同时显著提升了小物体、文本和属性识别的精度与效率。
FAVE 针对视觉编码器在细粒度理解中面临的权衡问题,提出了一种自适应注视点视觉编码方法。该方法通过对外部选定的局部区域进行高清晰度编码,在保持全局上下文的同时,显著提升了小物体、文本和属性识别的精度与效率。
FAVE 的核心思想是解耦“看哪里”(空间选择)与“如何编码”(局部表征),借鉴人类主动视觉机制,将计算资源集中在关键局部区域,从而在有限计算预算下实现更精细的视觉理解。
英文题目:FAVE: Foveated Adaptive Visual Encoding for Efficient Fine-Grained Visual Understanding
论文出处:arXiv 每日论文精选 · arXiv:2609.04392
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有视觉编码器在处理细粒度任务时面临两难:全图高分辨率处理计算成本高昂,而紧凑的全局编码(如下采样)容易丢失小物体、文本等局部关键细节。
现有方法如 NaViT 处理全图变分辨率,但 FAVE 专注于对外部选定的局部区域进行自适应高清晰度编码,从而更精准地分配计算资源。
FAVE 通过保留裁剪区域的原始宽高比,对齐到 16px patch 网格,生成变长 token 序列,使用 factorized positional encoding 和 Patch-n-Pack 进行高效批处理,避免了固定分辨率带来的信息损失。
核心创新
- 提出 FAVE 编码器,保留选定区域的原始几何结构,根据区域尺度自适应调整空间分辨率和 token 数量,避免固定分辨率表示。
- 在 ImageNet 上通过 oracle 空间选择隔离编码问题,证明在相同裁剪窗口下,FAVE 比固定分辨率 ViT 具有更高的精度和更低的 FLOPs。
- 将 FAVE 集成到 FastVLM 中作为稀疏局部分支,保持全局路径和语言模型冻结,仅增加少量局部 token 即可提升细粒度理解能力。
方法概览
FAVE 包含两个主要应用:1) 自适应对象识别:保留裁剪区域的原始宽高比,对齐到 16px patch 网格,生成变长 token 序列,使用 factorized positional encoding 和 Patch-n-Pack 进行高效批处理;2) 多模态理解:作为 FastVLM 的局部补充分支,通过两阶段训练(Stage 1 联合训练 ViT 和 reducer 生成紧凑 token,Stage 2 微调 reducer 并训练 local projector 映射到 LLM 空间),将局部 token 与全局 token 拼接后输入冻结的 Qwen2。
- FAVE 编码器保留选定区域的原始几何结构,根据区域尺度自适应调整空间分辨率和 token 数量,避免固定分辨率表示。
- 在 ImageNet 上通过 oracle 空间选择隔离编码问题,证明在相同裁剪窗口下,FAVE 比固定分辨率 ViT 具有更高的精度和更低的 FLOPs。
- 将 FAVE 集成到 FastVLM 中作为稀疏局部分支,保持全局路径和语言模型冻结,仅增加少量局部 token 即可提升细粒度理解能力。
- FAVE 包含两个主要应用:1) 自适应对象识别:保留裁剪区域的原始宽高比,对齐到 16px patch 网格,生成变长 token 序列;2) 多模态理解:作为 FastVLM 的局部补充分支,通过两阶段训练将局部 token 与全局 token 拼接后输入冻结的 Qwen2。
逐图理解论文
失败案例
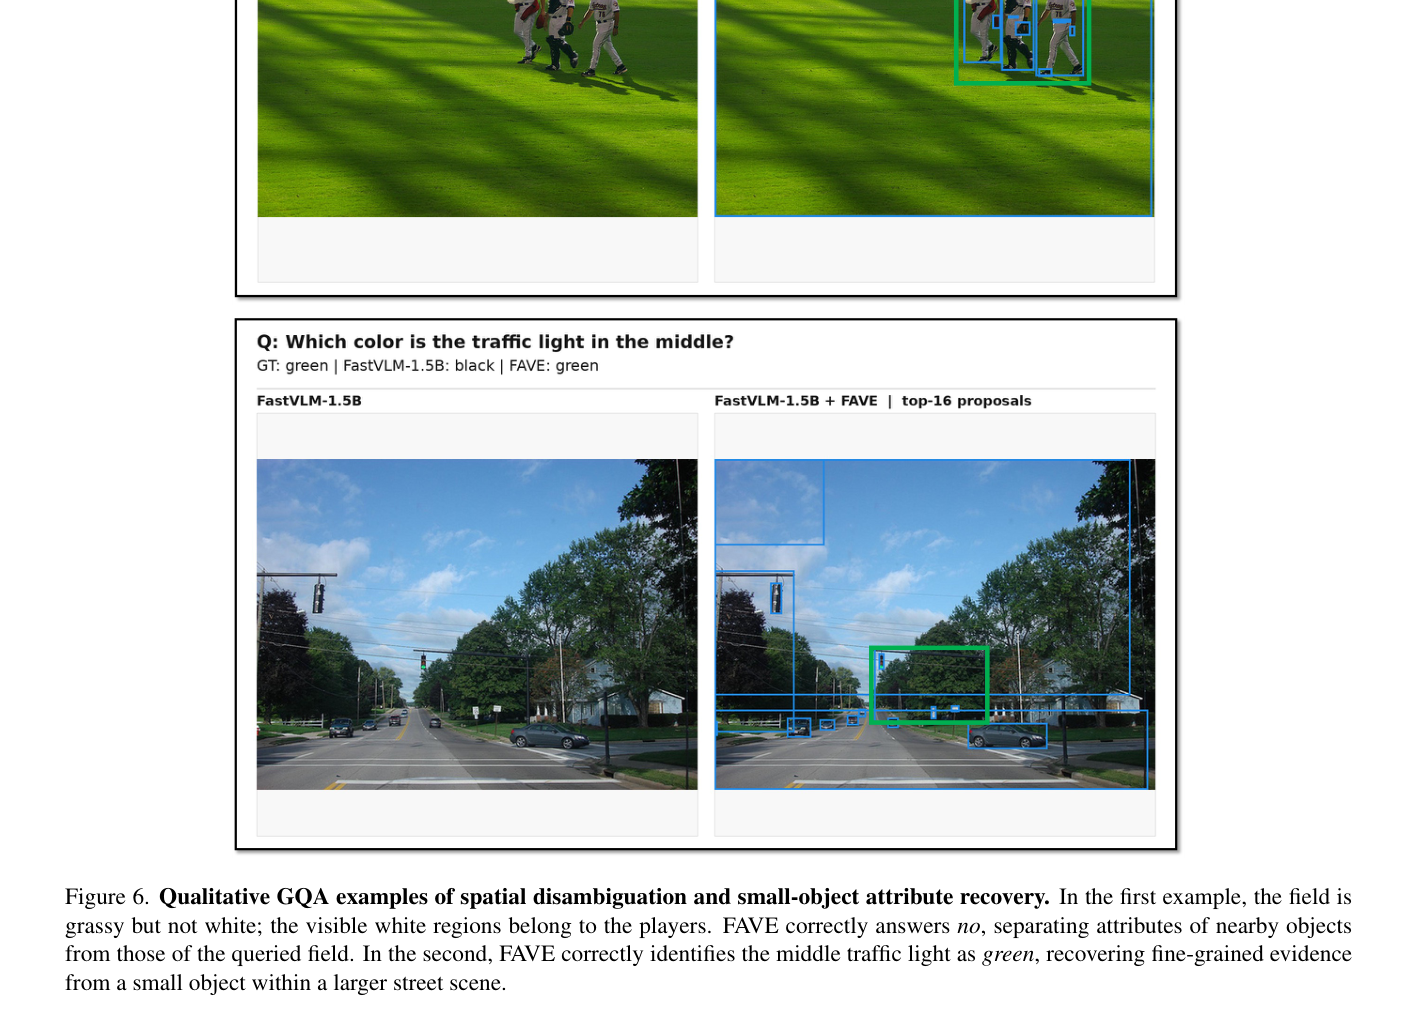
以街景中的小交通灯为例,全局下采样会丢失其颜色细节,导致模型无法区分红绿状态,而全图高分辨率处理又带来不可接受的计算开销。
核心贡献
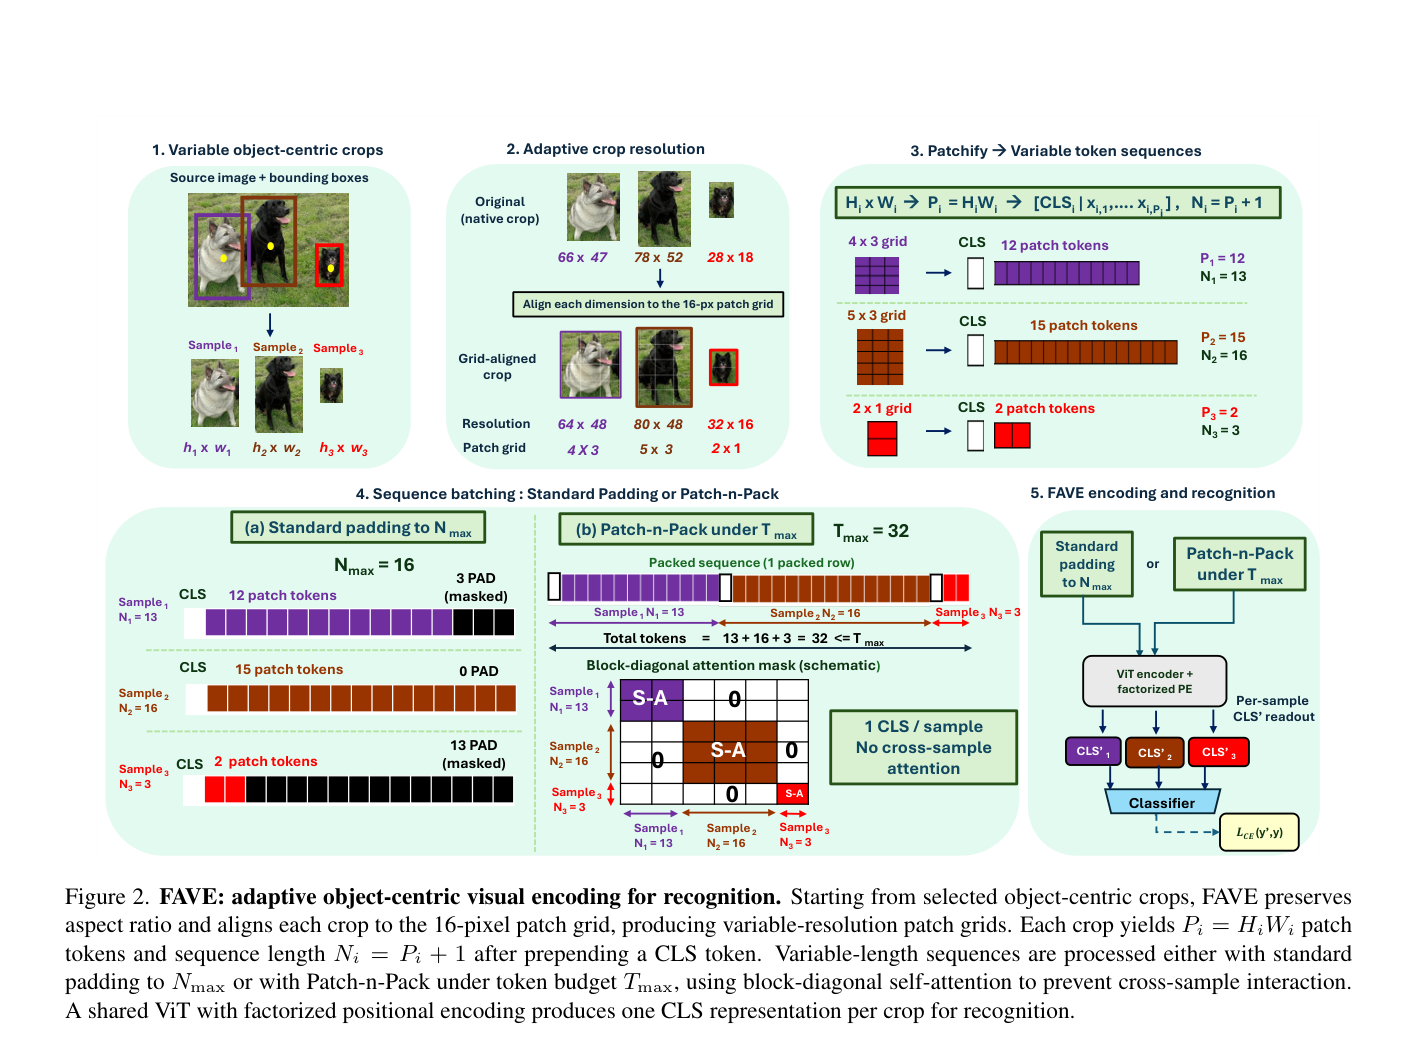
该图详细展示了 FAVE 的自适应对象中心视觉编码流程。从选定的对象中心裁剪开始,FAVE 保留宽高比并对齐到 16 像素 patch 网格,生成变分辨率 patch 网格,最终通过共享 ViT 和 factorized positional encoding 生成 CLS 表示。
最强结论
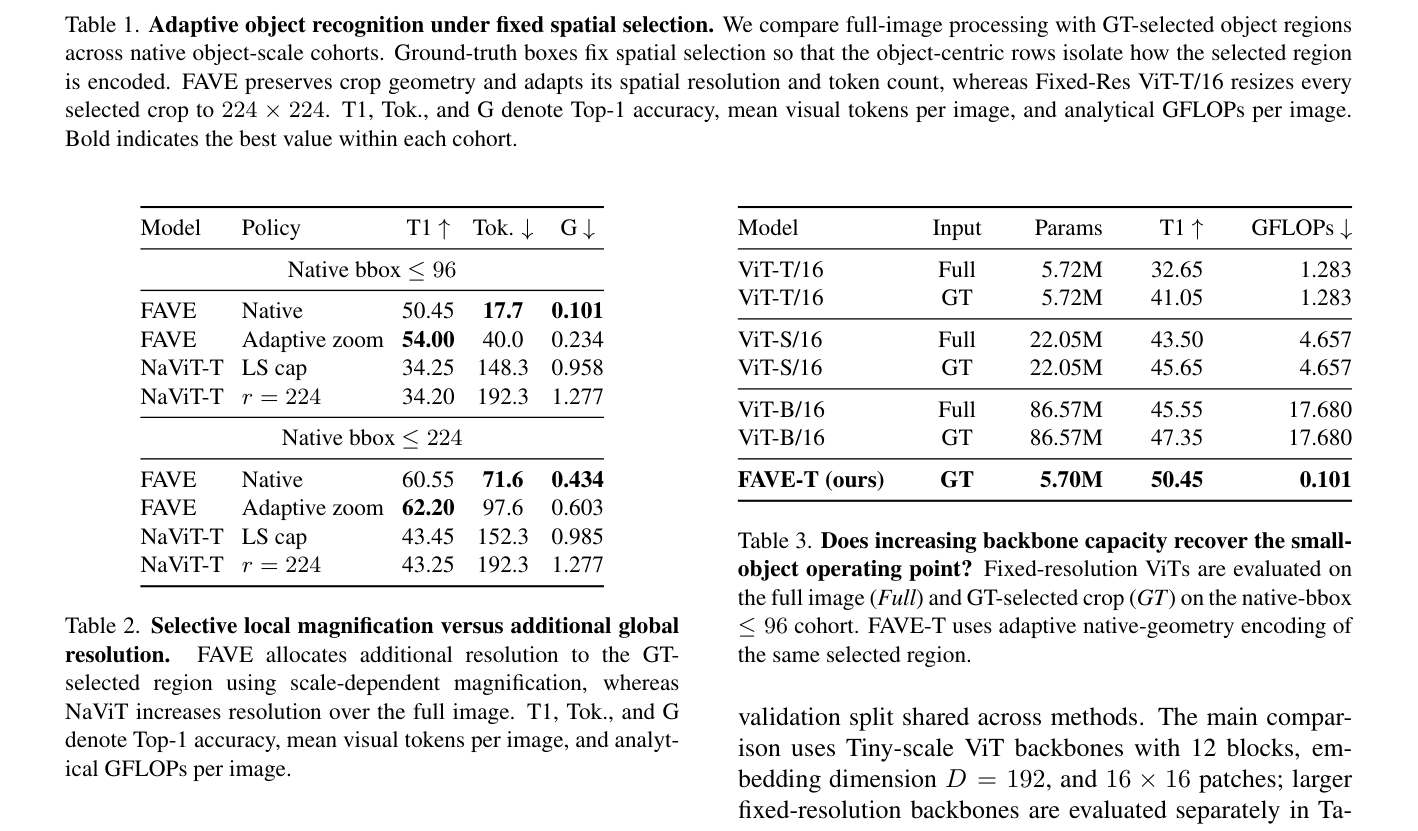
该表比较了全图处理和 GT 选定对象区域在不同原生对象尺度队列上的 Top-1 精度、平均视觉 token 数和解析 GFLOPs。FAVE 在保持裁剪几何并自适应空间分辨率和 token 数量的同时,比 Fixed-Res ViT-T/16 表现出更高的精度和更低的计算成本。
意义与局限
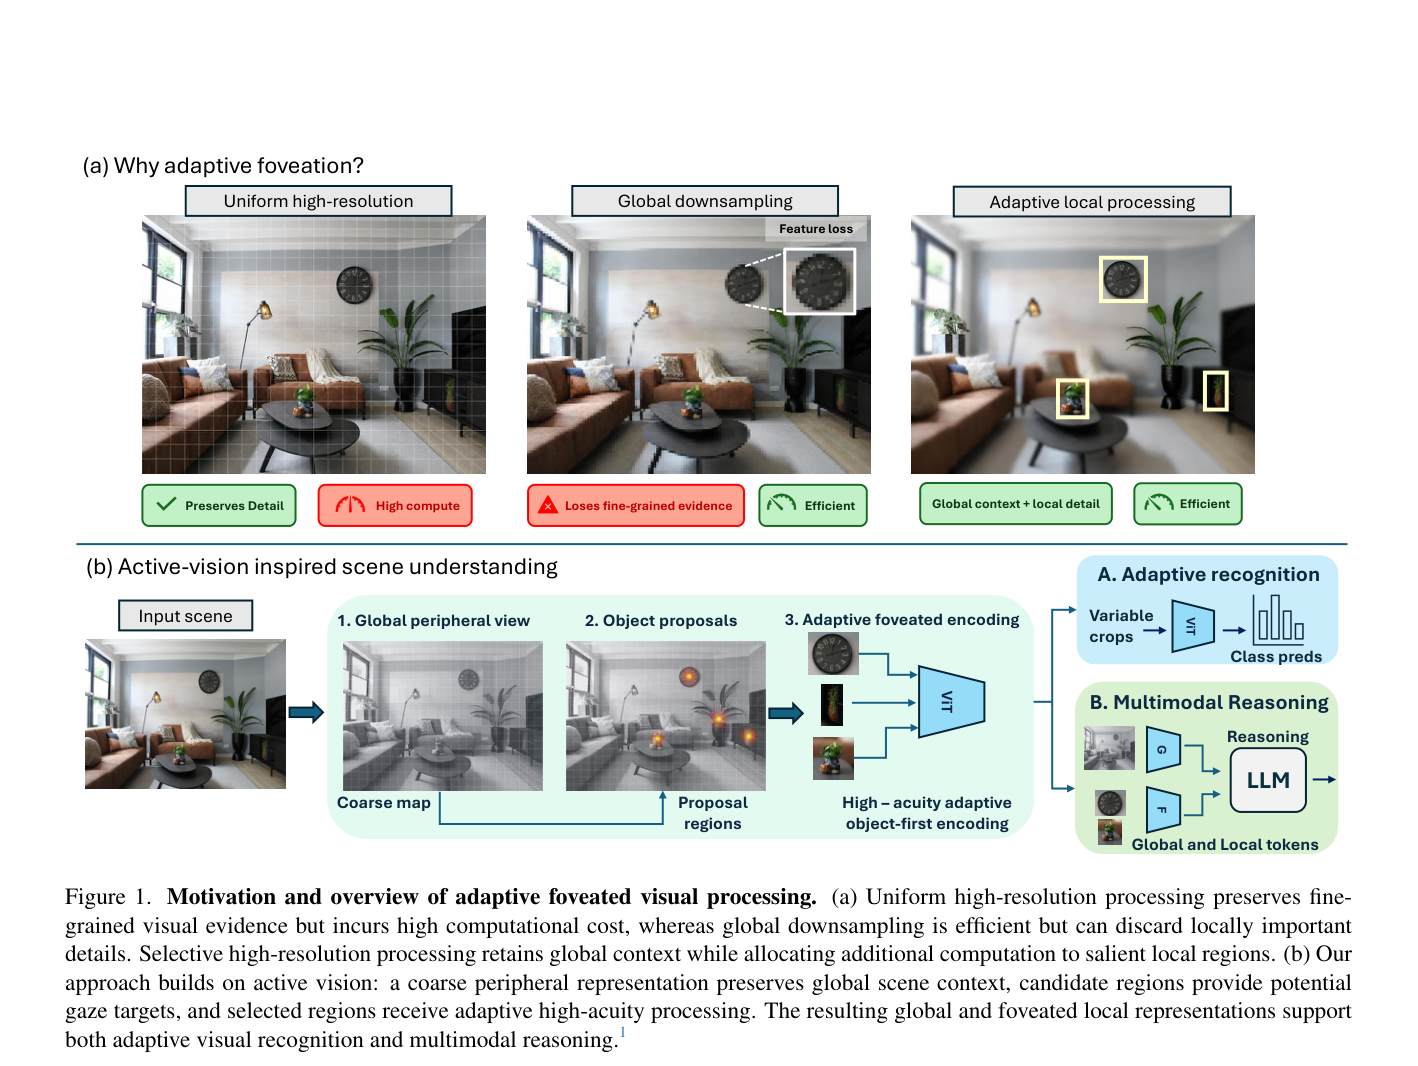
该图展示了 FAVE 的动机和整体架构。图 (a) 对比了全图高分辨率处理和全局下采样的优缺点,图 (b) 展示了 FAVE 如何通过粗粒度外围表示、候选区域和自适应高清晰度处理来实现细粒度视觉理解。
实验如何设计?
- ImageNet 对象识别:在 native bbox ≤96 像素的小物体队列上,比较 FAVE、Fixed-Res ViT、NaViT 等方法的 Top-1 精度、token 数和 GFLOPs。
- TextVQA:评估 FAVE 增强后的 FastVLM-1.5B 在文本视觉问答上的精度和推理延迟(TTFT)。
- GQA Attribute:评估 FAVE 在细粒度对象属性理解上的表现。
- OCRBench:测试 FAVE 在 OCR 相关任务上的迁移能力。
关键结果与论文证据
- 在 ImageNet 小物体队列上,FAVE 的 Top-1 精度达到 50.45%,比 Fixed-Res ViT 的 41.05% 高出 9.4 个百分点,且 FLOPs 降低 12.7 倍(第 5 页)。
- 在 TextVQA 上,FAVE 将 FastVLM-1.5B 的精度从 71.95% 提升至 73.55%,提升 1.60 个百分点(第 7 页)。
- 在 GQA Attribute 上,FAVE 将 FastVLM-1.5B 的精度从 70.73% 提升至 72.04%,提升 1.31 个百分点,匹配了 Mini-Gemini-HD-8B 的性能(第 8 页)。
- 在 OCRBench 上,FAVE 在 Scene Text VQA 任务上提升了 13.5 个百分点(第 8 页)。
- FAVE 的 TTFT 为 74.51 ms,比 SmolVLM2-2.2B 的 246.54 ms 快 3.3 倍(第 8 页)。
阅读时需要注意
- 依赖外部提议机制(如 DBNet++, YOLOE)进行空间选择,提议质量可能影响最终性能。
- 在 ImageNet 实验中使用了 ground-truth bounding boxes 作为 oracle 选择,未完全评估端到端提议误差的影响。
- 局部编码的分辨率上限(如 224px cap)是任务特定的,可能需要针对不同任务调整。
关联工作
- FAVE 借鉴了 NaViT 的变分辨率处理和 Patch-n-Pack 技术,但应用于外部选定的局部区域而非全图(第 3 页)。
- FAVE 作为 FastVLM 的局部补充分支,保持其全局路径和语言模型冻结(第 3 页)。
- FAVE 在 GQA Attribute 任务上匹配了 Mini-Gemini-HD-8B 的性能,但参数量更小(第 8 页)。
- FAVE 与 Q-Zoom 等区域自适应方法不同,FAVE 将空间选择与局部编码解耦(第 3 页)。