快速导读:本文提出了ICM-Bench,一个专门评估多模态智能体在长视频记忆中维持重复人物身份并进行跨时间关系推理能力的基准,包含839个合成片段和1217个开放式问题。
长时程多模态智能体在处理个人录像或生活相册时,需要维持对重复出现人物的稳定认知,并基于这些身份进行跨时间的关系推理。然而,现有的长视频基准主要关注事件理解或通用记忆问答,未能有效隔离评估智能体维持重复人物身份的能力。
本文提出了ICM-Bench,一个专门评估身份中心推理能力的基准。它通过合成生活相册视频序列,测试智能体在身份回忆、跨集身份检索和长期身份画像推断三个层面的表现,揭示了现有系统在身份推理上的显著缺陷。
英文题目:ICM-Bench: Person-Level Identity Reasoning in Multimodal Agents with Long-Term Memory
论文出处:arXiv 每日论文精选 · arXiv:2609.04438
原始论文:PDF / 论文页面
这篇论文解决什么问题?
现有系统通常将人物身份作为背景而非核心评估目标,导致无法区分系统是通过稳定的身份推理还是局部事件线索来回答问题。例如,在M3-Bench上,移除面部处理对整体准确率影响不大,说明现有基准未能有效隔离身份推理能力。
ICM-Bench通过主题可配置生成管线创建包含6个重复成年角色的合成生活相册视频序列。基准包含三类问题:身份回忆、跨集身份检索和长期身份画像推断。评估采用开放式问答协议,由Gemini 3 Flash作为语义等价性裁判。
通过诊断性评估,ICM-Bench分离了事件级记忆与累积的身份画像推断,并证明仅转录文本记忆是不够的。例如,ASR-only控制组在Gemini 3.5 Flash上的准确率从73.4%降至38.7%,表明许多问题需要分布在视频时间线上的视觉证据。
核心创新
- 首个专门评估长视频记忆中身份中心推理能力的基准ICM-Bench。
- 开发了可复用的主题条件生成管线,能够构建身份一致的视听记忆和基于证据的开放式QA。
- 通过诊断性评估分离了事件级记忆与累积的身份画像推断,并证明仅转录文本记忆是不够的。
方法概览
ICM-Bench使用主题可配置的生成管线(theme-configurable generation pipeline)创建包含6个重复成年角色的合成生活相册视频序列。基准包含三类问题:身份回忆(Identity Recall)、跨集身份检索(Cross-Episode Identity Retrieval)和长期身份画像推断(Long-Term Identity Profile Inference)。评估采用开放式问答协议,由Gemini 3 Flash作为语义等价性裁判。
- 主题可配置生成管线:从系列级主题预设扩展为规划元数据、可复用视听锚点、渲染视频和对话、质量控制及基准文件。
- 身份一致的视听记忆:通过面部、声音、姓名、物体、事件和社会关系等多模态线索,确保重复出现的人物身份在时间线上保持一致。
- 开放式问答协议:采用开放式问答而非选择题,由Gemini 3 Flash作为语义等价性裁判,评估答案的语义正确性。
- 三类问题设计:身份回忆测试局部记忆,跨集身份检索测试跨时间证据连接,长期身份画像推断测试累积的身份画像构建。
- 诊断性评估:通过移除面部处理或面部-声音等价链接,验证现有系统是否依赖身份推理还是局部事件线索。
- ASR-only控制组:仅使用ASR转录文本,验证视觉证据在身份推理中的必要性。
- 记忆增强智能体比较:比较直接字幕记忆基线、记忆增强智能体(如Vgent, M3-Agent)、图检索系统(HippoRAG2)的表现。
- 开源模型性能分析:分析不同模型在Recall, Retrieval, Profile三类问题上的表现差异,特别是开源模型在Profile问题上的显著下降。
逐图理解论文
现有基准的缺陷
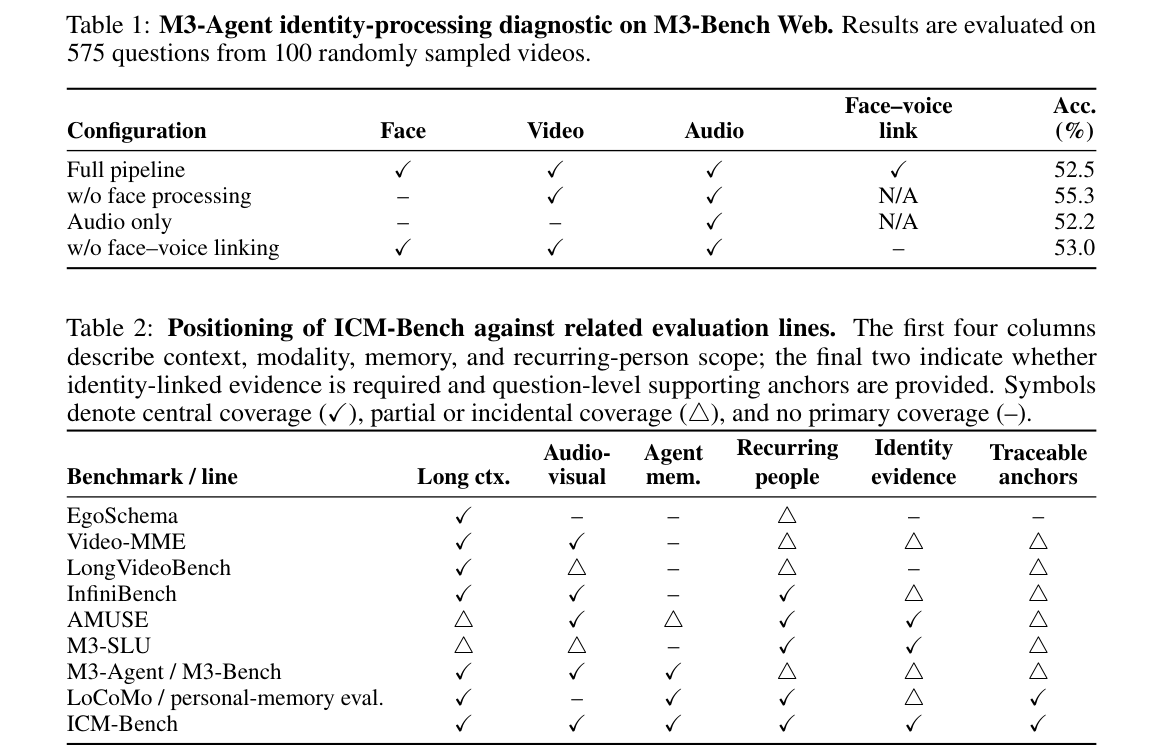
现有长视频基准主要关注事件理解,未能隔离评估身份推理能力。例如,移除面部处理对M3-Agent准确率影响不大,说明系统依赖局部事件线索而非稳定身份。
ICM-Bench的贡献
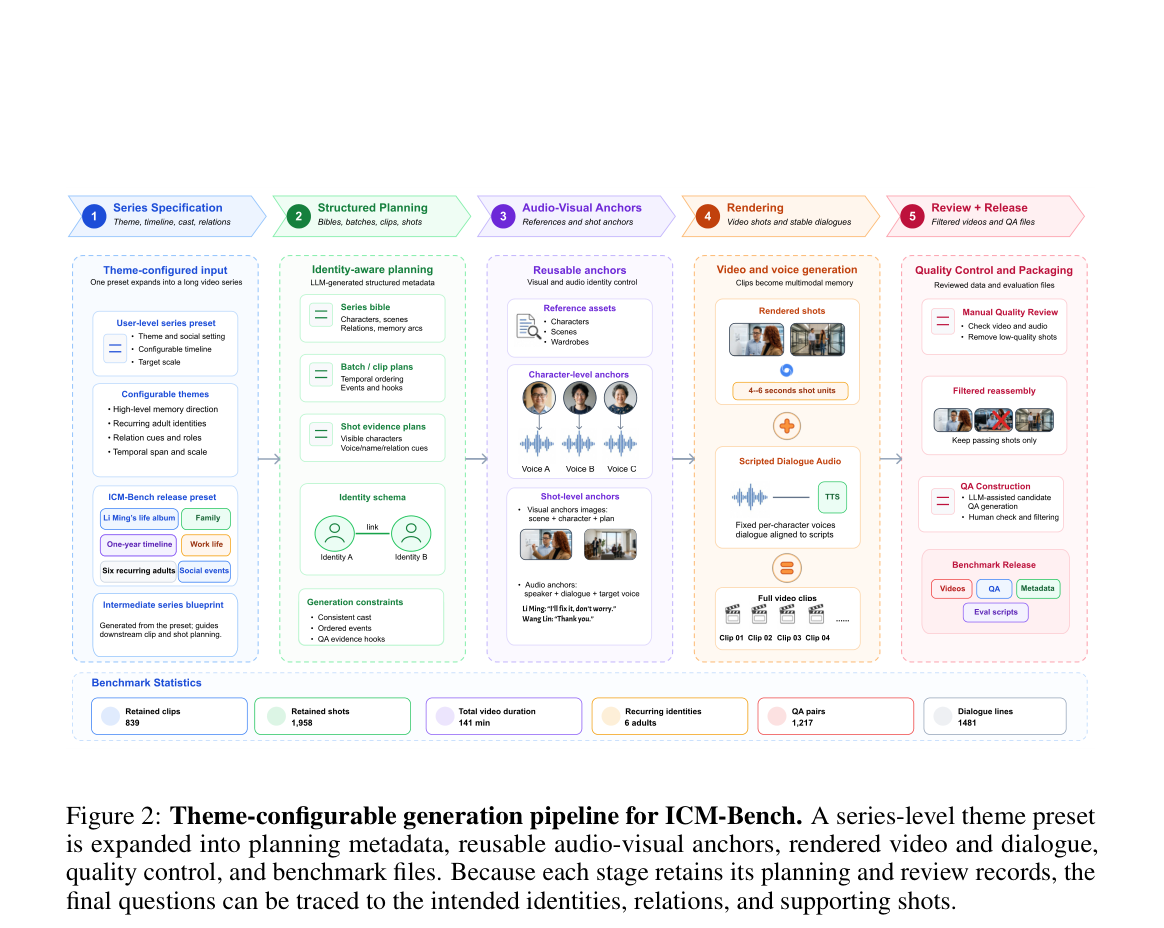
该图展示了ICM-Bench的主题可配置生成管线,从主题预设到规划元数据、视听锚点、渲染视频和对话、质量控制及基准文件的全过程。
关键发现
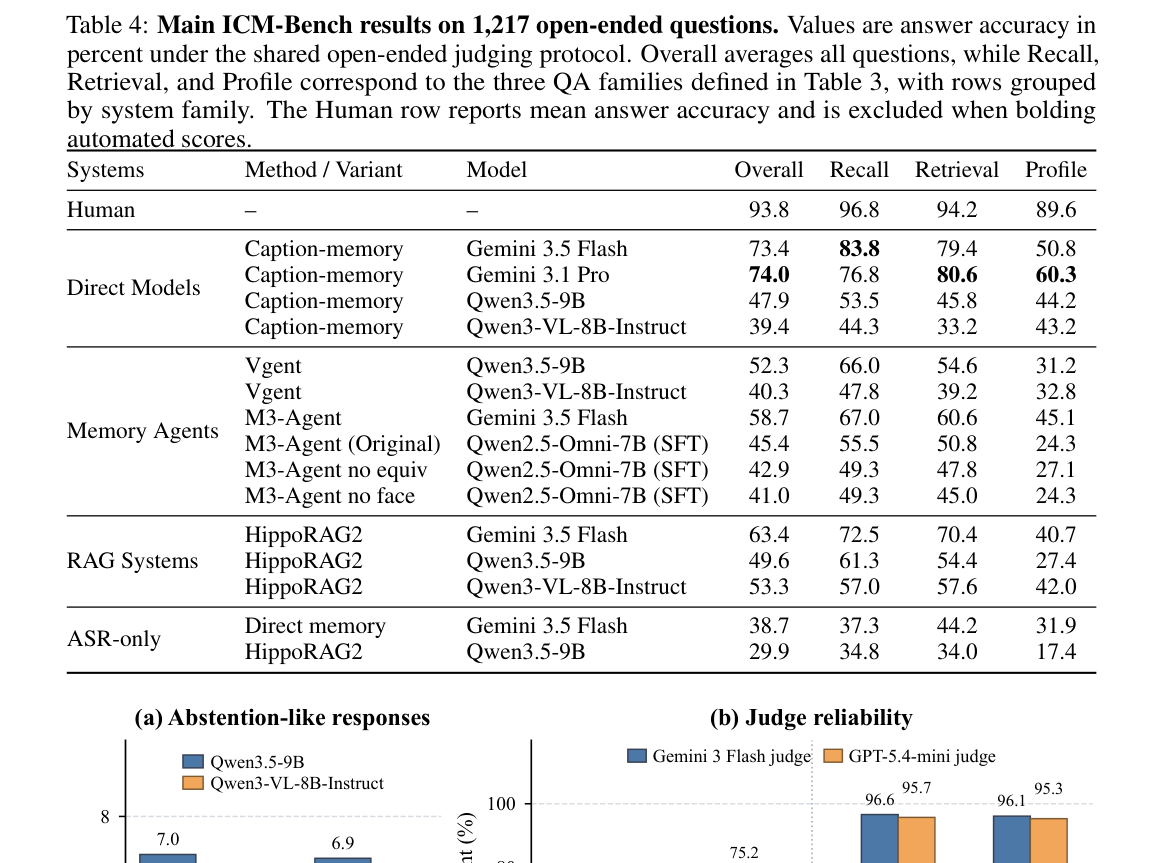
该表展示了ICM-Bench的主要结果,包括不同系统在Overall, Recall, Retrieval, Profile四类问题上的准确率。人类准确率作为参考,自动化系统得分加粗。
Figure 3: Response behavior and judge reliability
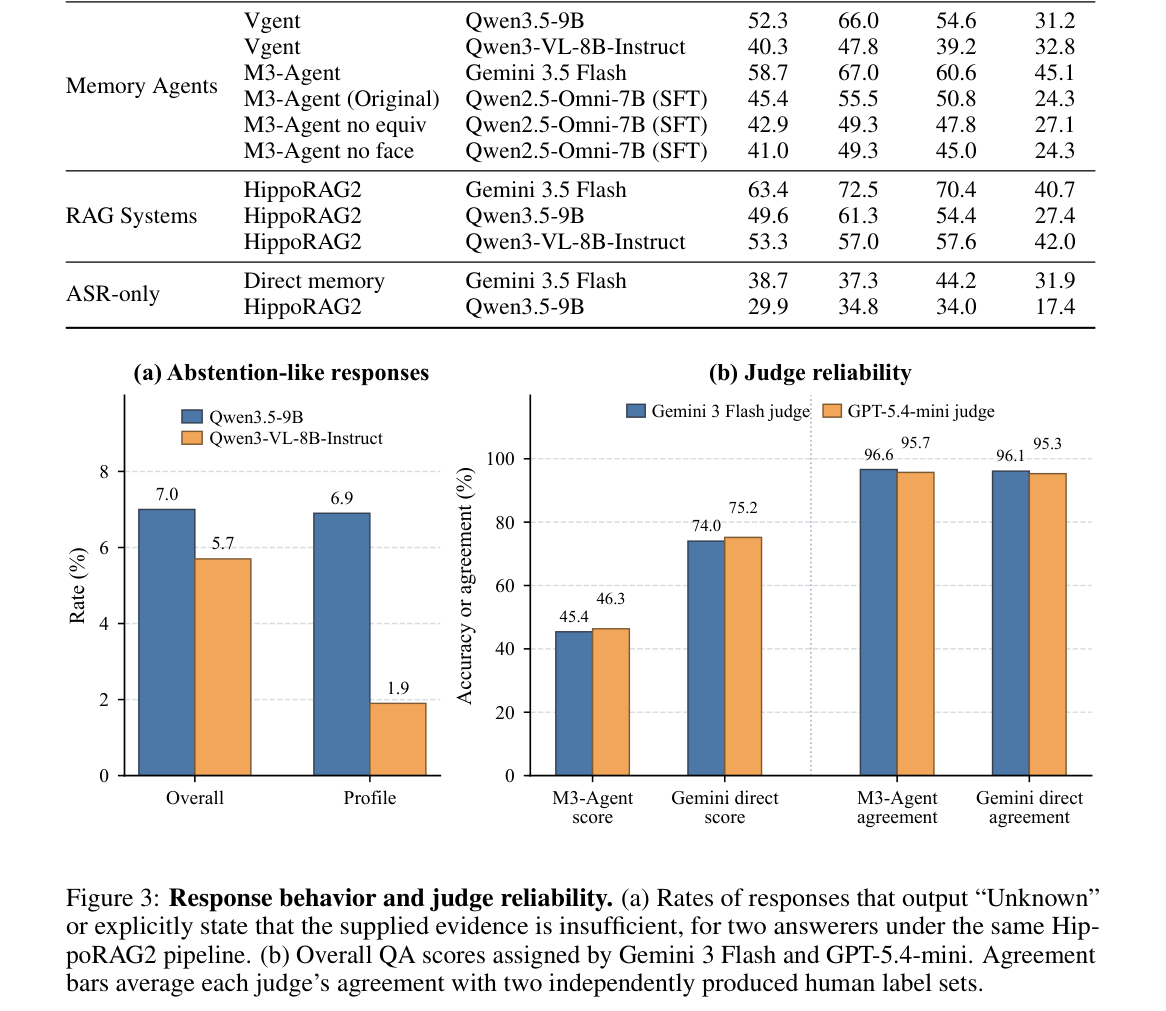
Figure 3: Response behavior and judge reliability. (a) Rates of responses that output “Unknown” or explicitly state that the supplied evidence is insufficient, for two answerers under the same Hip- poRAG2 pipeline. (b) Overall QA scores assigned by Gemini 3 Flash and GPT-5.4-mini. Agreement bars average each judge’s agreement with two independently produced human label sets.
Figure 1: Three identity-centric memory challenges in ICM-Bench
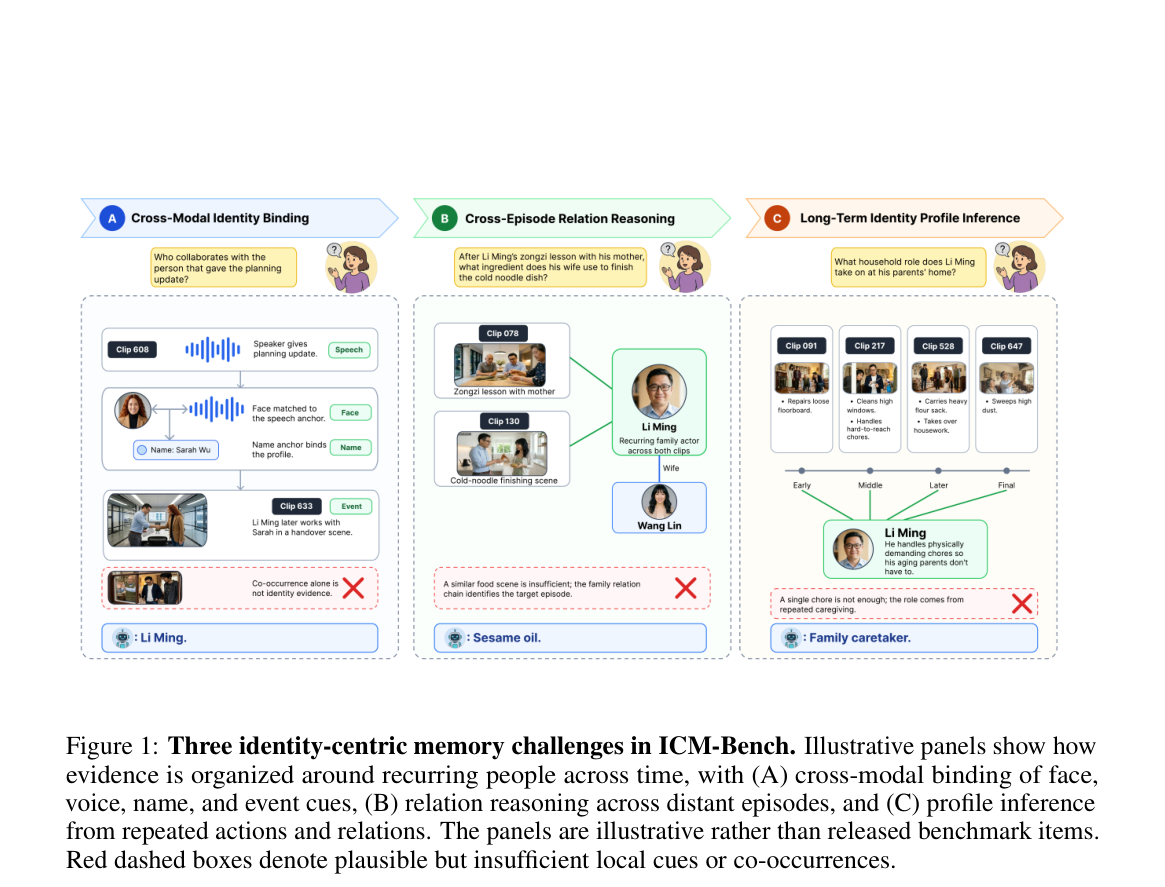
该图展示了ICM-Bench中三种身份中心记忆挑战:跨模态绑定、跨集关系推理和画像推断。红色虚线框表示局部线索或共现,但不足以支持身份推理。
实验如何设计?
- 在M3-Bench Web子集上对M3-Agent进行身份处理诊断,验证移除面部处理或面部-声音等价链接对整体准确率影响不大。
- 在ICM-Bench上比较直接字幕记忆基线、记忆增强智能体(如Vgent, M3-Agent)、图检索系统(HippoRAG2)以及仅ASR转录控制组。
- 分析不同模型在Recall, Retrieval, Profile三类问题上的表现差异,特别是开源模型在Profile问题上的显著下降。
- 使用Gemini 3 Flash作为语义等价性裁判,评估开放式问答的语义正确性。
- 通过ASR-only控制组验证视觉证据在身份推理中的必要性。
- 比较不同记忆框架(如Vgent, HippoRAG2)在身份推理中的表现,揭示记忆压缩或重构对Profile推断的影响。
关键结果与论文证据
- Gemini 3.1 Pro在ICM-Bench上取得74.0%的整体准确率,但在Profile问题上仅为60.3%,表明长期身份画像推断仍是挑战。
- 人类准确率在ICM-Bench上达到93.8%,其中Recall为96.8%,Retrieval为94.2%,Profile为89.6%,表明任务设计合理且可解。
- 移除面部处理在M3-Agent上使准确率从52.5%升至55.3%,证明现有基准未能有效隔离身份推理能力。
- ASR-only控制组使Gemini 3.5 Flash的整体准确率从73.4%降至38.7%,表明许多问题需要分布在视频时间线上的视觉证据。
- Qwen3.5-9B在Profile问题上的准确率从44.2%(直接)降至31.2%(Vgent)和27.4%(HippoRAG2),表明记忆框架可能削弱Profile推断。
- 开源模型在Profile问题上的显著下降,表明累积的身份画像推断需要更强的长上下文处理能力。
- 记忆框架可能提高事件检索但削弱Profile推断,因为压缩或重构记忆不一定能改善强长上下文模型的答案准确率。
- 仅ASR转录控制组表现较差,表明许多问题需要分布在视频时间线上的视觉证据。
阅读时需要注意
- 使用合成视听内容,可能包含视觉伪影、不完美运动、跨镜头不一致或不自然对话。
- 缺乏真实视频中的挑战,如遮挡、相机运动、光照变化、背景噪声和重叠语音。
- 结果应视为受控诊断,而非对不受约束的个人录像迁移能力的证据。
- 基准中的问题依赖于重复人物和跨时间关系,因此性能对系统如何使用人员关联证据非常敏感。
- 记忆框架可能提高事件检索但削弱Profile推断,因为压缩或重构记忆不一定能改善强长上下文模型的答案准确率。
关联工作
- M3-Agent:用于诊断身份处理机制的基线系统,其面部-声音等价链接在ICM-Bench中显示出影响。
- HippoRAG2:图检索系统,在ICM-Bench中用于评估检索增强生成在身份推理中的表现。
- Vgent:基于图的检索推理增强生成系统,用于长视频理解,在ICM-Bench中作为记忆智能体基线。
- EgoSchema, Video-MME, LongVideoBench, InfiniBench:现有的长视频QA基准,主要评估时间理解和多模态推理,但未隔离身份中心推理。
- AMUSE, M3-SLU:评估身份接地能力(如说话人关联、重识别)的基准,但关注有限片段内的身份归属,而非长时程持久记忆。