快速导读:本文通过实证分析指出长尾学习中专家多样性与集成精度无正相关,提出VICAL框架,利用Self-Consistency Learning和Deep Ensemble Distillation在解耦的频率域中降低预测方差,从而提升长尾识别性能。
长尾视觉识别中的多专家模型通常假设增加专家多样性可以提升集成精度,但这一假设缺乏系统性验证。VICAL通过实证分析指出,强制专家多样性不仅无法提升集成精度,反而可能损害个体专家的性能。
本文提出VICAL框架,利用Self-Consistency Learning和Deep Ensemble Distillation在解耦的频率域中降低预测方差。通过频率解耦机制,VICAL在保持专家一致性的同时,显著提升了长尾识别的鲁棒性。
英文题目:VICAL: Vicinal Consistency Alignment for Long-Tailed Visual Recognition
论文出处:arXiv 每日论文精选 · arXiv:2609.04948
原始论文:PDF / 论文页面
这篇论文解决什么问题?
长尾分布数据导致模型偏向头部类,多专家模型成为主流范式。现有方法通常通过Logit Adjustment或显式正则化强制专家多样性,以降低不确定性。
然而,集成误差分解表明多样性是偏差-方差分解中的纠缠维度,而非独立变量。强制多样性可能导致个体专家性能下降,进而影响整体集成精度。
本文通过实证分析指出,专家多样性与集成精度无正相关,甚至呈负相关。这一发现挑战了现有长尾学习的基本假设,为多专家模型的设计提供了新的视角。
VICAL框架旨在解决这一问题,通过频率解耦机制,在不强制专家分歧的前提下,降低预测方差,提升长尾识别性能。
核心创新
- 实证反驳了‘专家多样性直接提升集成精度’的假设,揭示强制多样性可能损害个体专家质量。
- 提出VICAL框架,将重点从显式多样性约束转向隐式方差降低。
- 设计频率解耦机制:SC处理局部高频扰动,DED处理全局低频语义对齐,避免优化冲突。
- 引入Conflicting Knowledge Filter (CKF),防止教师模型的不确定共识覆盖学生模型的正确知识。
方法概览
VICAL框架包含两个核心组件:1. Self-Consistency (SC) Learning:通过插值强增强视图构建局部邻域,惩罚对不稳定高频模式的依赖,平滑尾部类的损失景观;2. Deep Ensemble Distillation (DED):利用低分辨率视图进行跨专家对齐,限制在低频语义一致性上,避免与SC目标产生优化冲突,并通过Conflicting Knowledge Filter (CKF)过滤冲突知识。
- Self-Consistency (SC) Learning:通过插值强增强视图构建局部邻域,惩罚对不稳定高频模式的依赖,平滑尾部类的损失景观。
- Deep Ensemble Distillation (DED):利用低分辨率视图进行跨专家对齐,限制在低频语义一致性上,避免与SC目标产生优化冲突。
- Conflicting Knowledge Filter (CKF):过滤教师模型的不确定共识,防止覆盖学生模型的正确知识。
- 频率解耦机制:SC处理局部高频扰动,DED处理全局低频语义对齐,避免优化冲突。
- 低分辨率视图:DED使用低分辨率视图,限制在低频语义一致性上,避免与SC目标产生优化冲突。
- CKF过滤机制:CKF过滤教师模型的不确定共识,防止覆盖学生模型的正确知识。
- 损失景观平滑:SC通过惩罚高频模式依赖,平滑尾部类的损失景观,提升鲁棒性。
- 跨专家对齐:DED通过低分辨率视图进行跨专家对齐,保持专家一致性,降低预测方差。
逐图理解论文
反直觉发现
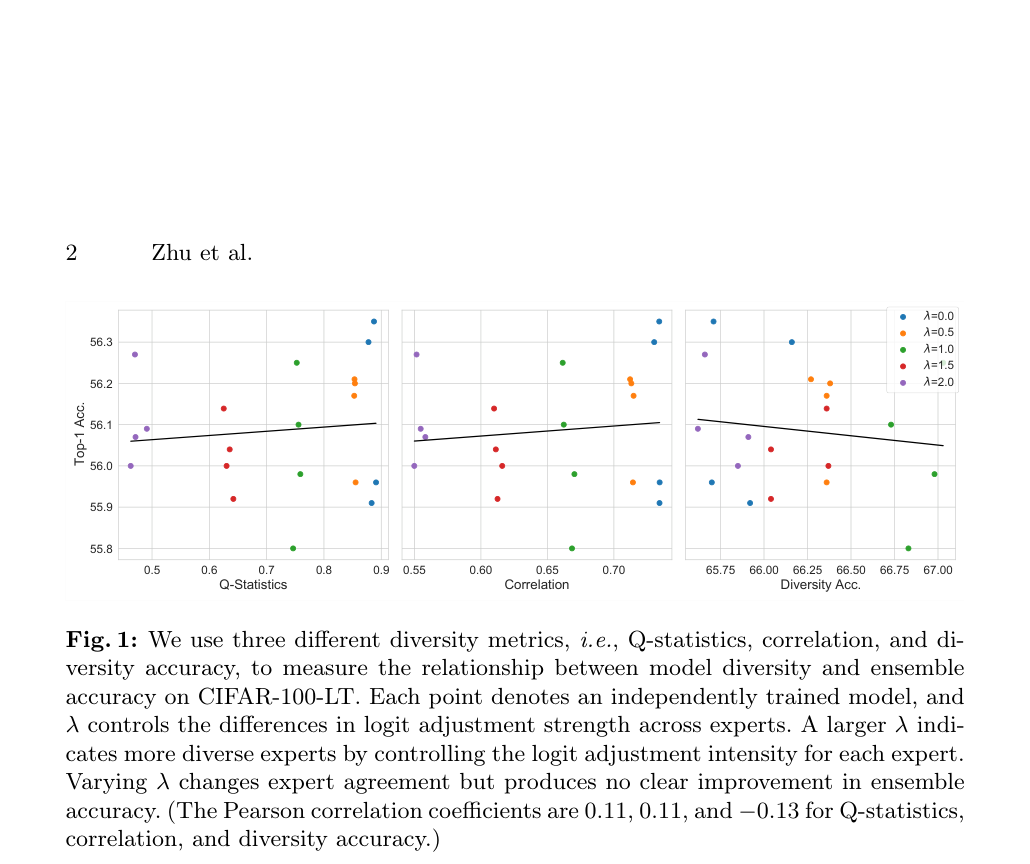
该图展示了三种多样性指标与集成精度的关系。观察各散点分布,可见多样性指标与集成精度无正相关,甚至呈负相关。这直接支持了本文的核心论点:强制专家多样性无法提升集成精度。
VICAL框架
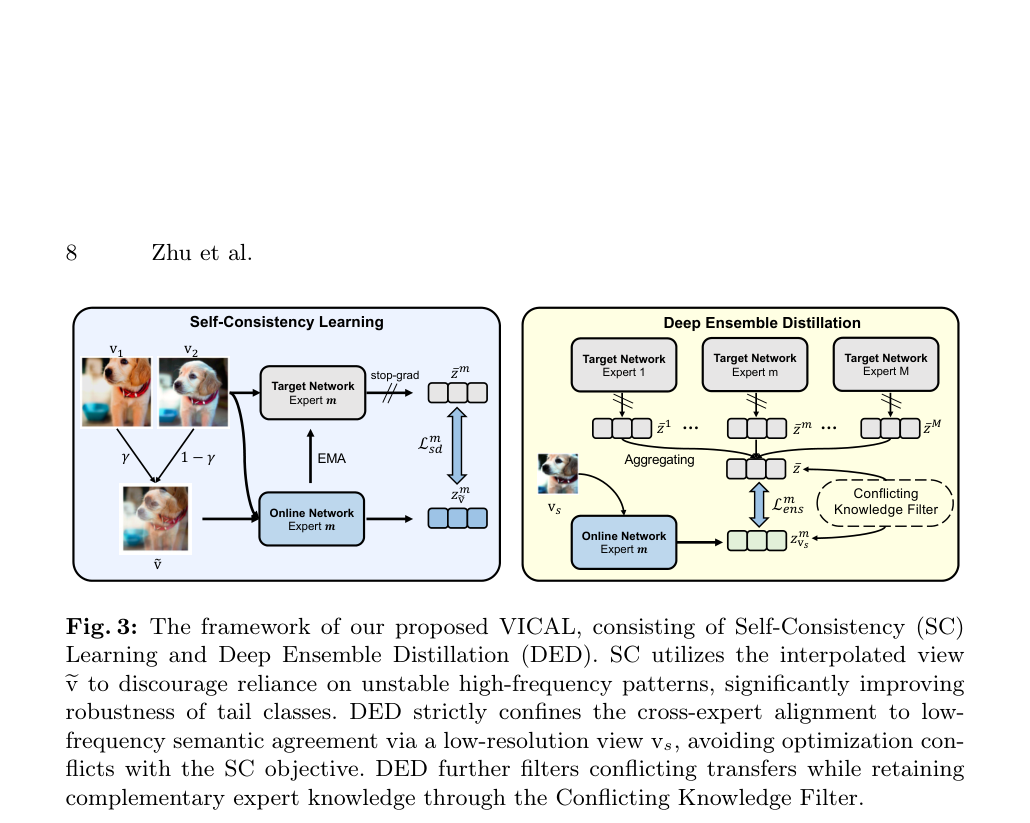
该图展示了VICAL框架的整体结构。重点观察SC和DED模块的连接方式,理解频率解耦机制如何实现。SC处理高频扰动,DED处理低频语义对齐,两者通过CKF过滤冲突知识。
最强结论
该表展示了VICAL在CIFAR-LT和ImageNet-LT上的Top-1准确率。对比VICAL与基线方法,可见VICAL在多个数据集上均取得最优性能,验证了框架的有效性。
Fig
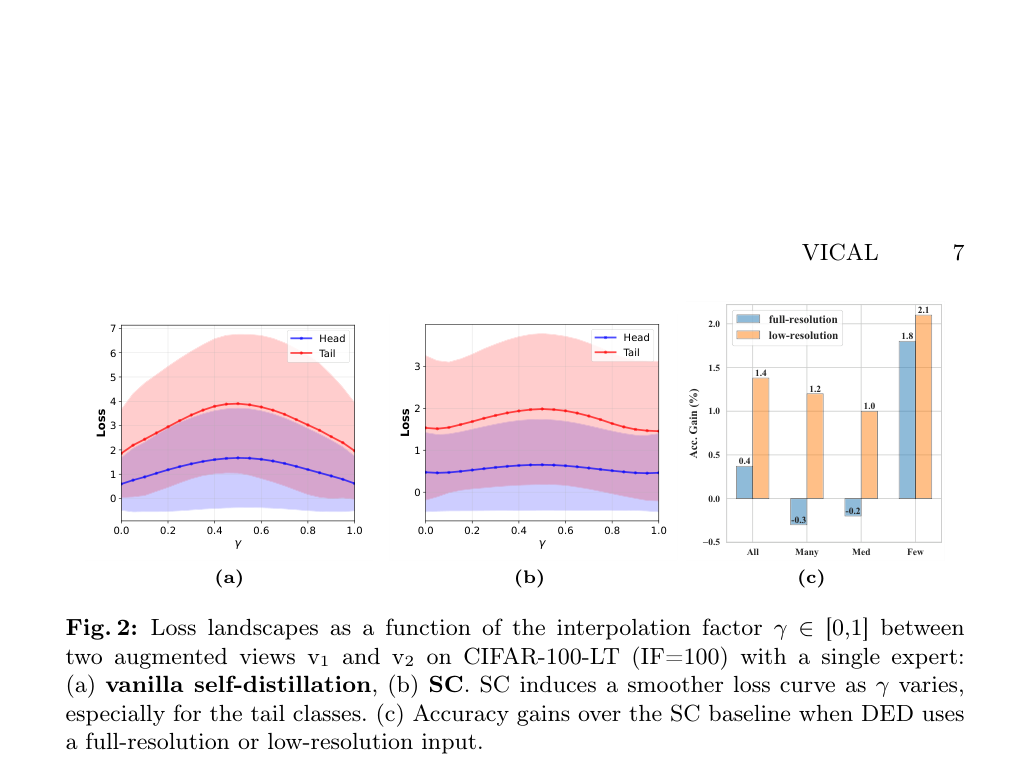
Fig. 2: Loss landscapes as a function of the interpolation factor γ ∈[0,1] between two augmented views v1 and v2 on CIFAR-100-LT (IF=100) with a single expert: (a) vanilla self-distillation, (b) SC. SC induces a smoother loss curve as γ varies, especially for the tail classes. (c) Accuracy gains over the SC baseline when DED uses a full-resolution or low-resolution input.
实验如何设计?
- 在CIFAR-10-LT, CIFAR-100-LT, ImageNet-LT, iNaturalist 2018上进行Top-1准确率评估。
- 消融实验验证SC, DED, CKF各组件的贡献。
- 频率分析:通过Fourier basis noise测试模型对高低频扰动的敏感性。
- 偏差-方差分析:比较不同方法在CIFAR-100-LT上的Bias和Variance。
- 计算成本对比:在等效FLOPs下与MDCS, NCL++比较性能。
- 多样性指标分析:使用Q-statistics, correlation, diversity accuracy衡量专家多样性与集成精度的关系。
关键结果与论文证据
- CIFAR-100-LT (IF=100) Top-1 Acc: 59.7% (Ours) vs 56.3% (NCL++) (Page 9)。
- ImageNet-LT Top-1 Acc: 62.9% (Ours) vs 61.7% (ECL) (Page 9)。
- iNaturalist 2018 Top-1 Acc: 77.5% (Ours) vs 75.9% (ICL) (Page 10)。
- CIFAR-100-LT Variance: 0.33 (Ours) vs 0.37 (MDCS†) (Page 13)。
- Pearson correlation between Q-statistics and Ensemble Accuracy: 0.11 (Logit Adj), 0.76 (Explicit Reg) (Page 2)。
- SC显著平滑尾部类的损失景观,提升鲁棒性 (Page 7)。
- DED通过低分辨率视图限制在低频语义一致性上,避免优化冲突 (Page 8)。
- CKF有效过滤冲突知识,提升集成精度 (Page 12)。
阅读时需要注意
- 多专家架构和邻域视图增加了训练时间,尽管推理成本与单模型相当。
- 一致性学习与长尾设置下方差降低之间的精确理论关系尚需进一步形式化分析。
- 在Head类中,VICAL对极端高频噪声的敏感性略有增加,这是以牺牲部分高频鲁棒性换取低频鲁棒性的权衡。
关联工作
- RIDE使用显式多样性正则化强制专家分歧,本文证明其可能损害性能 (Page 4)。
- BalPoE使用不同强度的Logit Adjustment实现专家专业化,本文指出其多样性假设未经验证 (Page 4)。
- NCL++使用全分辨率视图进行蒸馏,本文提出低分辨率视图以避免优化冲突 (Page 4)。
- FixMatch是半监督学习中的一致性学习基础,VICAL借鉴其思想但应用于长尾识别的频率解耦场景 (Page 4)。