快速导读:WorldSculpt 通过扩展 Pixal3D 生成先验以支持多视角条件输入,实现了从密集遮挡场景中生成数百个独立物体网格的组合式 3D 场景重建,并提出了包含精确逐物体真值的 UE-MeshyScene 基准数据集。
WorldSculpt 旨在解决从密集遮挡的复杂场景中生成可编辑组合式 3D 表示的难题。现有几何重建方法通常输出单一融合网格且遮挡区域缺失,而生成式先验多局限于单物体或简单场景,无法在已知世界坐标系中联合处理多视角观测以恢复完整几何。
该工作通过扩展 Pixal3D 生成先验以支持多视角条件输入,实现了从密集遮挡场景中生成数百个独立物体网格的组合式 3D 场景重建。其核心贡献在于将单物体生成能力泛化至复杂场景,无需场景级训练,并提出了包含精确逐物体真值的 UE-MeshyScene 基准数据集。
英文题目:WorldSculpt: Generating Compositional Worlds from Grounded Videos
论文出处:arXiv 每日论文精选 · arXiv:2609.05416
原始论文:PDF / 论文页面
这篇论文解决什么问题?
下游应用如游戏、AR/VR 和机器人需要场景分解为独立可操作的物体网格。现有生成式世界模型如 Marble 输出统一表示,无法分离物体;单物体生成模型如 Pixal3D 缺乏多视角一致性和世界坐标定位能力。
几何重建方法在处理密集遮挡时往往导致遮挡区域缺失,且输出为单一融合网格,难以进行物体级编辑。生成式先验虽然能补全遮挡区域,但通常局限于单物体或简单场景,无法在已知世界坐标系中联合处理多视角观测以恢复完整几何。
因此,如何在保持单物体生成质量的同时,实现多视角一致性和世界坐标定位,成为组合式 3D 场景重建的关键挑战。
核心创新
- 提出 WorldSculpt 框架,将单物体生成先验扩展至多视角条件生成,支持从密集遮挡场景生成组合式网格。
- 设计 Anchor-aligned canonicalization 机制,解决多视角观测在规范空间中的对齐问题,支持变数量视角输入。
- 引入 IBR 风格置换不变聚合器,融合多视角特征以增强对遮挡和视角变化的鲁棒性。
- 提出 UE-MeshyScene 基准数据集,包含 6 个高密度遮挡场景,提供精确的逐物体网格真值和相机参数。
- 证明在规范空间单物体上微调的模型可泛化至大规模复杂场景,无需场景级训练。
方法概览
WorldSculpt 包含三个主要步骤:1) Anchor-aligned canonicalization:为每个物体构建锚点对齐的规范立方体,通过 crop-aware projection 将多视角观测映射到规范空间;2) Multi-view conditioned generation:利用 DINOv3 提取特征并提升至规范体素网格,通过 IBR 风格的置换不变聚合器融合多视角特征,注入冻结的 Pixal3D 几何阶段(使用 LoRA 适配);3) Scene composition:将生成的规范空间网格通过规范到世界变换放置到共享世界坐标系中。训练仅在规范空间的单物体上进行,无需场景级训练。
- Anchor-aligned canonicalization:为每个物体构建锚点对齐的规范立方体,通过 crop-aware projection 将多视角观测映射到规范空间。
- Multi-view conditioned generation:利用 DINOv3 提取特征并提升至规范体素网格,通过 IBR 风格的置换不变聚合器融合多视角特征。
- 注入冻结的 Pixal3D 几何阶段:使用 LoRA 适配,将融合后的 3D 条件与锚点视角的全局 token 共同驱动几何生成。
- Scene composition:将生成的规范空间网格通过规范到世界变换放置到共享世界坐标系中。
- 训练策略:仅在规范空间的单物体上进行训练,无需场景级训练,从而将单物体生成能力泛化至复杂场景。
逐图理解论文
核心区分
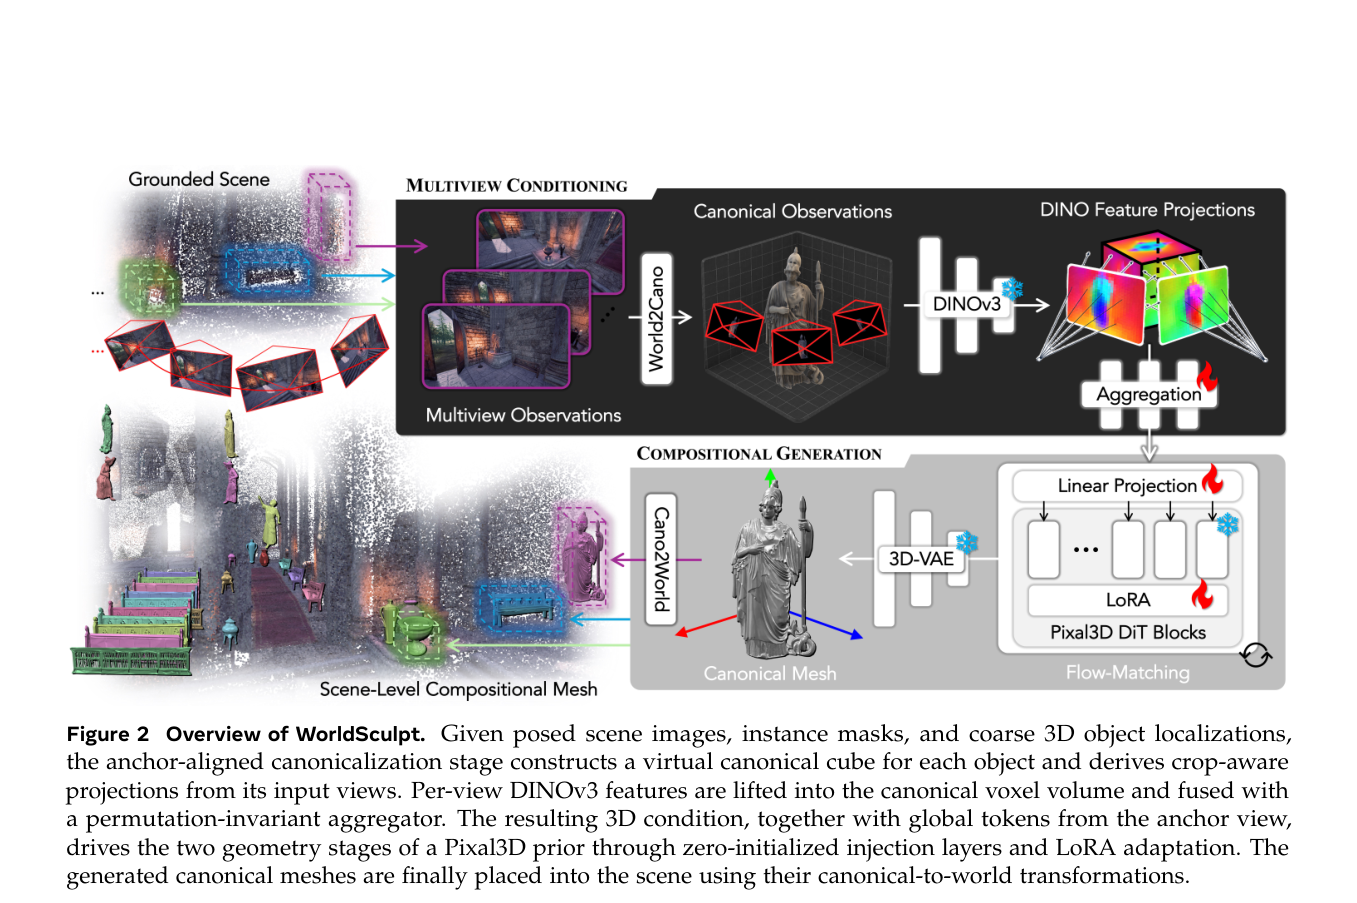
该图详细展示了 WorldSculpt 的三个主要步骤:Anchor-aligned canonicalization、Multi-view conditioned generation 和 Scene composition。重点观察多视角特征如何被融合并注入 Pixal3D 几何阶段,理解其技术细节。
最强结论
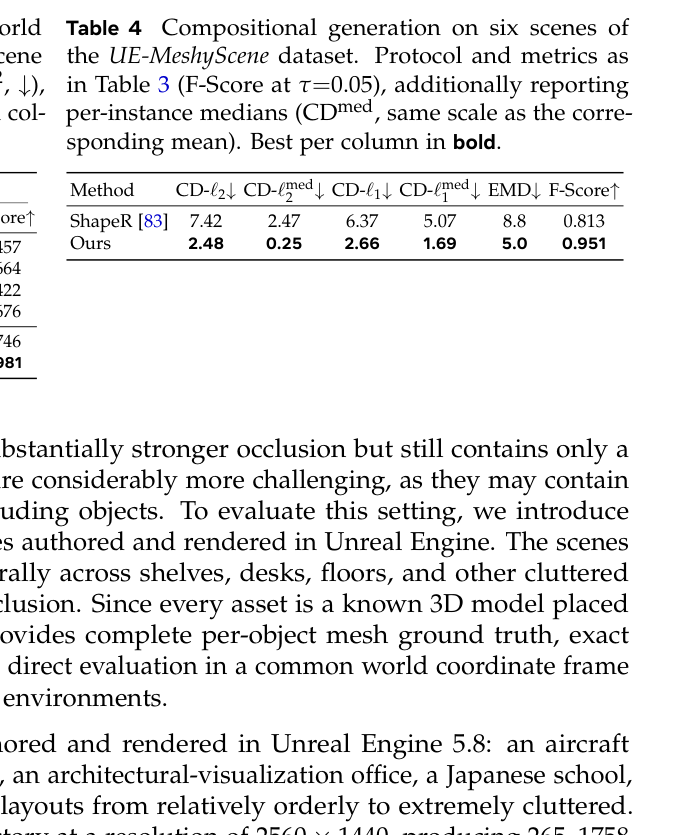
在 UE-MeshyScene 上,WorldSculpt 的 CD-ℓ2 为 2.48 (×10⁻³),F-Score 为 0.951,显著优于多视角基线 ShapeR,证明了其在复杂场景中的优越性能。
意义与局限
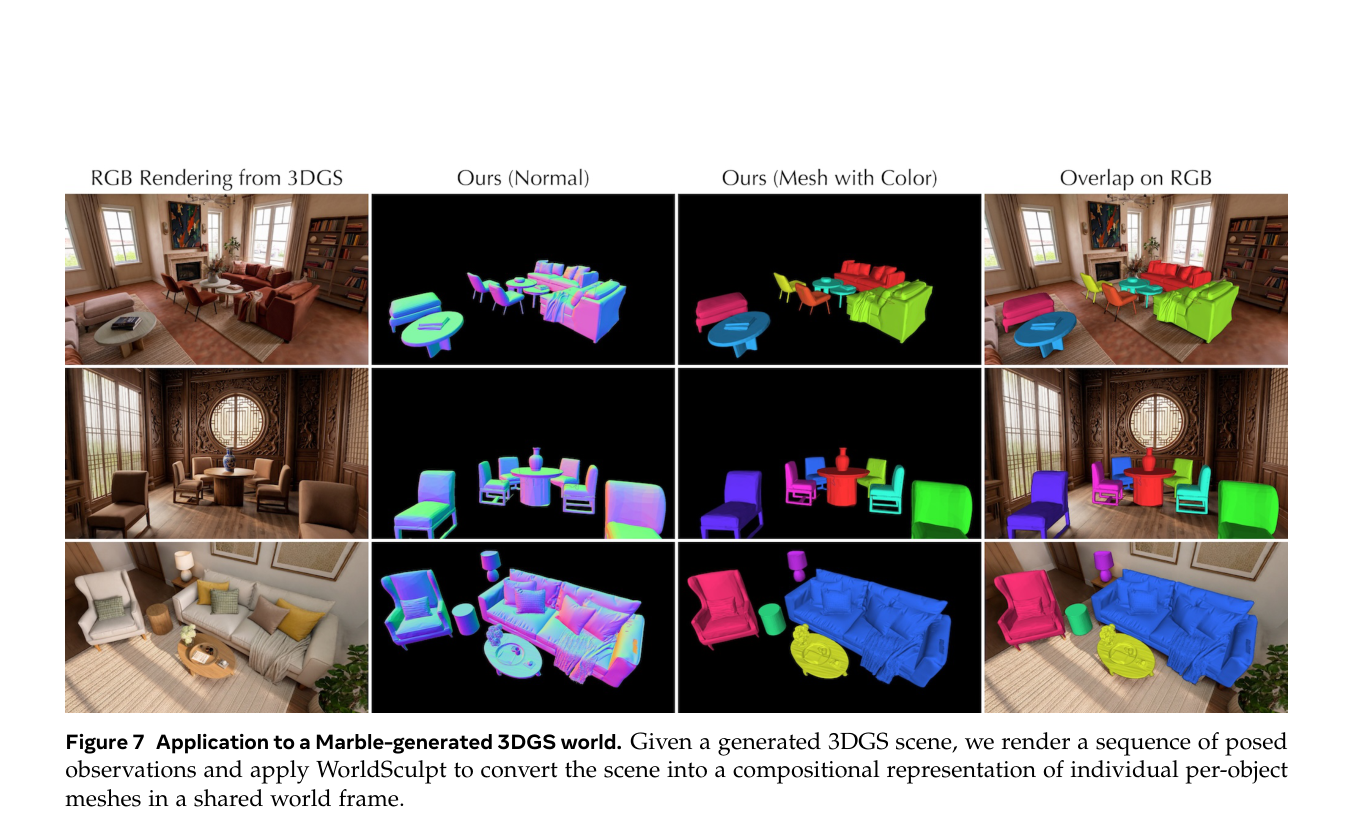
该图展示了将 Marble 生成的 3DGS 世界转换为组合式网格场景的应用。重点观察转换前后的表示差异,理解 WorldSculpt 在实际应用中的价值。
Figure 1 WorldSculpt
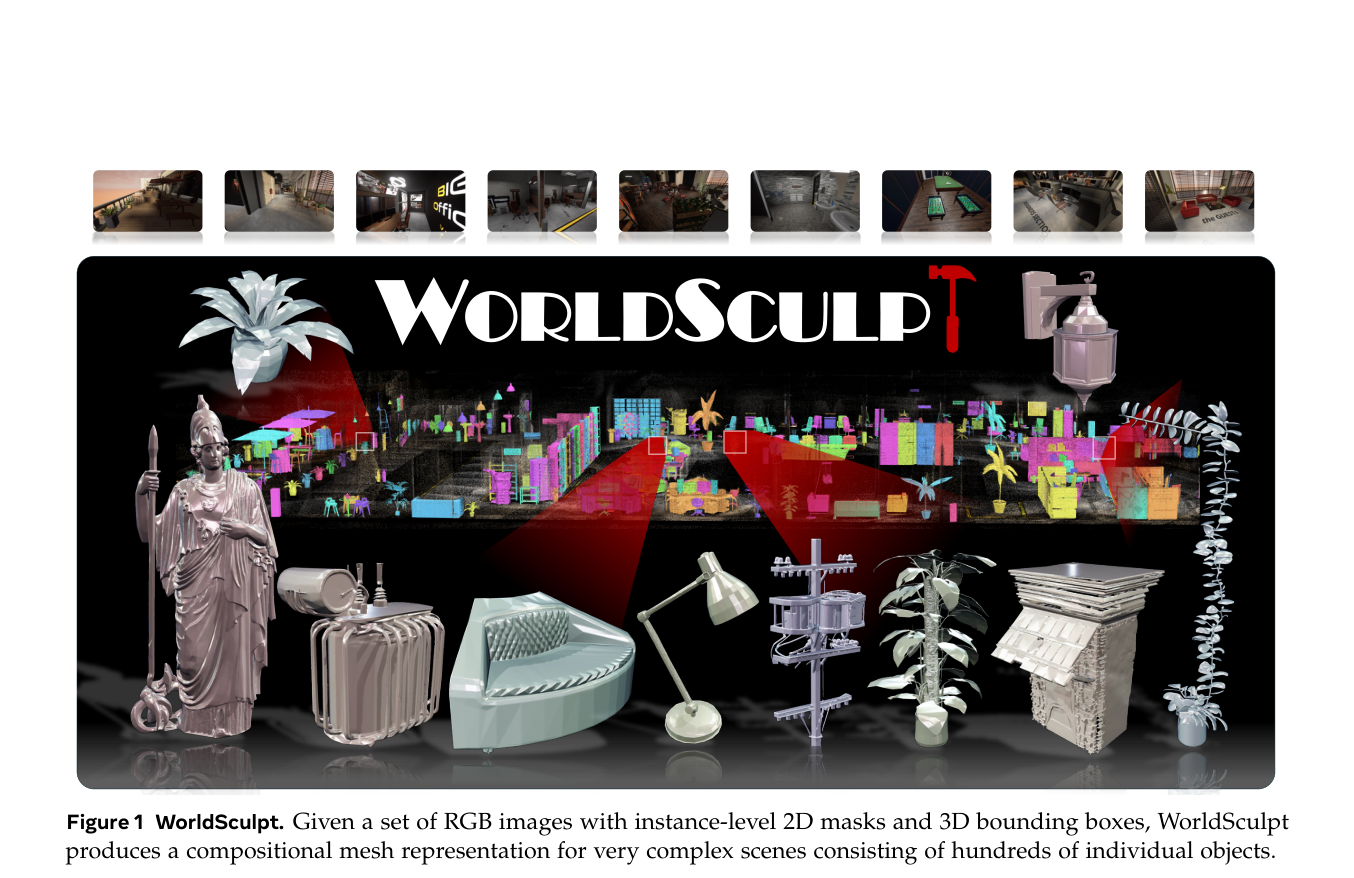
该图展示了 WorldSculpt 的整体流程,从输入 RGB 图像、实例掩码和 3D 定位框到输出组合式网格表示。重点观察输入输出的对应关系,理解其如何从复杂场景中生成数百个独立物体网格。
实验如何设计?
- 单物体评估:在 Toys4k 上进行规范空间生成评估,比较不同视角数和遮挡比例下的性能。
- 多物体场景评估:在 HouseCat6D 和 Toys4k-Scene 上进行多物体场景生成评估,比较与 SAM3D、SceneGen 等基线方法。
- 大规模组合式生成评估:在 UE-MeshyScene 上进行评估,重点比较与多视角基线 ShapeR 的性能。
- 消融实验:比较 IBR 聚合器与平均融合策略在不同场景复杂度下的效果。
- 应用实验:将 Marble 生成的 3DGS 世界转换为组合式网格场景。
关键结果与论文证据
- 在 Toys4k 16 视角 0% 遮挡下,CD-ℓ2 为 1.19 (×10⁻³),F-Score@0.05 为 0.967,优于 Pixal3D 单视角基线(Page 10)。
- 在 HouseCat6D 上,CD-ℓ2 为 0.28 (×10⁻³),F-Score 为 0.995,显著优于 ShapeR (CD-ℓ2 1.26, F-Score 0.973)(Page 10)。
- 在 UE-MeshyScene 上,CD-ℓ2 为 2.48 (×10⁻³),F-Score 为 0.951,优于 ShapeR (CD-ℓ2 7.42, F-Score 0.813)(Page 10)。
- 在 UE-MeshyScene 消融实验中,IBR 聚合器相比平均融合将 CD-ℓ2 降低 12% (2.48 vs 2.83),F-Score 提升至 0.951(Page 14)。
- 定性结果显示,WorldSculpt 在密集遮挡场景中恢复了更详细且准确放置的几何结构,包括小型和严重遮挡的物体(Page 13)。
阅读时需要注意
- 依赖上游估计的相机位姿、实例掩码和粗略 3D 定位框,严重误差会影响生成质量。
- 当前仅生成几何结构,未建模物体外观(纹理和材质)。
- 假设场景是静态的,不支持移动或变形物体。
关联工作
- Pixal3D:基础生成先验,WorldSculpt 在其几何阶段上扩展多视角条件路径。
- TRELLIS / TRELLIS.2:Pixal3D 的骨干网络,用于结构化潜变量生成。
- ShapeR:主要多视角基线方法,在 UE-MeshyScene 上进行对比。
- SAM3D / SceneGen / SceneMaker:组合式场景生成基线方法,在 HouseCat6D 和 Toys4k-Scene 上进行对比。
- IBRNet:多视角特征聚合模块的设计灵感来源。
- Marble / HY-World 2.0:生成式世界模型,WorldSculpt 用于将其 3DGS 输出转换为组合式网格。