快速导读:BLASt3R 提出了一种统一的混合 3D 重建框架,通过结合可扩展的多视图匹配网络、可调整的单目深度先验以及正则化束调整(BA),在离线 SfM 和在线 VSLAM 场景中均实现了优于现有方法的精度与速度权衡。
BLASt3R 针对混合 3D 重建系统可扩展性不足的问题,提出了一套统一框架。传统 SfM 在低纹理场景脆弱,纯前馈方法精度受限,而现有混合方法往往计算昂贵且场景专用。该工作通过架构级创新,将密集匹配、单目先验与几何优化解耦又统一,实现了精度与速度的新平衡。
核心贡献在于将单目深度从固定先验转变为可调整参数,使其在束调整中既能提供初始化又能作为正则化项。配合基于记忆的流式匹配网络,BLASt3R 在 TUM-RGBD、ETH3D 等基准上同时优于纯前馈和纯传统方法,且无需针对不同场景调整超参数。
英文题目:BLASt3R: Bundle Adjustment of Any Image Set with Multi-View Matching and Monocular Priors
论文出处:arXiv 每日论文精选 · arXiv:2609.05210
原始论文:PDF / 论文页面
这篇论文解决什么问题?
当前 3D 重建领域存在明显的精度-速度-通用性三角困境。DUSt3R 等前馈方法虽快,但缺乏全局几何一致性;COLMAP 等传统 SfM 精度高,但依赖特征匹配,在纹理缺失时失效。MASt3R-SfM 和 VGGT-BA 等混合方法试图结合两者优势,但前者计算复杂度随视图数平方增长,后者内存占用高且通常针对特定任务优化。
在线 VSLAM 场景对实时性要求严苛,传统 BA 的迭代优化难以满足帧率约束。而离线 SfM 虽可容忍较长计算时间,但现有混合方法在处理数千视图时仍面临可扩展性瓶颈。更关键的是,多数系统需要为在线和离线场景分别设计,缺乏统一接口。
单目深度先验在此背景下具有独特价值:它不依赖多视图几何,可提供稠密初始化。但传统方法将其视为固定输入,无法在优化过程中修正误差。BLASt3R 的核心洞察是:单目深度应作为可学习参数参与 BA,而非静态先验。
核心创新
- 提出了 BLASt3R 框架,统一支持离线无序图像重建和在线 VSLAM,共享超参数。
- 设计了可扩展的多视图匹配器,结合基于记忆的流式 FF3D 和成对密集匹配,通过粗到细策略降低计算复杂度。
- 引入了可调整点图(Adjustable Pointmaps)机制,在 BA 中利用单目深度先验进行初始化和正则化,通过优化线性组合系数提高深度拟合能力。
- 实现了基于 GPU 加速的统一 BA 优化,联合优化相机、轨迹和深度参数,显著提升了大规模场景的重建速度和精度。
方法概览
BLASt3R 包含三个核心组件:(1) 多视图匹配网络,采用粗到细策略(patch-level 粗匹配 + pixel-level 细匹配)生成密集光流,支持流式处理;(2) 单目可调整点图网络,预测射线图和深度图,并引入可优化的校正通道以在 BA 中调整深度;(3) 统一束调整,联合优化相机参数、稀疏轨迹和可调整深度参数,利用深度正则化提高收敛性和精度。
- 多视图匹配网络采用粗到细策略:patch-level 粗匹配通过 transformer 更新 query tokens 并与 memory 做点积,阈值化得到候选 patch 对 P;pixel-level 细匹配仅在 P 上执行,通过 block-sparse 相似度矩阵计算密集光流,将计算复杂度从 O(N²) 降至近似线性。
- 单目网络预测射线图和深度图,并引入可优化的校正通道。Adjustable Pointmaps 机制将单目深度表示为线性组合,系数在 BA 中联合优化,使深度先验能自适应修正系统误差。
- 统一 BA 模块联合优化相机内参、外参、稀疏轨迹和可调整深度参数。深度正则化项约束校正系数不偏离单目预测太远,提高收敛稳定性。GPU 加速实现支持大规模场景的实时优化。
- 流式处理架构基于记忆机制,新帧到来时仅与相关 memory 帧匹配,避免全对比较。实践中检索约 40 帧相关子集,平衡全局一致性与计算成本。
- 初始化策略借鉴 DUSt3R 的最大生成树方法,从无序图像集中构建初始轨迹,再逐步扩展至全场景。该策略对图像顺序不敏感,支持任意输入集合。
- 训练数据包含 10% 合成数据以增强泛化,但主要依赖真实场景。损失函数结合匹配精度、深度一致性和几何正则化,端到端训练匹配网络和单目网络。
逐图理解论文
关键区分
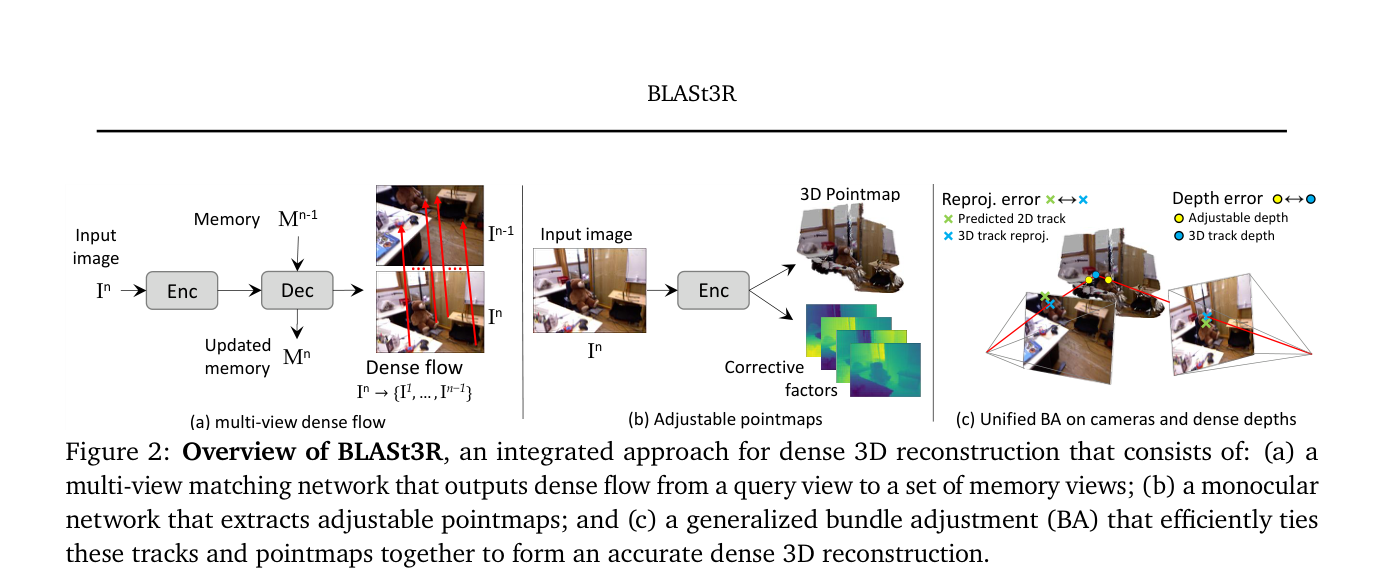
该图展示 BLASt3R 整体架构,包含三个核心组件:多视图匹配网络、单目网络和统一 BA。应重点观察各组件的数据流向:匹配网络输出密集光流,单目网络输出可调整点图,BA 模块联合优化所有参数。理解该图是把握论文核心贡献的关键,它直观展示了如何将前馈预测与传统几何优化统一。
方法贡献
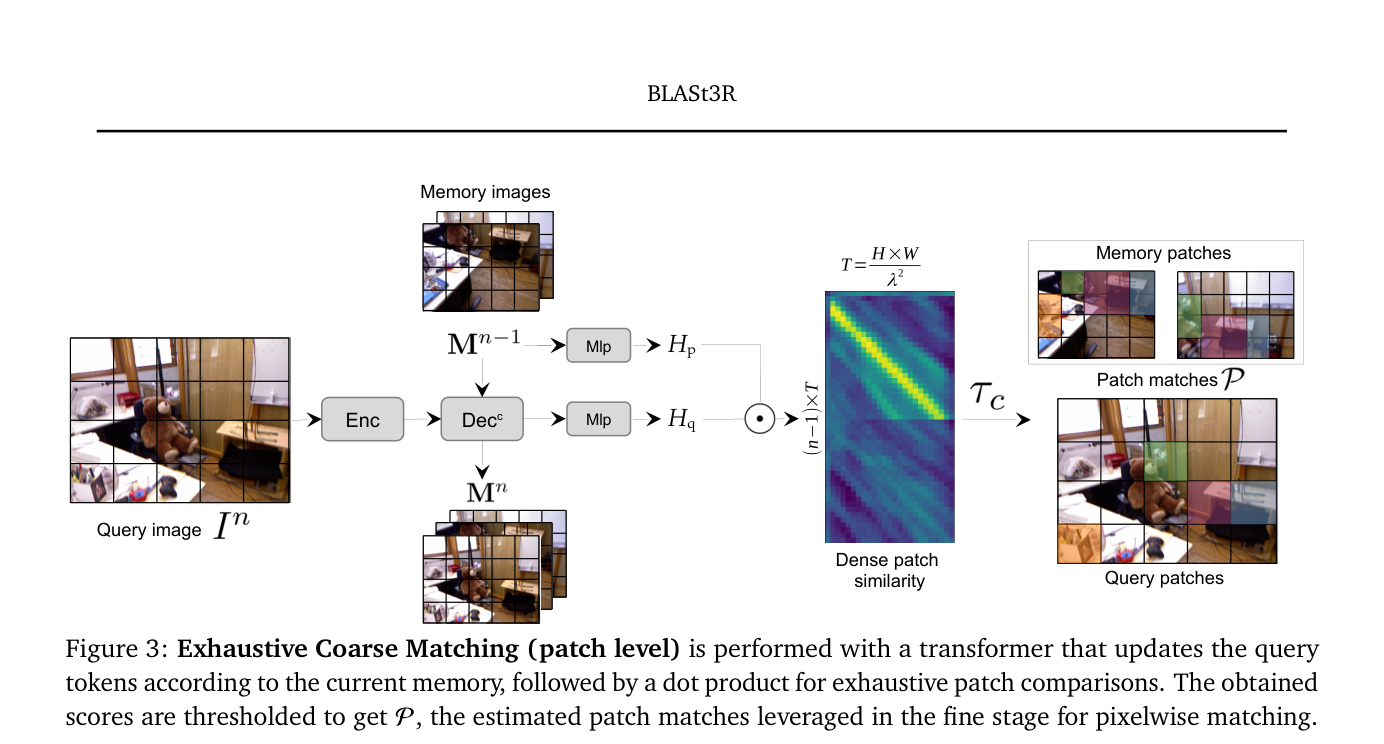
该图展示粗匹配阶段,patch-level 匹配通过 transformer 更新 query tokens 并与 memory 做点积。应关注阈值化操作如何生成候选 patch 对 P,这是降低计算复杂度的关键步骤。理解该图有助于理解 BLASt3R 如何实现可扩展性,以及为何细匹配仅需在 P 上执行。
最强证据
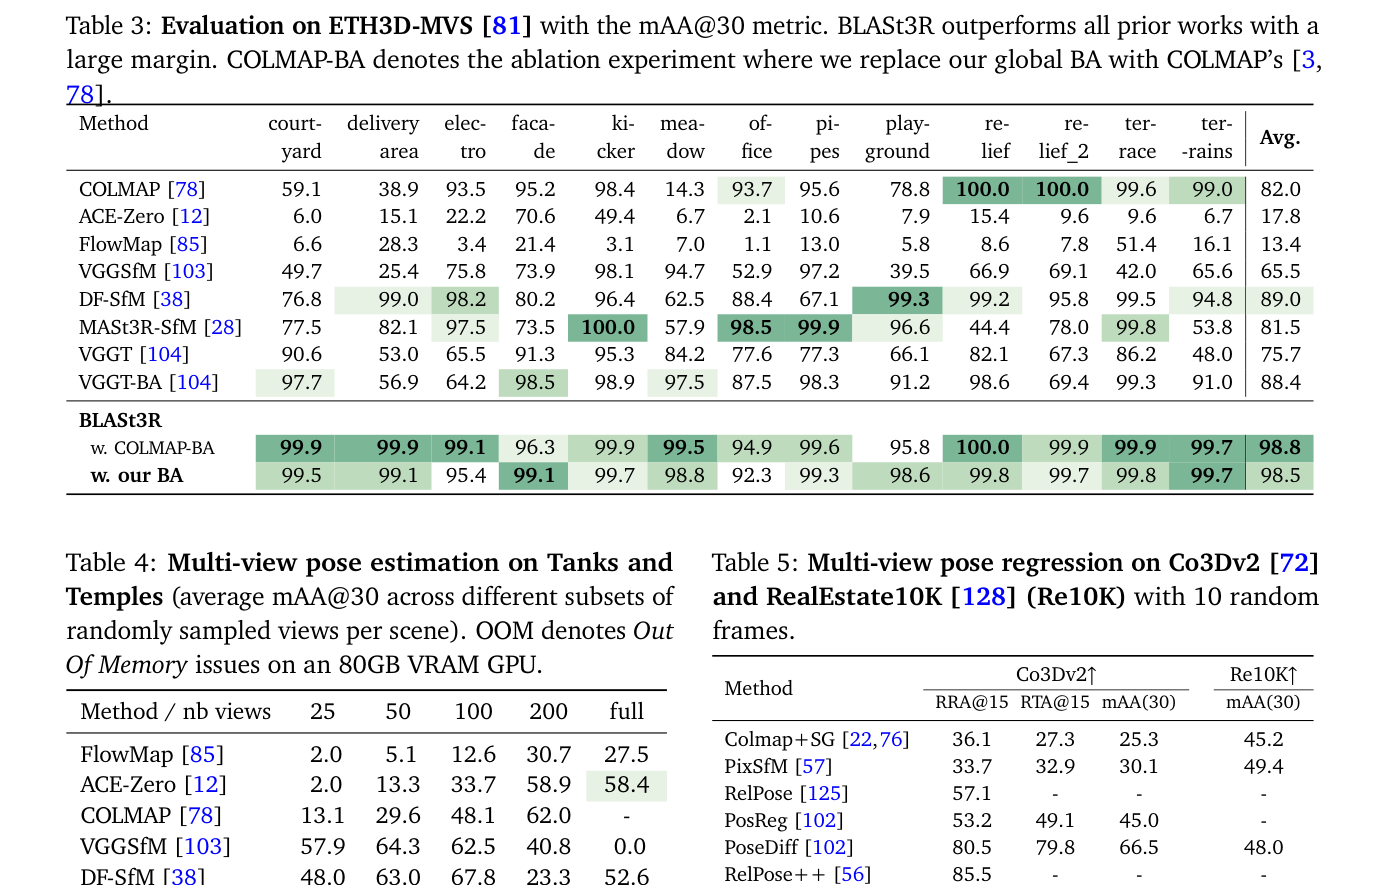
该表展示 ETH3D-MVS 上的 mAA@30 结果,BLASt3R 使用自身 BA 和 COLMAP-BA 均大幅优于基线。应关注不同场景下的性能差异,以及 COLMAP-BA 在部分场景略高的原因(基线较大,三角测量可靠)。理解该表有助于理解 BLASt3R 在离线 SfM 场景的优势,以及深度正则化的作用边界。
意义与局限
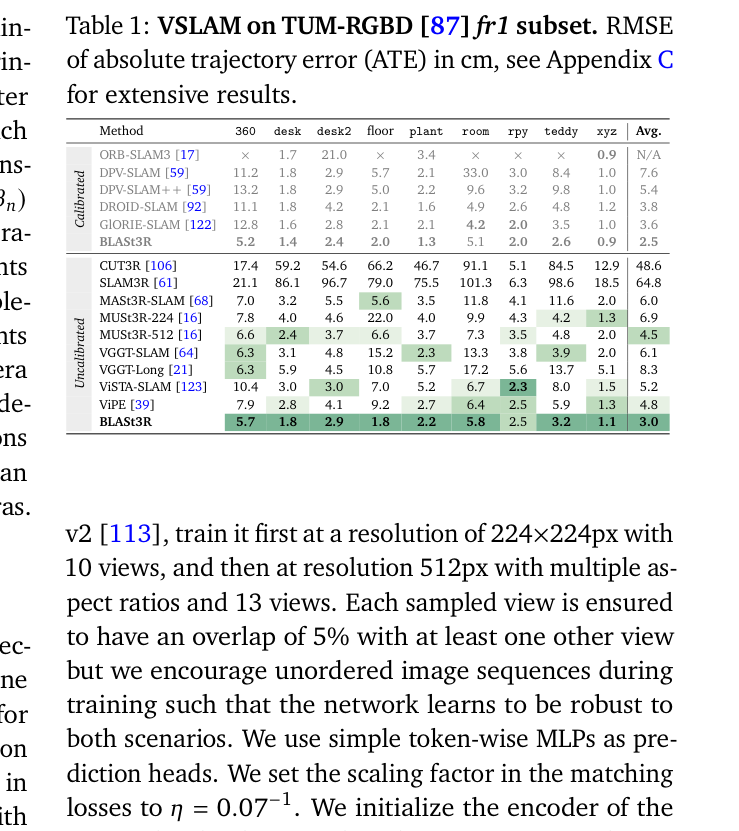
该表展示 TUM-RGBD fr1 子集上的 ATE RMSE 结果,BLASt3R 未标定模式优于所有已标定基线。应关注未标定与已标定模式的性能差异,以及不同序列上的表现。理解该表有助于理解 BLASt3R 在在线 VSLAM 场景的优势,以及未标定模式的实际意义。
Figure 4: Sparse Fine Matching (pixel level) is performed only on the patch-level matches P from the coarse step
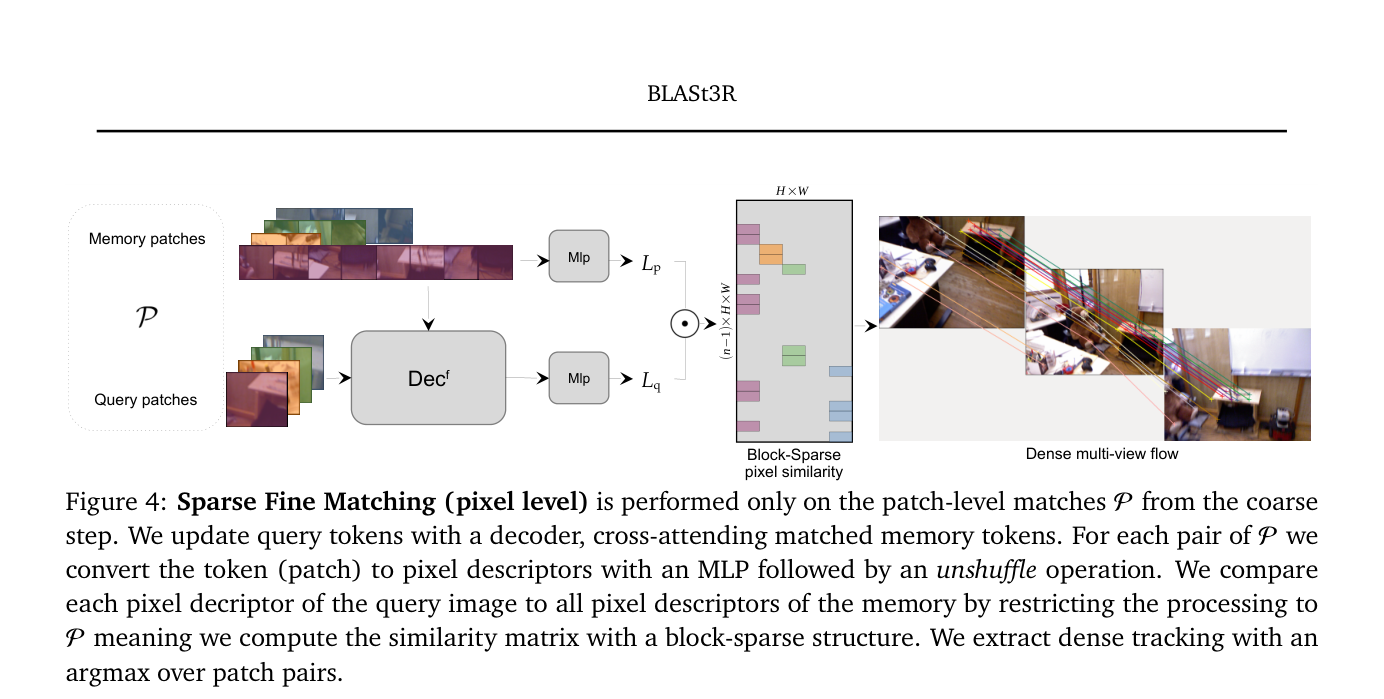
该图展示细匹配阶段,pixel-level 匹配仅在粗匹配得到的 P 上执行。应关注 block-sparse 相似度矩阵的结构,以及 argmax 操作如何提取密集跟踪。理解该图有助于理解 BLASt3R 如何在保持精度的同时降低计算成本,以及粗到细策略的具体实现。
实验如何设计?
- 在线 VSLAM 评估使用 TUM-RGBD 和 ETH3D-SLAM 数据集,指标为 ATE RMSE,对比 ORB-SLAM3、Spann3R、MUSt3R 等方法。
- 离线 SfM 评估使用 ETH3D-MVS 和 Tanks&Temples 数据集,指标为 mAA@30,对比 VGGT-BA、MASt3R-SfM 等混合方法。
- 多视图位姿回归在 Co3Dv2 和 RealEstate10K 上评估,使用 10 随机帧,指标为 mAA@30。
- 3D 点图重建质量在 7-Scenes 和 ETH3D 上评估,指标包括 Accuracy、Completeness 和 Normal Consistency。
- 单目深度估计在 NYUv2、KITTI 等 10 个数据集上评估,使用 MoGe 的 affine-invariant alignment 协议,nz=1 和 nz=16 两种设置。
- 消融实验包括替换 BA 模块为 COLMAP-BA、禁用焦距优化、移除深度正则化等,验证各组件贡献。
关键结果与论文证据
- 在 TUM-RGBD fr1 子集上,BLASt3R 未标定模式 ATE RMSE 为 3.0 cm,优于所有已标定基线(第 7 页 Table 1)。
- 在 ETH3D-SLAM 上,BLASt3R 平均 ATE RMSE 为 1.2 cm,显著优于 Spann3R(16.8 cm)和 MUSt3R-512(10.0 cm)(第 8 页 Table 2)。
- 在 ETH3D-MVS 上,BLASt3R 使用自身 BA 的 mAA@30 为 98.5%,使用 COLMAP-BA 为 98.8%,均大幅优于 VGGT-BA(88.4%)和 MASt3R-SfM(81.5%)(第 9 页 Table 3)。
- 在 Tanks&Temples 200 视图设置上,BLASt3R 使用自身 BA 的 mAA@30 为 76.1%,使用 COLMAP-BA 为 77.2%,优于 MASt3R-SfM(69.5%)(第 9 页 Table 4)。
- 在 Co3Dv2 上,BLASt3R 使用自身 BA 的 mAA@30 为 88.2%,低于 VGGT-BA(91.8%),作者归因于未针对稀疏视图场景优化超参数(第 9 页 Table 5)。
- 在 ETH3D 3D 点图重建上,BLASt3R 平均 Accuracy 为 0.055,中位数为 0.017,优于 π3(0.052/0.028)和 VGGT(0.108/0.052)(第 10 页 Table 6)。
- 单目深度估计 nz=1 设置下,BLASt3R 平均 Rel 为 8.65,低于 MoGe(4.51),但 nz=16 oracle bound 为 4.87,表明可调整机制具有表示潜力(第 10 页 Table 7)。
- 消融实验显示,移除深度正则化导致收敛性下降,替换为 COLMAP-BA 在基线较大的数据集上精度略高,验证了深度先验在小基线场景的关键作用。
阅读时需要注意
- 在 Co3Dv2 和 RealEstate10K 的稀疏视图位姿回归任务中,性能低于 VGGT-BA,主要因未针对该场景优化超参数(如禁用初始焦距优化)。
- 单目深度估计在 nz=1 设置下不如专门的单目深度模型,其价值主要体现在作为 BA 正则化项而非独立预测。
- 实际推理中若无法比较所有帧,需检索相关帧子集(实践中约 40 帧),可能影响全局一致性,尤其在长序列或大场景下。
- 训练数据包含 10% 合成数据,可能在完全未见过的真实世界场景中引入偏差。
- 未标定模式在 TUM-RGBD 上优于已标定基线,但这主要基于特定数据集,实际应用中已知内参可能仍有帮助。
关联工作
- MASt3R-SfM 是主要对比基线,混合方法精度高但速度慢,不支持在线流式处理,BLASt3R 通过粗到细匹配和流式架构解决其可扩展性问题。
- VGGT-BA 是另一主要基线,前馈方法结合 COLMAP BA,速度快但精度略低,内存占用高,BLASt3R 通过可调整单目先验和统一 BA 实现精度-速度更优平衡。
- MUSt3R 提供架构灵感,基于记忆的流式 FF3D,但仅回归点图而非像素匹配,BLASt3R 扩展至密集光流以支持 BA。
- DUSt3R 是前馈 3D 重建的开创性工作,BLASt3R 借鉴其最大生成树初始化策略,但将单目深度从固定先验转变为可调整参数。
- COLMAP 作为传统 SfM 基准,用于对比 BA 模块性能,BLASt3R 的 BA 在小基线场景优于 COLMAP-BA,但在大基线场景两者相当。