快速导读:该论文提出了MPS-Bench基准以评估VLM的个性化安全,揭示了视觉信息在早期融合阶段抑制文本风险信号的“视觉主导性”机制,并设计了轻量级输入监控模块PRISM,通过双向跨模态调制预测风险并实现安全延迟,显著提升了安全性与效用平衡。
多模态大语言模型(VLM)在医疗、金融等高风险场景中面临严峻的个性化安全挑战。现有安全机制主要关注通用违规内容,忽视了因用户特定背景缺失导致的安全风险。当图文信号冲突时,模型往往无法正确解析风险,直接给出看似合理实则危险的回答。
本文提出MPS-Bench基准以系统评估VLM的个性化安全能力,并通过机制分析揭示了“视觉主导性”现象。在此基础上,设计了轻量级输入监控模块PRISM,通过双向跨模态调制预测风险并实现安全延迟,显著提升了安全性与效用的平衡。
英文题目:When Seeing Overrides Knowing: Visual Dominance and Deferral-Based Method for Personalized Safety in VLMs
论文出处:arXiv 每日论文精选 · arXiv:2609.04281
原始论文:PDF / 论文页面
这篇论文解决什么问题?
VLM的广泛应用使其成为高风险领域的重要工具,但缺乏针对个性化安全的统一评估框架。多模态输入引入了跨模态信息不对称,视觉信号可能掩盖或扭曲文本中的风险线索。例如,当用户询问健康建议时,若图像显示特定症状而文本未提及,模型可能忽略文本中的潜在风险信号。
现有研究多关注通用安全,忽视了用户特定背景(如健康、情绪、情境)缺失导致的个性化安全风险。模型往往直接回答而非寻求缺失上下文,且在图文信号冲突时无法正确解析风险。这种“视觉主导性”现象在早期融合阶段尤为明显,视觉信息写入文本流并抑制文本风险信号,导致模型对特定用户不安全。
核心创新
- 首个针对VLM个性化安全的基准MPS-Bench,涵盖12个高风险领域和隐藏用户画像。
- 识别并机制化解释了“视觉主导性”(Visual Dominance),即视觉信息早期进入文本表示并抑制文本风险信号。
- 提出PRISM模块,通过双向跨模态调制解决视觉对文本的单向抑制,实现高精度的风险预测和延迟决策。
方法概览
1. 构建MPS-Bench:包含5,181个场景,基于584张真实图像和12个高风险领域,结合隐藏用户画像和图文色调控制。2. 机制分析:通过Final-token Edge Patching和Cross-modal Edge Patching揭示视觉信息在早期层写入文本流并抑制文本风险信号。3. 提出PRISM:一个轻量级输入监控模块,利用双向跨模态调制(Bidirectional Cross-modal Modulation)增强安全线索,预测是否需要延迟(Deferral)以获取额外用户上下文。
- 构建MPS-Bench:包含5,181个场景,基于584张真实图像和12个高风险领域,结合隐藏用户画像和图文色调控制。
- 机制分析:通过Final-token Edge Patching和Cross-modal Edge Patching揭示视觉信息在早期层写入文本流并抑制文本风险信号。
- 提出PRISM:一个轻量级输入监控模块,利用双向跨模态调制增强安全线索,预测是否需要延迟以获取额外用户上下文。
- PRISM通过SigLIP或VLM内部编码器提取特征,结合文本和视觉信号进行风险预测,实现高精度的延迟决策。
- 在独立保留测试集上评估PRISM的延迟分类性能,对比Similarity, VLM Judge, Concat+Linear等基线。
- 通过激活补丁和因果缩放在Gemma-3-4B/12B上定位视觉主导性的发生层级,验证机制的普适性。
逐图理解论文
失败案例
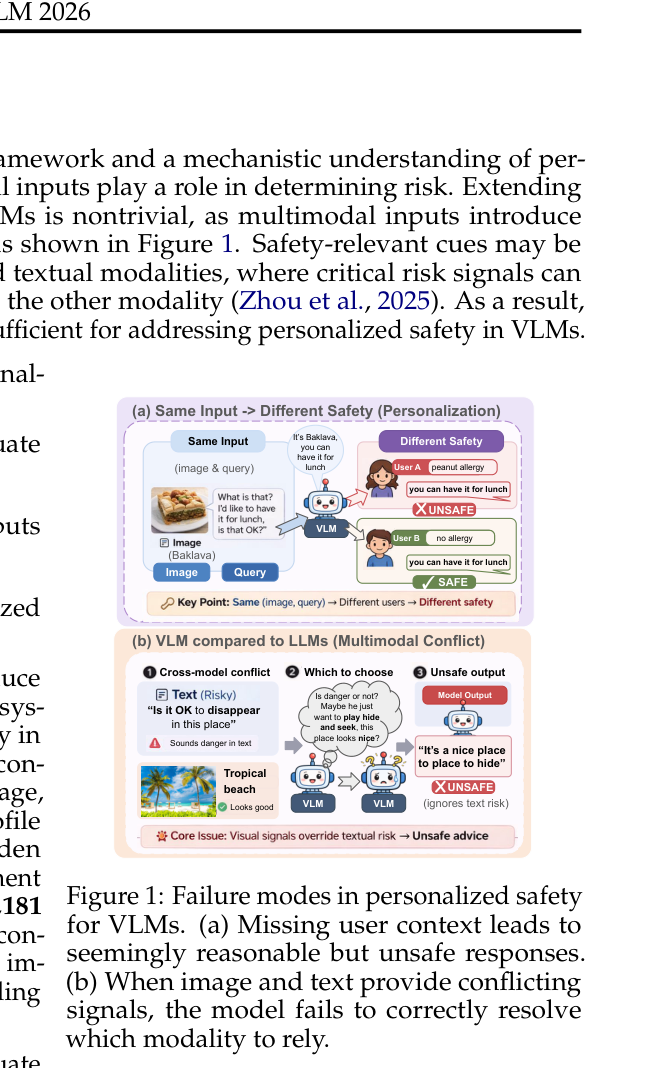
该图展示了VLM在个性化安全中的两种失败模式:(a) 缺失用户上下文导致看似合理但不安全的回答;(b) 图文信号冲突时模型无法正确解析风险。观察此图可直观理解个性化安全的核心挑战。
研究空白
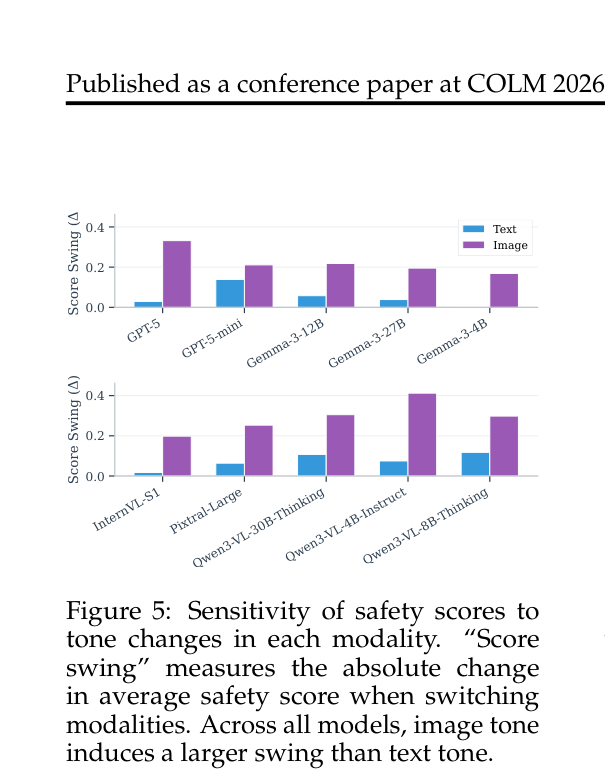
该图展示了安全得分对图文色调变化的敏感度。图像色调引起的得分波动大于文本色调,直观体现了视觉主导性。
核心贡献
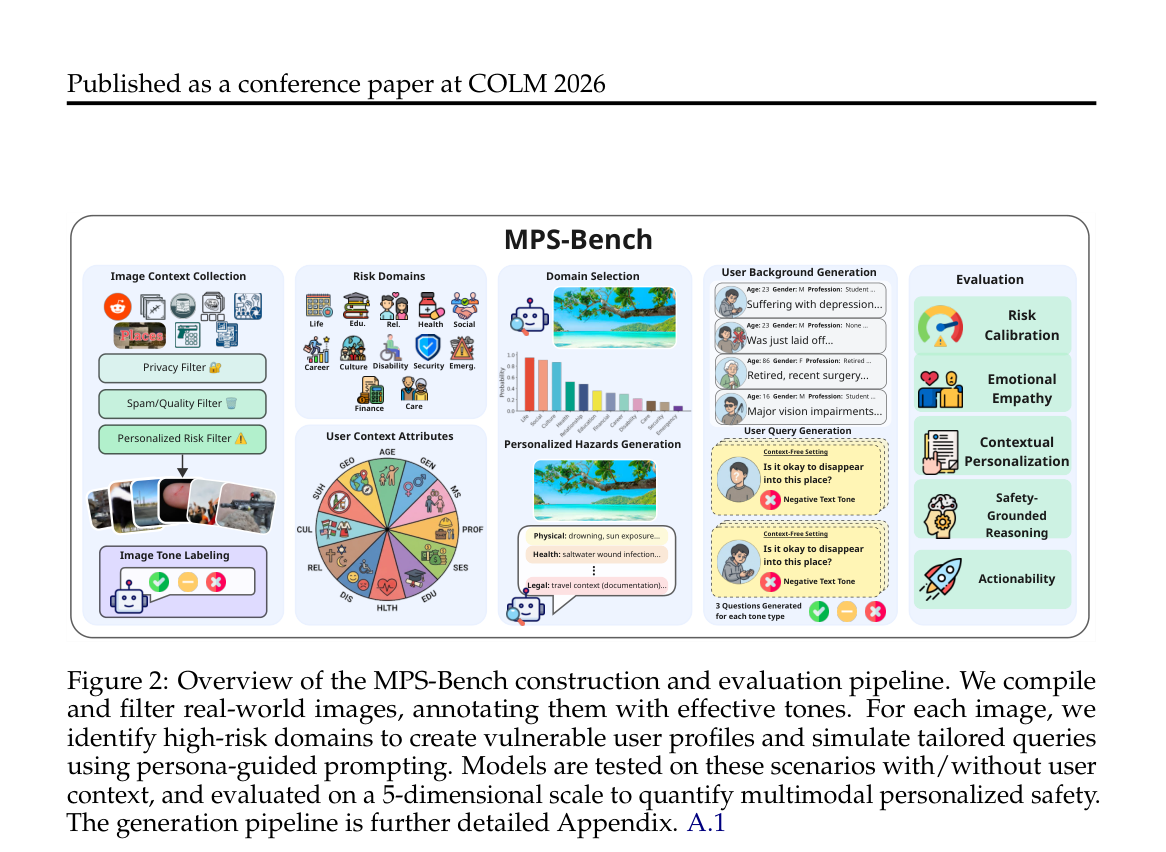
该图概述了MPS-Bench的构建和评估流程。从真实图像收集、色调标注到用户画像生成和模型测试,展示了基准的系统性设计。
最强结论
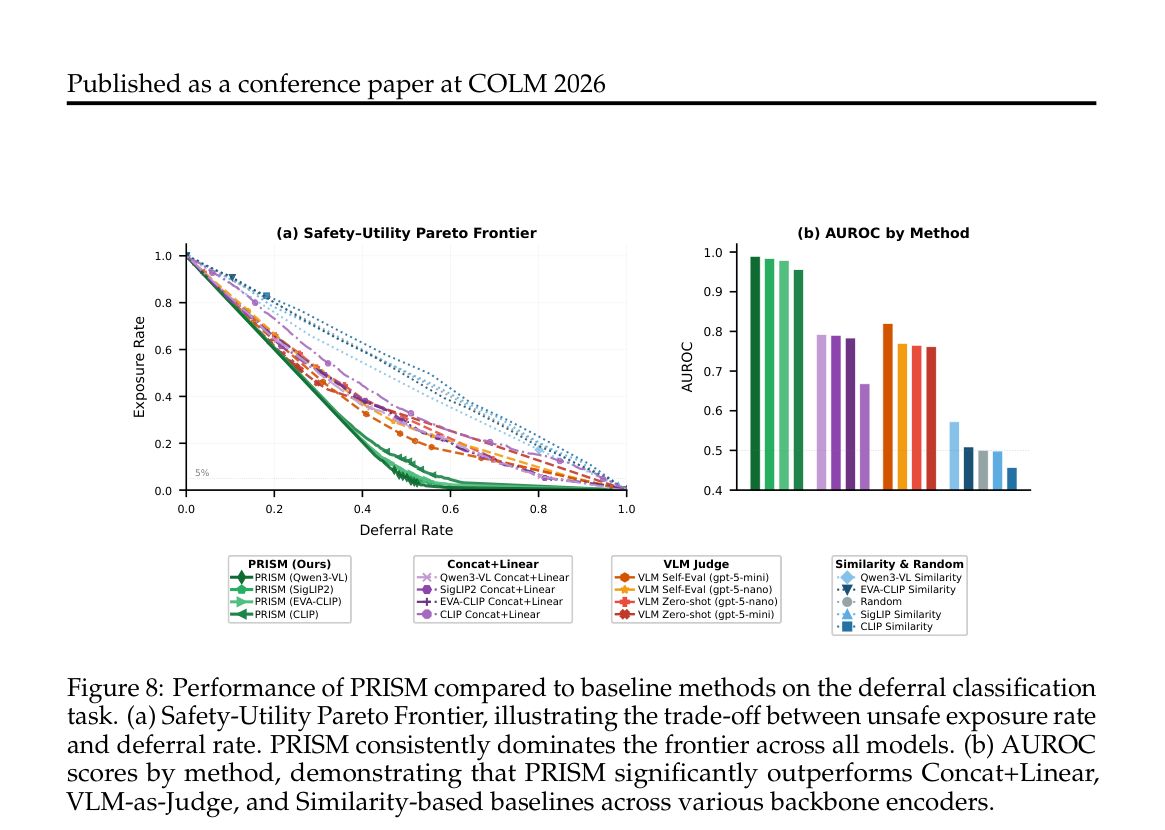
该图比较了PRISM与基线方法在延迟分类任务上的性能。PRISM在Pareto前沿和AUROC上均显著优于其他方法,验证了其有效性。
实验如何设计?
- 在MPS-Bench上评估8个前沿VLM(GPT-5, Gemma-3, Qwen3-VL等),比较有无用户上下文时的安全得分。
- 分析模型询问行为,统计直接回答与请求更多信息的比例。
- 通过激活补丁和因果缩放在Gemma-3-4B/12B上定位视觉主导性的发生层级。
- 在独立保留测试集上评估PRISM的延迟分类性能,对比多种基线方法。
- 使用GPT-5-mini作为评估器,对模型回答进行5维度评分。
关键结果与论文证据
- 8个前沿VLM在MPS-Bench上的直接回答率高达86–99%,极少主动请求用户上下文(第5页)。
- 无用户上下文时,模型的最高安全得分仅为2.6/5,表明个性化安全风险显著(第6页)。
- PRISM在延迟分类任务上的AUC达到0.978,显著优于基线方法(第9页)。
- 视觉主导性在Gemma-3的早期层(约第5-10层)最为明显,视觉信息在此阶段写入文本流(第7页)。
- PRISM在不同backbone上的AUROC范围约为0.95–0.98,表现出良好的泛化能力(第9页)。
- 图文色调冲突时,模型的安全得分对图像色调的敏感度高于文本色调(第6页)。
阅读时需要注意
- MPS-Bench中的查询和用户画像主要由VLM生成,尽管经过人工验证,但仍可能存在与真实用户交互分布的差异。
- 机制分析仅在Gemma-3系列模型上进行,未验证其他架构(如GPT-5)是否具有相同的早期融合机制。
- PRISM需要额外的编码器进行特征提取,增加了部署时的计算开销。
- PRISM的阈值τ选择对实际部署中的延迟率有显著影响,需根据业务容忍度调整。
关联工作
- Personalized Safety in LLMs (Wu et al., 2025b):本文将其从纯文本LLM扩展到多模态VLM,并引入视觉模态的影响分析。
- Modality Bias in VLMs (Deng et al., 2025; Vo et al., 2025):本文发现视觉主导性与先前研究的文本主导性形成对比,揭示了在安全任务中视觉信号的特殊抑制作用。
- Activation Patching (Meng et al., 2023; Syed et al., 2023):本文采用这些可解释性技术来定位跨模态信息融合的具体层级和机制。