快速导读:本文提出SVDtrunc,通过重要性感知的截断SVD压缩投影矩阵并结合模块化知识蒸馏,在保持Diffusion Transformer架构不变的前提下实现高效参数压缩,显著优于现有剪枝方法。
扩散Transformer(DiTs)已成为文生图领域的主流架构,但其巨大的参数量(通常达8-20B)使得部署成本高昂。现有的参数压缩方法,如剪枝和结构修改,在激进压缩下往往导致性能骤降,且可能破坏网络结构。本文提出SVDtrunc,一种基于重要性感知的低秩蒸馏方法,旨在解决这一挑战。
SVDtrunc的核心思想是利用DiT对投影矩阵低秩近似的内在鲁棒性,通过截断SVD压缩投影矩阵,并结合模块化知识蒸馏恢复生成质量。与传统的剪枝方法不同,SVDtrunc不改变网络架构,而是通过非均匀的秩分配策略,根据块的重要性进行压缩,从而在保持生成质量的同时显著减少参数量。
英文题目:Importance-Aware Low-Rank Distillation of Diffusion Transformers
论文出处:arXiv 每日论文精选 · arXiv:2609.04646
原始论文:PDF / 论文页面
这篇论文解决什么问题?
DiTs的参数量巨大,部署成本高,限制了其在实际场景中的应用。现有的参数压缩方法主要分为两类:一是结构修改方法,如EcoDiff和PPCL,通过移除神经元或块来减少参数,但这些方法可能破坏网络结构,导致性能骤降;二是低秩分解方法,如SVD-LLM,在LLM中表现出灾难性失败,但在DiT中的鲁棒性尚不明确。
本文的研究动机在于探索DiT对低秩近似的鲁棒性,并提出一种更稳健的压缩方法。通过对比LLM和DiT在低秩分解下的表现,本文发现DiT具有内在的鲁棒性,即使在不训练的情况下也能保持平滑退化。这一发现为SVDtrunc的设计提供了理论基础。
此外,现有的压缩方法在激进压缩下往往导致性能骤降,且缺乏对块重要性的细粒度评估。本文提出基于CMMD指标的块重要性评估协议,通过探测每个块单独压缩后的质量下降,实现非均匀的秩分配策略,从而在保持生成质量的同时显著减少参数量。
核心创新
- 发现DiTs对投影矩阵级别的低秩近似具有内在鲁棒性,即使在不训练的情况下也能保持平滑退化,不同于LLM的灾难性失败。
- 提出基于压缩探测的块重要性评估协议,利用CMMD指标量化块对生成质量的贡献,实现重要性感知的秩分配。
- 引入SVDtrunc框架,结合重要性感知截断SVD和模块化知识蒸馏,在不改变架构的前提下实现高质量参数压缩。
- 验证了SVDtrunc与时间蒸馏的互补性,证明低秩容忍度在时间蒸馏后依然存在。
方法概览
SVDtrunc包含两个阶段:1. 重要性感知低秩压缩:通过探测每个块单独压缩后的质量下降(使用CMMD指标)对块进行重要性排序,根据全局参数预算分配非均匀压缩率,对投影矩阵进行截断SVD。2. 微调:使用Rectified Flow目标函数和模块化知识蒸馏(MKD)对齐中间特征,恢复生成质量。
- SVDtrunc包含两个阶段:重要性感知低秩压缩和微调。在重要性感知低秩压缩阶段,通过探测每个块单独压缩后的质量下降,利用CMMD指标对块进行重要性排序,并根据全局参数预算分配非均匀压缩率。
- 在微调阶段,使用Rectified Flow目标函数和模块化知识蒸馏(MKD)对齐中间特征,恢复生成质量。Rectified Flow目标函数确保压缩后的模型在生成过程中保持与原始模型的一致性,而MKD则通过对齐中间特征,进一步恢复生成质量。
- 重要性评估依赖于CMMD指标,该指标比LPIPS更稳定,能够更准确地量化块对生成质量的贡献。通过CMMD指标,SVDtrunc能够识别出对生成质量影响较小的块,并进行更激进的压缩,从而在保持生成质量的同时显著减少参数量。
- SVDtrunc的压缩策略是非均匀的,即不同块的压缩率不同。这种策略基于块的重要性排序,确保对生成质量影响较大的块保留更多的参数,而对生成质量影响较小的块进行更激进的压缩。这种非均匀的压缩策略使得SVDtrunc在保持生成质量的同时,能够显著减少参数量。
- SVDtrunc的微调过程需要大量GPU资源(H200),且不同压缩级别需要迭代训练。这一过程虽然计算成本较高,但能够确保压缩后的模型在生成质量上接近原始模型。
- SVDtrunc与时间蒸馏具有互补性,证明低秩容忍度在时间蒸馏后依然存在。这一发现表明,SVDtrunc可以与其他压缩方法结合使用,进一步提升压缩效果。
逐图理解论文
核心贡献
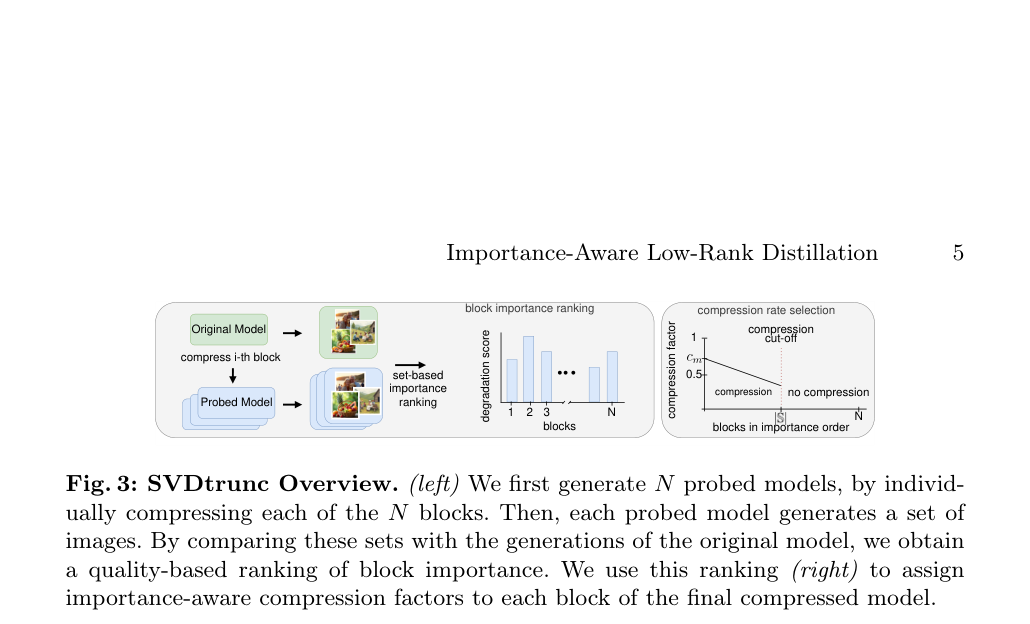
该图展示了SVDtrunc的整体流程。观察左侧的探测模型生成过程,可以发现每个块单独压缩后的质量下降情况。右侧的块重要性排序和压缩因子分配,展示了SVDtrunc如何根据块的重要性进行非均匀压缩。
最强结论
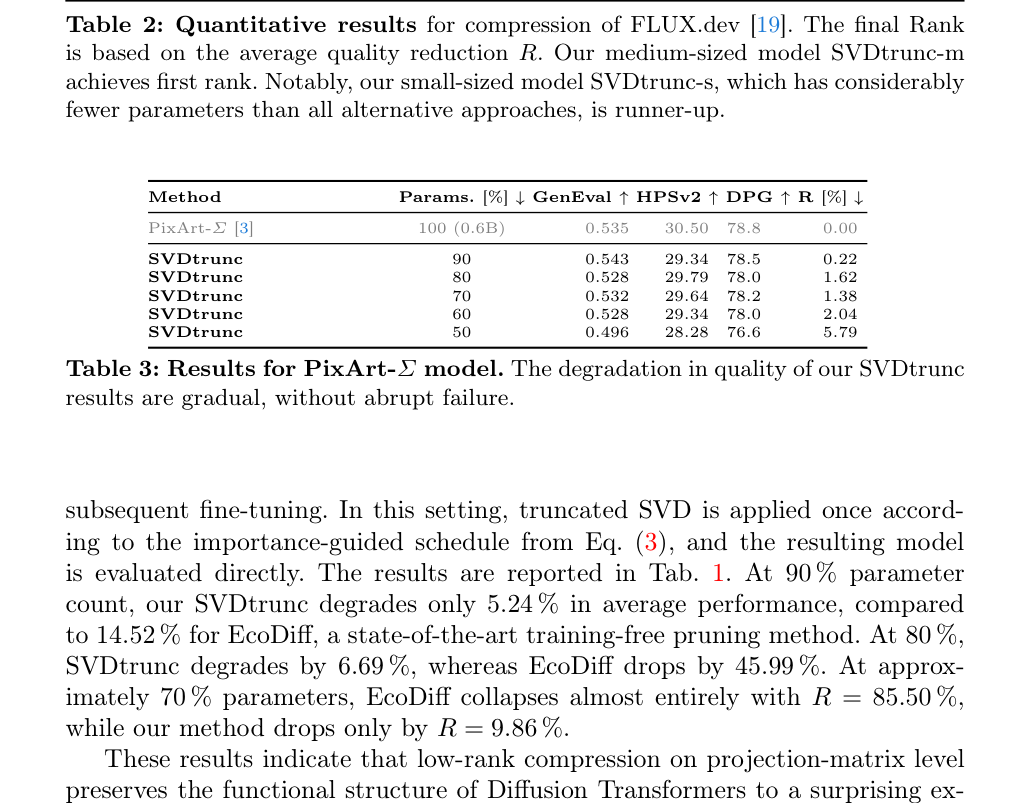
该表展示了FLUX.dev压缩的定量结果。观察SVDtrunc-m和SVDtrunc-s在不同参数预算下的质量下降情况,可以发现SVDtrunc-m在68%参数下表现最佳,而SVDtrunc-s在57%参数下表现次佳,表明SVDtrunc在不同压缩级别上均具有竞争力。
Fig
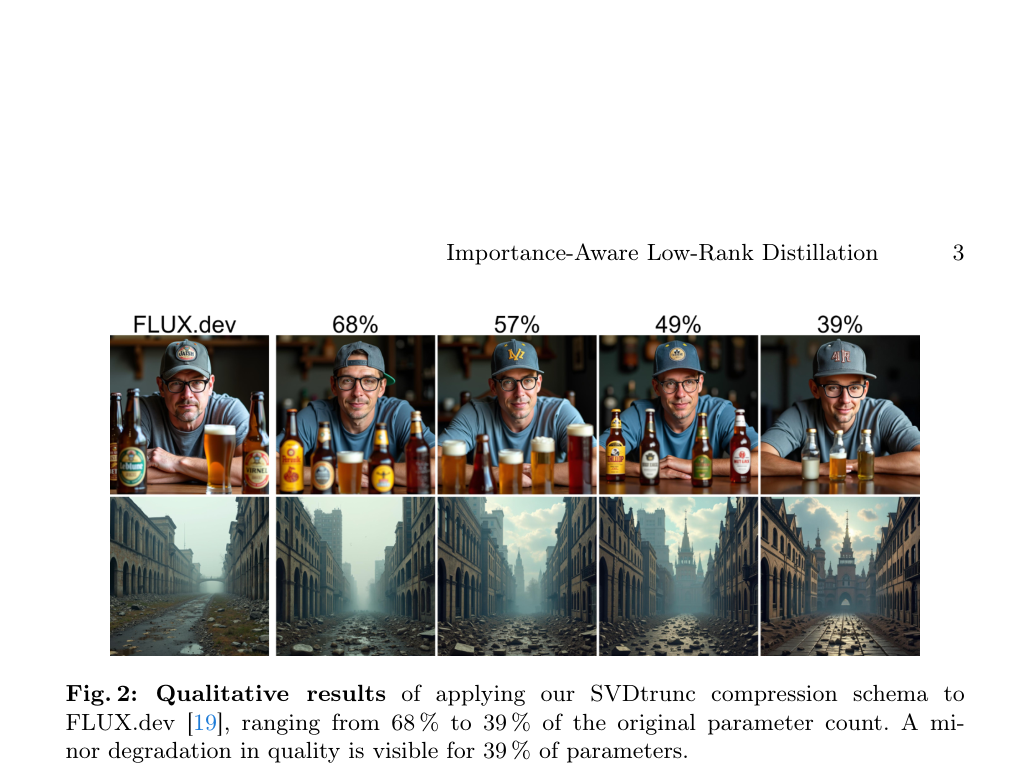
该图展示了FLUX.dev模型在应用SVDtrunc压缩方案后的定性结果对比。图像分为上下两行,每行包含五张生成图片,分别对应原始模型(FLUX.dev)和不同参数保留率(68%、57%、49%、39%)下的生成效果。上行为人物肖像,下行为城市街景。
实验如何设计?
- 实验在FLUX.dev (12B) 和 PixArt-Σ (0.6B) 上进行,压缩率从90%到39%。
- 对比方法包括EcoDiff, PPCL, FastFlux, TinyFusion, Dense2MoE等。
- 基准测试包括GenEval, HPSv2, DPG。
- 消融实验比较了均匀、随机和重要性感知分配策略,以及不同微调目标。
- 训练免费压缩实验验证了无微调情况下的鲁棒性。
关键结果与论文证据
- SVDtrunc-m (68% params) achieves R=0.75% average quality reduction, outperforming all competitors at same or larger budgets. (Page 11)
- SVDtrunc-s (57% params) achieves R=2.60% average quality reduction, ranking second overall despite having fewer parameters than all alternatives. (Page 11)
- Training-free at 70% params: SVDtrunc R=9.86% vs EcoDiff R=85.50% and Pruning R=94.52%. (Page 10)
- On PixArt-Σ (0.6B), SVDtrunc at 50% params shows R=5.79%, demonstrating graceful degradation on smaller models. (Page 11)
- On temporally-distilled FLUX.schnell, SVDtrunc at 60% params shows R=4.53%, confirming robustness after step distillation. (Page 14)
阅读时需要注意
- 在激进压缩(<50%参数)下,可能出现风格漂移(Domain Drift),生成图像向更写实风格偏移。
- 强压缩下会丢失对特定知名实体(如比萨斜塔、Bugs Bunny)的记忆能力,生成类似但非精确的图像。
- 低秩分解在轻微压缩时可能引入计算开销,尽管在强压缩下能降低推理时间。
关联工作
- EcoDiff: 对比方法,使用可微神经元掩码进行结构剪枝,在激进压缩下性能崩溃。 (Page 4)
- PPCL: 对比方法,通过连续层蒸馏进行块级剪枝,SVDtrunc在相同预算下表现更优。 (Page 4)
- SVD-LLM: 背景工作,指出LLM中朴素SVD压缩会导致灾难性失败,与DiT的鲁棒性形成对比。 (Page 4)
- FastFLUX: 对比方法,通过替换残差分支进行压缩,SVDtrunc保持架构完整性。 (Page 4)
- Dense2MoE: 对比方法,将DiT转换为MoE架构,SVDtrunc保持密集架构但减少参数。 (Page 4)