快速导读:本文提出 CARNIVAL 模型,利用 cryo-ET 前向模型生成的物理配对视图和模拟器提供的特权标签,在 LeJEPA 框架下训练对测量噪声不变的特征表示,在真实数据上的分类和检测任务中优于 TomoTwin。
Cryo-ET断层扫描受限于低剂量和有限倾斜角度,导致严重的测量退化,且真实数据中缺乏小分子和稀有蛋白的标注,难以通过监督学习直接训练模型。现有方法如TomoTwin使用模拟数据训练,但未利用前向模型产生的物理配对视图或模拟器提供的完整场景标签。
本文提出CARNIVAL模型,利用Cryo-ET前向模型生成的物理配对视图和模拟器提供的特权标签,在LeJEPA框架下训练对测量噪声不变的特征表示。该方法在真实数据上的分类和检测任务中优于TomoTwin,为Cryo-ET图像分析提供了新的自监督学习范式。
英文题目:The microscope is the mask: privileged views and labels from a cryo-ET forward model
论文出处:arXiv 每日论文精选 · arXiv:2609.04325
原始论文:PDF / 论文页面
这篇论文解决什么问题?
Cryo-ET用于在原生细胞环境中观察蛋白质复合物,但重建图像质量差。主要挑战包括:1) 测量退化:低剂量和有限倾斜角度导致missing wedge等严重退化;2) 标注稀缺:真实数据中缺乏小分子和稀有蛋白的标注,难以通过监督学习直接训练模型;3) 数据分布差异:模拟数据与真实数据之间存在分布差异,影响模型泛化能力。
现有方法如TomoTwin使用模拟数据训练,但未利用前向模型产生的物理配对视图或模拟器提供的完整场景标签。DINOv2等自监督学习方法使用随机掩码而非物理missing wedge,无法有效处理Cryo-ET特有的测量退化。CryoSIAM等其他使用模拟数据的方法也未使用前向模型配对视图。
核心创新
- 利用前向模型生成物理配对的干净与损坏视图,将 missing wedge 等测量退化作为不变性目标,而非简单的数据增强。
- 引入特权信息(privileged information),利用模拟器提供的蛋白质位置和身份标签构建 Lscene 损失,使语义信息在特征体积中局部化。
- 提出内容轴(content axis)和物理轴(physics axis)的双重不变性策略,分别处理背景/朝向变化和测量参数变化。
- 在 GPU 上实时生成模拟数据和损坏视图,支持大规模参数随机化(domain randomization),无需预存数据集。
方法概览
CARNIVAL 基于 LeJEPA 自监督学习框架,包含编码器 E、读出网络 F 和可选分割头 G。训练时生成三种视图:两个共享结构但背景不同的干净视图,一个改变蛋白质朝向的干净视图,以及通过前向模型 Ψθ 生成的对应损坏视图。损失函数包括视图不变性损失 Lview、场景身份损失 Lscene(利用蛋白质位置和身份标签)和分割损失 Lseg。
- CARNIVAL基于LeJEPA自监督学习框架,包含编码器E、读出网络F和可选分割头G。训练时生成三种视图:两个共享结构但背景不同的干净视图,一个改变蛋白质朝向的干净视图,以及通过前向模型Ψθ生成的对应损坏视图。
- 利用前向模型生成物理配对的干净与损坏视图,将missing wedge等测量退化作为不变性目标,而非简单的数据增强。前向模型参数包括tilt range、CTF、coloured noise等,每个模拟断层扫描独立采样参数值。
- 引入特权信息,利用模拟器提供的蛋白质位置和身份标签构建Lscene损失,使语义信息在特征体积中局部化。Lscene损失鼓励编码器在相同蛋白质位置生成相似特征,不同位置生成不同特征。
- 提出内容轴和物理轴的双重不变性策略,分别处理背景/朝向变化和测量参数变化。内容轴不变性通过Lview损失实现,物理轴不变性通过前向模型配对视图实现。
- 损失函数包括视图不变性损失Lview、场景身份损失Lscene和分割损失Lseg。Lview鼓励不同视图的特征相似,Lscene利用特权标签实现语义局部化,Lseg提供像素级监督信号。
- 在GPU上实时生成模拟数据和损坏视图,支持大规模参数随机化(domain randomization),无需预存数据集。这种实时生成策略提高了训练效率,并允许更广泛的参数采样。
逐图理解论文
失败案例
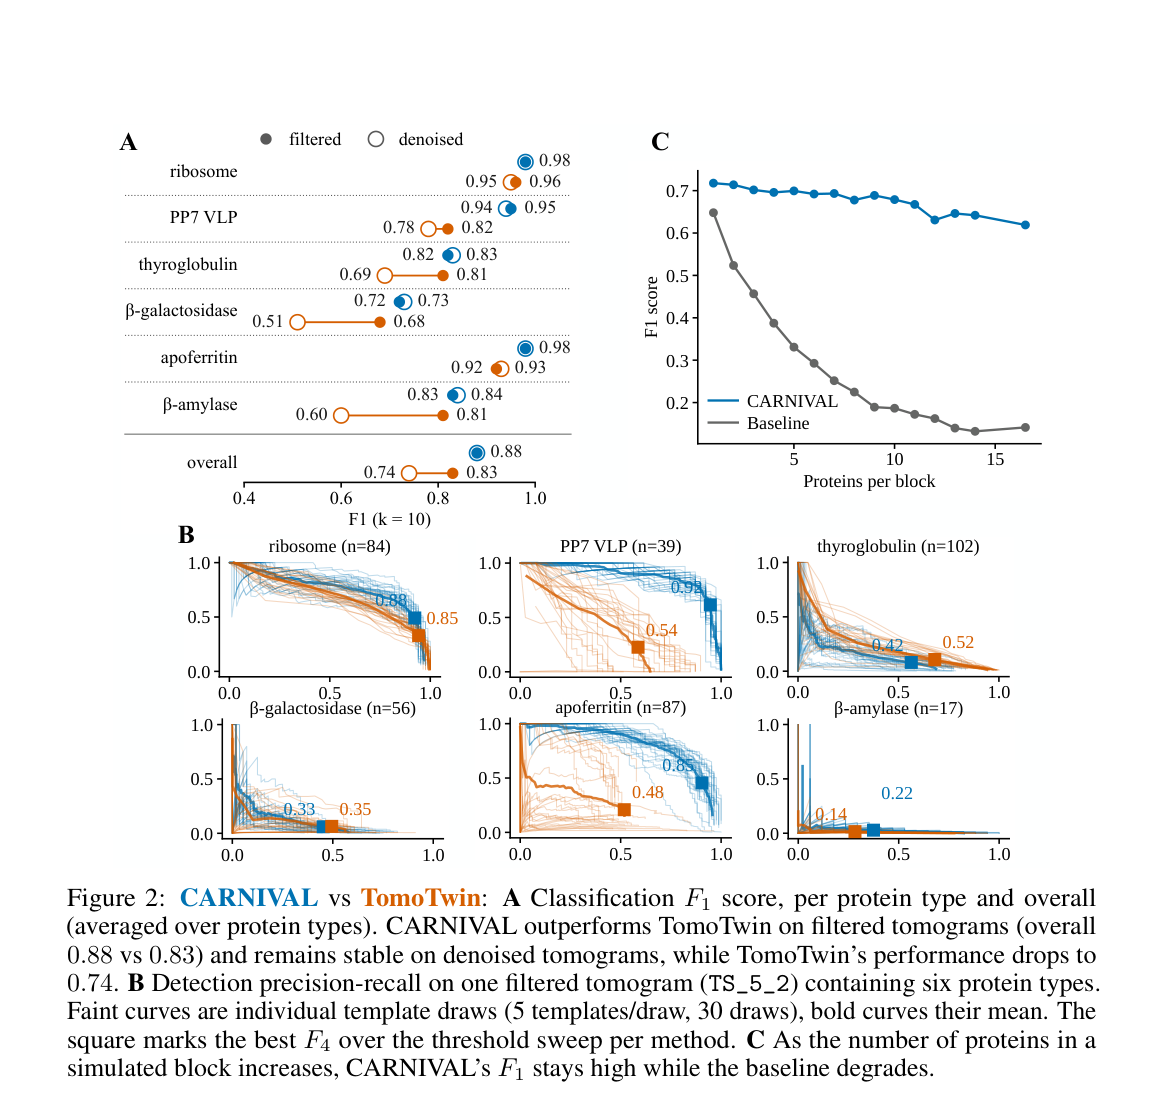
该图对比CARNIVAL和TomoTwin的性能。A部分显示分类F1分数,CARNIVAL在filtered和denoised断层扫描上均优于TomoTwin;B部分显示检测precision-recall曲线,CARNIVAL的曲线整体位于TomoTwin上方;C部分显示拥挤度实验,CARNIVAL的F1随蛋白质数量增加保持稳定,而基线性能下降。此图综合展示了CARNIVAL在分类、检测和拥挤场景下的优势。
核心贡献
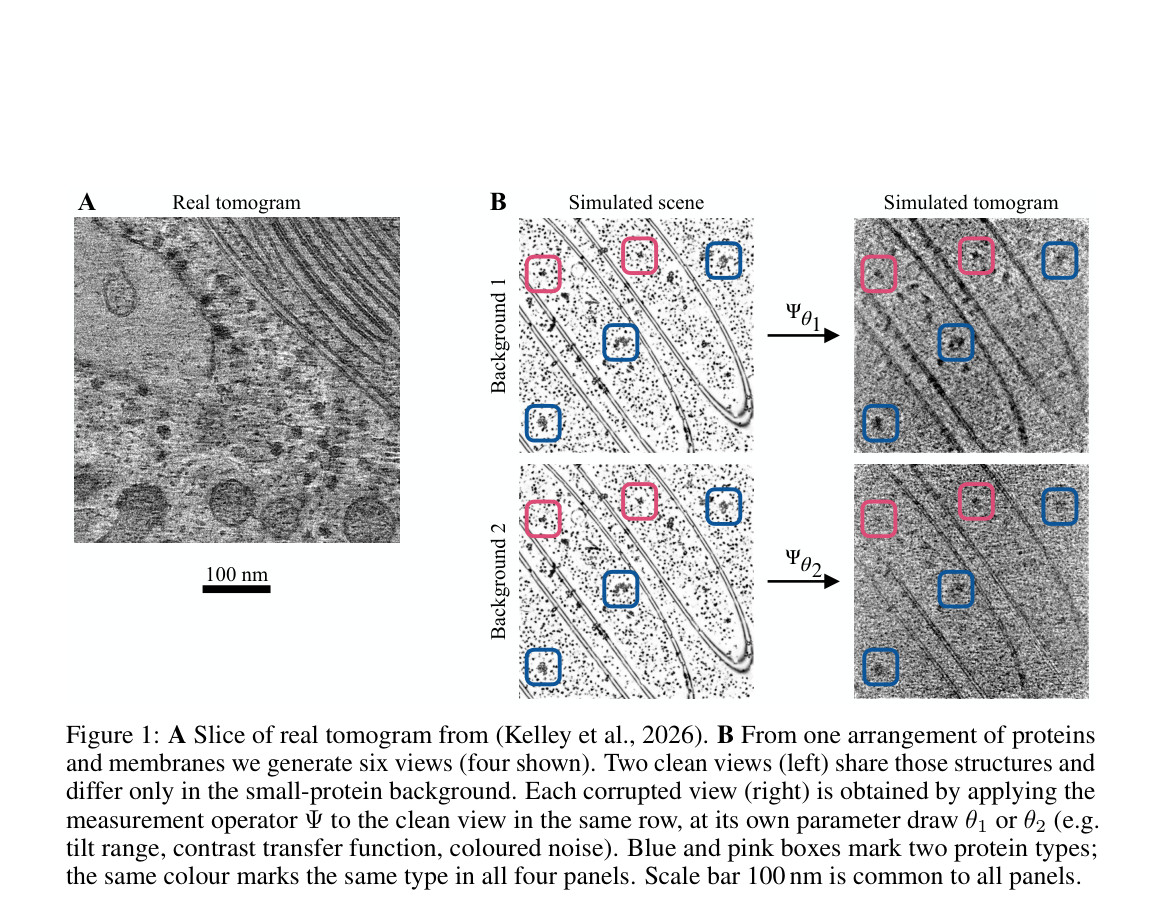
该图展示了从同一蛋白质和膜排列生成的六个视图(显示四个)。左侧两个干净视图共享结构但小蛋白背景不同;右侧损坏视图通过应用测量算子Ψ生成,参数θ1或θ2独立采样(如tilt range、CTF、coloured noise)。蓝粉框标记两种蛋白质类型,相同颜色表示相同类型。此图直观展示了物理配对视图的生成过程,是理解CARNIVAL核心创新的关键。
Figure 3: Model architecture
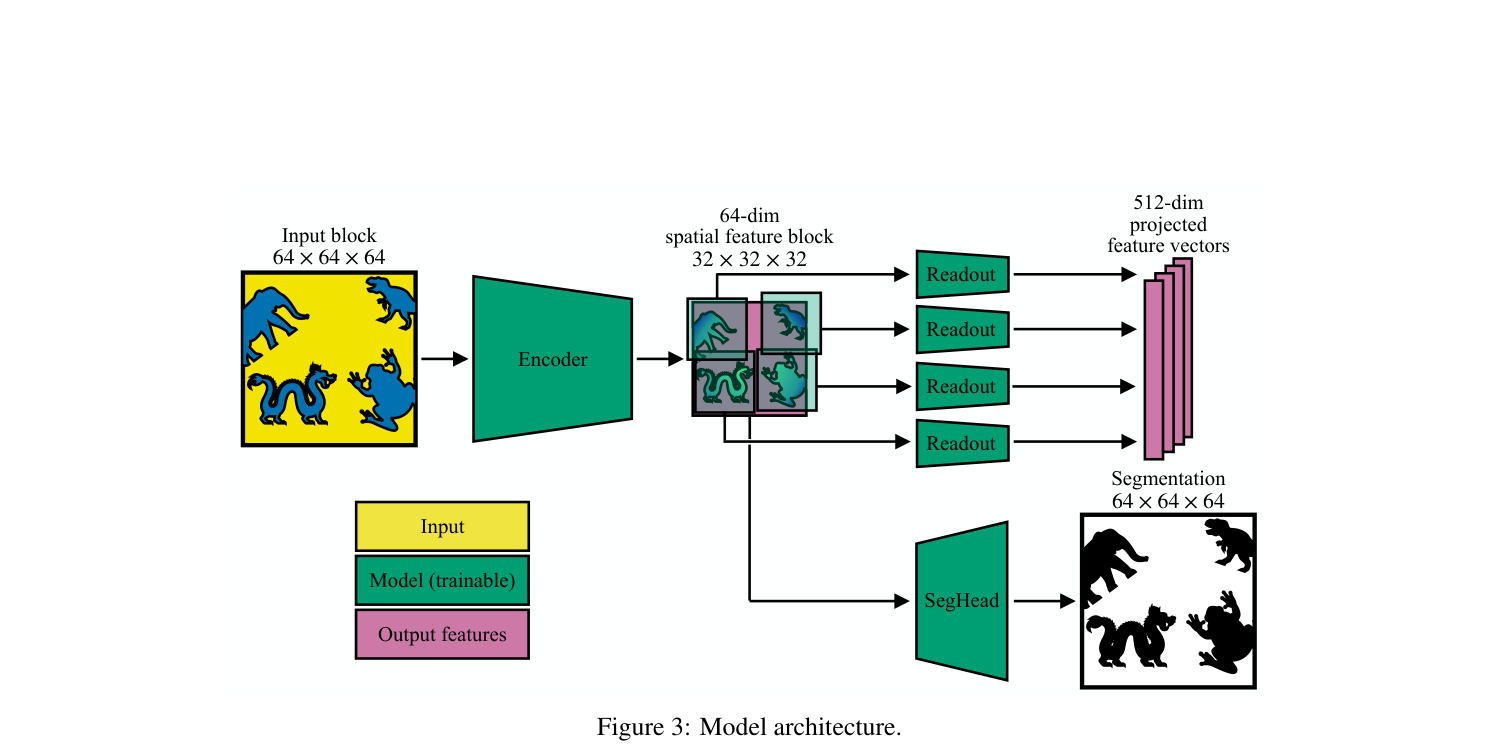
该图展示了CARNIVAL的模型架构,包括编码器E、读出网络F和可选分割头G。编码器处理输入断层扫描生成特征表示,读出网络预测蛋白质类型和位置,分割头提供像素级监督。此图帮助理解CARNIVAL的网络结构和各组件的功能。
实验如何设计?
- 在CZII CryoET Object Identification challenge的公开测试集上评估分类和检测性能,测试集包含121个真实断层扫描,6种蛋白质类型,32,722个实例。
- 分类实验使用k=10最近邻分类,报告F1分数,比较filtered和denoised两种处理条件下的表现。
- 检测实验在三个不同组成的断层扫描上评估,使用F4分数(权重偏向recall),通过阈值扫描和模板抽样(30次,每次5个模板)计算precision-recall曲线。
- 拥挤度实验在模拟数据上测试不同蛋白质密度下的分类性能,验证Lscene损失对高密度场景的鲁棒性。
关键结果与论文证据
- 分类实验:CARNIVAL在filtered断层扫描上overall F1为0.88,TomoTwin为0.83;在denoised断层扫描上CARNIVAL保持0.88,而TomoTwin降至0.74(第4页)。
- 检测实验:在TS_5_2断层扫描上,CARNIVAL的weighted mean F4为0.508(filtered)和0.529(denoised),显著优于TomoTwin的0.431和0.410(第5页)。
- 在TS_14_1断层扫描上,CARNIVAL的F4为0.389,TomoTwin为0.311;在TS_43_9断层扫描上,CARNIVAL为0.542,TomoTwin为0.437(第5页)。
- VLP检测F4:CARNIVAL为0.92±0.02,TomoTwin为0.54±0.22;Apoferritin检测F4:CARNIVAL为0.85±0.13,TomoTwin为0.48±0.10(第5页)。
- 拥挤度实验:随着模拟块中蛋白质数量增加,CARNIVAL的F1保持高位,而基线性能下降(第5页)。
阅读时需要注意
- 覆盖范围策略无法应对前向模型未捕捉到的真实数据变化维度,仅能保护参数设置错误。
- 部分退化轴(如辐射损伤和噪声颜色)是经验近似,可能导致过度不变性,丢弃测量中仍携带的变异信息。
- 模型仅在112个PDB ID(>100kDa)上训练,未覆盖更广泛的蛋白质库。
- 检测实验中的F4分数是阈值扫描的上界,实际部署时无法获得该最优阈值。
关联工作
- TomoTwin:主要对比基线,使用模拟数据训练但未利用前向模型配对视图或特权信息(第4页)。
- LeJEPA:CARNIVAL的自监督学习框架基础(第2页)。
- DINOv2:对比的自监督学习方法,使用随机掩码而非物理missing wedge(第2页)。
- Domain Randomization:CARNIVAL的参数随机化策略借鉴自该领域,但用于生成不变性目标而非仅输入多样性(第3页)。
- CryoSIAM:其他使用模拟数据的Cryo-ET表示学习方法,但未使用前向模型配对视图(第10页)。