快速导读:本文提出了一种基于逐步稀疏自编码器(step-wise SAE)的可解释性框架,用于诊断和修正文本到图像扩散模型中特定对象导致的概念实现失败(object-dependent concept brittleness),通过在推理时向类原型插值来恢复缺失的风格或属性证据。
文本到图像扩散模型在大多数提示词下能正确实现目标概念,但在仅对象不同而语义相近的少量提示词上会系统性失败。这种现象被称为对象依赖概念脆弱性,它揭示了模型内部表示的结构性盲区。本文提出了一种基于逐步稀疏自编码器的可解释性框架,用于诊断和修正这种失败模式。
英文题目:Interpreting Object-Dependent Concept Brittleness in Text-to-Image Diffusion Models
论文出处:arXiv 每日论文精选 · arXiv:2609.09909
原始论文:PDF / 论文页面
这篇论文解决什么问题?
传统的注意力归因或局部空间定位方法难以捕捉这种全局性、过程依赖的概念失败。原始去噪特征空间中内容、风格和属性高度纠缠,导致成功与失败样本难以区分。稀疏自编码器能够将密集激活映射为稀疏潜在表示,有助于解耦概念证据。
核心创新
- 定义了对象依赖概念脆弱性(object-dependent concept brittleness)这一新的失败模式,并指出其源于内部表示的系统性盲区而非随机噪声。
- 提出了逐步稀疏自编码器(step-wise SAE)框架,发现深层去噪特征在稀疏空间中具有更清晰的概念结构,且成功与失败轨迹在稀疏维度上存在显著差异。
- 设计了轻量级的推理时修正策略(Prototype-Guided Correction),通过在SAE空间中向类原型插值来恢复缺失的概念证据,验证了诊断出的稀疏差异与最终生成结果的功能相关性。
方法概览
1. 逐步SAE表示:为每个去噪时间步训练独立的Top-K SAE,将去噪特征映射到时间步特定的稀疏空间,以增强概念证据的可分离性。
2. 概念脆弱性诊断:在稀疏空间中计算样本与类均值的偏差,过滤不一致样本以构建可靠的类条件稀疏原型(class-conditioned sparse prototypes)。
3. 原型引导修正:在推理早期阶段(Early Only),将当前去噪特征在SAE空间中向目标类原型进行插值(Interpolation SAE Module, ISM),从而在不重新训练模型的情况下修正概念实现。
- 为每个去噪时间步训练独立的Top-K稀疏自编码器,将去噪特征映射到时间步特定的稀疏空间,以增强概念证据的可分离性。
- 在稀疏空间中计算样本与类均值的偏差,过滤不一致样本以构建可靠的类条件稀疏原型。
- 在推理早期阶段,将当前去噪特征在稀疏自编码器空间中向目标类原型进行插值,从而在不重新训练模型的情况下修正概念实现。
- 通过比较不同表示层和干预时间窗口,确认早期去噪步骤具有最高的修正杠杆率,且稀疏空间干预比原始空间干预更有效。
逐图理解论文
失败案例
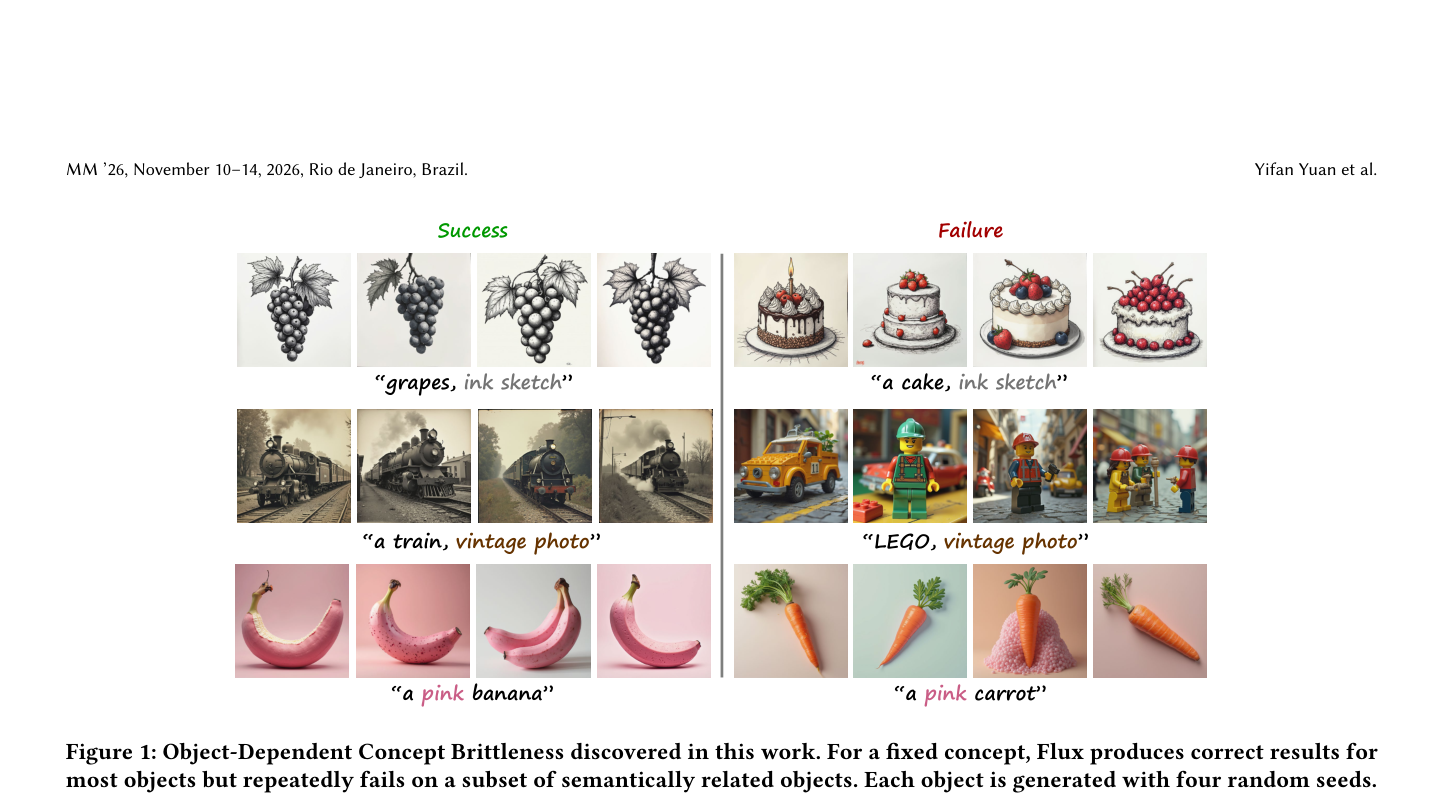
该图展示了对象依赖概念脆弱性的具体表现。对于固定概念,Flux在大多数对象上生成正确结果,但在少数语义相关对象上反复失败。每个对象使用四个随机种子生成,以排除随机噪声的影响。
核心贡献
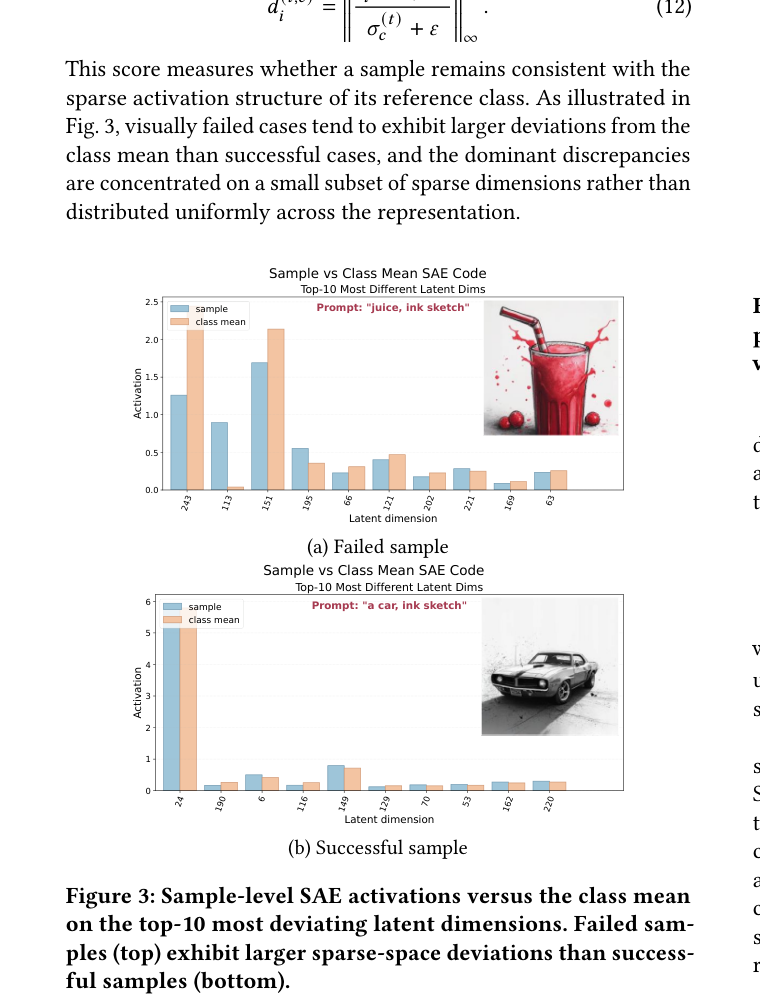
该图比较了成功与失败样本在稀疏自编码器空间中的激活模式。失败样本在稀疏维度上表现出更大的偏差,表明概念失败源于稀疏空间中的结构化偏差。
修正策略
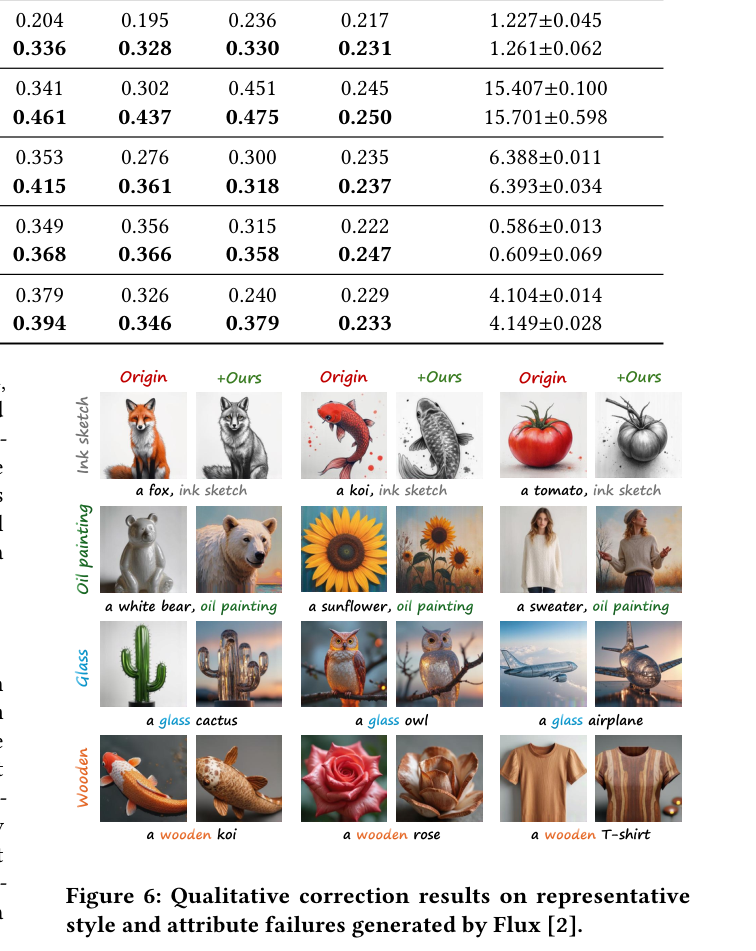
该图展示了风格生成和属性控制任务的定性修正结果。修正后的图像在目标风格或属性上表现出更清晰的表达,同时保留了原始图像的内容布局。
实验如何设计?
- 在5个主流扩散模型骨干上评估了风格生成和属性控制任务。
- 比较了不同表示层(Noise Latent, Last Single/Double DiT Layer)的概念分离能力和修正效果。
- 分析了干预时间窗口(Early, Middle, Late)对修正效果的影响,确认早期去噪步骤具有最高的修正杠杆率。
- 进行了定性分析,展示了对风格(如ink sketch)和属性(如color, material)失败的修正效果。
关键结果与论文证据
- 在Flux.1-dev上,修正后的CLIP-I达到0.623,CLIP-T达到0.288,Style Align.达到0.230,显著优于基线模型。
- Noise Latent表示在概念分离能力上表现最佳,Acc达到0.7648,Sep达到1.8479,优于Last Double DiT Layer。
- Early Only干预窗口在Style Alignment上达到0.230,FID为293.3,优于All Steps干预窗口。
- 定性结果表明,稀疏空间干预能更可靠地恢复目标风格或属性,同时保留原始图像的内容布局。
阅读时需要注意
- 实验主要在256×256分辨率下进行,未验证在更高分辨率下的有效性。
- 修正策略依赖于预构建的类原型,对于极度罕见或未见过的概念类别可能效果有限。
- 虽然推理时间增加可忽略,但训练逐步稀疏自编码器需要额外的计算资源。
关联工作
- DAAM使用交叉注意力进行空间定位,但难以捕捉全局风格失败。
- SAeUron使用稀疏自编码器进行概念遗忘,本文使用稀疏自编码器进行概念诊断和修正。
- Tinaz et al.研究扩散模型中概念演化和阶段依赖引导,本文关注对象依赖的概念脆弱性。
- PCI研究概念动态和可编辑性,本文聚焦于成功与失败案例的差异诊断。