VLA-ACL:用动作一致性学习给视觉语言动作模型剪视觉 token
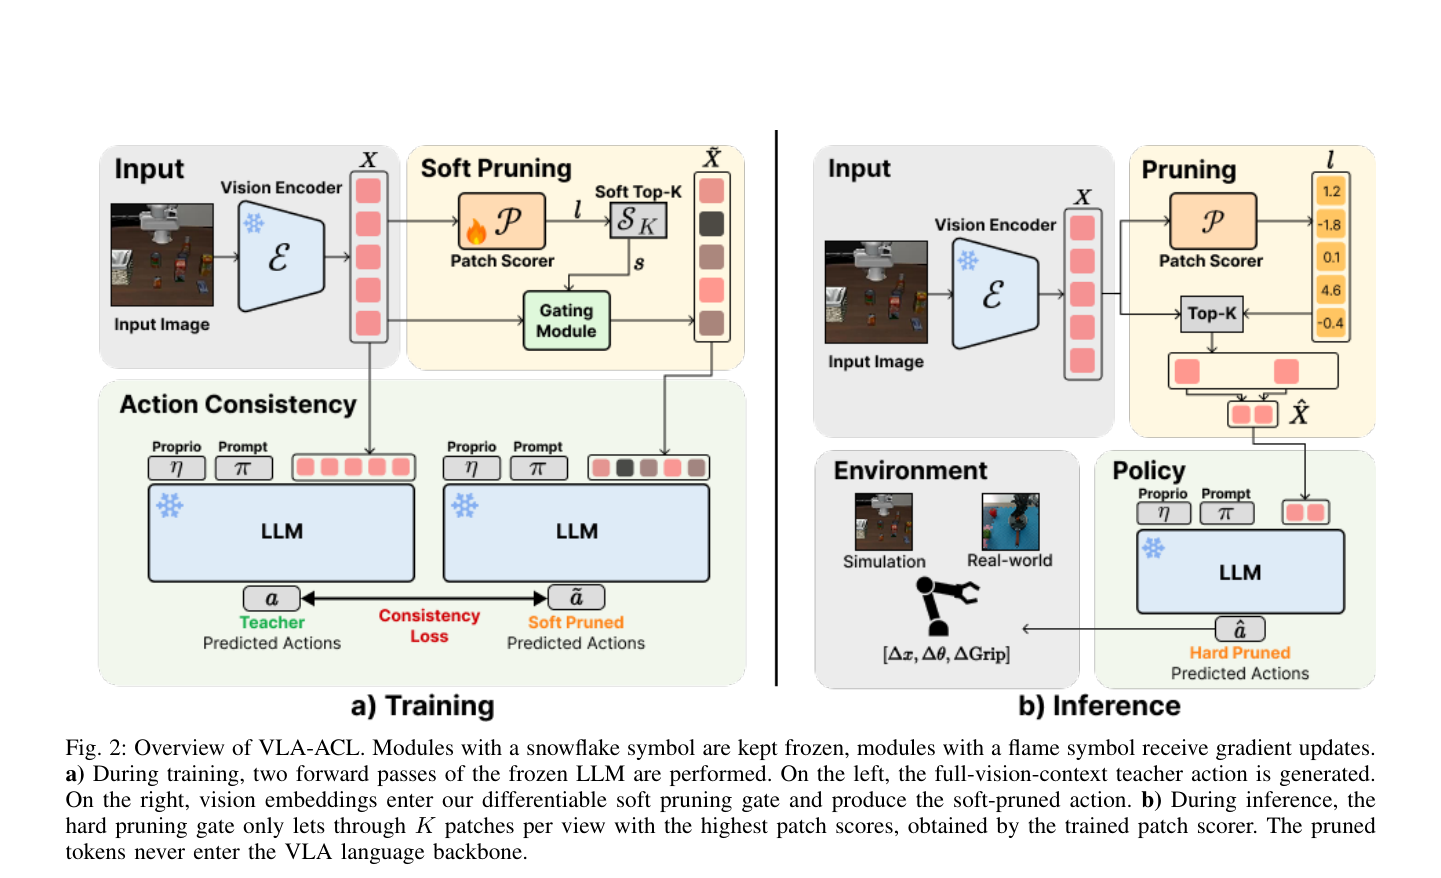
VLA-ACL 在冻结视觉语言动作骨干上训练轻量 patch 打分器,让剪枝后的动作跟上全上下文教师,从而大幅丢掉视觉 token。
VLA-ACL 在冻结视觉语言动作骨干上训练轻量 patch 打分器,让剪枝后的动作跟上全上下文教师,从而大幅丢掉视觉 token。
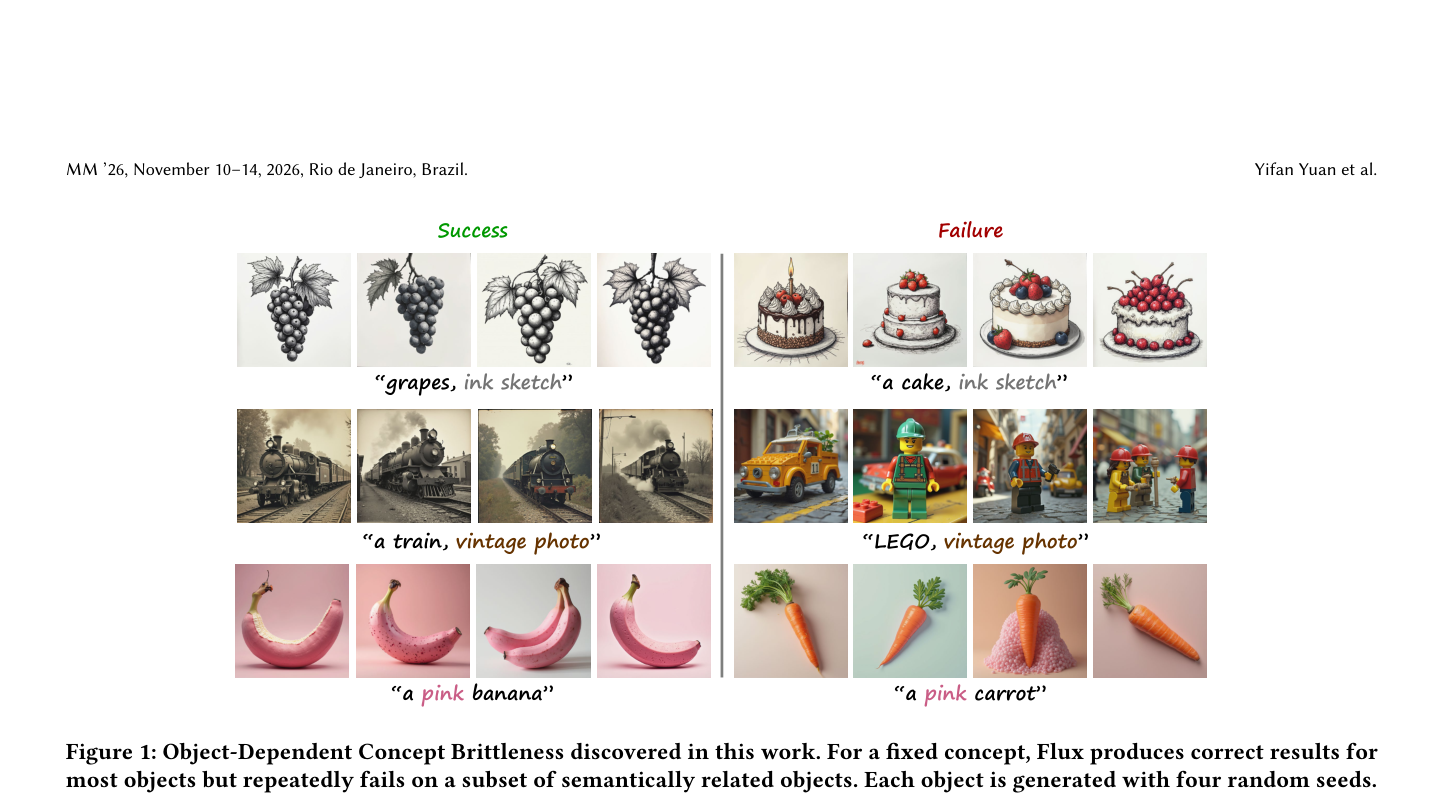
本文提出了一种基于逐步稀疏自编码器(step-wise SAE)的可解释性框架,用于诊断和修正文本到图像扩散模型中特定对象导致的概念实现失败(object-dependent concept brittleness),通过在推理时向类原型插值来恢复缺失的风格或属性证据。
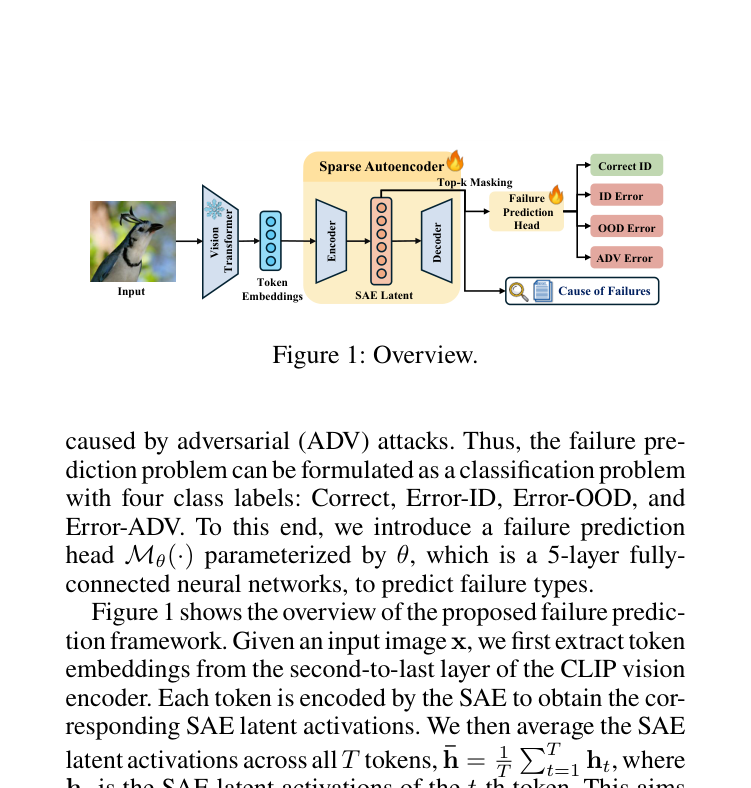
本文提出 FailSAE,一种基于稀疏自编码器(SAE)的三阶段故障感知训练框架,通过解耦 VLM 内部表示为稀疏概念方向,实现了比现有基线更准确且具备概念级可解释性的故障预测。
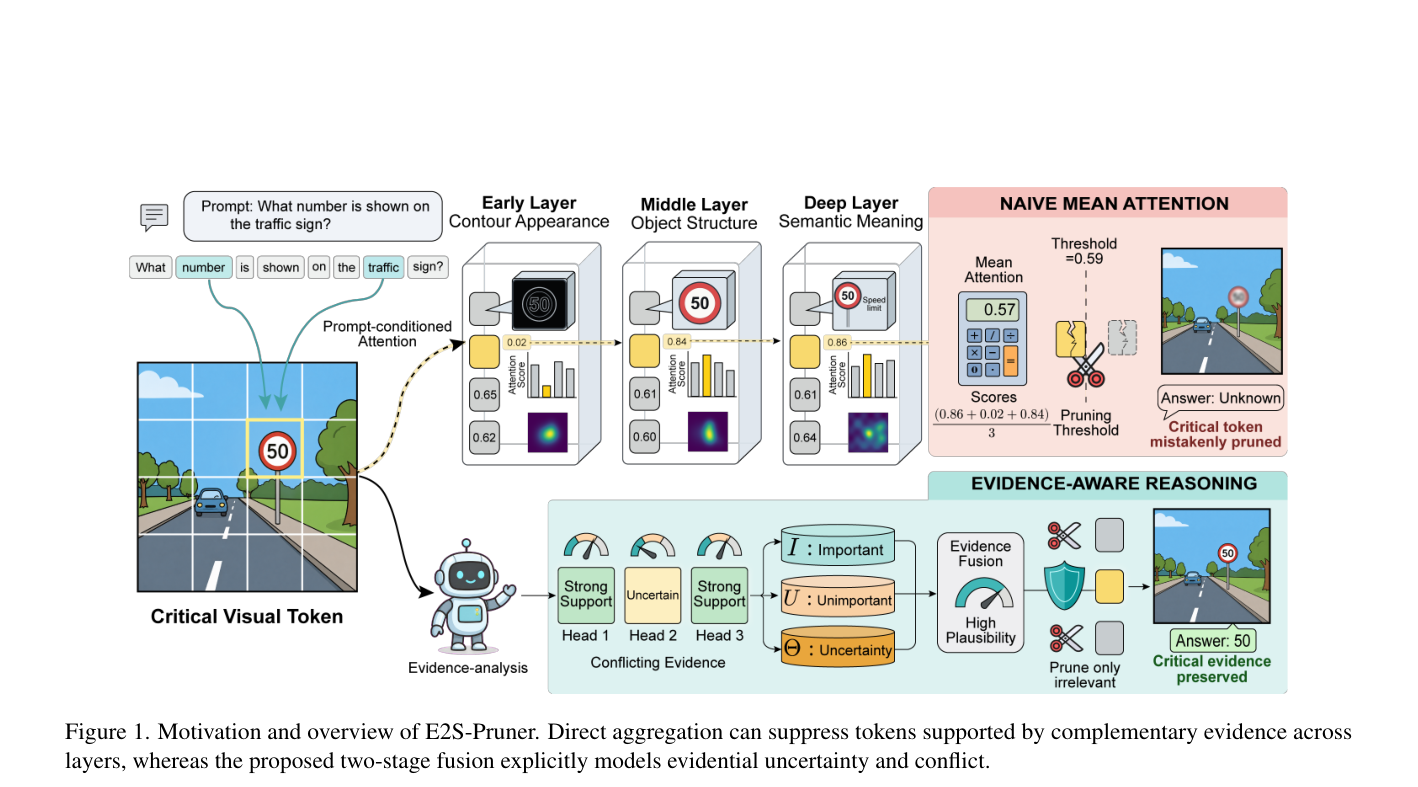
E2S-Pruner 将 Dempster–Shafer 证据理论引入视觉 token 剪枝,通过注意力头级可靠性建模、层级证据递归融合和空间新颖性正则,在无需训练的前提下实现视觉 token 的高效剪枝。