快速导读:提出了一种免训练的视觉证据接口 World in World (WiW),通过原生自注意力机制将异构控制证据(源视频、投影、几何、历史)转化为冻结因果视频世界模型可读取的干净视觉状态,实现灵活且一致的长时程视频重渲染与探索。
World in World (WiW) 提出了一种免训练的视觉证据接口,旨在解决现有视频世界模型在支持灵活控制时依赖任务特定模块或额外训练的问题。
通过将异构控制证据转化为冻结因果视频模型可读取的干净视觉状态,WiW 实现了灵活且一致的长时程视频重渲染与探索,无需模型适配。
英文题目:World in World: Explore the World with World Models
论文出处:arXiv 每日论文精选 · arXiv:2609.11548
原始论文:PDF / 论文页面
这篇论文解决什么问题?
自回归视频世界模型支持交互式长时程探索,但扩展其控制能力通常需要重新训练或设计特定的条件路径。
作者观察到,因果视频模型的原生自注意力机制已经是一个共享的视觉信息入口,可以通过将外部控制信息转换为带有相机和时间标签的干净视觉状态来利用这一机制。
现有的视频世界模型在支持灵活控制(如从新视角探索源视频、补全新暴露区域、长时程一致性)时,通常缺乏统一的接口来整合异构的视觉证据。
WiW 的核心假设是,通过将外部控制信息转换为干净视觉状态,可以避免模型适配,同时保持生成质量的一致性。
核心创新
- 提出免训练的视觉证据接口,将异构控制信号统一为冻结模型可读取的干净视觉状态。
- 开发互补的视觉证据构建方法,包括目标视图投影、几何渲染和历史检索。
- 引入 CGAR 和 EWA 机制,在原生自注意力中实现证据的精准定位和强度调节,且 EWA 不增加额外的网络前向传播(NFE)。
- 在单一冻结骨干网络上实现了相机控制重渲染、子弹时间、视频稳定、编辑及跨模型 K/V 共享等多种应用。
方法概览
WiW 框架包含四个主要部分:1) 共享证据接口,将源视频观察、目标视图投影、渲染几何和生成历史转换为带有相机/时间/空间有效性信息的干净 K/V 特征;2) 目标视图场景证据,利用深度投影提供空间布局参考;3) 渲染几何证据,利用 LHM++ 和 SMPL-X 补全新暴露的主体表面;4) 检索生成证据,从滚动缓存外的历史库中检索相关状态以维持长时程一致性。此外,引入 CGAR(对应引导注意力路由)和 EWA(证据级注意力 CFG)来定位和调节证据的影响。
- 共享证据接口:将源视频观察、目标视图投影、渲染几何和生成历史转换为带有相机/时间/空间有效性信息的干净 K/V 特征。
- 目标视图场景证据:利用深度投影提供空间布局参考,帮助模型在新视角下保持场景结构一致性。
- 渲染几何证据:利用 LHM++ 和 SMPL-X 补全新暴露的主体表面,确保人体或物体在新视角下的几何完整性。
- 检索生成证据:从滚动缓存外的历史库中检索相关状态以维持长时程一致性,避免重复生成时的外观漂移。
- CGAR(对应引导注意力路由):通过持久点身份跟踪,将查询连接到匹配的源视频 token,实现证据的精准定位。
- EWA(证据级注意力 CFG):调节每个证据通道的额外贡献,且不增加额外的网络前向传播(NFE),保持推理效率。
- 滚动缓存机制:临时证据块在每个 chunk 后移除,最终化输出进入滚动缓存,其视觉特征在驱逐后归档,支持长时程探索。
- 跨模型 K/V 共享:不同生成实例可通过共享缓存的 K/V 作为视觉证据进行通信,实现跨模型的一致性控制。
逐图理解论文
失败案例
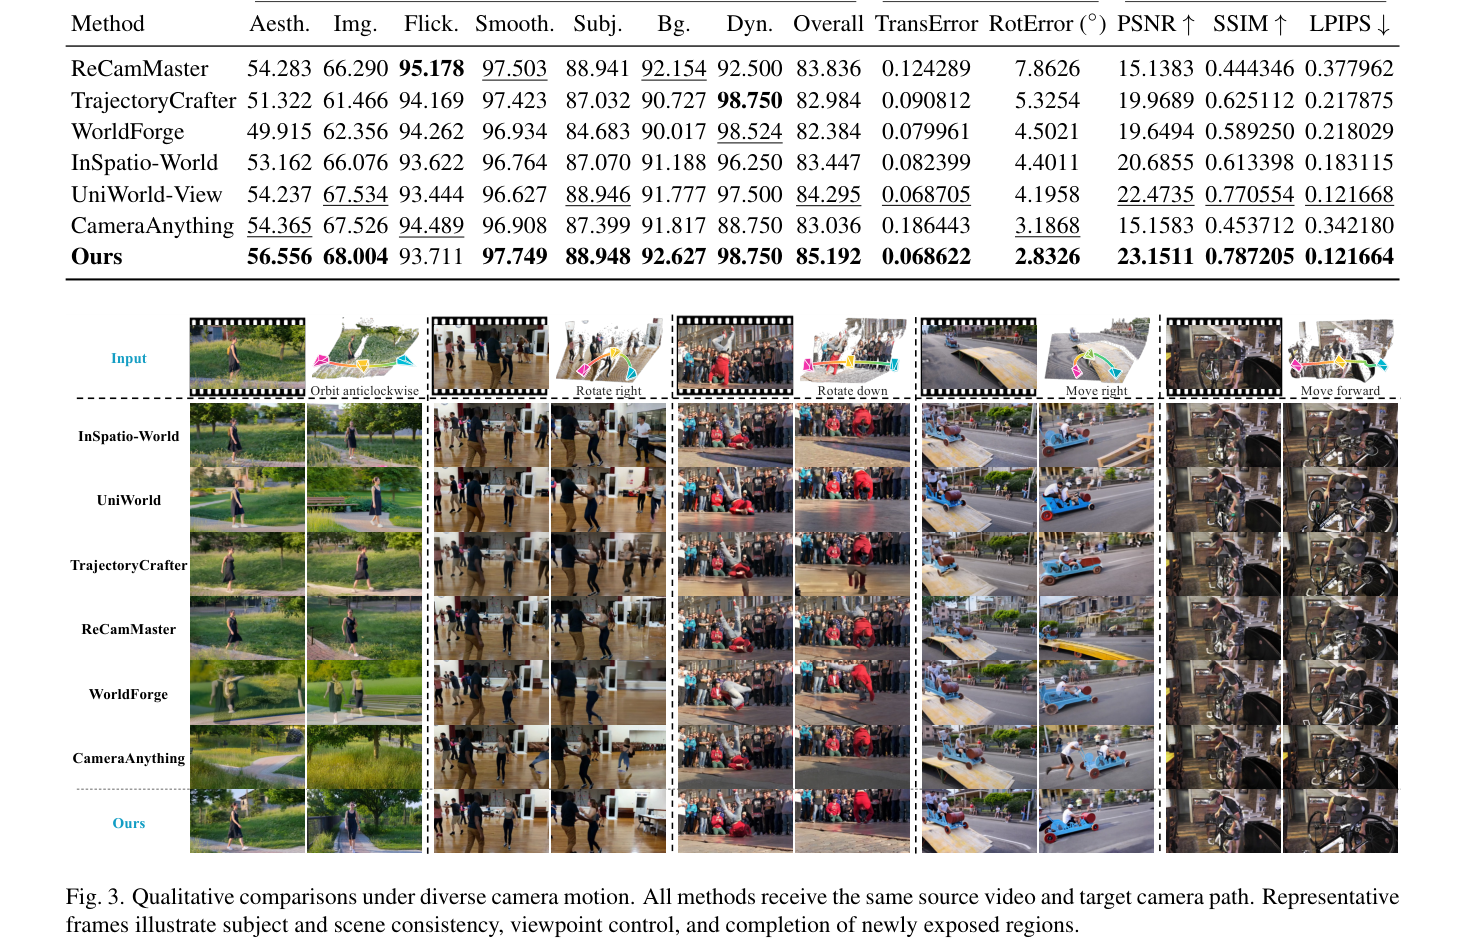
该图展示了不同相机运动下的定性比较。检查各方法在主体和场景一致性、视角控制和新暴露区域补全方面的表现,理解 WiW 在复杂视角变化下的优势。
研究缺口
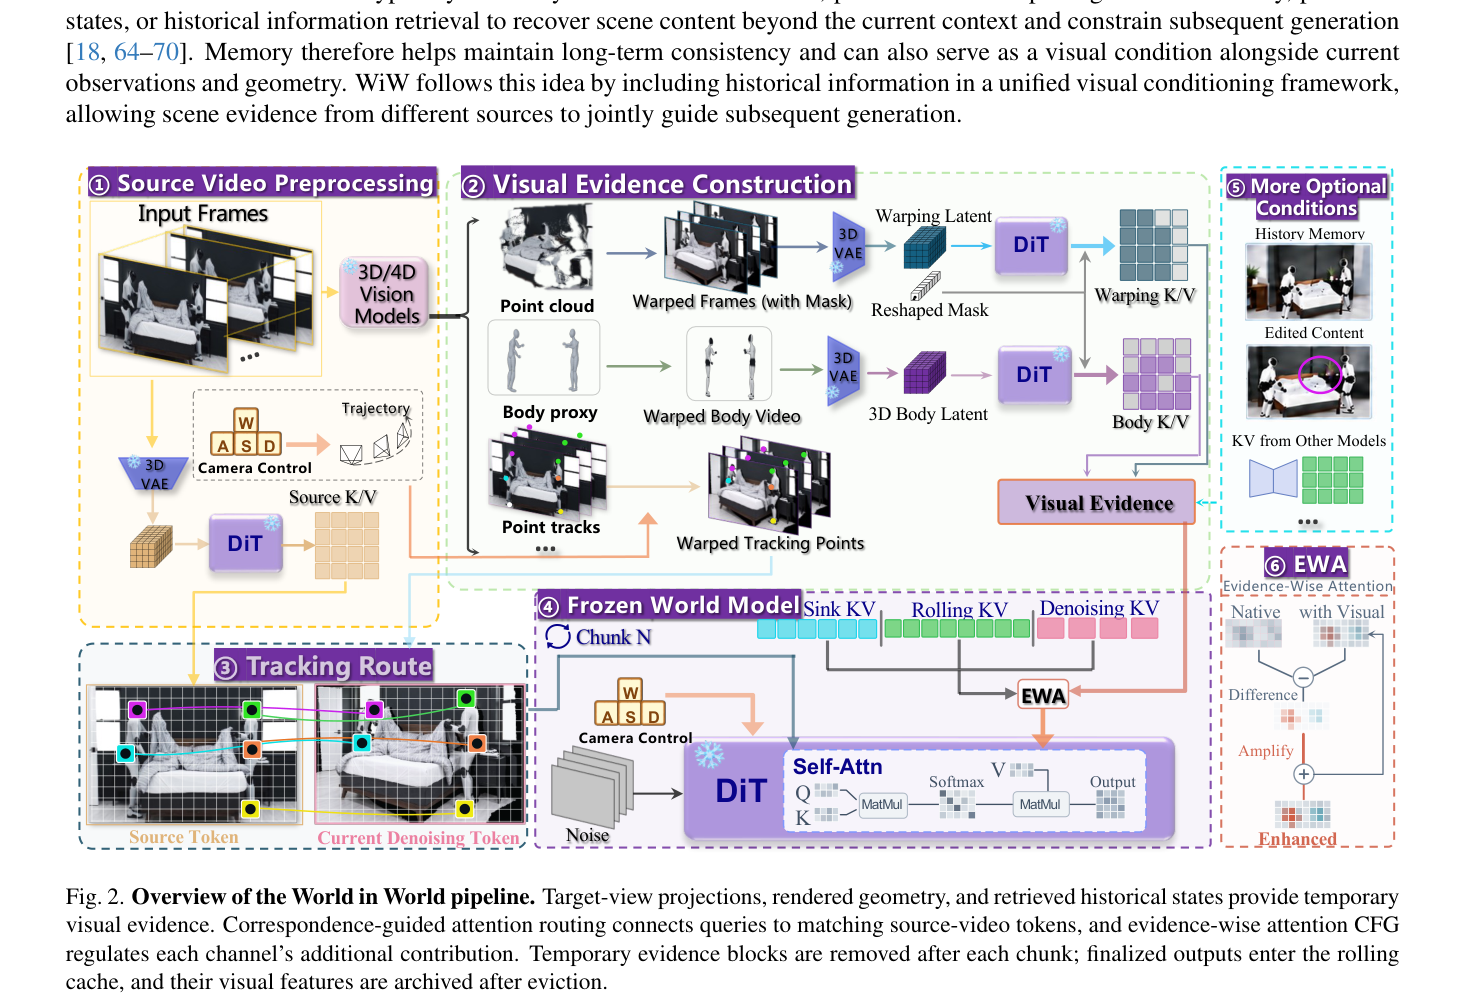
该图总结了 WiW 的整体流水线。检查目标视图投影、渲染几何和检索历史状态如何提供临时视觉证据,以及 CGAR 和 EWA 如何连接查询并调节证据贡献。
核心贡献
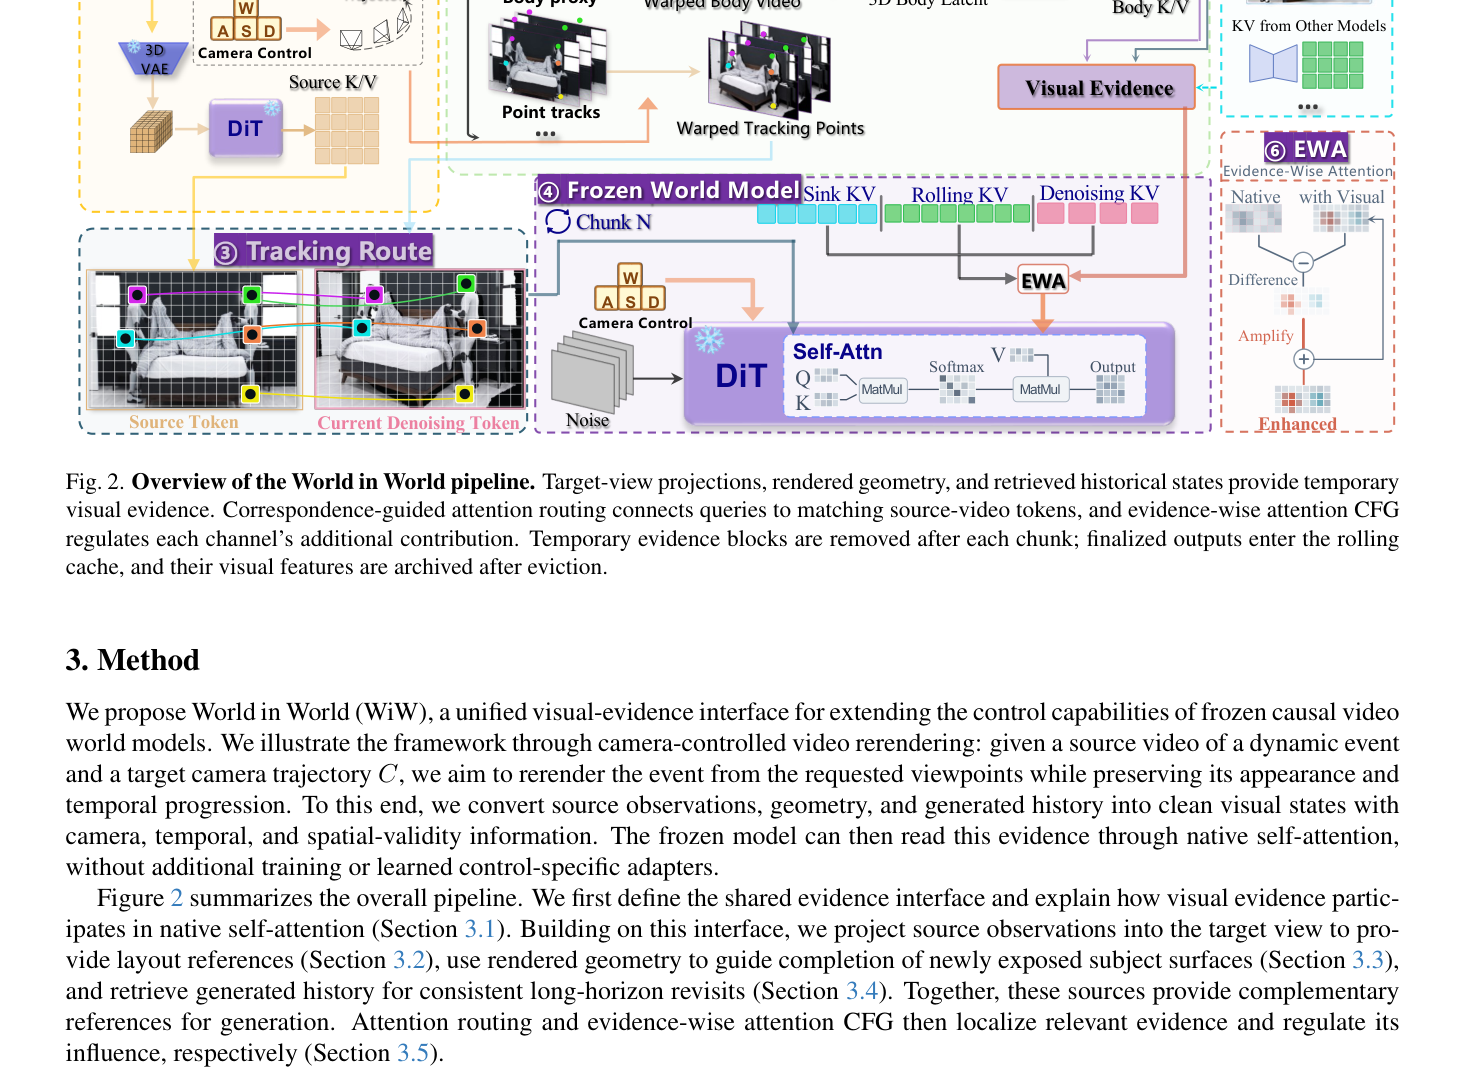
该图详细说明了共享证据接口和视觉证据参与原生自注意力的方式。检查各证据源(投影、几何、历史)如何转化为干净 K/V 特征,以及注意力路由和 EWA 如何定位和调节证据影响。
最强结论
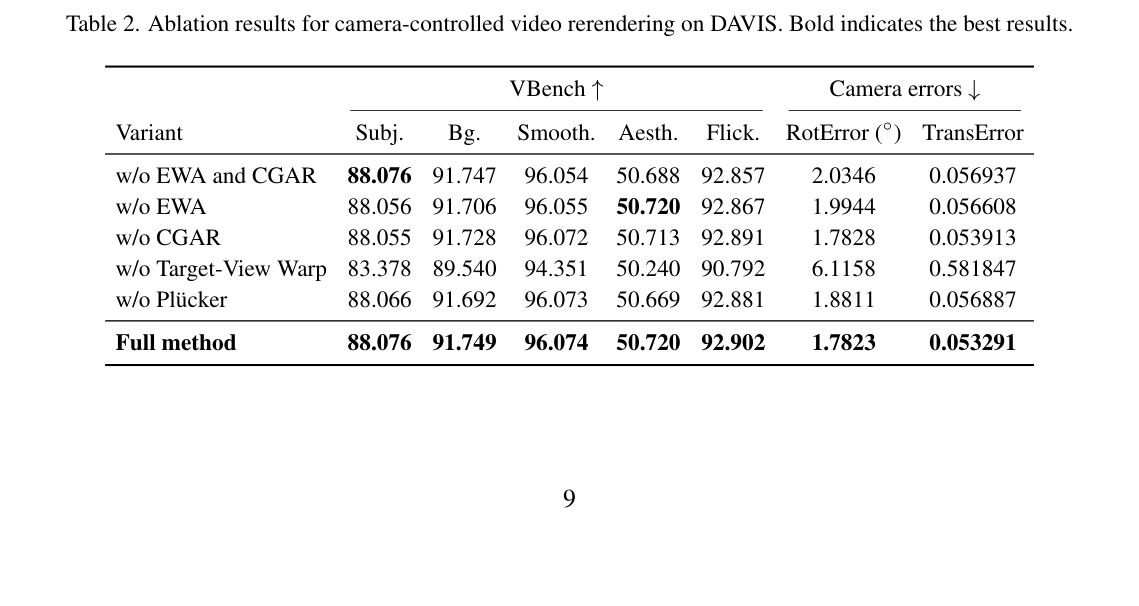
该表报告了 DAVIS 上相机控制视频重渲染的消融结果。检查移除各组件(EWA, CGAR, Target-View Warp, Plücker conditioning)对性能的影响,理解各模块的贡献。
意义与局限
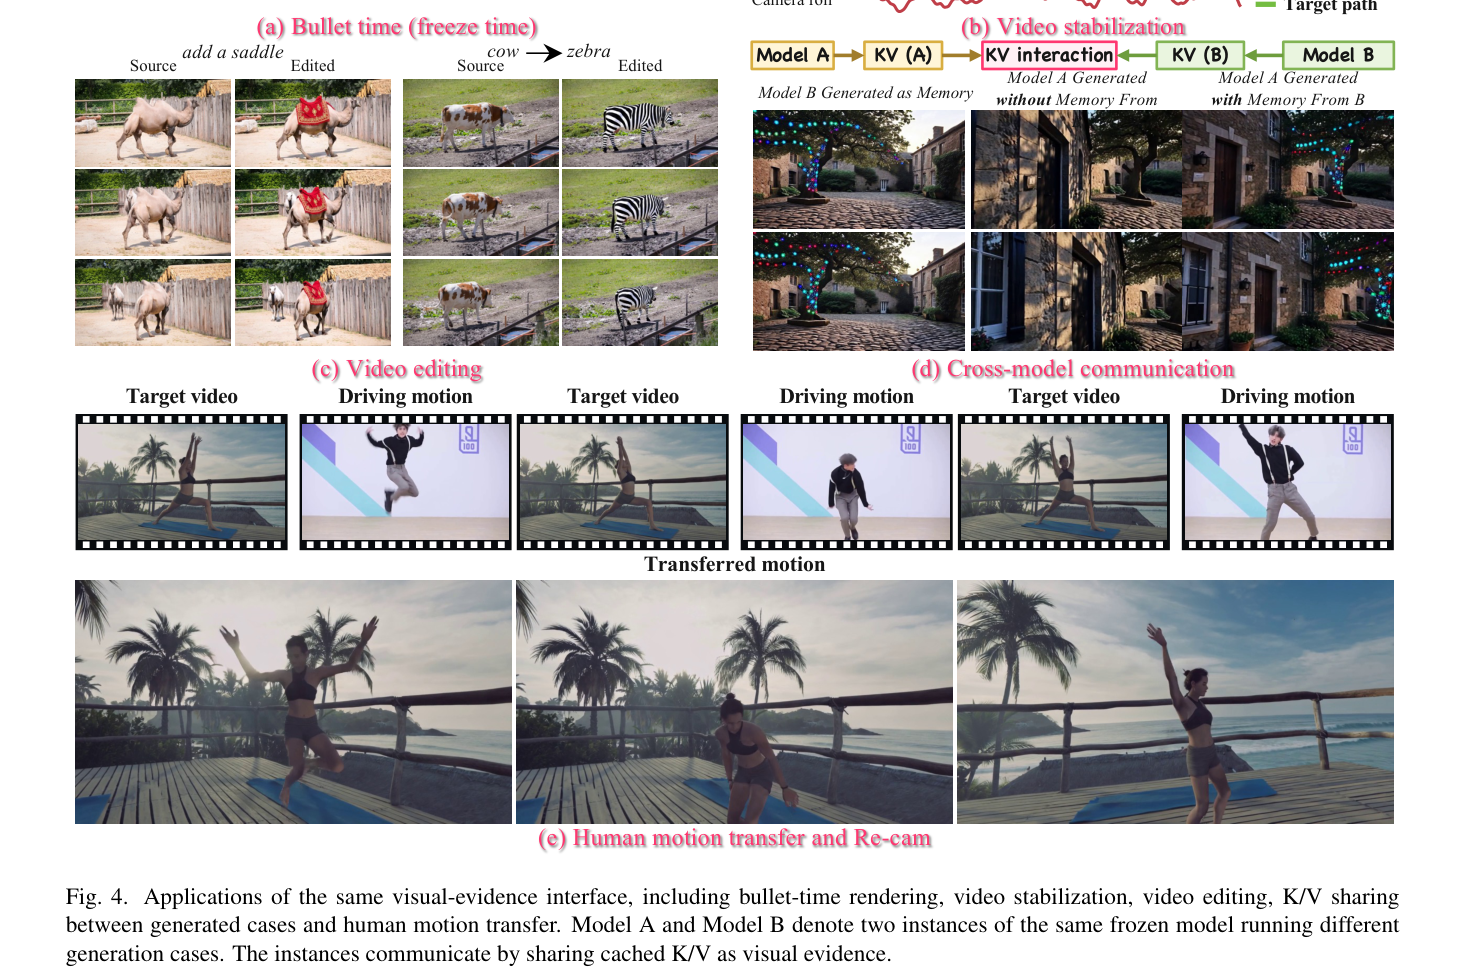
该图展示了同一视觉证据接口的多种应用,包括子弹时间、视频稳定、视频编辑和跨模型 K/V 共享。检查不同任务如何共享同一接口,理解 WiW 的通用性和灵活性。
实验如何设计?
- 在 DAVIS 和 OpenVid-1M 数据集上进行相机控制视频重渲染的定量比较,评估 VBench 的七个维度、相机轨迹误差和图像保真度。
- 评估指标包括 VBench 的美学、成像质量、时间闪烁、运动平滑度、主体一致性、背景一致性、动态程度,以及 TransError、RotError、PSNR、SSIM、LPIPS。
- 在 DAVIS 数据集上进行消融实验,验证各组件(EWA, CGAR, Target-View Warp, Plücker conditioning)的贡献。
- 定性展示多种下游应用,包括子弹时间、视频稳定、视频编辑和人体运动迁移,验证接口的通用性。
- 使用 LingBot-World 2.0 作为冻结因果视频模型骨干,确保实验结果反映接口本身的有效性而非模型能力。
- 对比基线包括 InSpatio-World、ReCamMaster、TrajectoryCrafter、UniWorld-View 和 CameraAnything,覆盖实时 4D 模拟、相机控制生成、轨迹重定向等任务。
关键结果与论文证据
- WiW 在 VBench Overall、TransError、RotError、PSNR、SSIM 和 LPIPS 上均取得最佳结果,证明其在相机控制重渲染中的全面优势(第 8 页)。
- 消融实验表明,移除 Target-View Warp 会导致 RotError 增加约 3.4 倍,TransError 增加约 10.9 倍,凸显空间布局参考对视角控制的关键作用(第 8 页)。
- CGAR 和 EWA 机制在保持主体外观和背景结构方面表现显著,移除后导致外观漂移和结构不一致(第 10 页)。
- 渲染几何证据有效补全新暴露的主体表面,确保人体或物体在新视角下的几何完整性(第 10 页)。
- 历史检索机制在相机重访先前生成区域时,有效维持了早期访问时建立的外观和布局(第 10 页)。
- WiW 在子弹时间、视频稳定、视频编辑和人体运动迁移等下游应用中均表现出一致的性能,验证了接口的通用性(第 9 页)。
- 跨模型 K/V 共享机制允许不同生成实例通过共享缓存的 K/V 进行通信,实现跨模型的一致性控制(第 9 页)。
- EWA 机制虽然不增加 NFE,但涉及额外的注意力响应计算和投影操作,可能增加推理延迟(第 9 页)。
阅读时需要注意
- 依赖外部深度估计(DepthCrafter)和人体重建模型(LHM++),这些模块的误差可能影响最终生成质量。
- 历史检索机制依赖于滚动缓存的驱逐策略,极端长时程或复杂场景下的检索准确性未详细量化。
- 实验主要基于 DAVIS 和 OpenVid-1M,未在其他大规模或更复杂动态场景数据集上进行广泛验证。
- CGAR 依赖于持久点身份跟踪,在剧烈运动或遮挡严重的情况下,对应关系可能失效。
- 方法假设源视频和生成视频之间的时间同步是准确的,时间对齐错误可能导致动态不一致。
关联工作
- InSpatio-World 作为实时 4D 世界模拟器基线,WiW 在相机控制重渲染中表现出更优的一致性和质量(第 7 页)。
- ReCamMaster 专注于单视频相机控制生成渲染,WiW 通过统一接口支持更多样化的控制任务(第 7 页)。
- TrajectoryCrafter 处理单目视频相机轨迹重定向,WiW 在长时程一致性方面更具优势(第 7 页)。
- UniWorld-View 关注大基线视图合成,WiW 通过历史检索机制支持更灵活的视角探索(第 7 页)。
- CameraAnything 实现任意相机控制视频重拍,WiW 在免训练接口和证据整合方面提供新范式(第 7 页)。
- Warp-as-History 将相机扭曲观察作为伪历史,WiW 通过干净视觉状态和 CGAR 实现更精准的证据定位(第 3 页)。
- LingBot-World 2.0 作为冻结因果视频模型骨干,WiW 证明其原生自注意力机制可作为共享视觉信息入口(第 3 页)。