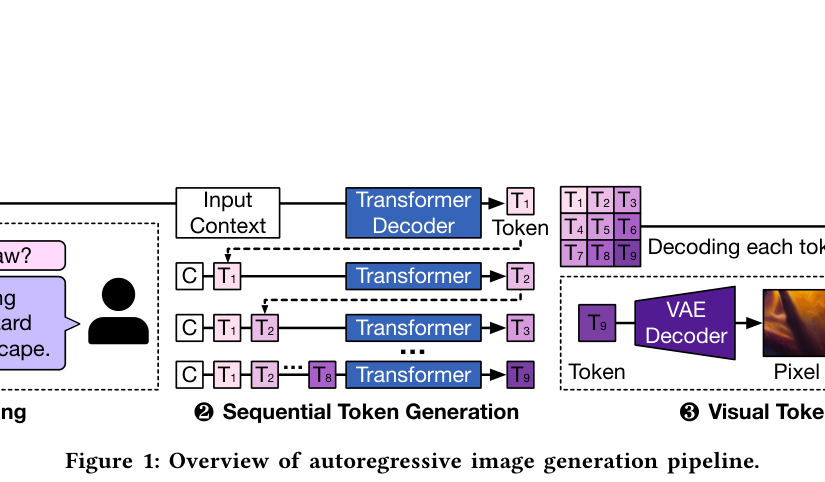
快速导读:本文系统刻画自回归图像生成的注意力稀疏,发现视觉 token 空间局部性带来的对角稀疏模式,并据此设计对角感知稀疏注意力,在稠密推理质量损失有限的前提下提升吞吐与延迟。
自回归图像生成把一张图拆成网格上的视觉 token,再按 next-token 方式逐个吐出,因此可以直接接进 Transformer 与 LLM 服务栈。代价也很明确:一次请求往往要解码上千甚至上万个视觉 token,KV cache 随步数线性膨胀,注意力反复读这些缓存,解码很快变成带宽与计算瓶颈。
文本侧已经有大量稀疏注意力与 KV 驱逐方法,但它们依赖的“少数 token 持续重要、注意力呈纵向 heavy hitter”是否还成立,对图像生成并不清楚。本文做了跨模型、跨工作负载的系统刻画,指出图像生成具有短 prompt、长 decode、注意力集中在 prompt 与局部 token,以及由空间局部性带来的对角稀疏。据此提出对角感知稀疏注意力:在较宽最近窗口内沿对角跳过 KV,用 FlexGen、FlashAttention-2 与自定义 Triton 核接到 GPU 服务路径上。
英文题目:Understanding and Exploiting Diagonal Attention Sparsity in Autoregressive Image Generation
论文出处:arXiv 每日论文精选 · /tmp/ingest_20260920/arxiv-2609-19702.pdf
原始论文:PDF / 论文页面
这篇论文解决什么问题?
多模态 Agent、交互式改图和世界模型越来越需要在交互环里生成图像。扩散模型画质高,但骨干与 LLM 异构,服务时往往要单独占卡。自回归图像生成用同一套解码循环,服务栈可以复用,却把压力转移到超长视觉 decode。
表征显示文生图 prompt 大多短于 100 token,而 Azure LLM traces 的平均 prompt 超过 1K。相反,输出长度由分辨率和 VAE latent 下采样比钉死:1/16 设定下常见 576(Janus-Pro 384×384)到 4096(Lumina-mGPT 1024×1024),更高设定可到 8100。1024×1024 时 decode 可比 prompt 长约 40 倍,KV 几乎全是 decode 视觉 token。
批量出图时,高分辨率会把 KV 连同权重一起顶穿消费级与服务器卡的显存墙;注意力在 Transformer 延迟中可占到约 40%,并且随解码推进从约 12–22% 升到超过 50%。只压缩 prompt KV 解决不了这个问题。
草稿预览和安全过滤等应用可以接受适度画质损失来换吞吐。问题在于:直接套用 LLM 的分数选择(H2O、TOVA、ALISA)在图像模型上会在高稀疏处崩掉,而只靠收窄窗口的位置方法又会丢掉仍有用的较远上下文。
核心创新
- 首次系统刻画自回归图像生成的注意力稀疏,指出与文本 LLM 相反的 prefill-decode 不对称,以及位置类稀疏优于分数类稀疏。
- 揭示视觉 token 空间局部性导致的对角注意力稀疏,并用对角相似度高于纵向相似度加以量化。
- 提出对角感知稀疏注意力:在较宽最近窗口内沿对角跳过 KV,用 (N_r, N_att) 分别控制显存与计算。
- 在 GPU 服务栈上用 FlexGen、FlashAttention-2 与自定义 Triton 核实现,并报告质量–延迟–吞吐权衡。
方法概览
先在 Janus-Pro、Lumina-mGPT、NextStep-1 与同规模 LLM 上刻画稀疏结构:KV 由 decode 视觉 token 主导,注意力集中在 prompt 与最近局部 token,注意力图出现图像特有的对角条纹。据此提出对角感知稀疏注意力:始终完整关注 prompt KV;在宽度为 N_r 的最近窗口内沿对角方向跳过低分 KV,使每步只关注 N_att 个 decode token。算法分三阶段:前 N_att−1 步全注意力;随后每步把最低分位置加入 skip 集合并沿对角平移;窗口滑出后驱逐最旧 KV 并平移 skip 索引。N_r 取 0.5×L_dec,N_att 由目标稀疏比 1−N_att/L_dec 决定。实现基于 FlexGen 与 FlashAttention-2,并用 Triton 核融合间接 gather 与窗口内 argmin。
- 作者先把 KV 稀疏分成三类对照:无稀疏、位置规则(SlidingWindow、StreamingLLM)和分数规则(H2O、TOVA、ALISA)。分数法在 LLM 上通常更好,因为它假设重要 key 对后续 query 仍然重要,对应注意力图上的纵向条。图像模型把这个排序反过来:位置法在各稀疏档都更稳。
- 注意力质量分解把 token 分成 prompt、最近 10% 的 local、以及其余 middle。prompt 虽短却占一半以上注意力;middle 在 Janus-Pro、NextStep-1、Lumina-mGPT 上分别只有 6.2%、8.1%、8.5%。因此稀疏策略必须保住 prompt,并优先照顾局部窗口。
- 更关键的是对角结构。layer 10、head 5 的注意力图上,三款图像模型在 decode 区出现清晰对角条纹,Qwen3-8B、Llama3.1-8B、Gemma3-4B 则没有。对角相似度比较的是 query i 与 query i+d 在平移后的 key 区间 [d, i+d] 上的分数向量,纵向相似度则比较同一 key 区间 [0, i]。图像模型对角始终高于纵向,说明重要性跟相对位置走,而不是钉在绝对 key 编号上。
- 几何直觉是:相邻图像块共享相对空间关系,query 前进一步,相关邻域也一起平移,于是重要 query-key 对在注意力图上画出对角线。分数法抓不住这条对角,普通滑动窗口只能隐式覆盖其中一段。
- 对角感知算法用两个旋钮:最近窗口 N_r 和每步关注数 N_att。实验取 N_r=0.5×L_dec,稀疏比定义为 1−N_att/L_dec。Prompt KV 始终全看。阶段一:前 N_att−1 步对窗口内全部 decode KV 做全注意力。阶段二:每步把当前最低分位置记入 skip 集合,下一步把这些下标整体 +1,沿对角追踪“以后也不该看”的位置,直到窗口内只剩 N_att 个被看位置。阶段三:窗口滑出后驱逐最旧 KV,skip 下标继续 +1,N_att 保持不变。每个注意力头独立维护 skip。
- 显存上界是 N_r+L_p,每步注意力代价是 O(N_att+L_p)。选择步的 argmin 复杂度 O(N_r),但只在阶段二的 N_r−N_att 步出现。服务实现把间接 KV gather 和窗口 argmin 融进 Triton 注意力核,避免中间 gather 缓冲。变体 Diagonal+sink4 再保留前 4 个 decode token 作为 attention sink。
逐图理解论文
失败直觉
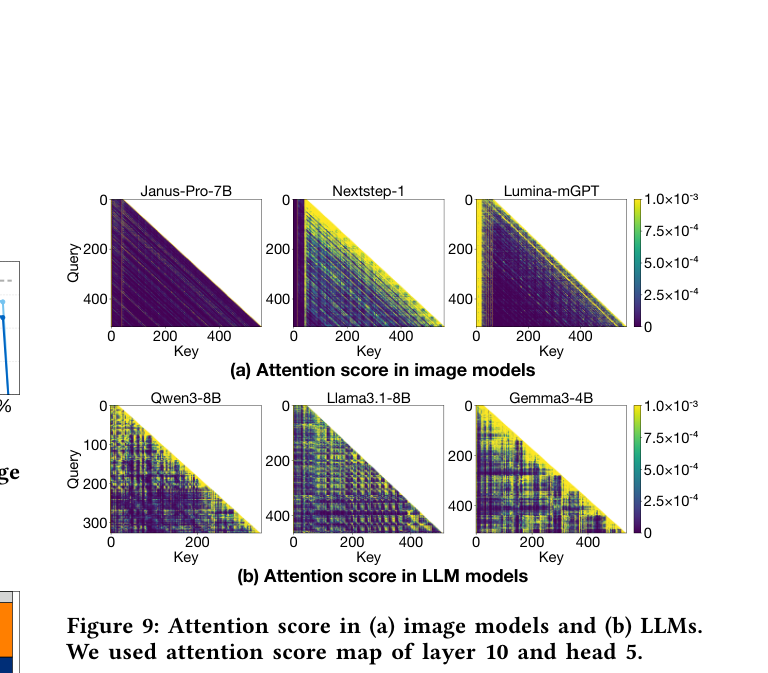
同一层同一头的注意力分数图对比。上排 Janus-Pro-7B、NextStep-1、Lumina-mGPT 在 decode 区出现规律对角条纹,左侧 prompt 列也偏亮;下排 Qwen3-8B、Llama3.1-8B、Gemma3-4B 更像不规则块状,没有稳定对角。色标约 0 到 1.0×10⁻³,取 layer 10、head 5。这是“图像注意力结构不同于 LLM”的直接证据。
研究缺口
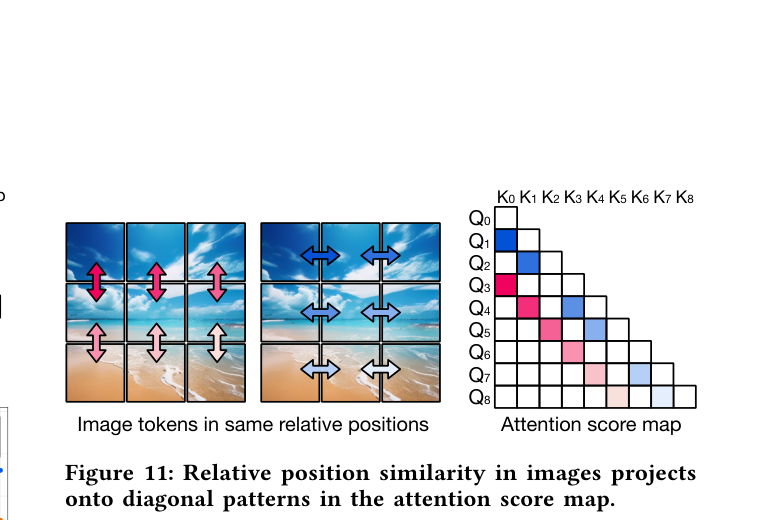
用海滩 3×3 图块说明相对位置:左图竖向红箭头、中图横向蓝箭头标出相同相对关系的 token 对;右侧下三角注意力图用蓝、红两串对角格子对应这些关系。结论是空间上的相对位置会投影成注意力图上的对角线,而不是钉死在某个绝对 key。
方法贡献
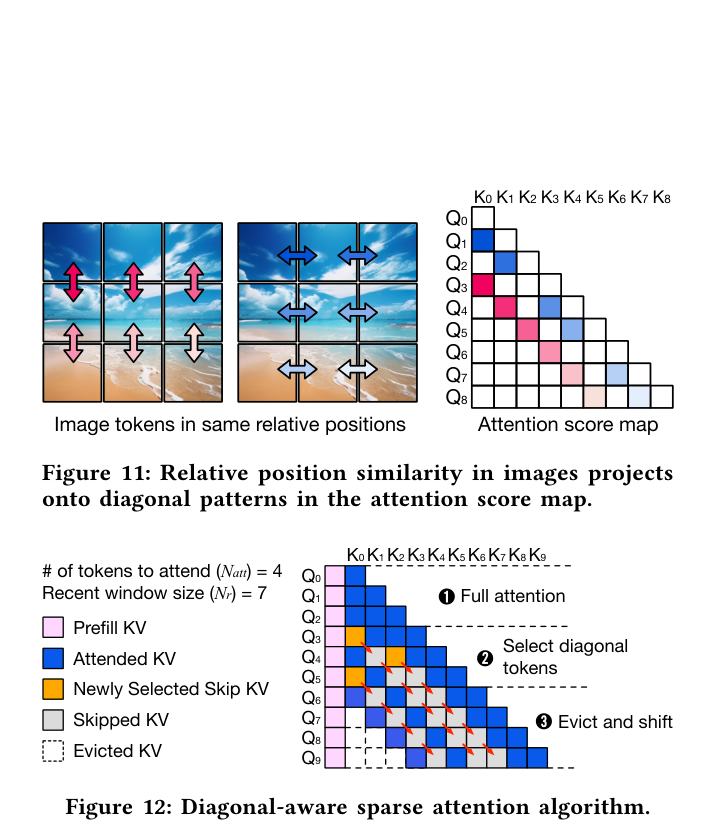
算法示意(该裁剪上方还带有 Figure 11)。图例区分 Prefill KV(粉)、Attended KV(蓝)、Newly Selected Skip KV(橙)、Skipped KV(灰)和 Evicted KV(虚线)。示例 N_att=4、N_r=7:① 前几步全注意;② 每步选出新的最低分 skip 并沿红箭头对角传播;③ 窗口滑出后驱逐最旧 KV,skip 下标平移。Prompt 列始终保留。
核心结论
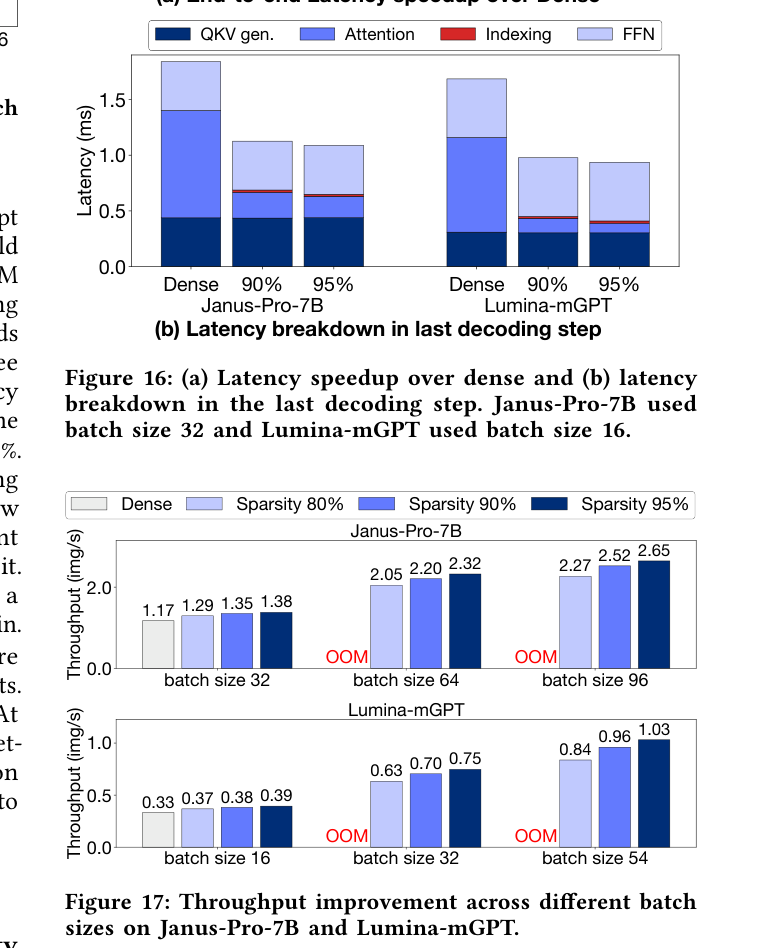
吞吐柱状图,单位 img/s。Janus-Pro-7B 在 batch 32 上 Dense 1.17、95% 稀疏 1.38,batch 64/96 的 Dense 标红 OOM,Diagonal 95% 达到 2.32 与 2.65。Lumina-mGPT 在 batch 16 上 Dense 0.33、95% 为 0.39,batch 32/54 的 Dense OOM,峰值 1.03。裁剪上方还带有 Figure 16(b) 的末步延迟分解,红条 Indexing 很薄。
实验如何设计?
- 表征与评测都在单卡 NVIDIA RTX A6000 48GB 加 Intel Xeon Gold 上进行。图像模型为 Janus-Pro-1B/7B(384×384,576 visual token)、Lumina-mGPT-7B(512×512,1024 visual token),表征还包含 NextStep-1-14B。分类器无关引导权重按官方默认:Janus 5.0,Lumina-mGPT 4.0。
- 质量基准是 GenEval(553 prompt、每条 4 张图,考察物体存在、计数、颜色与空间关系)和 DPG-bench(更密的组合 prompt)。稀疏比从 80% 扫到 96%,对照 Dense 与五类 LLM 稀疏基线。
- 延迟与吞吐固定 prompt 为 50 token(DiffusionDB 中位数),warmup 后平均 3 次。吞吐按 images/s 报告,并给出 Dense 在更大 batch 上的 OOM 边界。
- 附录说明完整 GenEval 质量表在 4 张 A6000 上约需 40 天;工件仓库为 casys-kaist/DiagonalAttn。
关键结果与论文证据
- Table 2 显示分数类方法在超过 90% 稀疏后迅速垮掉,95–96% 时往往保留不到稠密精度的 30%。位置类能撑到 90–92.5%,但 StreamingLLM 在两个 Janus-Pro 的 96% 档出现悬崖,GenEval 可掉到 0.071–0.083。
- 对角方法在极端稀疏仍贴近 Dense。Janus-Pro-7B 上 Dense GenEval 为 0.788,Diagonal 在 80% 时为 0.792、96% 时为 0.738,Diagonal+sink4 在 96% 为 0.749;Lumina-mGPT 上 Dense 为 0.543,Diagonal+sink4 在 96% 为 0.504。作者概括为 96% 稀疏下与 Dense 相差约 1–6%,而最强位置基线下降约 10–30%。原因是它在更宽窗口里按对角取样,而不是把窗口本身收成一条窄带。
- Figure 13 的 Janus-Pro-7B 定性结果与数字一致:90% 时 StreamingLLM 与 Diagonal+sink4 都还能保住苹果和泰迪熊;96–97% 时 StreamingLLM 变成空白或残缺,对角方法仍保持物体轮廓与颜色,尽管极高稀疏下结构会开始变形。
- 质量–延迟曲线上,Diagonal 整体压过 StreamingLLM。Janus-Pro-7B、batch 96 时 Diagonal+sink4 约 38s 回到 Dense 级 GenEval,StreamingLLM 约需 41s。95% 稀疏的端到端延迟加速为 1.18×(Janus-Pro-7B)与 1.19×(Lumina-mGPT);末步注意力本身可加速 4.15×–9.78×,indexing 开销在融合核后很小。
- 吞吐上,更小 KV 允许更大 batch:Janus-Pro-7B 的 Dense 在 batch 64 起 OOM,Diagonal 可到 96,峰值 2.65 img/s;Lumina-mGPT 的 Dense 停在 16,Diagonal 到 54,峰值 1.03 img/s。相对各自稠密配置约 2.3× 与 3.1×。同 batch 内也有增益,例如 Janus-Pro-7B batch 32、95% 稀疏为 1.38 img/s 对 Dense 1.17 img/s。
阅读时需要注意
- 论文没有单独写 Limitations。设计前提是视觉生成可以拿适度质量换效率,草稿和过滤场景比最终交付更合适;若任务要求几乎无损,96% 这类极端稀疏并不合适。
- 摘要写“质量下降不到 2%”,但 Table 2 在 96% 稀疏、不同模型与指标上可以看到约 1–6% 的差距,引用时应以表格为准。
- 质量评测没有覆盖表征里用过的 NextStep-1;N_r 统一取半个 decode 长度,没有逐模型搜索。延迟固定 50 token prompt,硬件是一张 48GB A6000,OOM 边界和绝对 img/s 都会随显存变化。
- KV 量化以及 ZipAR、PAR、NAR 等并行解码被作者视为正交,文中没有联合加速数字。
关联工作
- SlidingWindow 与 StreamingLLM 代表位置类 KV 稀疏。前者只留最近窗口,后者再加 attention sink。它们部分利用了局部性,但高稀疏时只能靠把窗口收窄,覆盖不到对角上更远但仍相关的 key。
- H2O、TOVA、ALISA 代表分数类方法,假设重要 token 会纵向持续。图像注意力没有这种全局 heavy hitter,中间 token 贡献很小,所以这些方法在图像模型上的优劣排序与 LLM 文献相反。
- HACK 按头的稀疏方差分类并在局部窗口内退回分数选择,ADSA 每步挑多样化中间 token。本文把对角本身写成选择规则,并在多款 AR 图像模型上量化这一模式。
- ZipAR、PAR、NAR 用空间局部性并行解码多个 token,改的是并行度而不是每步 KV 访问;作者认为可与对角稀疏叠加。KV 量化(KIVI、KVQuant、QServe 等)同样正交。