快速导读:Edit-VAR 把源视频直接编成多尺度离散词元,用概率引导替换与注意力调制的逐词元、分尺度保真控制,在 InfinityStar 上做免训练、不求逆的文本视频编辑。
文本引导视频编辑要改指定内容,同时保住未编辑区域的外观与时间连贯。训练式方法控制力强,但数据和算力贵。免训练方法里,求逆派先把源视频拉回潜在轨迹再按新提示重生,近似误差会变成背景漂移;不求逆派避免轨迹恢复,却常把源约束绑得太死,语义改不完。中山大学等机构的 Edit-VAR 把问题放到预训练视觉自回归视频模型上:分词器直接把源视频编成由粗到细的离散词元,编辑变成对这些词元的条件保留或替换,不再做迭代轨迹求逆。
方法分两阶段前向。Phase 1 在源提示下缓存各词元概率与交叉注意力;Phase 2 在编辑提示下用源到目标的概率落差决定替换,并用注意力把编辑区的保留容差 γ 压低、把背景抬高。晚尺度实行 Scale-Decoupled Generation,停止缓存源约束以免细纹理碎裂;最后两档高分辨率按残差范数剪枝以加快推理。实验覆盖属性、背景、物体添加与替换四类任务,并做盲测用户研究。项目页与代码已公开。
英文题目:Edit-VAR: Taming Visual Autoregressive Model for Precise Video Editing
论文出处:arXiv 每日论文精选 · arXiv:2609.21268
原始论文:PDF / 论文页面
这篇论文解决什么问题?
训练式编辑从大规模视频学习显式行为,指令跟随好,但收集配对数据、训练专用模型成本高(第2页)。免训练则复用预训练生成器,分成不求逆与求逆两派。
不求逆方法直接构造源到目标的变换或引导,源保真运输可能限制语义偏离,留下改不完的编辑。求逆方法先把源映到噪声轨迹再重生,求逆与再生成的误差会在时空表示里传播,造成源内容漂移和时间不一致(第2页)。
图像级 AR 编辑提示可以用缓存源概率做词元替换。视频词元却在时间上耦合,同时编码外观、姿态、运动和可能随帧变化的编辑区。均匀保留规则会过度约束编辑词元、或欠约束非编辑词元。VAR 视频编辑因此需要既逐词元又分尺度的保真控制(第2–3页,Fig.2)。
核心创新
- 据作者称是首个在预训练 VAR 视频模型上、免训练且不求逆的文本引导编辑框架。
- 层次化自适应保真:概率引导替换加上注意力驱动的逐词元、分尺度调制。
- Scale-Decoupled Generation 在晚尺度释放源约束,再生与运动一致的细节。
- 残差引导词元剪枝降低晚尺度推理成本。
方法概览
两阶段前向:Phase 1 编码源视频,在源提示下强制解码缓存词元概率与交叉注意力;Phase 2 在编辑提示下按源到编辑的支持落差做条件替换,γ 由尺度包络与注意力双层 sigmoid 决定。S_stop 之后放开源约束(Scale-Decoupled Generation)。最后两档高分辨率按残差范数只保留 top-K% 词元过 Transformer。
- 骨干是 InfinityStar:视频表示为 S 个由粗到细的离散词元块,尺度内并行预测。前段是单帧图像塔,后段是多帧视频塔,空间分辨率递增。分词器编码器把任意视频确定性映射到各尺度源词元下标,无需迭代求逆;每步用 arg max 选词元,编辑就插在这一选择上(第3页)。
- Phase 1:编码源视频得到各尺度源下标,在源提示下强制解码,缓存源条件概率与交叉注意力。锚点由源提示与编辑提示的词级差分自动得到:替换/属性/背景用差分跨度里的源侧词;物体添加则用插入跨度旁最近的未改源词。超注意力窗的尺度从最近可用尺度插值注意力(第4页,Fig.3)。
- 概率引导:用源到编辑的支持落差衡量兼容性。位置 i、尺度 s 上计算偏向源词元的 bias,与编辑分布的 arg max 比较后决定保留或替换。容差 γ 控制允许多大落差仍保源;γ=0 时完全听编辑分布,γ=2.0 时因概率不超过一而强制保源(第4–5页)。
- 空间调制:单 γ 分不清编辑区与背景。源侧编辑目标的交叉注意力高响应处更可能是编辑区。双层 sigmoid:尺度包络给每尺度 [γ_low, γ_high],γ_start=2.0 使早尺度全保;词元层再按注意力把高注意映到低 γ(可编辑)、低注意映到高 γ(保背景)(第5页,Fig.4)。
- Scale-Decoupled Generation:晚尺度源词元绑着原运动与纹理,强制保留会导致碎裂。Phase 1 在 S_stop 停止,之后不缓存源概率与注意力,Phase 2 自由生成(γ=0)。残差剪枝:最后两档用上一尺度残差范数,三线性插值后只让 top-K%(默认一半)词元过全部 Transformer 块,其余保持输入嵌入,索引在所有块上固定(第5–6页)。
逐图理解论文
失败直觉
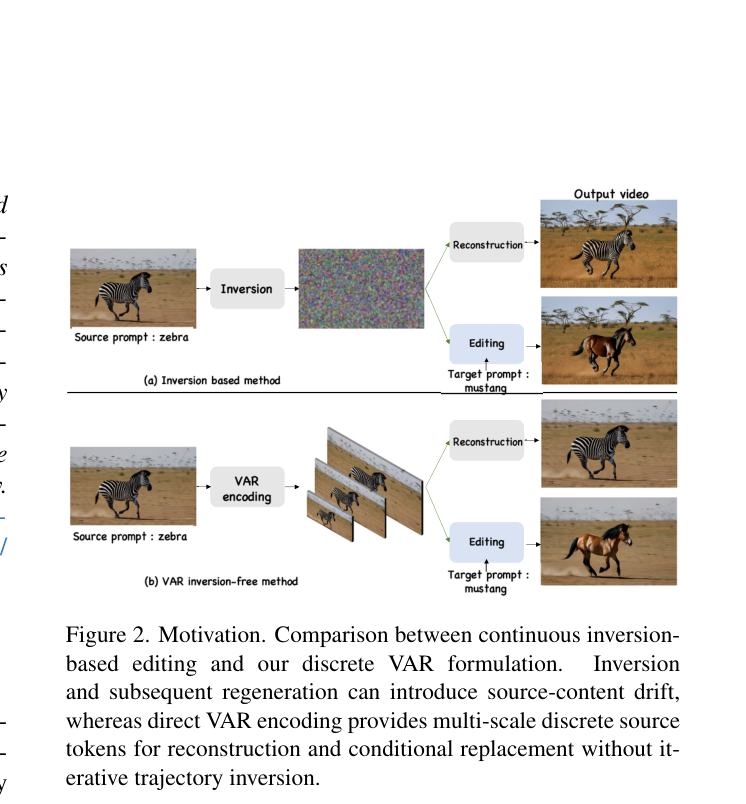
上下对照。上 (a) Inversion based:斑马 → Inversion → 彩色噪声,再分叉 Reconstruction 仍是斑马、Editing 变成奔马,但重建斑马带伪影。下 (b) VAR inversion-free:斑马 → VAR encoding → 三层由粗到细的斑马词元金字塔,重建更干净,Editing 得到棕色奔马。源提示 zebra、目标 mustang。用来讲“不求逆、直接多尺度离散源参照”。左缘正文被切,不要当完整段落读。
研究缺口
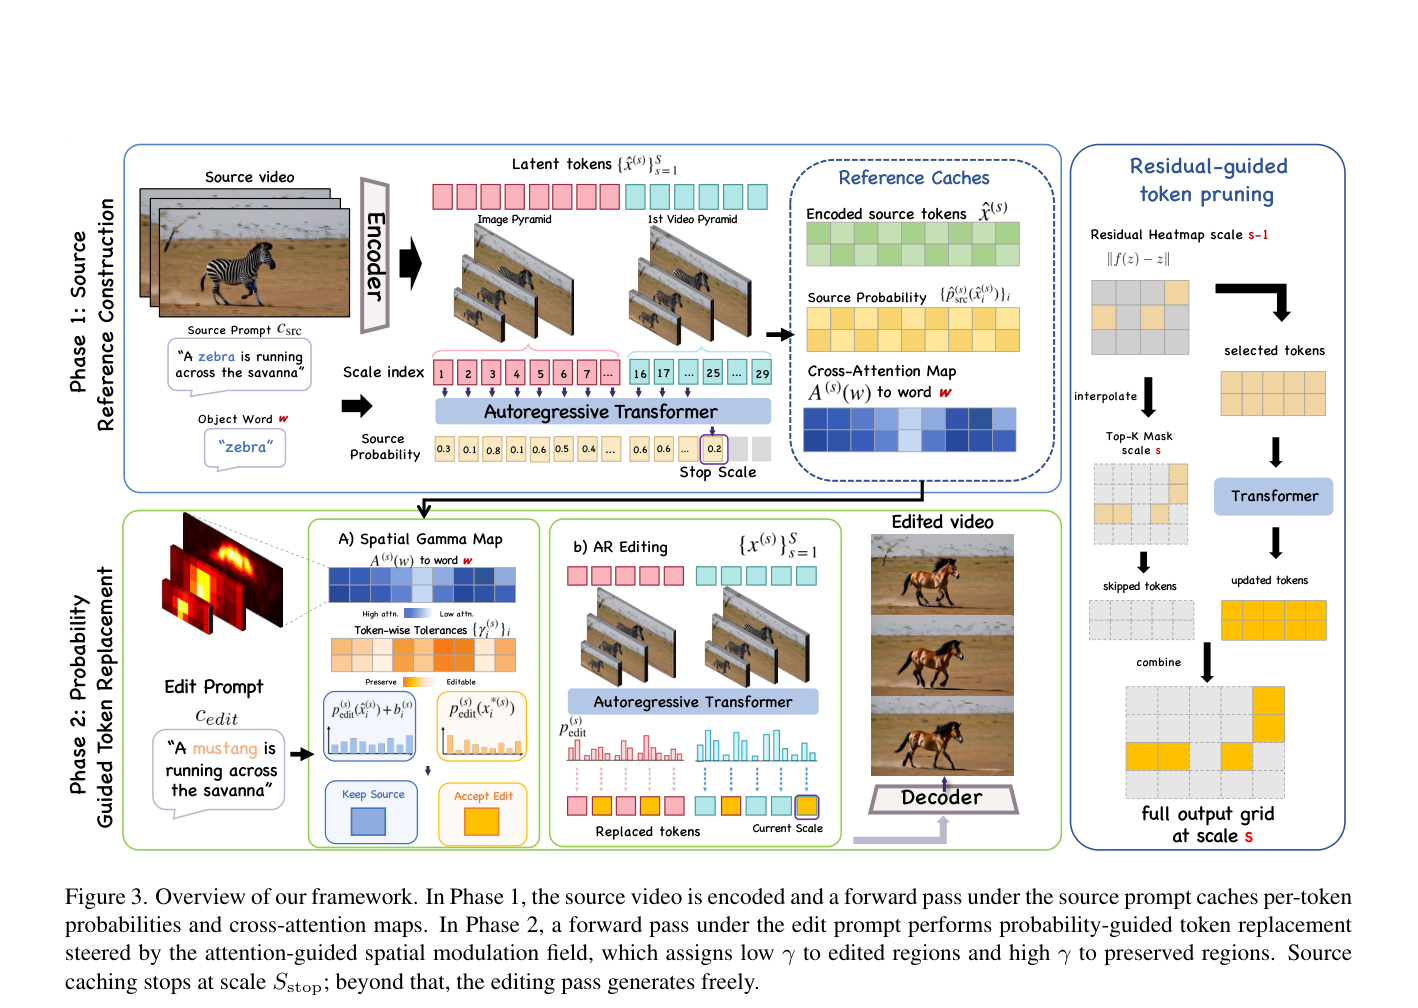
总览分三色块。上蓝 Phase 1:斑马源视频经 Encoder 成 Image Pyramid 与 1st Video Pyramid,尺度索引 1…29,Stop Scale 后不再缓存;右侧 Reference Caches 为源词元、源概率、对词 w 的交叉注意力。下绿 Phase 2:编辑提示 mustang,A) Spatial Gamma Map 高注意可编辑、低注意保留,B) AR Editing 替换词元后 Decoder 出奔马视频。右蓝 Residual-guided token pruning:残差热图 → Top-K Mask → 只更新选中词元再拼回全网格。这是架构/方案图,适合当特色图。
方法贡献
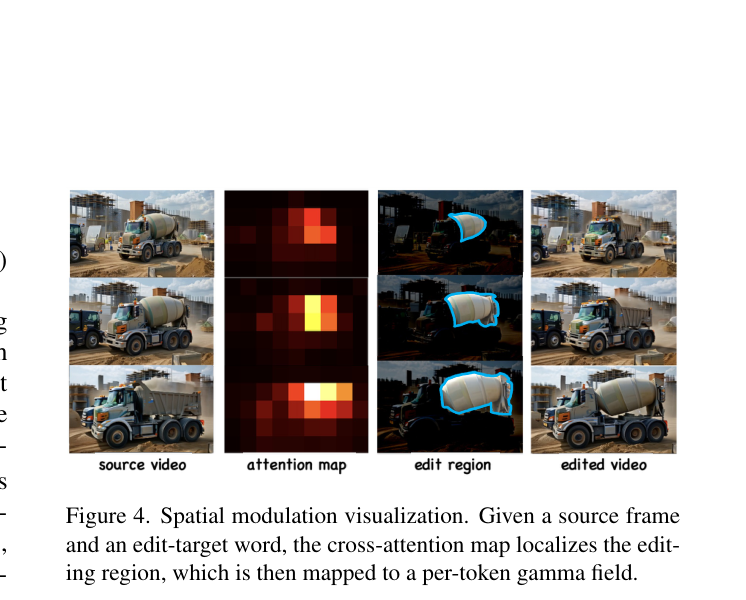
三行水泥搅拌车。列:source video、attention map、edit region、edited video。注意力亮斑落在罐体,第三列蓝线圈出罐,第四列罐体变成更浅的外观而车头与工地背景大体保留。用来理解交叉注意力如何变成逐词元 γ,不是分割网络输出。编辑目标词未印在图上,需结合图注。
实验观察
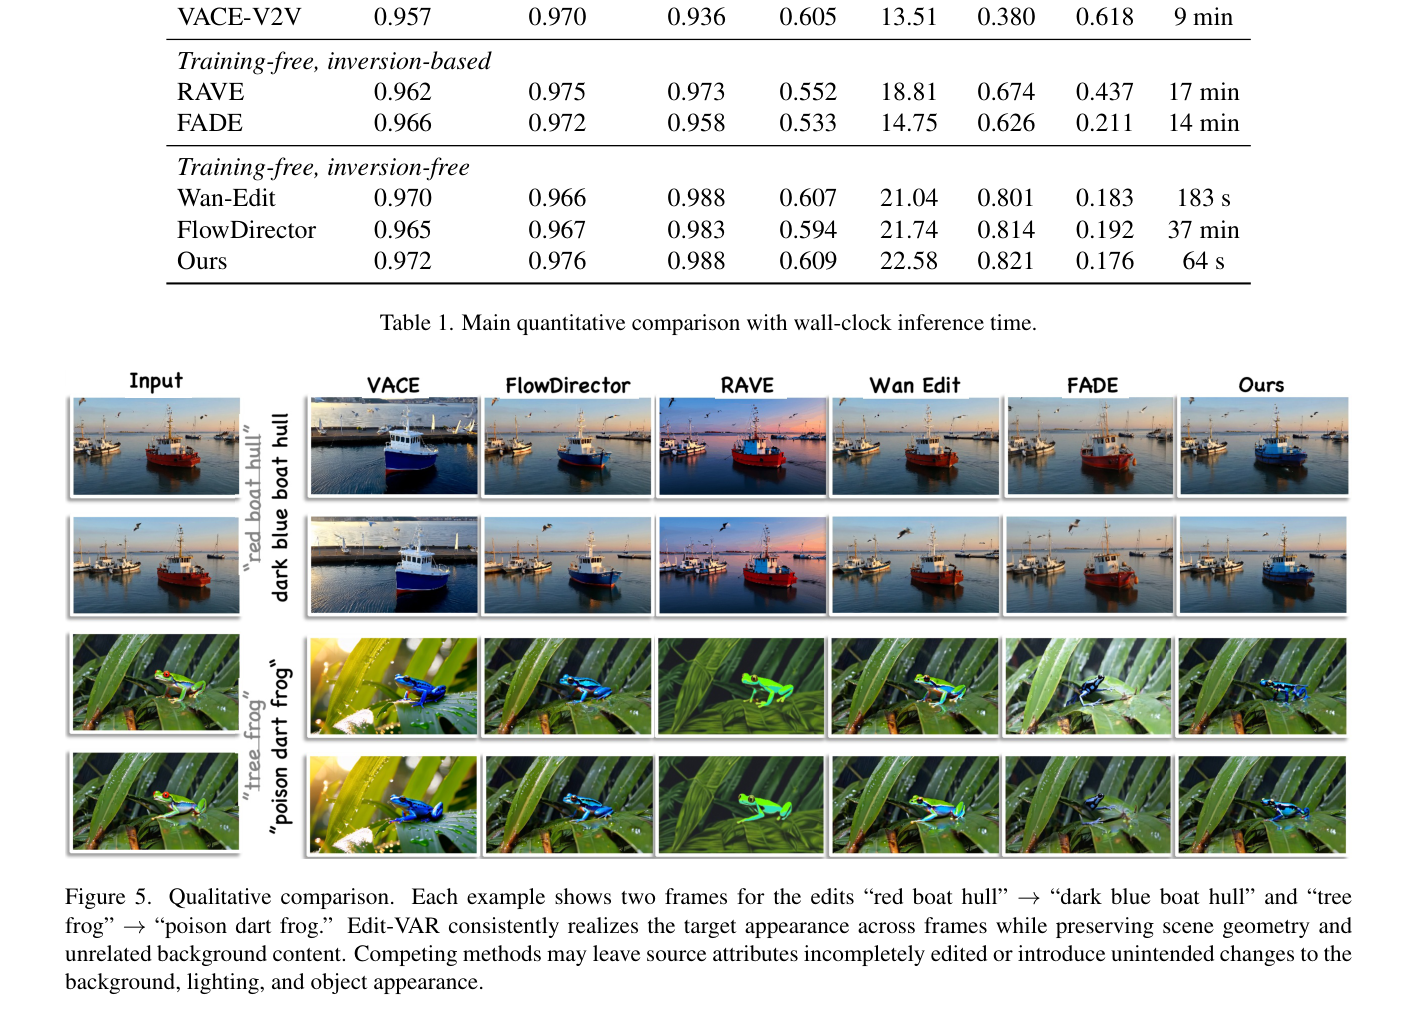
上半是 Table 1 主表,可见 Ours 0.972 / 0.976 / 0.988 / 0.609 / 22.58 / 0.821 / 0.176 / 64 s。下半定性:左 Input 两帧船、两帧蛙;列 VACE、FlowDirector、RAVE、Wan Edit、FADE、Ours。船任务要把红船体改深蓝,蛙要把树蛙改箭毒蛙。看 Ours 列是否两帧都完成且水面、叶片稳定;竞品有改不完或背景被拖。叙述可视化只引用这张 figure id,不要引用 table id。表在图上出现不改变它是定性主图。
实验如何设计?
- 默认生成 81 帧。关键超参:γ_start=2.0,γ_fg_end=1.60,γ_bg_end=1.78,图像塔/视频塔包络转场分别在尺度 5 与 4;S_stop=25;残差剪枝只作用于最后两档。全部编辑类别共用同一套设置。实验在单卡 NVIDIA A800 上计时(第6页)。
- 数据:160 段公开网络视频,物体替换、添加、背景替换、属性编辑各 40。用户输入只有源视频与文本。训练基线 VACE-V2V;求逆免训练 RAVE、FADE;不求逆免训练 Wan-Edit、FlowDirector。均用官方实现与作者推荐配置,不做逐例调参(第6–7页)。
- 对齐用全帧与编辑区 CLIP-S(FiVE-Bench 区域协议);质量用 VBench 的 Motion Smoothness 与 Aesthetic Quality。编辑区掩膜由 SAM2 每例生成一次并全方法共享。PSNR/SSIM/LPIPS 在互补非编辑区上计算。盲测 15 人、随机 50 例,按 Fail/Pass/Good/Excellent 评编辑质量、背景保持与时间一致性(第7页)。
关键结果与论文证据
- Table 1:加速后的 Edit-VAR 在所列免训练方法中总体最强。CLIP-Sfull/edit 为 0.972 / 0.976,Smooth 0.988 并列最高,Aesth 0.609 最高;非编辑区 PSNR/SSIM/LPIPS 为 22.58 / 0.821 / 0.176;81 帧墙钟 64 s,对照基线约 5–37 分钟或 Wan-Edit 的 183 s(第6–7页)。
- Fig.5:红船体改深蓝与树蛙改箭毒蛙。VACE 与部分方法改不完或改掉水面、天空、叶片;本文两帧都完成目标外观并保住几何与无关背景。上半同页是主表,下半才是拼图(第6页)。
- 消融:去注意力后 CLIP-Sedit 从 0.980 降到 0.931、SSIM 从 0.833 到 0.563;去尺度包络 CLIP-Sedit 再降 0.047、SSIM 降 0.166;均匀 γ 的 CLIP-Sedit 0.913、LPIPS 0.456 最差。S_stop=25 把全帧/编辑区 CLIP-S 从 0.935/0.951 升到 0.979/0.980,SSIM 从 0.612 到 0.833,Phase 1 从 65.0 s 到 19.8 s(第7–8页)。
- 残差剪枝相对随机剪枝:同为 K=50% 时 CLIP-Sedit 0.976 vs 0.954、LPIPS 0.176 vs 0.235。K=50% 把 Phase 2 从 65.0 s 降到 43.9 s;与尺度解耦合起来相对 130 s 未优化两阶段达到 2.04×,主表 64 s(第8页)。
- 用户研究中本文在三项上的 Good+Excellent 合计比例最高(补充 Fig.10)。失败案例主要是大结构改动:源约束倾向保留原布局、姿态与运动(第8、21页)。
阅读时需要注意
- 编辑被写成条件词元替换,设计上就保留源视频的全局结构,因此不适合物体删除或显著改布局——空出来的区域需要连贯补全而不是逐词元替换(第8页)。
- 提示含糊或描述不足时,模型可能认错编辑对象或只完成部分语义,出现残留源结构、局部不合理变形或与目标概念不完全相符的内容(第21页,Fig.15)。
- 方法绑定 InfinityStar 的离散词元接口与注意力窗;换骨干或超长视频时,注意力插值与 S_stop 选择都要重标定,论文用全类别共用超参,不保证每例最优。
关联工作
- VAR 与 Infinity 把生成改写成多尺度离散自回归;InfinityStar 再把它接到时空金字塔。Edit-VAR 利用“编码器直接给出源下标”和“每步 arg max 可干预”两点,避免连续扩散求逆(第3页)。
- AREdit 在图像上缓存源概率并自适应替换;ISLock 用锚点匹配保结构。它们没有显式处理视频里空间变化的编辑区与尺度相关约束。均匀 γ 消融就是把 AREdit 策略直接接到视频词元上(第3、7页)。
- RAVE、FADE、TokenFlow 等代表求逆或注意力复用的免训练视频编辑;Wan-Edit、FlowDirector 代表不求逆。Edit-VAR 用同一用户输入协议与它们比,但骨干是 VAR 而不是扩散(第2、6页)。
- 视觉 AR 加速文献常用词元/层剪枝或缓存压缩;本文只用残差范数在最后两档高分辨率上选词元,并固定 keep 索引穿过全部 Transformer 块(第3、5页)。