快速导读:腾讯与港科广发布 OmniVBench 与约 34 万条 Omni-R2V 数据,按内容、运动、风格、结构、叙事及多参考把 R2V 拆成因素级评测与可训练配对。
参考到视频正在变成创作里的常规控件:不只把一张人物图粘进镜头,还要迁移动作、镜头轨迹、画风、线稿/分镜结构,甚至按故事板或上一镜续写。现有基准大多停在内容参考和整体像不像,细的控制因素有没有被保留、拆开、接到正确对象,基本测不到。腾讯 Online Video BU 与香港科技大学(广州)发布 OmniVBench 和 Omni-R2V 数据集,想把评测和训练放在同一套 omni 任务分类上。项目页 https://wxliii.github.io/OmniVBench/。
OmniVBench 覆盖 7 个任务族、18 个细任务、813 个评测 case,并用 12,172 条 case 级 checklist 分别看参考保真、指令实现和视觉质量。配套 Omni-R2V 提供 339,570 条(约 340K)已处理好的参考–视频–指令三元组,主要来自专业成片,按任务做匹配或逆构造。开闭源模型评下来:内容参考普遍更强,运动、叙事和多参考差距更大;没有任何模型在所有族上都领先。
英文题目:OmniVBench: A Benchmark and Large-Scale Dataset for Omni Reference-to-Video Generation
论文出处:arXiv 每日论文精选 · arXiv:2609.22069
原始论文:PDF / 论文页面
这篇论文解决什么问题?
实用工作流里的参考是异构的。一张角色图管身份,一段别人的视频管动作,一张线稿管构图,一句“把场景改到沙漠”管叙事变换。只测“生成视频和参考整段像不像”,会把抄到不该抄的因素也算成功。
Table 1 对照显示 OpenS2V-Eval、VACE-Bench、UniVBench 等几乎没有同时覆盖动作、镜头、风格、Greybox/线稿/分镜、故事与下一镜、以及多内容/跨要素。Table 2 里既有图像又有视频参考、还直接提供处理后样本的公开数据也很少。
因此缺口有两块:评测要按因素列清单;训练要有跨任务族、已对齐的大规模配对,而不是让用户自己下原片再切。
核心创新
- 据作者所述,这是覆盖内容/运动/风格/结构/叙事及多参考的 omni R2V 基准,含 813 个评测 case 与 18 个细任务。
- 因素级 checklist(12,172 项)把保真、解耦路由与指令实现分开,而不是只打整体参考一致性。
- 发布约 340K 已处理好的异构参考训练对,并给出按任务的配对流水线。
方法概览
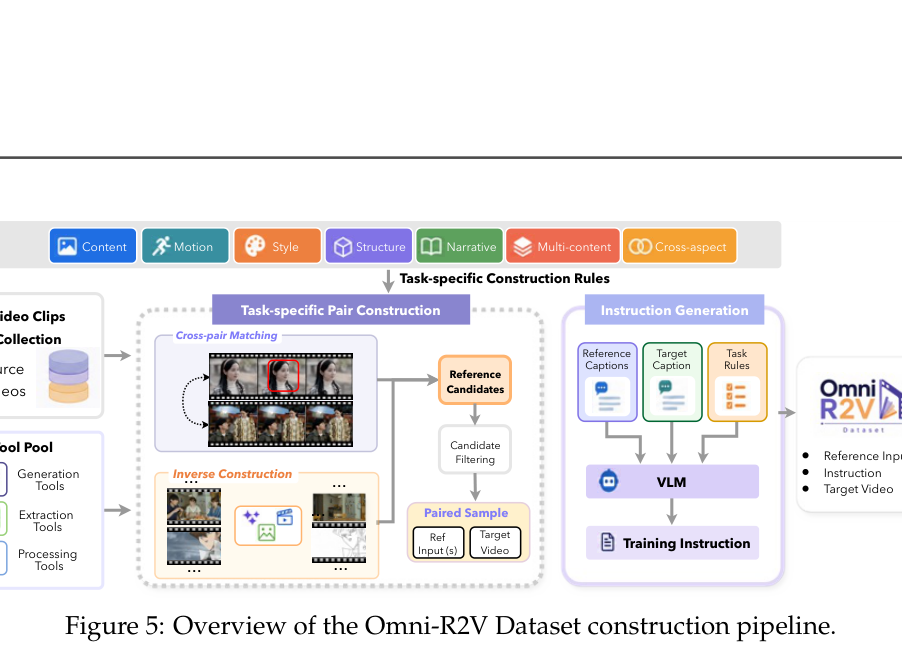
把单参考任务分成内容、运动、风格、结构、叙事五类,并扩展到多内容与跨要素多参考,共 7 个任务族、18 个细任务。评测用因素清单:每个 case 检查应保留、应解耦路由、应按指令实现的因素,共 12,172 条 checklist,分数沿 RF/IR/VQ 汇总。训练数据 Omni-R2V 从专业视频切分,经跨对匹配或逆构造得到参考,Gemini-3.1-Pro 描述、DeepSeek-V4-Pro 按任务规则写成指令,得到 339,570 条处理好的样本。
- 任务分类:单参考五类——内容(物体整体/材质/图案/部件,人物单视角/多视角/定制编辑/属性定位,场景)、运动(动作与镜头轨迹)、风格、结构(Greybox、线稿、粗分镜)、叙事(多分镜故事板、故事改写、上一镜续写);再加多内容与跨要素,合计 7 族 18 细任务。
- 因素评测:每个 case 写成应保留、应解耦并路由、应按指令实现的检查项,共 12,172 条,沿 RF、IR、VQ 汇总;IR 再拆 IRDR 与 IRTC。
- 基准构造:有权使用的内部视频,按任务用跨片段匹配或专用工具做参考,指令从目标描述改写并去掉应向参考泄漏的信息,全部人工核对。
- Omni-R2V 流水线:源视频切分与质量过滤 → 跨对匹配或从目标逆提取/生成参考 → 过滤可见性 → Gemini-3.1-Pro 分别描述参考与目标,DeepSeek-V4-Pro 按任务规则写成训练指令。
- 数据规模:339,570 条;时长可到 20 秒;分辨率 480p 到 2160p+,以 1080p 与 2160p+ 为主;含 2D/3D 动画与实拍。
逐图理解论文
失败直觉
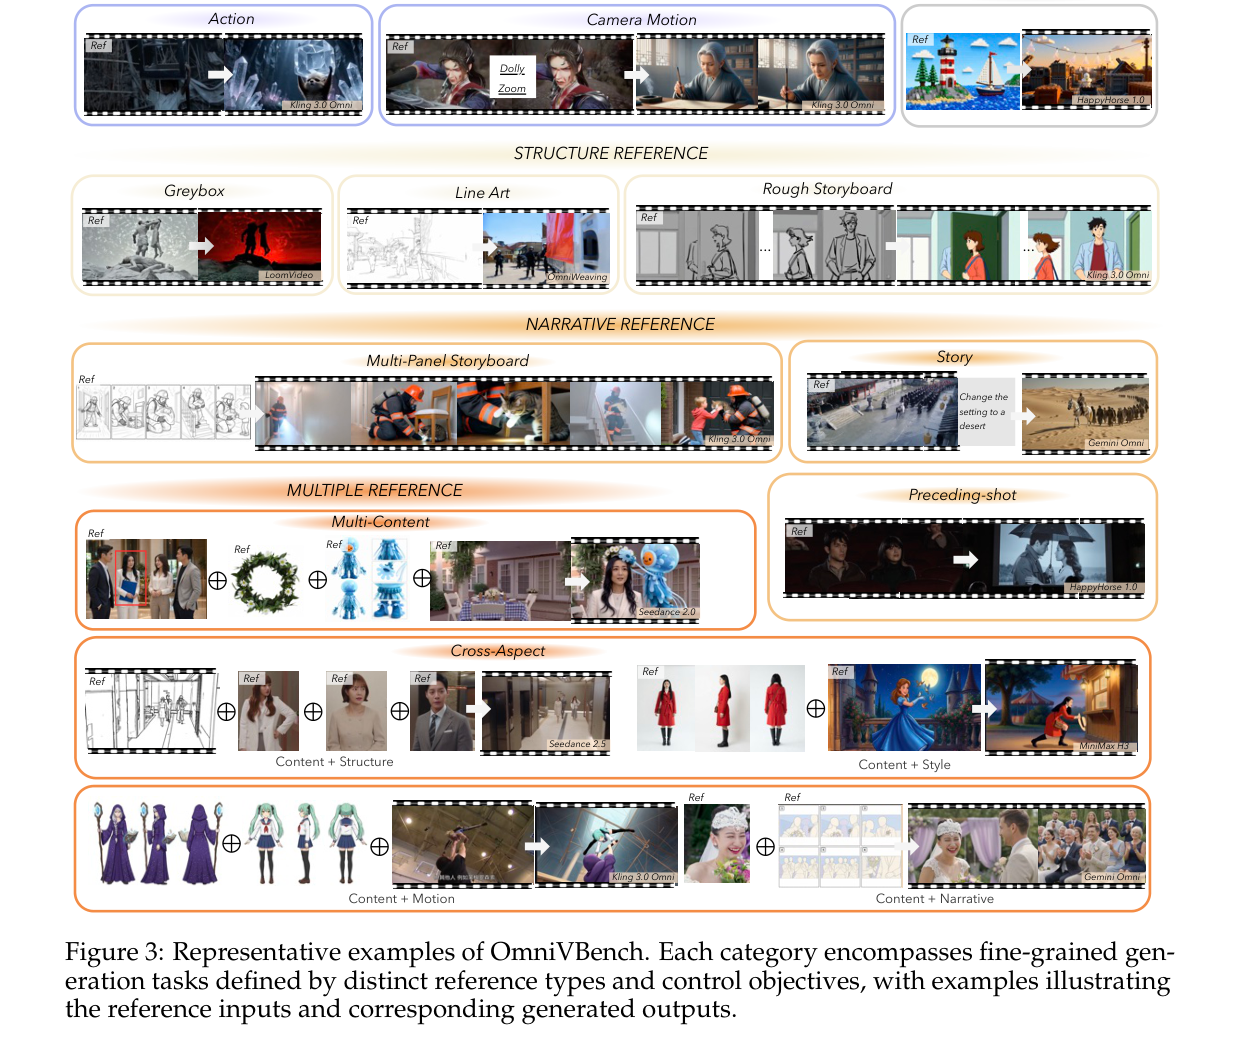
这张裁切没有内容参考。从上往下看 Action/Dolly Zoom、Greybox/线稿/粗分镜、故事板与改沙漠、多图相加,以及 Content+Structure/Style/Motion/Narrative。每组先认 Ref 胶片再看生成。它说明参考类型有多杂,不是谁得分最高。
研究缺口
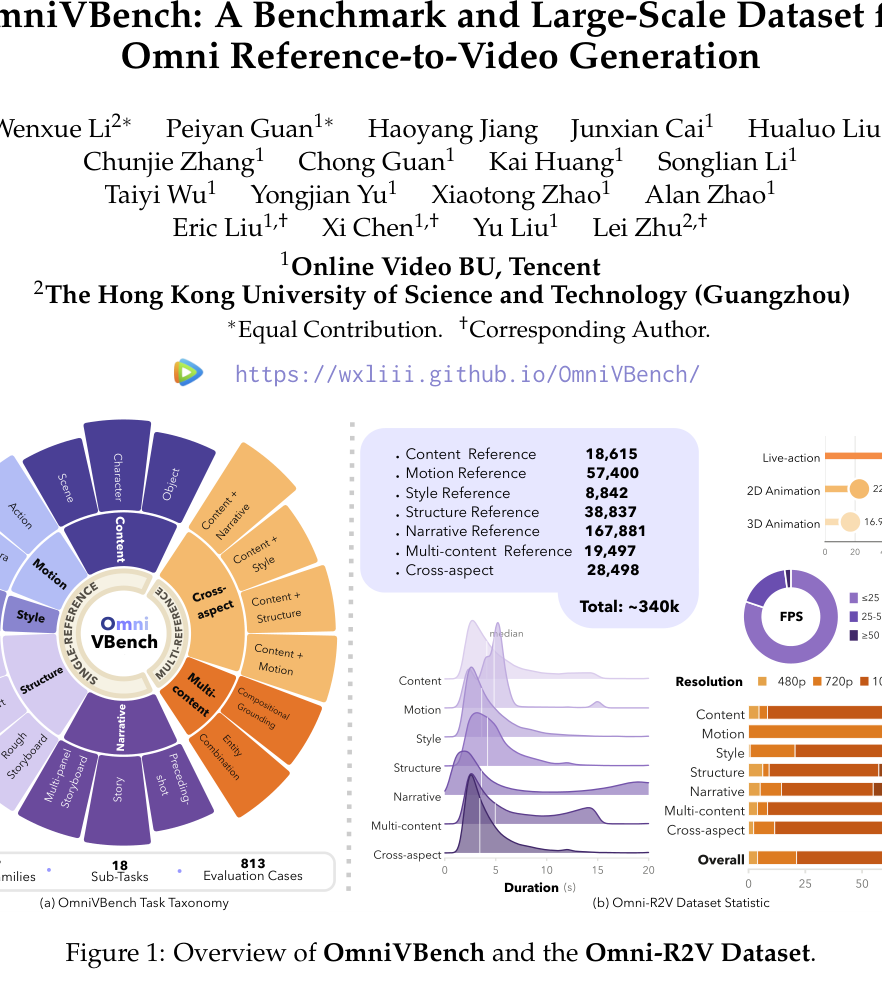
左轮是评测分类:内环单参考五类,外环多内容与跨要素;底栏 18 细任务、813 case。右栏紫框是训练集约 340k 的分项,Narrative 167,881 最大。时长密度横轴到 20s。不要把右侧条形当成模型榜。这张适合当特色图。
关键机制
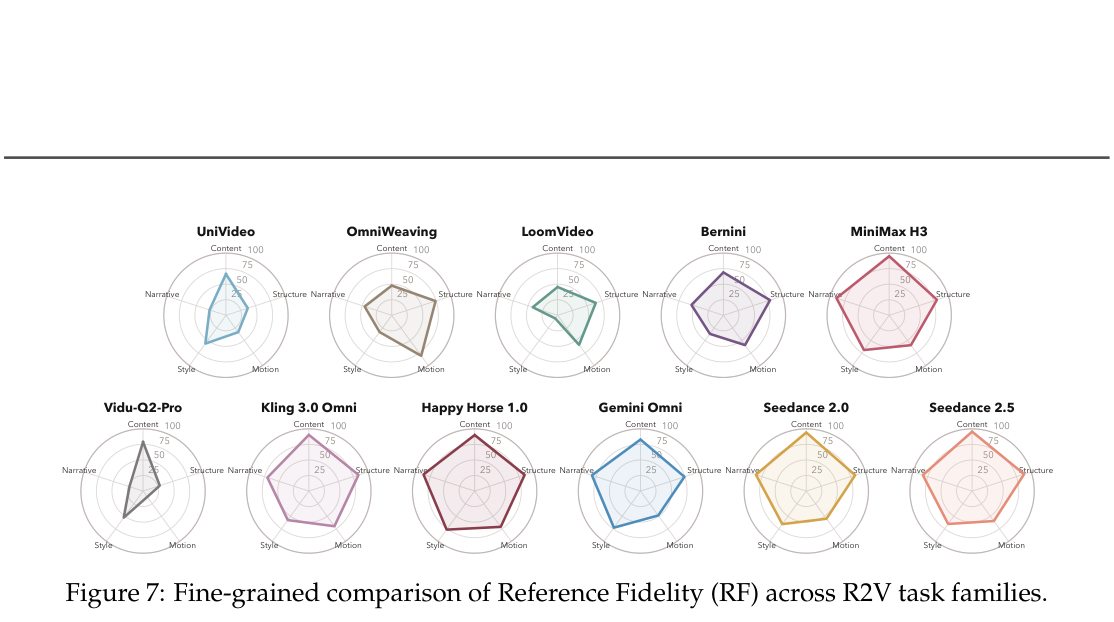
十一张雷达都是 Reference Fidelity 五轴,不是 Overall。先看 MiniMax H3 和 Seedance 是否更满,再看 UniVideo 等是否在 Narrative/Motion 瘪掉。轴上没有印刷精确分,总分请回到 Table 3 的 72.68/72.41。
实验如何设计?
- 开源:UniVideo、OmniWeaving、LoomVideo、Bernini、MiniMax H3(官方 H3-Context-IR 预处理)。闭源:Vidu-Q2-Pro、Kling 3.0 Omni、Happy Horse 1.0、Gemini Omni、Seedance 2.0、Seedance 2.5。
- Table 3 每个任务分是 RF/IR/VQ 平均;再给 Overall。Figure 6 看三维落差,Figure 7 看 RF 五轴。
- Table 4 报各任务族的 IRDR 与 IRTC。
- 协议校验:100 个覆盖 18 细任务的 case、965 个输出,三人独立五分制,计算自动分数与人工相关;再对比整体式打分与因素清单。
关键结果与论文证据
- Table 3(第 9 页)Overall:Seedance 2.5 72.68,MiniMax H3 72.41 已接近最强闭源;Seedance 2.0 70.91、Happy Horse 1.0 70.89、Gemini Omni 70.76;UniVideo/OmniWeaving/LoomVideo 约 49–51。Content 列普遍最高,Narrative/Motion 更低。
- 作者强调开闭源总分差距在收窄,但没有模型在所有任务族都稳;内容好不代表运动或跨要素好。
- Figure 7:雷达上 Content 轴普遍更满,Motion/Narrative 缺角在开源前排尤其明显,MiniMax H3 与若干闭源更接近正五边形。
- Table 4:多内容与跨要素上不少模型 IRTC 明显高于 IRDR,会跟目标走但仍把因素接到错误对象。
- Table 5–6(第 10 页):RF/IR/VQ 与人工 Spearman 0.77/0.74/0.82;因素清单高于整体式(RF 0.77 vs 0.67)。
阅读时需要注意
- 工作本身不训练新的 omni 生成器,只提供评测与数据。
- 内部专业成片为主,对用户随手拍摄的外推未验证。
- 现有模型在运动、叙事、结构与多参考上仍明显弱于内容复制。
关联工作
- OpenS2V、VACE、UniVBench 等把评测重心放在主体/内容组合,OmniVBench 用 Table 1 把缺口画全。
- OpenS2V-5M 更大但任务覆盖窄;Omni-R2V 强调已处理样本和视频参考。
- Seedance、Kling Omni、Gemini Omni、MiniMax H3 是当前可测的 omni 接口,文中当评测对象而非自家方法。