快速导读:MAGIC 在冻结的 ColPali 风格页面补丁向量上,用检索需求源边际与均衡目标边际做双边际熵正则最优传输,免训练地压成少量 facet。
视觉文档检索要把版式、表格、小字段一起找出来,ColPali 一类多向量检索器用页面补丁嵌入加 MaxSim,细但贵:一页存数百个向量,在线还要每个查询 token 扫一遍。事后压缩想在抽完嵌入之后再把 N 个补丁收成 K 个 facet,检索器冻结、不必重训。香港理工大学与南方科技大学的 MAGIC 指出,现有合并常用均匀重构,和 MaxSim 的稀疏、非均匀补丁使用对不上。
MAGIC 把压缩写成双边际熵正则最优传输:源边际按校准得到的检索需求给补丁加权,目标边际把容量均摊到保留 facet,索引阶段离线算完,在线仍是压缩向量上的标准 MaxSim。ViDoRe 上它在中等与激进 keep-ratio 都拿到最强事后平均,紧预算时相对 Light-ColPali 的优势更大。代码见 github.com/xandery-geek/MAGIC。
英文题目:MAGIC: Marginal-Guided Compression with Optimal Transport for Efficient Visual Document Retrieval
论文出处:arXiv 每日论文精选 · arXiv:2609.21018
原始论文:PDF / 论文页面
这篇论文解决什么问题?
MaxSim 对每个查询 token 只取最相似的那个补丁。诊断里,页面上大约前 20% 的补丁承担了约 84% 的 token 选择,其余补丁几乎不进分数。均匀重构却同等惩罚所有补丁误差,等于把稀缺的 K 个名额分给很少被问到的区域。
另一边,若对 facet 使用不加约束,查询相关补丁会堆到少数代表上,有效活跃 facet 数 Keff 远低于预算,覆盖误差 Cerr 随 keep-ratio 变紧迅速上升。Light-ColPali 这类合并在中等预算还过得去,一到 r=0.01 就和需求结构打架。
学习式压缩要改训练或加模块;剪枝在紧预算更脆。缺口是:冻结核、只改索引,但让补丁权重跟着检索需求走,同时迫使保留向量都被用起来。
核心创新
- 诊断查询无关事后合并的两边误分配:均匀补丁权重忽略集中的检索需求,无约束 facet 使用会让有效活跃数远低于预算。
- 把 MaxSim 退化上界写成需求加权代理,再实例化为双边际熵正则最优传输。
- 校准需求源边际与均衡目标边际互补,紧 keep-ratio 下增益更大,且不重训检索器。
方法概览
先由 MaxSim 选择概率定义补丁检索需求 w,并证明压缩后正分数下降受需求加权覆盖误差上界约束。索引时用与评测查询不相交的校准查询 token 池,经视觉激活与多样性 farthest-first 估计源边际 a=N ŵ;目标边际取均匀 bak=(Σa)/K。对代价 c=1−d⊤f 做熵正则双边际 OT,Log-Sinkhorn 与阻尼球面重心交替更新 facet,最后用需求加权球面 Lloyd readout。在线检索仍是压缩 facet 上的标准 MaxSim。
- 代理目标:令 w_j 为查询 token 选中补丁 j 的概率。在单位向量假设下,压缩造成的正 MaxSim 下降期望被需求加权的 ||d_j−f_π(j)|| 上界住,从而得到 L_RD=Σ w_j(1−d_j⊤f_π(j))。低需求补丁的重构误差几乎不进代理。
- 源边际:索引时用与评测不相交的训练查询构造 Q_cal。先从训练页补丁 farthest-first 建视觉词典,再按视觉激活 vis(q) 与多样性选 L_cal 个 token,softmax 温度 τ 得到 ŵ,令 a_j=N ŵ_j。
- 目标边际:b_k=(Σ_j a_j)/K,阻止传输质量堆到少数 facet,但不强制最终簇大小完全相等。
- 求解:松弛硬分配并加熵 ε,得到 min_{F,T∈U(a,b)} Σ T_kj c(f_k,d_j)+ε Σ T_kj(log T_kj−1)。facet 用 farthest-first 初始化,内层 log-domain Sinkhorn 更新 T,外层按行归一化做阻尼球面重心;最后球面 Lloyd:每补丁归最相似 facet,再按 a_j 加权归一化均值。空簇保留传输重心。
- 部署:默认 L_cal=1000、τ=0.05、ε=0.05、Tout=5、Tsk=5。压缩只在离线索引发生,查询路径不改。
逐图理解论文
失败直觉
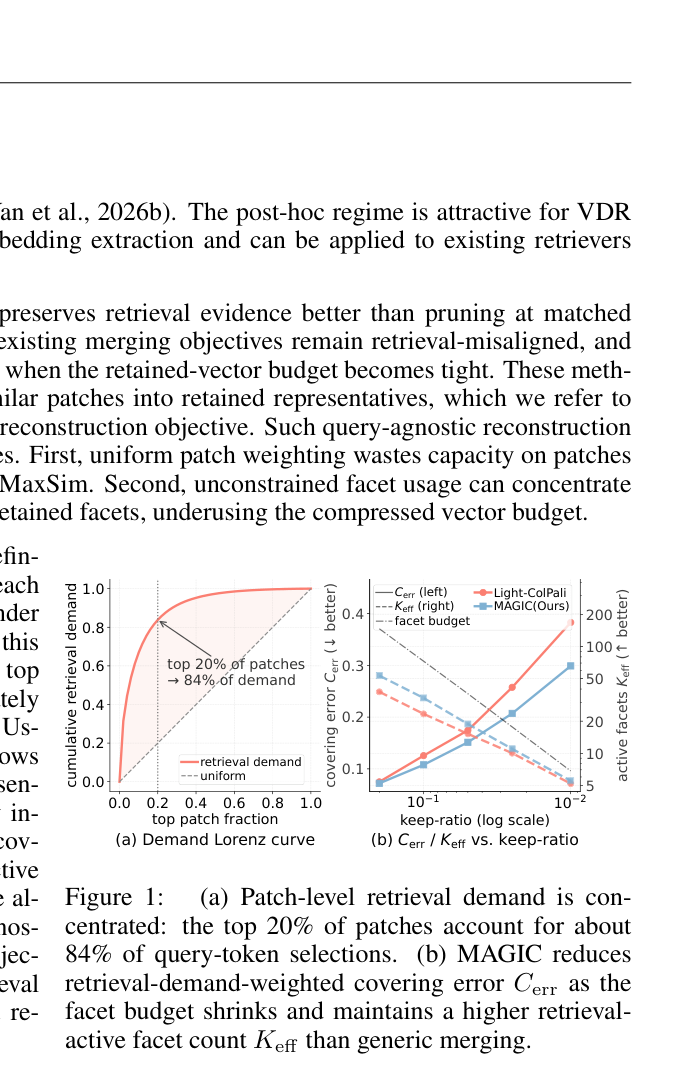
不要读左侧被裁进来的引言。左图 Lorenz:红线远高于均匀对角线,箭头写 top 20% 补丁约占 84% 需求。右图随 keep-ratio 变紧,红 Light-ColPali 的 Cerr 升、Keff 虚线低于预算;蓝 MAGIC 的 Cerr 更低、Keff 更高。它解释为何要双边际,不是 nDCG 榜。
研究缺口
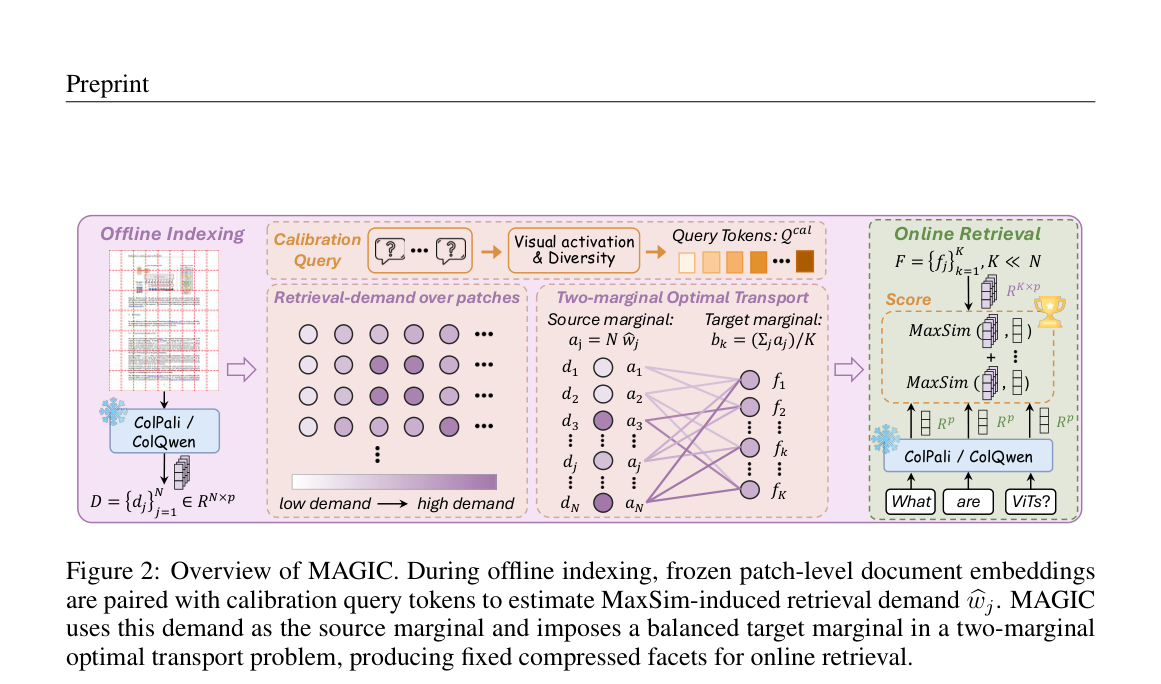
先看左列冻结 ColPali/ColQwen 抽出带红格的页面补丁,再看上方校准查询经视觉激活与多样性得到 Q_cal。中间热图颜色越深需求越高;右边 OT 明确写出源边际 a_j=N ŵ_j 和目标边际 bak=(Σa)/K,紫线把补丁质量分到 K 个 facet。绿框强调在线只对压缩向量做 MaxSim,查询词 What are ViTs? 只是示意。这张应做特色图。
关键机制
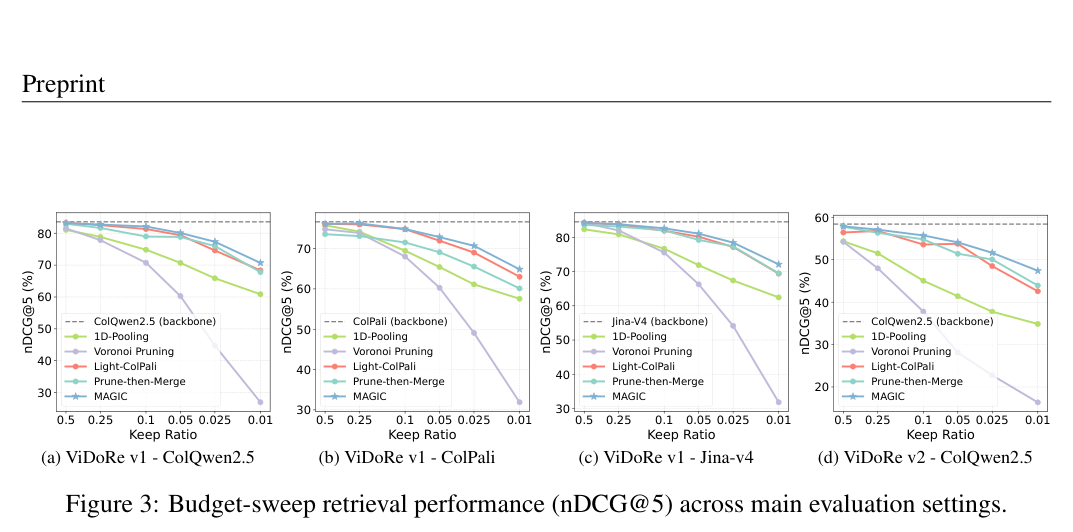
四张都是 nDCG@5 对 Keep Ratio。先看 (a) ColQwen2.5:蓝 MAGIC 贴着或高于红 Light-ColPali,紫 Voronoi 在 0.01 崩到约 30。再扫 (b)(c) 换骨干、(d) ViDoRe v2 轴更低。用来说明增益不绑在单一 r,精确两点请用 Table 1 的 82.12 与 71.04。
实验如何设计?
- 冻结检索器默认 ColQwen2.5;K=min{N,max(1,⌈rN⌉)},事后方法在近似匹配的保留向量数下比。主基准 ViDoRe v1,迁移用 ViDoRe v2,附录含 ViDoSeek。
- 事后对照:1D/2D-Pooling、K-Means、DocPruner、Voronoi Pruning、Light-ColPali、ColChunk、Prune-then-Merge。指标 nDCG@5 与 Recall@5(百分数)。
- 主表报 r=0.1 与 r=0.01;Figure 3 扫 0.5 到 0.01,并换 ColPali、Jina-v4。消融拆源/目标边际与 Lloyd,再扫迭代、ε、校准策略与 token 数。
- 效率在 2000 页、平均 743.5 向量/页上测 MB/1K、ms/query 与 ms/page。
关键结果与论文证据
- Table 1(第 7 页):r=0.1 时 MAGIC 平均 82.12/88.39,Light-ColPali 81.32/87.99;r=0.01 时 MAGIC 71.04/80.00,相对 Light-ColPali +2.70/+2.87、相对 ColChunk +0.95/+1.79。Voronoi Pruning 在 r=0.01 掉到 26.98/33.21。
- Figure 3(第 8 页):四条预算曲线上 MAGIC 全程处在合并方法上沿,keep-ratio 变小后与 pooling/剪枝的开口变大;换 ColPali、Jina-v4 和 ViDoRe v2 趋势仍在。
- Table 2:源边际在紧预算最关键,均匀源使 r=0.01 的 nDCG@5 从 70.71 掉到 61.88;均衡目标与 Lloyd 提供更小但同向的增益。
- Table 3(第 9 页):r=0.01 时 MAGIC 3.86 MB/1K、0.06 ms/query,相对未压缩 380.67 MB、0.98 ms 约 99× 存储与 17× 延迟;离线 119.91 ms/page,接近编码 112.62,低于 Light-ColPali 的约 213。
- Figure 1 诊断与 Figure 6/9 定性:压缩后 MaxSim 选中的 facet 回投到源补丁,高亮仍落在答案字段附近(如 DocVQA 采购单号)。
阅读时需要注意
- 校准查询池若代表不了稀有意图或领域版式,需求估计会偏,对应补丁可能被牺牲。
- 极端压缩下小字段和密表仍可能进不了任何一个 facet。
- 换骨干必须重做校准与压缩,因为嵌入空间不同。
关联工作
- ColPali 把 ColBERT 式晚交互搬到页图;后续 ColQwen、Jina-v4 等是可冻结的多向量骨干。
- Light-ColPali 用层次聚类做事后合并,是最强均匀合并对照,也是复杂度对照:其代价几乎不随最终 K 下降,而 MAGIC 优化 K×N 传输。
- DocPruner、Voronoi Pruning 代表剪枝;ColChunk、Prune-then-Merge 代表其他合并/混合事后策略。
- Sinkhorn 熵正则 OT 提供可微、可加双边际的分配工具,这里被当成压缩机制而不是生成模型。