快速导读:PePESeg3D 把单目深度与掩码先验同时注入三维高斯重建与对比特征学习,在 SPIn-NeRF、LERF-Mask、NVOS 上同时抬高多尺度分割与重建质量。
三维高斯溅射(3DGS)把场景拆成可单独附特征的高斯原语,天然适合从部件到整物的多尺度分割。但多尺度管线常先做光度重建、再学分割特征:几何不知道语义边界,后续特征只能在错位骨架上长;监督又依赖 SAM 网格点提示,掩码粒度乱、跨视角残缺,对比学习信号稀疏。
KAIST 的 PePESeg3D(BMVC 2026)主张:感知先验不能只当特征正则,还要进上游几何。PePE Reconstruction 用掩码边界 refinement 与单目深度对齐;PePE Contrastive Learning 再用深度—颜色突变与跨视角质心,补上 SAM 的空洞。代码公开于 https://github.com/BeCow5X5/PePESeg3D。
在 SPIn-NeRF、LERF-Mask、LERF-Mask-Fine、NVOS 上,方法同时刷新多尺度分割与重建指标,并在专攻单粒度的强基线旁保持竞争力,说明“语义对齐的几何骨干”是多尺度三维分割的关键前置条件。
英文题目:PePESeg3D: Perception Prior Enhances Multi-Scale Segmentation for 3D Gaussian Splatting
论文出处:arXiv 每日论文精选 · arXiv:2609.28645
原始论文:PDF / 论文页面
这篇论文解决什么问题?
单尺度 3DGS 分割可与 SAM 唯一真值图联合优化;多尺度因一张图叠多层粒度,联合优化不稳定,业界改成几何与特征顺序训练。作者指出两条连锁失败:仅光度初始化的高斯边界与物体边界错位,错位会原样传进特征场;SAM 掩码在多粒度下更不一致,局部实体被漏标。
相关工作里,OmniSeg3D 等用有限离散层级,GARField/SAGA 则把尺度写成连续物理量。PePESeg3D 站在连续尺度一侧,但强调若几何本身语义失配,再精巧的尺度门控也难救边界。
因此问题被重写为:如何把二维感知先验同时写进三维重建与尺度感知特征学习,使多视角、多粒度分割既干净又一致。
核心创新
- 把感知先验提前灌进几何:掩码边界 refinement + 单目深度约束,形成语义对齐的高斯骨干。
- 用深度—颜色突变补 SAM 空洞,感知对比损失只在掩码不可靠区域起作用。
- 在 s=1.0 / 0.01 维护跨视角 EMA 质心,约束尺度门控特征的全局一致性。
方法概览
两阶段:PePE Reconstruction 用 SAM 掩码驱动边界附近高斯 refinement,并用单目深度经尺度—平移对齐做 Ldepth,与光度损失组成 Lrecon;再给每个高斯挂特征与 scale gate。PePE Contrastive Learning 用尺度感知对比损失 Lm、基于深度—颜色差阈值的感知对比损失 Lp、极端尺度上的跨视角质心损失 Lc,外加单位范数正则,合成 Lcont。
- 总流程两段。重建段先得到与语义边界对齐、深度分布受单目先验约束的高斯骨干;再为每个高斯附加特征,并按掩码物理尺度进入对比学习段。
- PePE Reconstruction:按掩码像素数从小到大处理,优先细部。把三维高斯投到二维,若主轴与掩码边界相交则 refinement,且只改“投影深度与渲染深度差最小”的前 10% 表面候选,避免背景被拆碎。单目深度估计算相对深度,经最小二乘求最优尺度与平移后做 L1 深度损失,与 L1 + D-SSIM 光度项组成 Lrecon;约第 4000 步起做 refinement 引导的初始化。
- PePE Contrastive Learning:查询尺度 s 下 alpha 混合渲染特征,用余弦相似度衡量像素对关系。尺度感知对比损失按 Λ(s,p) 选与 s 匹配的最细掩码,并允许更细掩码内的像素在粗尺度仍被视为同类,以保持层级一致性。
- 感知对比损失在尺度自适应窗口内,用深度差与颜色差相对局部均值+标准差的阈值划分相似/不相似对;仅当像素对至少一侧缺少可靠掩码时启用,避免与明确掩码监督冲突。
- 视角一致质心损失在 s=1.0 与 s=0.01 用 HDBSCAN 提候选,余弦相似度>0.9 的做 EMA 合并,每隔固定步数用随机训练视角刷新;当前视角只吸引相似度>0.9 的像素。另加三维与二维特征单位范数正则。总损失 Lcont = Lm + λp Lp + Lc + Lr。
逐图理解论文
失败直觉
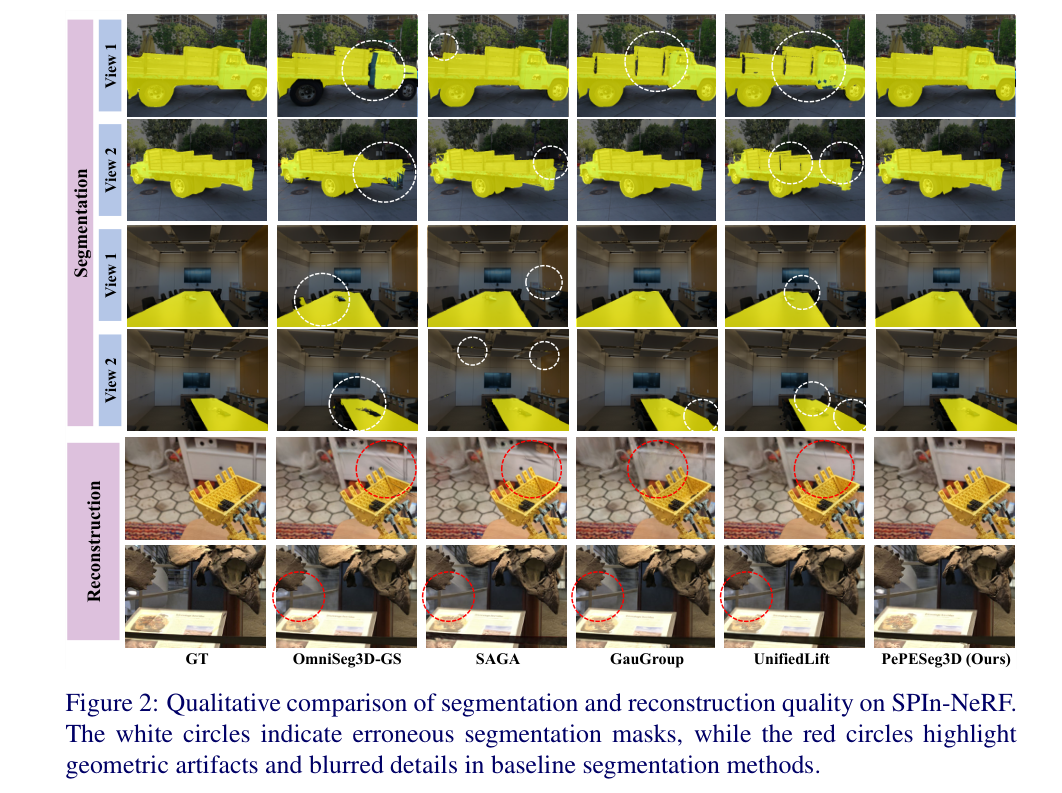
SPIn-NeRF 定性对照。上四行分割:黄卡车与长会议桌两视角,对照 GT、OmniSeg3D-GS、SAGA、GauGroup、UnifiedLift 与 Ours;白虚线圈标基线漏割、溢边或碎掩码,Ours 更贴近 GT。下两行重建:玩具挖掘机与恐龙头骨,红圈标基线模糊与伪影,Ours 边缘更利。读图时把圈注与 Table 1 的 mIoU/PSNR 一起看。
方法贡献
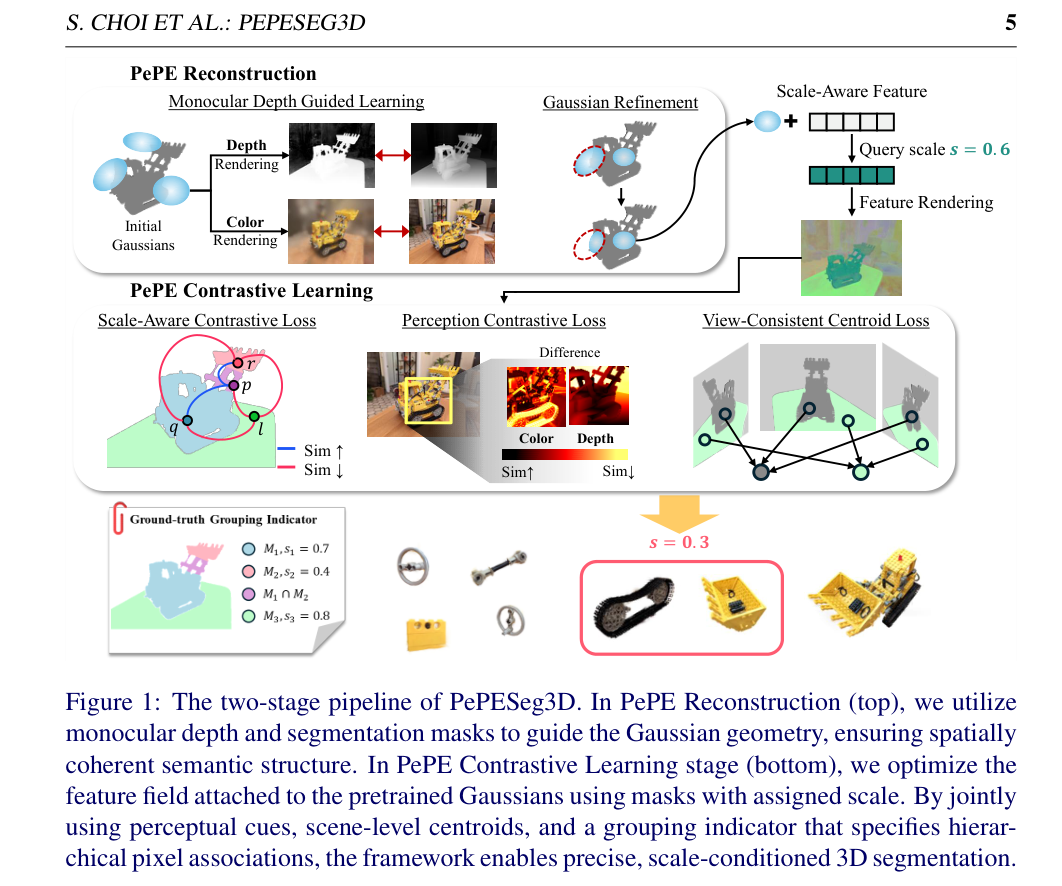
两阶段总览。上半 PePE Reconstruction:初始蓝色散点高斯经深度与颜色渲染对齐,边界处 refinement,再与查询尺度 s(示例 0.6)拼特征并渲染语义图。下半 PePE Contrastive Learning 三块损失:尺度感知对比(同掩码拉近、异掩码推远)、感知对比(颜色/深度差热力图)、跨视角质心连线。底部给出层级分组指示与 s=0.3 时挖掘机被拆成方向盘、履带、铲斗等部件。适合做方法总图与特色图。
核心结论
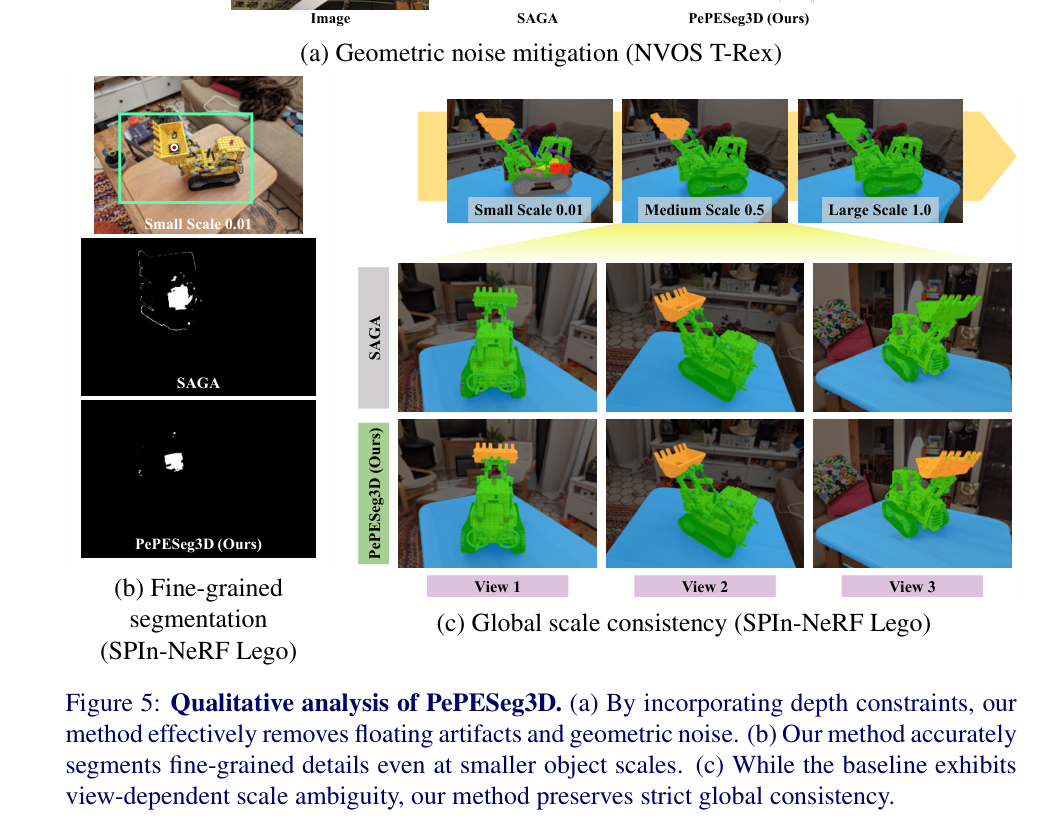
三块机理验证。(a) NVOS T-Rex:相对 SAGA,深度约束压掉骨架与墙之间的浮空高斯噪点。(b) SPIn-NeRF Lego 小尺度 0.01:SAGA 掩码破碎,Ours 更完整。(c) 同场景三视角:SAGA 在不同视角把铲斗/车身颜色关系打乱,Ours 保持铲斗橙、车身绿的全局一致。用来解释“重建先验 + 质心约束”各自解决什么失败。
实验如何设计?
- 基准覆盖混合粒度(SPIn-NeRF)、文本引导粗目标(LERF-Mask)、部件细粒度(LERF-Mask-Fine)与复杂细节(NVOS)。SPIn-NeRF/LERF-Mask 走标签传播:参考视角 HDBSCAN 质心,其他视角相似度>0.7 关联;NVOS/Fine 用参考掩码采样点平均提示,相似度>0.9 检索。
- 重建质量报 PSNR、SSIM、LPIPS。基线含 Gaussian Grouping、UnifiedLift、OmniSeg3D-GS、SAGA、OpenSplat3D 等,作者称均用官方实现与协议复现。
- 实现:重建 30k 迭代;λph=0.2、λd=0.05;掩码来自 SAM ViT-H;对比段几何冻结。定性图用白圈标分割错误、红圈标重建伪影。
关键结果与论文证据
- SPIn-NeRF(Table 1):PePESeg3D 取得 mIoU 92.3%、mAcc 98.9%,重建 PSNR 26.81 / SSIM 0.857 / LPIPS 0.142,分割与重建均为表中最优;相对最强单尺度 UnifiedLift 的 mIoU 拉开 7.3 百分点,说明单固定粒度难以覆盖细部。
- LERF-Mask 多尺度组(Table 2):80.5/76.5 mIoU/mBIoU,相对 SAGA 提升约 2.1/2.5 百分点,同时仍接近专攻粗目标的单尺度强方法。LERF-Mask-Fine(Table 3)上单尺度常崩到 15–23% mIoU,本文 70.8%,略高于 SAGA 69.6%。
- NVOS(Table 4–5):分割 mIoU 92.2%,重建相对 SAGA 约 +1.22 dB。Figure 2 显示基线易把卡车/桌面与背景糊在一起或碎成多块;Figure 5 显示深度先验去掉 T-Rex 浮空噪点,小尺度 s=0.01 掩码更完整,且跨视角颜色分配不再随视角翻转。
- 作者结论:先把高斯几何做成语义一致骨架,再学多尺度特征,比只在错误几何上堆对比损失更有效。
阅读时需要注意
- 尺度门控在共享特征空间上工作,上下尺度通道会互相串扰,物理尺度接近的两类实体可能分不开。
- 面对 SAM 也认不全的复杂连通结构,感知损失只能缓解不能根治碎片掩码。
- 尺度在场景内归一化,跨场景同一 s 不对应同一绝对尺寸,部署时需参考物或短扫描。
- 系统仍绑定 2D 基础模型质量;单目深度的尺度歧义需要训练日程上的权重衰减来压冲突。
关联工作
- SAGA 提供连续尺度门控亲和特征,是本文多尺度主对照。
- OmniSeg3D / Click-Gaussian 代表离散或概念双层粒度路线。
- Gaussian Grouping、Unified-Lift、Feature-3DGS 代表单尺度或特征蒸馏路线,用来证明多尺度方法不必牺牲粗粒度精度。
- GARField 的连续尺度条件化是概念近邻,但未把感知先验同时灌进几何优化。