快速导读:MoVISA 用对象-帧对齐的多个 <SEG> token 替代单一全局分割 token,结合 InternVL 与 SAM2 记忆传播,在 MeViS/ReVOS 等指代与推理视频分割基准上提升细粒度时空对齐。
指代视频目标分割要求模型根据自然语言,在整段视频里持续标出目标掩码。近年把多模态大模型接到分割头上很流行:LISA 一类方法用特殊 token <SEG> 的隐状态解码掩码,VISA、Sa2VA 再把它推到视频,并借助 SAM2 记忆做时序传播。
但单一全局 <SEG> 会把整段时间里的外观变化压成一个向量。对“绕圈跑的马”“先向前再转身的羊”这类时序锚定表达,信息瓶颈很明显。UIUC 的 MoVISA(arXiv:2609.28956,预印本,尚未同行评审)提出:为每个对象-帧对分配独立的 <SEG> token,让语言与时空掩码在更细粒度对齐。
英文题目:MoVISA: Multi-Token Reasoning for Video Object Segmentation
论文出处:arXiv 每日论文精选 · arXiv:2609.28956
原始论文:PDF / 论文页面
这篇论文解决什么问题?
视频里目标会经历姿态、尺度、遮挡与身份混淆;若所有关键帧共用同一分割嵌入,模型难以在每一帧保留局部空间线索。
Sa2VA 虽用 SAM2 memory 传播关键帧掩码,关键帧监督仍来自单一 token,长程跟踪与杂乱场景下仍易欠表示。
VRS-HQ、GLUS 等尝试时序抽象或多样化邻接 token,但仍缺少显式的帧级、对象级分割监督。
核心创新
- 提出对象-帧对齐的多 token 提示,使语言与时空掩码在帧级粒度对齐,而非压成单一 <SEG>。
- 与 SAM2/MLLM 端到端整合:关键帧多 token 掩码 + memory 传播,无需外部 VOS 或启发式后处理。
- 消融表明 Frame-Object Tokens 优于 Single-Token 与仅 Frame Tokens;生成式指令监督优于 decoder-only 插入 token。
方法概览
MoVISA 在 vision-language 指令中为每个对象-帧对分配可学习索引 token <SEG>_{o,t}(K=O·T)。InternVL 骨干编码采样关键帧与语言,经 LoRA 微调的 LLM 自回归生成多枚 <SEG>;其末层隐状态经 MLP 适配器进入 SAM2 mask decoder,仅在关键帧监督掩码,再由 SAM2 memory bank 传播到非关键帧。训练联合 L_text(token 序列交叉熵)与 L_mask(BCE+Dice);图像视为单帧视频以统一多模态。
- 任务形式:给定视频 I_{1:T} 与语言 R,预测掩码序列 M_{1:T}。MoVISA 在指令中动态构造 K=O·T 个可学习索引 token,索引 k=(i-1)·T+m 对应第 i 个对象、第 m 个采样帧。
- 骨干沿用 InternVL 视觉编码:每帧压缩为约 256 visual tokens,视频通常采样 5 个关键帧,按时间顺序拼到语言指令前;LLM 用 LoRA 微调,自回归输出结构化 <SEG> 序列。
- 每枚 <SEG> 末层隐状态经两层 MLP 投到 SAM2 prompt 空间,解码关键帧二值掩码;关键帧掩码写入 memory bank,再经 memory attention 传播到非关键帧。图像当作单帧视频,仅需一枚对象 token,便于图文共训。
- 损失为 L_instruction=L_text+L_mask:L_text 监督正确的索引 token 序列,L_mask 为像素 BCE 与 Dice。另支持 <vp> 视觉提示注入,把裁剪目标特征包进对话以保持多轮对象身份。
逐图理解论文
单token瓶颈
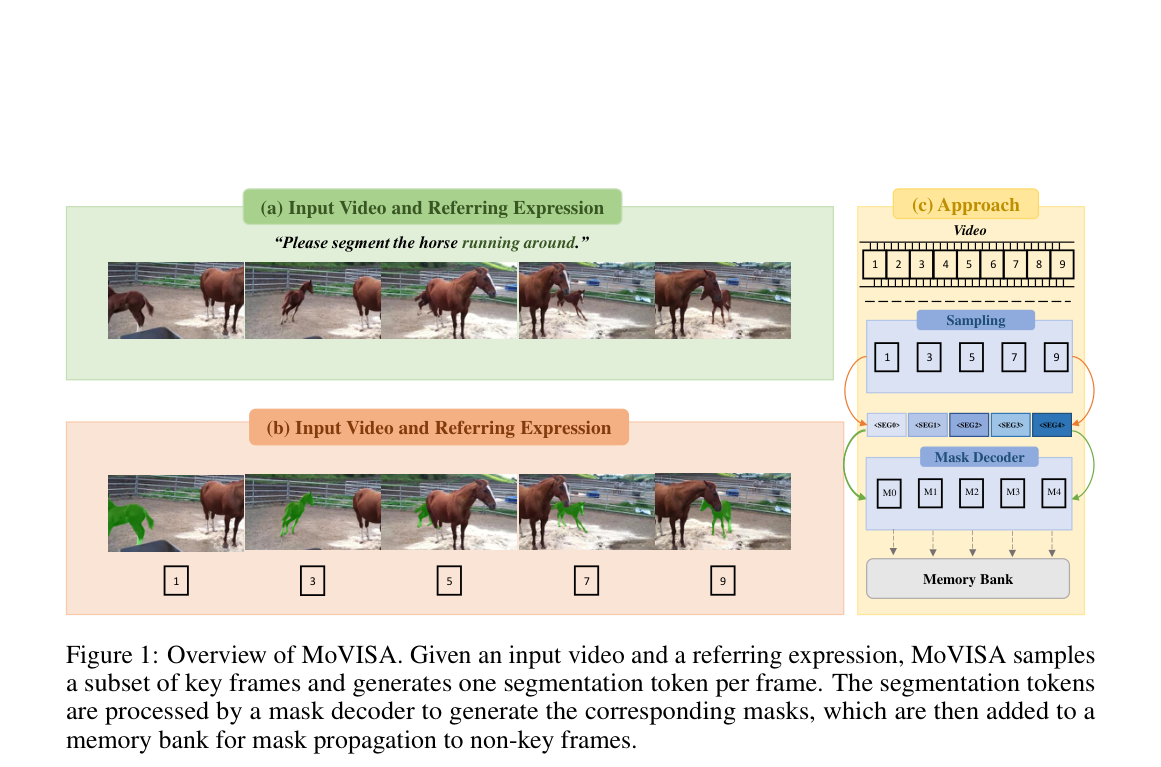
图1总览:输入视频+指代表达(如“请分割绕圈跑的马”),采样关键帧并生成每帧一枚 <SEG0>…<SEG4>,经 mask decoder 得到 M0–M4 写入 memory bank,再传播到未采样帧。适合作为方法主图与特色图。
系统框架
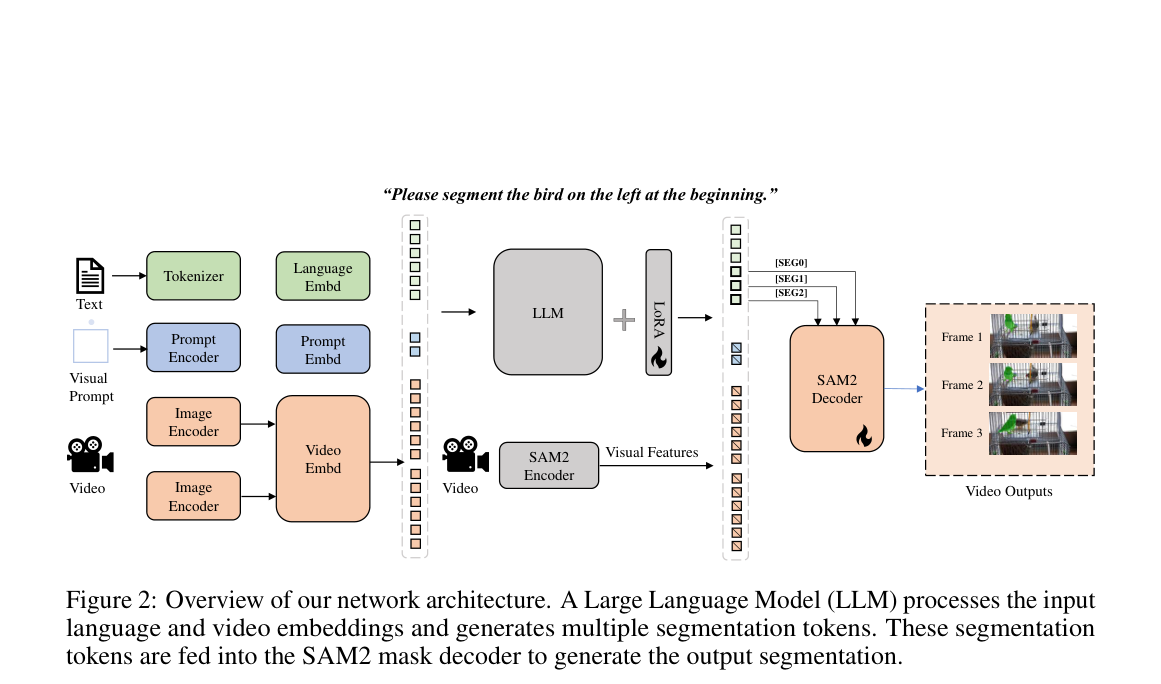
图2架构:文本/视觉提示/视频三路嵌入进入带 LoRA 的 LLM,输出多枚 [SEG];并行 SAM2 Encoder 提视觉特征,与 [SEG] 一并送入 SAM2 Decoder 生成各帧掩码。
结论与局限
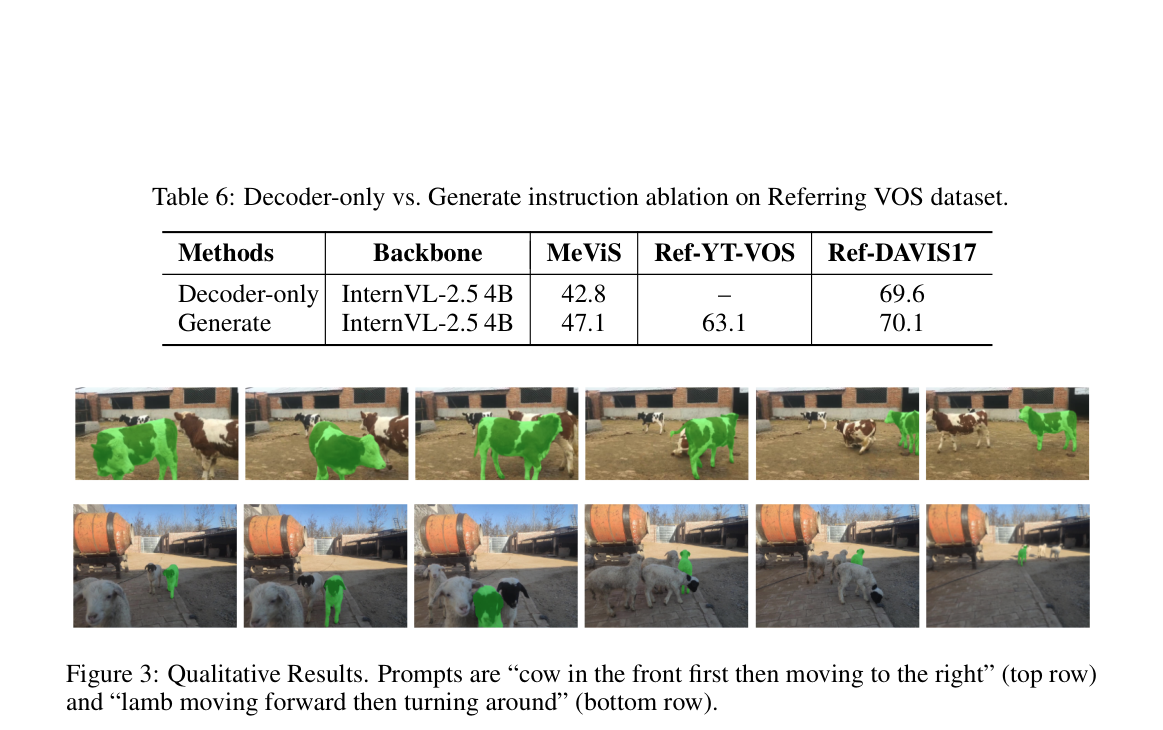
图3(同页含表6):Generate 相对 Decoder-only 在 MeViS 上 47.1 vs 42.8;定性两行展示牛右移与羊掉头的绿色掩码跟踪,体现时序行为指代能力。
实验如何设计?
- 两套配置:MoVISAV 用 InternVL-2.5 4B、约 5.8K 视频数据(MeViS/Ref-YTVOS/ReVOS);MoVISAVIR 用 InternVL-2.0 1B,再加 RefCOCO 系约 56K 图像与 Ref-SAV 约 37K。
- 评测:MeViS、Ref-YouTube-VOS、Ref-DAVIS17 与推理基准 ReVOS,主指标 J&F。训练冻结视觉编码器,LoRA 学习率 4e-5,序列最长 8192,六张 A6000。
- 消融:去掉图像+Ref-SAV;Single-Token / Frame Tokens / Frame-Object Tokens;Decoder-only 预置 token 仅训掩码 vs Generate 指令。
关键结果与论文证据
- 表2:MoVISAVIR(1B) 在 MeViS 达 47.2 J&F,相对同规模 Sa2VA-1B 的 41.7 提升 5.5 点(相对约 13.2%);Ref-YT/Ref-DAVIS 亦分别高 0.4/0.9。
- 表3:MoVISAVIR ReVOS Overall 51.6 vs Sa2VA-1B 47.6(+4.0,相对约 8.4%);MoVISAV(4B) Overall 53.3,略高于 Sa2VA-4B 的 53.2,且作者强调视频侧数据量更少。
- 表5:Frame-Object Tokens 在 MeViS 为 39.1,显著高于 Single-Token 31.0 与 Frame Tokens 30.9,直接支持“单 token 不够”的主张。
- 表6:Generate 在 MeViS 上 47.1,优于 Decoder-only 的 42.8;图3定性显示模型能跟随“前排牛再右移”“羊前行再掉头”等时序指代。
- 表4:去掉图像与 Ref-SAV 后 MeViS/Ref-YT/Ref-DAVIS 分别掉 8.1/7.3/17.2,说明静态分割与描述性数据对 1B 设定很关键。
阅读时需要注意
- 本文为 arXiv 预印本,结果未经同行评审;横向对比需注意训练数据与骨干不完全对齐。
- 4B 视频-only 的 MoVISAV 在 Ref-YT 与 Ref-DAVIS 低于 Sa2VA-4B,作者归因于缺少图像与 Ref-SAV 共训。
- 主要验证 1B/4B;更大模型、更长视频与密集多目标的扩展仍待研究。勿当作已可用监控或临床产品。
关联工作
- LISA、VISA、Sa2VA 构成单 token 推理分割主线;SAM2 提供可微记忆传播。
- VRS-HQ、GLUS 代表改进特殊 token 设计的并发工作。
- ReferFormer、MTTR、OnlineRefer 等提供经典非 MLLM 基线对照。