快速导读:Rolling-WAM 用阶梯噪声滑动窗把视频-动作联合去噪摊到连续重规划周期,在保持操作成功率的同时大幅降低稳态推理时延。
世界动作模型(WAM)同时生成机器人动作与未来视觉想象,有助于闭环纠错;但若每个重规划周期都要把整段预测视界从纯噪声联合去噪到干净,时延会拖慢动作更新。USC、Brown、复旦与丰田研究院等提出的 Rolling-WAM(arXiv:2609.30247)把联合去噪摊到连续控制周期:维护阶梯噪声的视频-动作滑动窗口,只把即将执行的动作块完全去噪,更远的未来块继续部分精炼。
稳态下每个周期只需总去噪步数的一小部分即可产出下一块可执行动作,同时保留跨块演化的视觉-动作上下文。项目页 https://rolling-wam.github.io/ 。在 LIBERO、RoboTwin 2.0 与 Unitree G1 真人形任务上,它保持有竞争力的成功率,并对标准 Joint-WAM 给出约 4.5× 的稳态重规划加速。
英文题目:Rolling-WAM: World Action Models with Rolling Imagination
论文出处:arXiv 每日论文精选 · arXiv:2609.30247
原始论文:PDF / 论文页面
这篇论文解决什么问题?
闭环操作要求机器人不断根据最新观测重规划,以修正执行误差并响应环境变化。标准联合采样器在每个周期处理整段视频-动作序列,模型反复评估代价高,动作更新被推迟(第1页)。
有些方法部署时直接砍掉未来视频生成以换速度,但也就失去了可显式指导动作的视觉预测。传统 chunk 采样即使执行只吃开头一段,未执行尾部也常被丢弃而不是跨周期复用(第1–2页)。
直觉上近端计划应更具体、远端计划可暂定;滚动扩散在序列生成里已用滑动噪声窗表达这一点。Rolling-WAM 把该机制扩展到视频-动作耦合的操作控制。
核心创新
- 把滚动去噪扩展到联合视频-动作世界模型。
- 跨重规划周期复用部分去噪未来,分摊计算并保留上下文。
- 动作可关注同窗部分去噪的视觉未来,训练推理共享掩码。
- 在仿真与真人形上验证成功率与约 4.5× 加速兼得。
方法概览
维护 W 个阶梯噪声的视频-动作块;每步只完整去噪即将执行块,执行后滚动窗口并追加新噪声块继续精炼;MoT 视频/动作专家经掩码联合注意力耦合,训练匹配滚动噪声剖面。
- 把预测窗分成 W 个时间对齐块 Xj=(v(j),a(j))。滚动噪声日程让即将执行块噪声最低、越远越高;每个稳态周期充分去噪第一块动作供执行,其余块只推进部分去噪(Fig.1,第1页)。
- 执行第一动作块并获得新相机观测后,窗口前移:丢掉已执行块,保留未来块(它们已处在新位置的起始噪声),并在末端追加 σ=1 的高斯噪声新块,再在新观测条件下联合精炼(式3与 Fig.2b)。
- 架构为 Mixture-of-Transformers:视频专家处理当前观测与噪声未来视频 latent,动作专家处理噪声动作;层内掩码联合注意力耦合二者,文本与本体状态经交叉注意力注入。块级噪声水平调制两类 token,使不同精炼阶段可同窗处理(Fig.2a,第3–4页)。
- 注意力掩码(Fig.2c)让动作块主要看见观测与对应视频块,训练与推理共用同一掩码。视频专家自 Wan2.2-TI2V-5B 初始化,动作专家约 1B;默认 N=10、W=5、每块 K=16 动作,故稳态每周期约 N/W=2 步(第5页)。
- 训练混合 initialization 与 rolling 模式(概率约 0.2/0.8),视频与动作同用 shifted noise schedule;损失对两模态分别平均。该方法与其他加速技巧正交,可叠加(第4页)。
逐图理解论文
问题背景
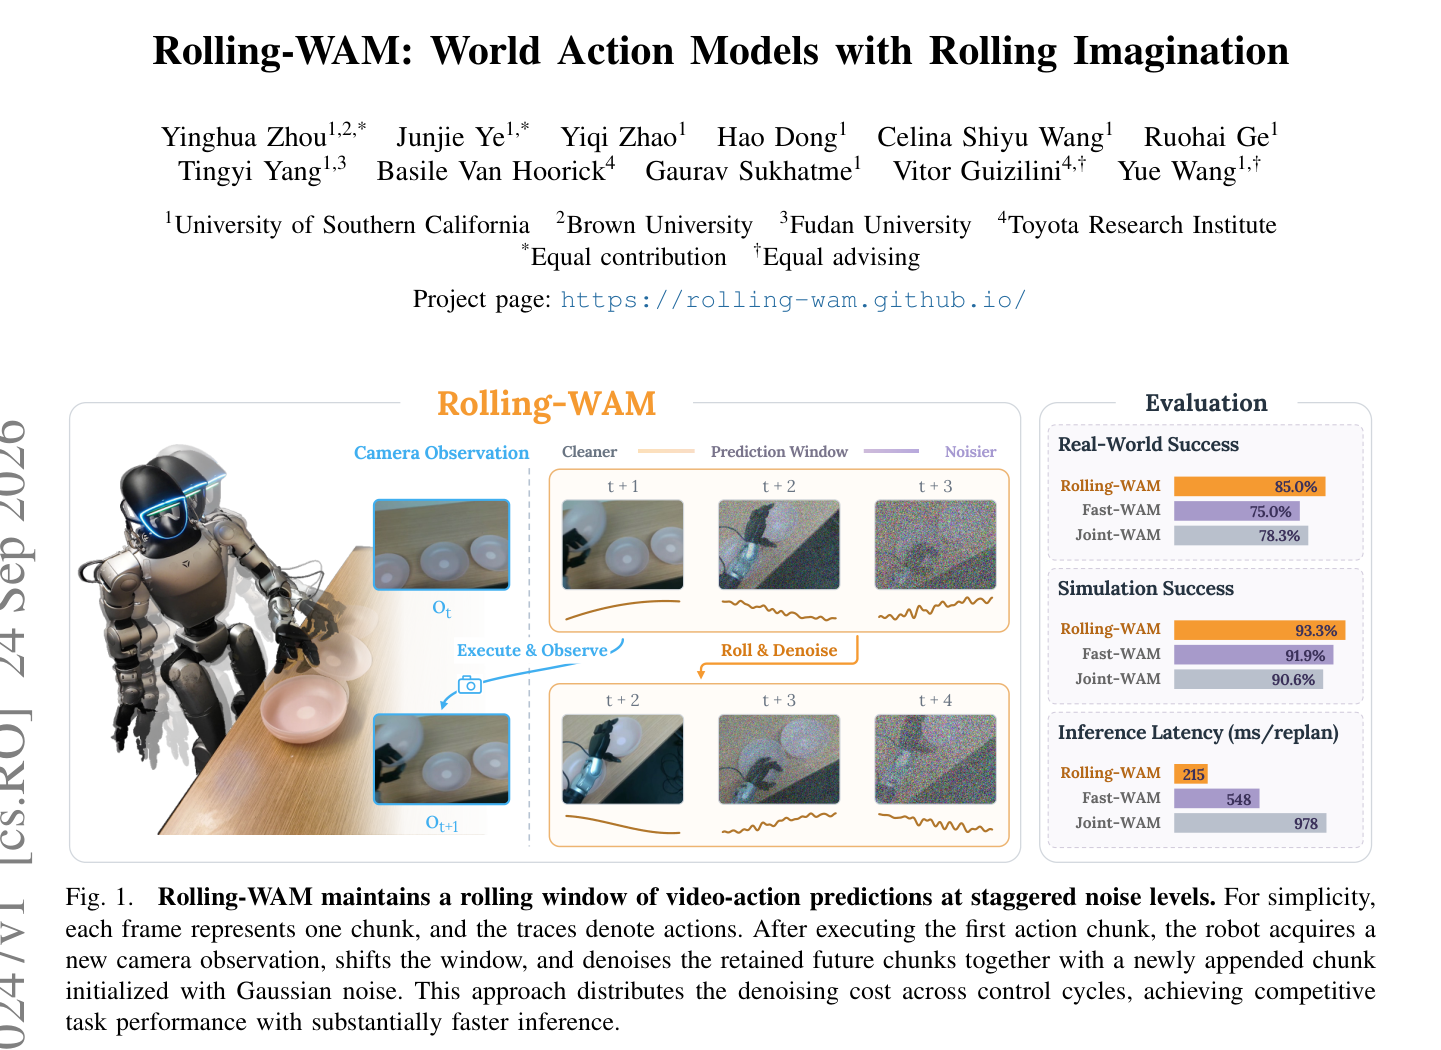
Fig.1 teaser:左示意相机观测下的阶梯噪声预测窗,执行后滚动并去噪;右柱状汇总真实 85.0%、仿真 93.3% 与时延 215 ms,对照 Fast/Joint-WAM。适合开篇建立“更快闭环仍保想象”印象。
方法总览
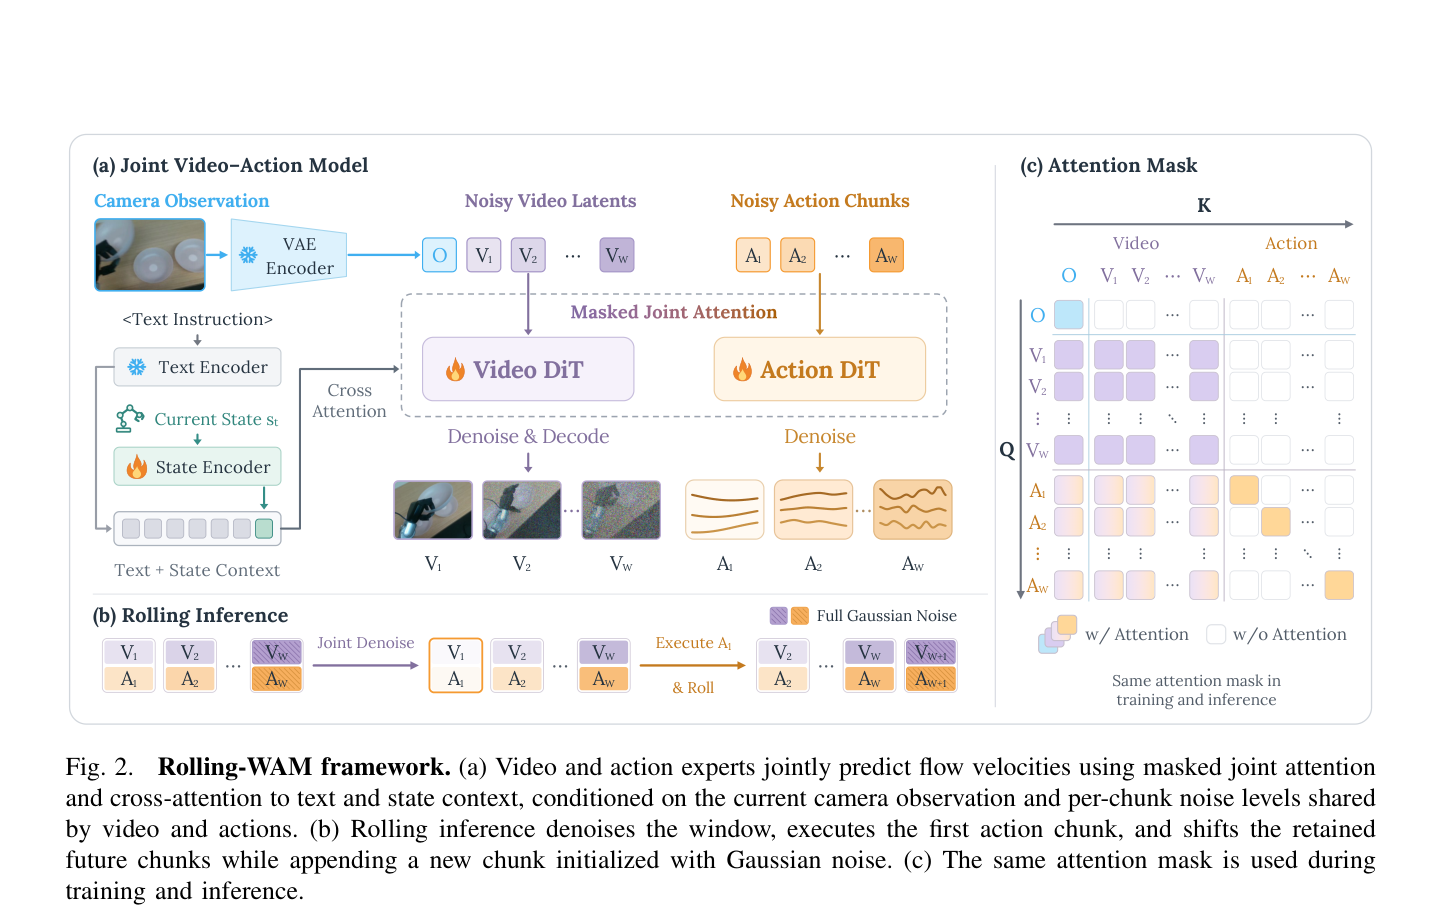
Fig.2 方法总图:(a) 视频/动作专家 + 掩码联合注意力与文本状态条件;(b) 去噪→执行→滚动追加噪声块;(c) 训练推理共用注意力掩码。适合作为方法主图与特色图。
关键证据
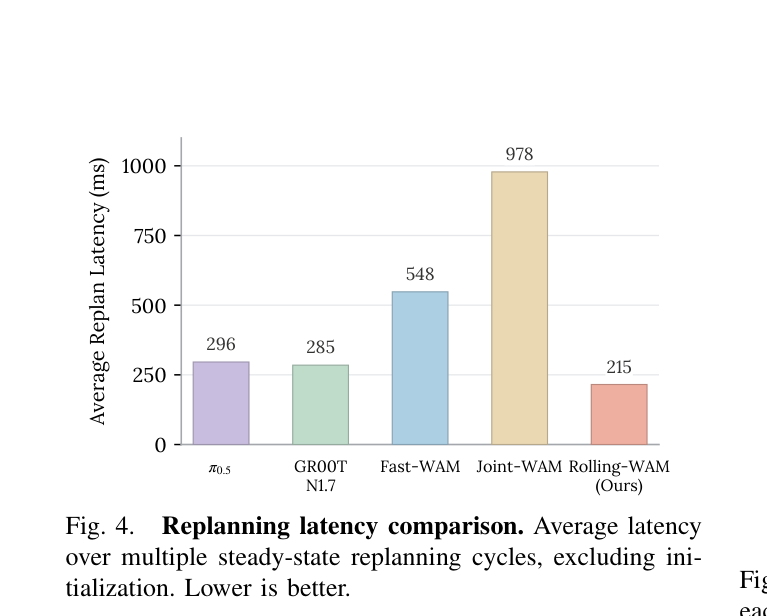
Fig.4 稳态重规划时延柱图:Rolling-WAM 215 ms,显著低于 Fast-WAM 548 与 Joint-WAM 978,也低于 π0.5/GR00T。配合 4.5× 叙事。
实验如何设计?
- LIBERO:Spatial/Object/Goal/Long 四套件联合训练,每任务 50 次 rollout,报成功率(Table I)。
- RoboTwin 2.0:50 个双臂任务,Clean 与 Randomized,每任务每设定 100 次 rollout(Table II)。
- 真实 Unitree G1:Doll Placement、Plate Stacking、Bead Pouring,每任务 20 次,报成功率(Table III、Fig.6)。
- 效率:稳态重规划时延对比 π0.5、GR00T N1.7、Fast-WAM、Joint-WAM;并扫窗口大小 W(Fig.4–5、Fig.7)。
关键结果与论文证据
- LIBERO 平均成功率 98.1%,与 Joint-WAM / LingBot-VA 的 98.5% 接近,高于 Fast-WAM 97.6% 与 Motus 97.7%(Table I)。
- RoboTwin 平均 93.3%(Clean 93.5 / Rand. 93.0),高于 LingBot-VA 92.2、Fast-WAM 91.8、Joint-WAM 90.6(Table II)。
- 真人形平均 85.0%(放玩偶 85 / 叠盘 100 / 倒珠 70),高于 Joint-WAM 78.3 与 Fast-WAM 75.0(Table III);开篇 Fig.1 汇总仿真 93.3% 与真实 85.0%。
- 稳态重规划时延约 215 ms,对比 Fast-WAM 548、Joint-WAM 978,相对 Joint 约 4.5×;也低于 π0.5 的 296 与 GR00T N1.7 的 285(Fig.1、Fig.4)。
- 窗口扫描上,选中的六项 RoboTwin 任务成功率在 W=5 达 78.2%,优于过短或过长窗;增大 W 可把时延压到约 200–300 ms 量级(Fig.5、Fig.7)。
阅读时需要注意
- 默认超参(W、N、K)需按平台调;过长窗可能稀释对即将动作的指导。
- 真实实验任务数与试次有限,外推到更广家庭操作需谨慎。
- 依赖预训练视频 DiT 与匹配训练协议;与未复现完全一致的外部系统对比仍有口径差。
- 滚动推理不自动解决接触丰富或强物理约束失败模式。
关联工作
- 相对 Joint-WAM 全视界重去噪与 Fast-WAM 弃视频,Rolling-WAM 保留视觉想象并跨周期复用计算。
- Rolling Diffusion、Streaming Diffusion Policy / RNR-DP 提供滚动去噪灵感,但本文耦合世界模型与动作。
- π0/π0.5、Motus、LingBot-VA、GR00T 等构成 VLA/WAM 成功率坐标。