快速导读:PreviewDiff 免训练,在去噪中途解码预览并由多模态评论家提出语义修正,对潜变量分支做束剪枝搜索,从而改进组合性提示遵循。
扩散模型已经能做出很“像样”的图像和视频,但一旦提示要求精确计数、属性绑定、左右空间关系或时序动作,生成仍常跑偏。常见的测试时补救是 Best-of-N:多抽几条完整样本,再用奖励模型或裁判挑最好的一条。问题是它只能在成品里做选择题,无法在“轨迹还不错但已开始偏航”的中途动手修复。
PreviewDiff(arXiv:2609.36199 ,MIT CSAIL / Google Cloud AI Research / UCSF)给出免训练的测试时搜索:在选定去噪检查点解码中间预览,让多模态评论家打分并写出自然语言纠错,再围绕语义提示编辑对潜变量做局部重加噪与续去噪分支,用束剪枝树搜索选出最佳 rollout。项目页 https://previewdiff.github.io/ 。
英文题目:PreviewDiff: Multimodal Critic-Guided Search over Diffusion Latents
论文出处:arXiv 每日论文精选 · arXiv:2609.36199
原始论文:PDF / 论文页面
这篇论文解决什么问题?
组合性失败是文生图/文生视频的老痛点:整体 FID 或 CLIPScore 可能还过得去,但针对性评测会暴露错数、属性串台、空间关系颠倒等问题。单次前馈很难完成“发现错误—局部修正—再验证”的迭代。
相关工作大致分两条线。一条把测试时算力花在噪声、轨迹、粒子或进化突变上,评论家主要给标量奖励;另一条在完整图像上做自纠错或提示重写。二者都缺少一步:把可解释的语义反馈嵌进去噪过程内部,在样本仍可塑形时改条件。
因此需要一种搜索状态定义在中间潜变量上的方法:预览足够揭示语义结构,评论家输出可执行的提示编辑,分支又能被预算匹配地与 Best-of-N 公平比较。
核心创新
- 把去噪中途潜变量当搜索状态,解码预览后在样本仍可编辑时介入。
- 多模态评论家既打分又提出自然语言语义提示编辑,定义搜索分支。
- 束剪枝树搜索在算力匹配下系统优于 Best-of-N 与标量轨迹搜索。
- 同一框架覆盖图像与视频生成,并在多个验证器与骨干上验证。
方法概览
PreviewDiff 把中间去噪潜变量当作搜索状态。在选定检查点解码预览,多模态评论家打分并给出自然语言纠错;系统按语义提示编辑做局部重加噪与续去噪分支,再以束剪枝树搜索保留高分 rollout。方法免训练,可接 SDXL、SD-3.5、FLUX.2 与 LTX-Video、Wan 2.2 等骨干。
- 整体流程分三步。第一步从初始提示开始去噪,在检查点停住,把中间潜变量解码成预览;第二步多模态评论家(如 Gemini / Qwen)对预览打分并给出针对性批评,例如补齐缺失物体、纠正颜色或拉开空间关系;第三步按这些自然语言编辑生成候选提示分支,对潜变量局部重加噪后继续去噪,再打分并用束剪枝保留高分路径。
- 与 Best-of-N 的关键差别在于:验证算力被提前用到“诊断与转向”,而不是全部押在终局挑样。与 EvoSearch / 粒子采样相比,评论家不只是奖励 oracle,还提供定义分支的语义动作。与 Video-T1 相比,搜索状态是中间潜变量估计,动作空间是语义提示修正加局部续去噪。
- 实现上可调四个轴:检查点时机、树深度(顺序 judge-and-branch 轮数)、每节点语义变体数、搜索宽度(根轨迹与存活部分状态数)。作者强调早期介入往往更有效:预览不必完美,只要暴露足够结构,就仍有去噪预算让修正生效。
逐图理解论文
中途预览搜索
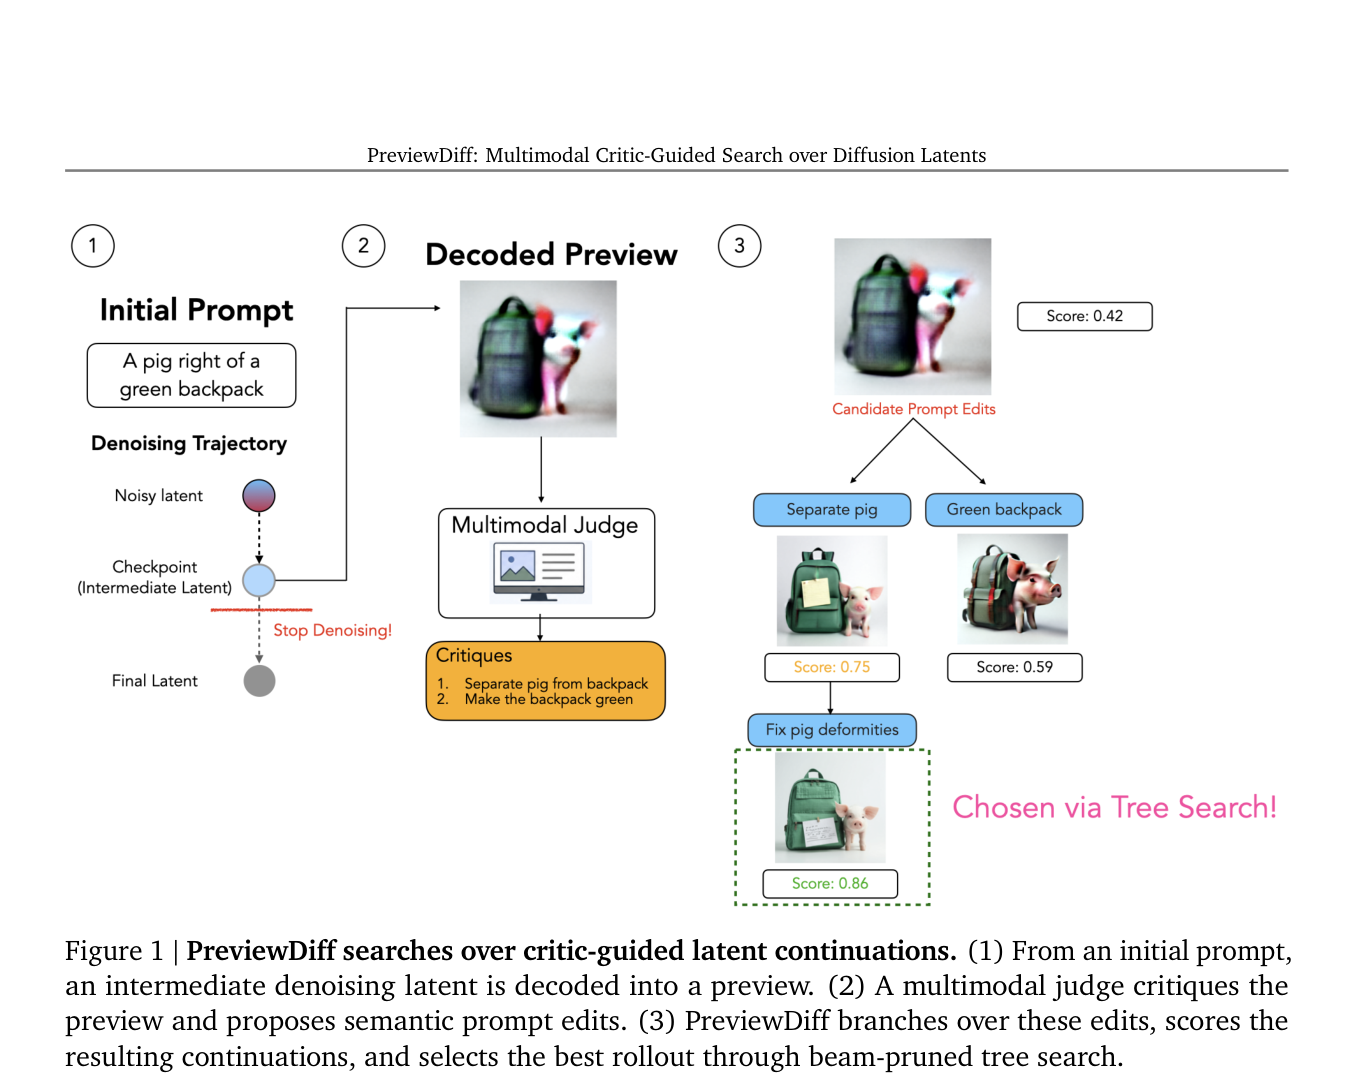
图1是方法总览:初始提示去噪到检查点后解码预览,多模态评论家提出如“把猪与背包分开”“背包变绿”等语义编辑,再对分支续去噪并用束剪枝选出高分结果。宜作特色图。
关键证据
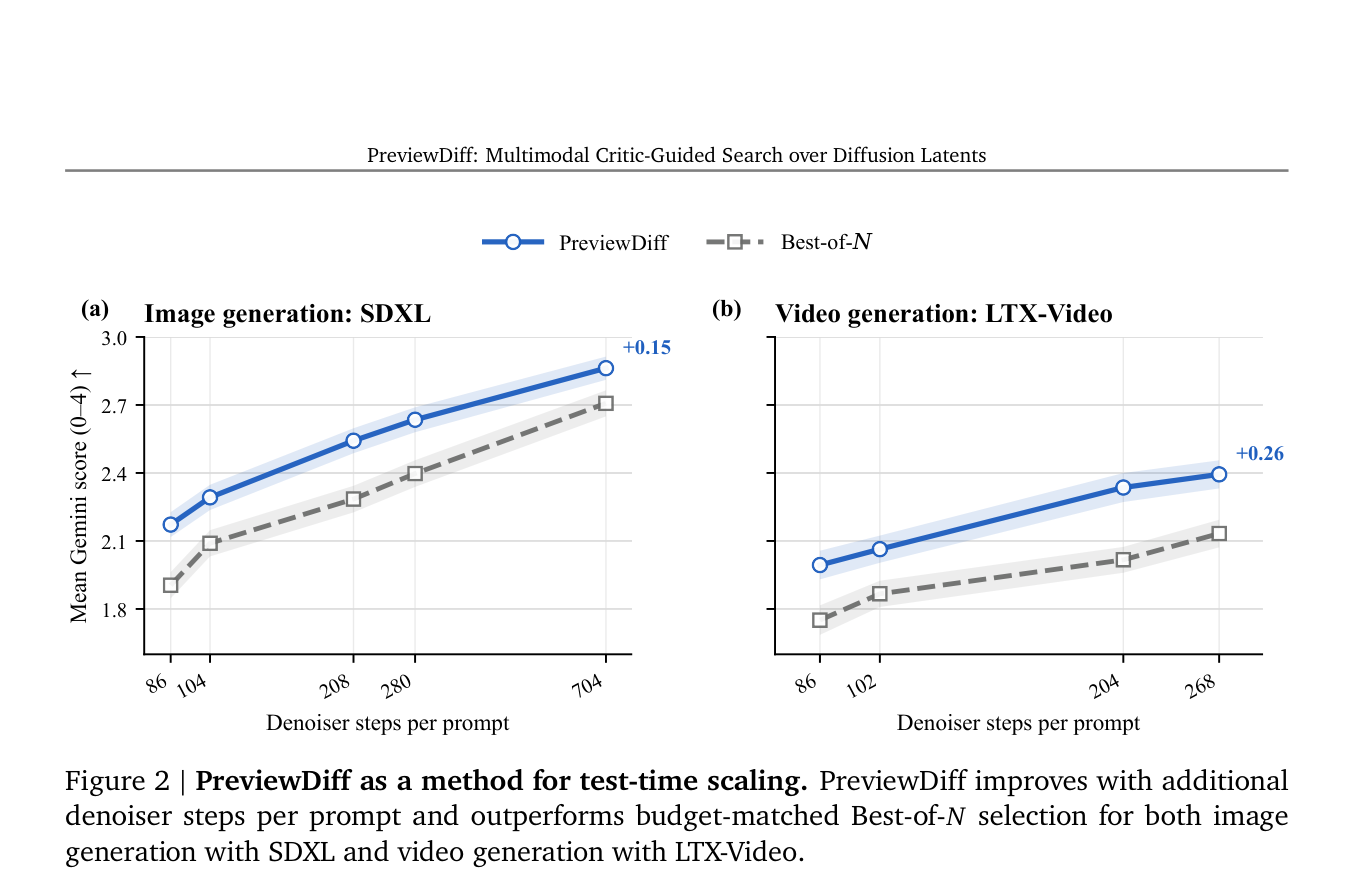
图2给出测试时扩展主结果:横轴为每提示去噪步数,纵轴为 Gemini 均分;图像(SDXL)与视频(LTX-Video)上 PreviewDiff 曲线全程高于预算匹配 Best-of-N,高预算仍分别约 +0.15 / +0.26。
结论与局限
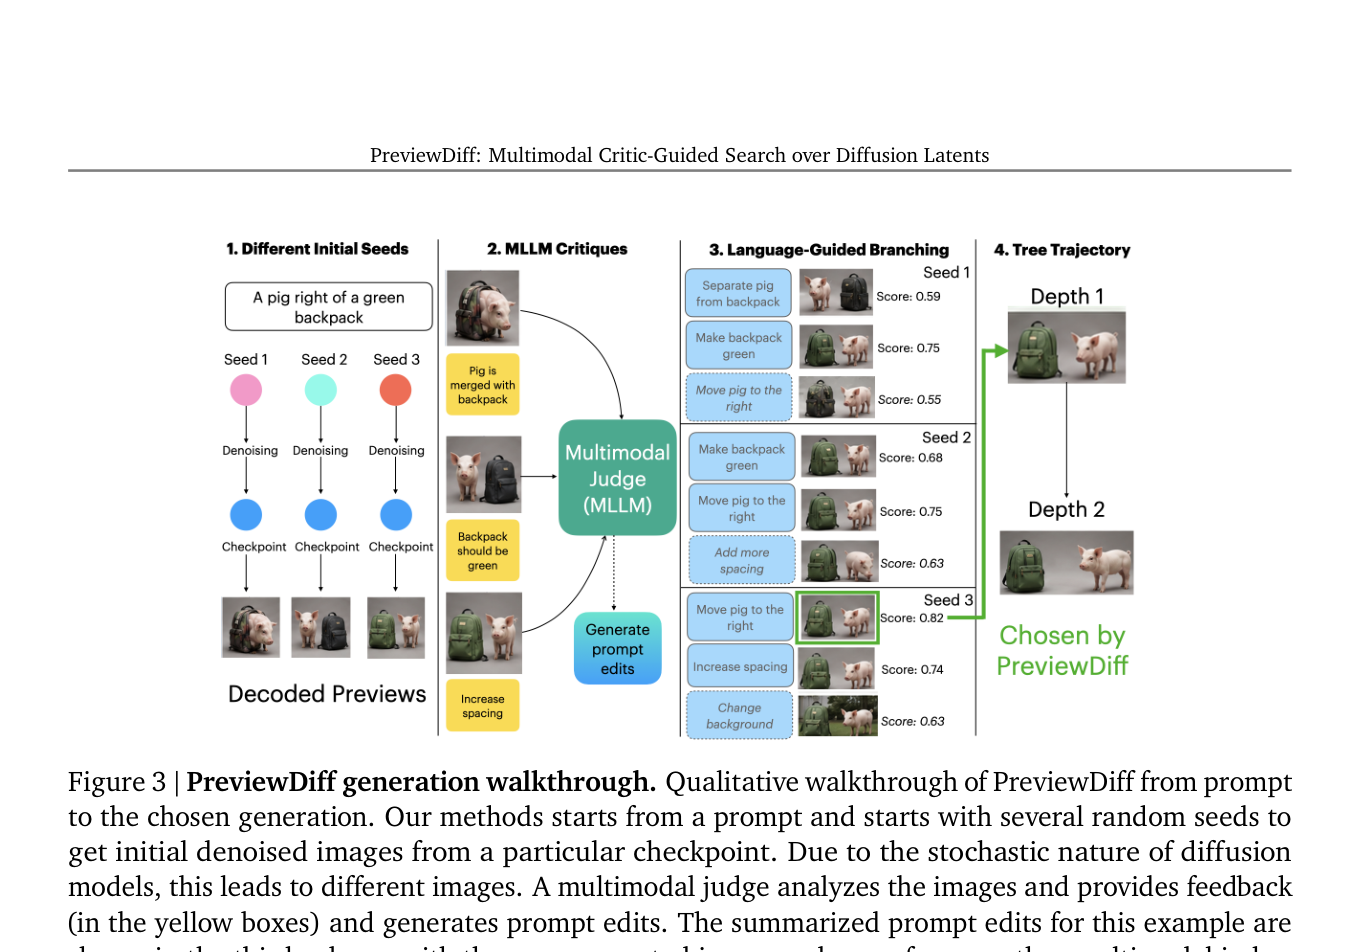
图3是定性走查:多样子种子在检查点得到不同预览,评论家黄框反馈后生成提示编辑,展示方法如何用中间视觉证据转向,而不是只靠多采样。
实验如何设计?
- 图像骨干含 SDXL、SD-3.5、FLUX.2 9B;视频骨干含 LTX-Video 与 Wan 2.2。组合基准覆盖 GenEval2、T2I-CoReBench、T2I-CompBench++,以及 T2V-CompBench、NarrLV、V-Bench 2.0。
- 主扩展实验在 SDXL×GenEval2 与 LTX-Video×NarrLV 上画预算曲线,对照预算匹配的 Best-of-N;另比 EvoSearch、Particle-Sample、Video-T1、MCTS-CGD。
- 消融单独扫检查点时机、树深、语义变体与搜索宽度;人工评在内容与风格两轴上对比 PreviewDiff、EvoSearch 与 Best-of-N。计算量以 denoiser steps 与 verifier calls 统计。
关键结果与论文证据
- 图2显示:SDXL 上 PreviewDiff 的 Gemini 均分随预算从 2.17 提到 2.86,Best-of-N 从 1.91 到 2.71;LTX-Video 上为 1.99→2.39 对 1.75→2.13。高低预算都保持优势,说明中途反馈不是低预算取巧(页10–11)。
- 跨骨干表格中,PreviewDiff 相对 Best-of-N、EvoSearch、Particle-Sample 与 Video-T1 在多数组合指标上领先,作者将其归因于“去噪轨迹上的中间视觉证据 + MLLM 语义动作”(页12–14)。
- 定性上,成功修正多落在缺失物体、错误计数、错误颜色与空间关系;人工评也显示内容赢面显著大于风格,与评论家提示聚焦提示遵循一致(页12–13)。
- 消融表明搜索宽度增益最大(SDXL 1.97→2.74;LTX-Video 1.64→2.30);深度与语义变体有互补收益但更快饱和;过晚检查点虽预览更清晰,却留给修正的去噪时间不足(页14–15)。
阅读时需要注意
- 顺序树搜索难以像 Best-of-N 那样完全并行,墙钟成本可能更高。
- 当前评论家目标偏语义正确,不保证同等幅度的美学/风格提升。
- 附录失败案例显示计数、空间关系与属性绑定仍可能出错,方法降低严重度但不消灭组合错误。
关联工作
- Best-of-N 代表终样选择式测试时扩展。
- EvoSearch / 粒子采样代表标量奖励驱动的轨迹搜索。
- Video-T1 与自纠错扩散则分别从视频搜索与完成图像闭环纠错逼近同一目标。