快速导读:JRDB-AVR 要求智能体按时间与视角主动观察真实机器人场景,并同时评答案与视觉证据,揭示当前 VLM 大量答对却无支撑。
在拥挤咖啡馆里问机器人:柜台附近那个人加入人群前有没有拎包?证据可能落在更早的时间、另一个视角,或一群外观相近的人里。若系统只靠语言先验或局部上下文“碰巧答对”,却从未观察正确对象,对具身智能体来说仍是危险幻觉。
JRDB-AVR(arXiv:2609.35032 ,NeurIPS 2026 Evaluations & Datasets;Monash University)把 JRDB 全景机器人视频改造成主动观察接口:智能体可按时间戳与视角请求有界观察,并同时被评分答案与支撑证据。代码见 https://github.com/ControlNet/JRDB-AVR 。作者还给出参考方法 JRDB-AVR-Agent:用图规划与观察接地的世界模型显式累计证据再求解作答。
英文题目:JRDB-AVR: An Active Visual Reasoning Benchmark for Embodied Agents in Real-World Environments
论文出处:arXiv 每日论文精选 · arXiv:2609.35032
原始论文:PDF / 论文页面
这篇论文解决什么问题?
既有视觉推理基准(GQA、CLEVRER、STAR、MindCube 等)与 JRDB-Reasoning 等多在被动给定观察上评最终答案,难区分“看对了”与“蒙对了”。
随着 VLM 与工具智能体答案率上升,仅看答案更容易高估具身视觉推理:模型可能定位错人、错帧、错视角仍输出看似合理的文本。
真实机器人无法同时看见所有方向与时刻。JRDB-AVR 用录制全景视频提供 observe(time, view) 接口,把“决定看哪里”本身写进任务定义。
核心创新
- 主动观察协议:Time+View 取证,Time+BBox 证据,答案与证据联合评测。
- 从 JRDB 标注自动生成并校验的 2098 题主动 VQA 引擎。
- JRDB-AVR-Agent:图计划 + 显式世界模型 + 工具循环的可审计基线。
- 实证暴露答案—证据鸿沟与高条件幻觉率。
方法概览
由 JRDB 标注构建时序场景图并用七类生成器产出主动问题;接口为按帧与视角裁剪观察;指标含答案、证据、组合与条件幻觉。参考智能体 JRDB-AVR-Agent 以图规划、观察接地世界模型与图求解作答。
- 数据生成(图2):从 JRDB 标注的框、轨迹、姿态、关系、社交组与动作等解析时序场景图;七类生成器在图上搜索多跳关系、长程后果、动作边界、时空视角定位等主动推理模式,并经证据可恢复、必要性、唯一性与抽样人工检查后保留问题。
- 规模与协议:基于 27 条 JRDB 测试序列,发布 2098 道主动 VQA。智能体通常不先拿到完整全景,而是调用 observe(sequence, frame_index, angle_deg) 获得 480×480 裁剪;预测需同时给出答案与目标时间/框证据。
- 指标:分别报告答案分、证据分与二者同时正确的组合分;另用条件幻觉率 (Answer−Combined)/Answer 衡量“答对却证据错”的比例。
- JRDB-AVR-Agent(图3):先把问题变成锚定—中间—目标实体的图计划;再通过 observe / add_entity / add_attribute / add_relation / final_answer 等工具交替取证与写世界模型;最终用图求解器在当前图状态上产出答案与证据,拒绝无观察支撑的写入。
逐图理解论文
评测缺口
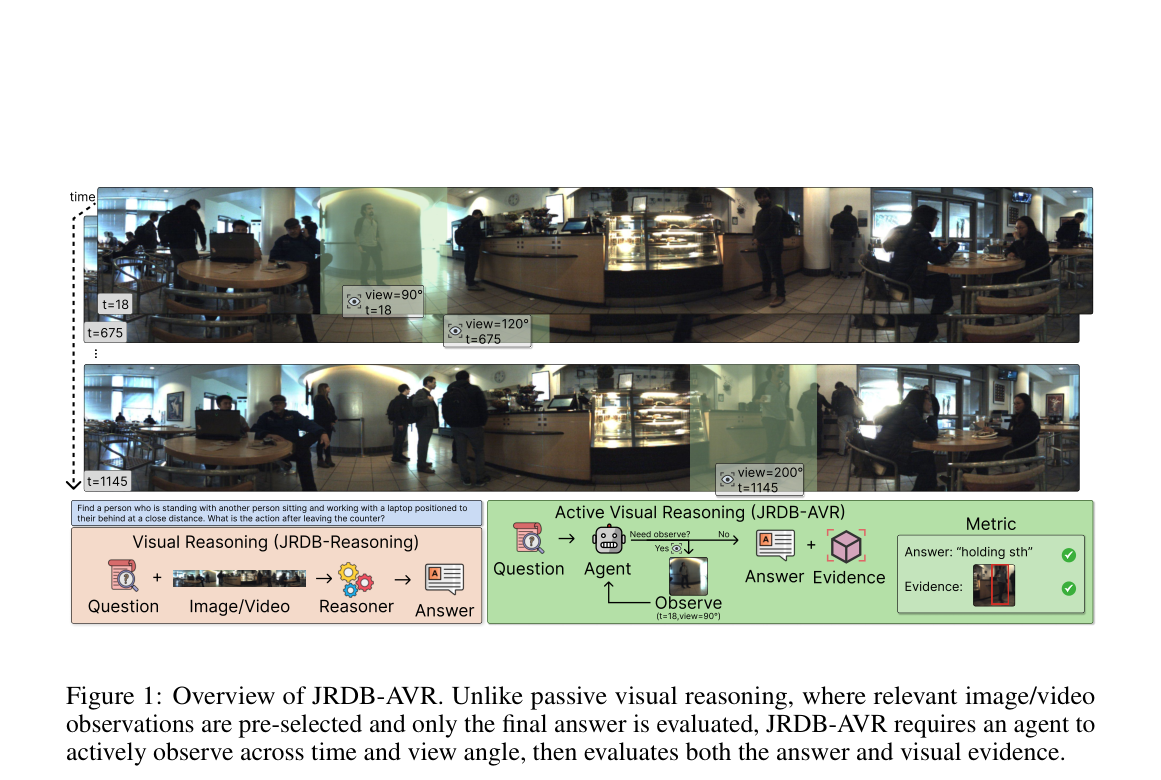
图1总览:上方全景时间轴上按 (t, view) 主动裁剪取证;下方对比被动 JRDB-Reasoning 与主动 JRDB-AVR,并同时验收答案与证据框。适合开篇与特色图。
基准构造
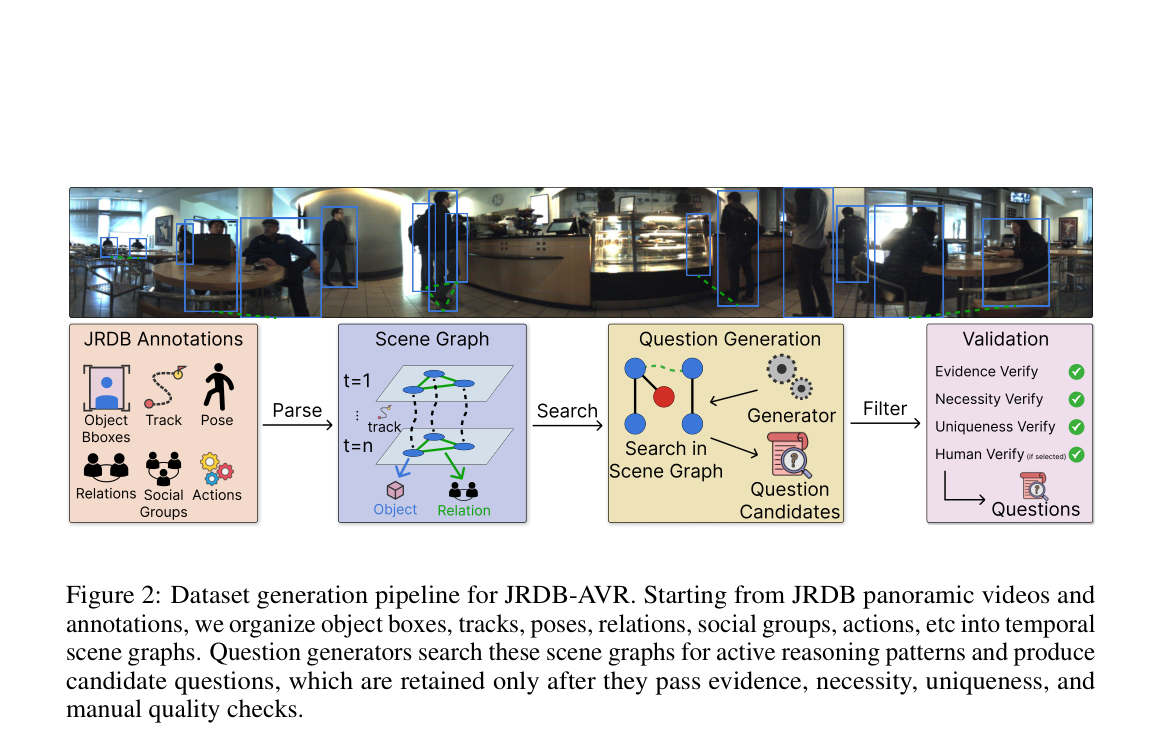
图2数据流水线:JRDB 标注 → 时序场景图 → 生成器搜主动模式 → 证据/必要性/唯一性/人工过滤得到问题。
参考智能体
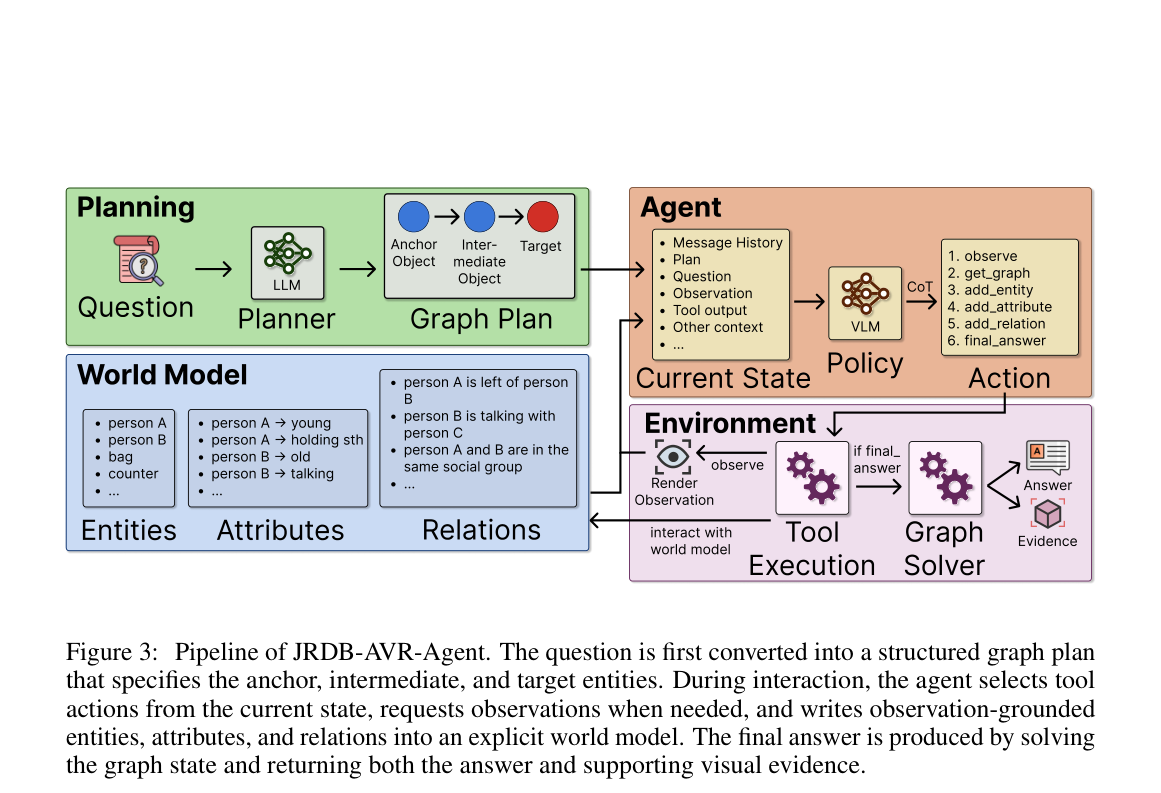
图3给出 JRDB-AVR-Agent:LLM 规划图路径,VLM 策略选工具,观察接地写入实体/属性/关系世界模型,再经图求解输出答案与证据。
实验如何设计?
- 骨干:Gemma-4 E2B/E4B、Qwen3-VL 4B/8B、Qwen3.5 4B/9B 等。
- 基线:Monolithic VLM、Chain-of-Thought、Search-Recognize-Pipeline、ReAct,均在同一评测协议下报告 Answer / Evidence / Combined / Hallucination。
- 消融(Table 4):开关主动观察与显式世界模型四组合。
- 失败分析:强调即便有世界模型,跨人、跨帧、跨视角的精确证据绑定仍难。
关键结果与论文证据
- 答案—证据鸿沟显著:最强基线答案分约 33.65,而最强基线证据分仅约 13.01、组合分约 5.96(Table 3,百分比)。
- JRDB-AVR-Agent 达到 Answer 38.51、Evidence 27.50、Combined 14.54,条件幻觉率降到 62.25,仍远高于“答对且证据对”的理想水平。
- 被动单体 VLM / CoT 证据分接近 0–6,幻觉率常超 90;引入搜索或 ReAct 可抬证据,但组合分仍个位数。
- 消融:仅世界模型或仅主动观察都有帮助;两者齐用时证据从主动-无世界模型的 18.22 升到 27.50,组合分 9.20→14.54,幻觉 75.57→62.25。
- 局限:评测是在录制观察上的主动推理,而非实时机器人控制闭环。
阅读时需要注意
- 观察来自录制全景视频的裁剪接口,不是现场运动控制与真实物理交互。
- 问题由生成引擎与过滤得到,覆盖取决于 JRDB 标注与七类模板,不能代表一切具身问询。
- 绝对组合分仍低,说明主动取证与证据绑定仍有很大改进空间。
关联工作
- GQA、CLEVRER、STAR、TVQA+、MindCube、VIEW2SPACE 等代表被动或固定输入的组合/时空推理评测。
- JRDB 与 JRDB-Reasoning 提供真实机器人场景与推理标注,但原设定仍偏被动感知与答案评分。
- ReAct、zoom-and-refine、神经符号世界模型等工作启发了主动工具循环,却缺少答案+证据的具身主动评测协议。