快速导读:World2Motion 把 Cosmos 3 改造成单阶段框架,从单图与文本联合生成场景感知三维人体动作与对应视频。
生成能走进椅子并坐下的三维人体动作,既要对齐文本,也要对齐周围几何。纯动作数据集场景覆盖有限;视频世界模型见过更多环境,但先出视频再跑人体网格恢复会拖慢推理,直接联合生成又容易出现动作抖动。
World2Motion(arXiv:2609.37004 ,JAIST / 东京大学 / Alaya Lab 等)把 Cosmos 3 的 Mixture-of-Transformers 改造成单阶段框架:输入单图与文本,联合输出场景感知三维动作与对应视频,并用位移解耦噪声日程稳定跨模态去噪。
英文题目:World2Motion: Turning Video World Models into 3D Human Motion Generators
论文出处:arXiv 每日论文精选 · arXiv:2609.37004
原始论文:PDF / 论文页面
这篇论文解决什么问题?
文本到动作方法在大规模数据上质量提升明显,但文本很难精确指定“坐到画面右侧那张高凳”这类空间关系;缺环境覆盖时,交互容易漂。
HOI 方法可吃物体网格或状态,却难以及大规模采集动作与场景配对。视频世界模型提供互补先验,两阶段 I2V+HMR 能场景感知,却多一次恢复代价。
因此需要单阶段联合生成:保留视频世界先验,直接吐出可用三维动作,并解决配对监督稀缺与视频—动作噪声日程不匹配导致的时序不稳。
核心创新
- 把预训练视频世界模型适配为单阶段场景感知三维动作+视频生成。
- 合成与真实估计动作混合的视频—动作训练数据,缓解配对稀缺。
- Shift-decoupled 噪声日程:模态特定噪声位移、共享去噪进度,降低抖动。
- 在交互基准上提升文本对齐与场景交互,并相对两阶段约 3.3× 更快。
方法概览
用 CameraHMR 从输入图估初始姿态;在 Cosmos 3 的 MoT 上增加运动编码器/解码器与模态嵌入,视频与动作 token 共享注意力。构造合成视频—动作对与真实视频+估计动作的混合数据。提出 shift-decoupled 噪声日程:共享去噪进度 u,但对视频与动作施加不同噪声位移(默认 sv=10、sm=1),使中间步动作更干净以稳定时序。
- 输入含人单图与动作文本;CameraHMR 估计初始姿态。理解分支文本分词,生成分支经视频编码器与运动编码器得到视频/动作 token,送入适配后的 Cosmos 3 MoT,共享注意力并区分模态嵌入,再分别解码视频与动作。
- 数据上混合两类监督:用已有交互动作数据集渲染/构造合成视频—动作对,提供可靠三维标签;从真实视频估计三维动作,扩展外观与环境多样性。
- 关键技巧是 shift-decoupled 噪声日程:采样共享进度变量,再映射到视频噪声 σv 与动作噪声 σm。默认视频位移更大、动作位移更小,使中间去噪步动作更接近干净状态,从而约束仍嘈杂的视频分支,减轻抖动。
- 表示上采用相对根平移等设计;主实验输出可经 Savitzky–Golay 平滑。整体避免“先视频后恢复”的串行代价,一次前向得到配对模态。
逐图理解论文
场景与代价
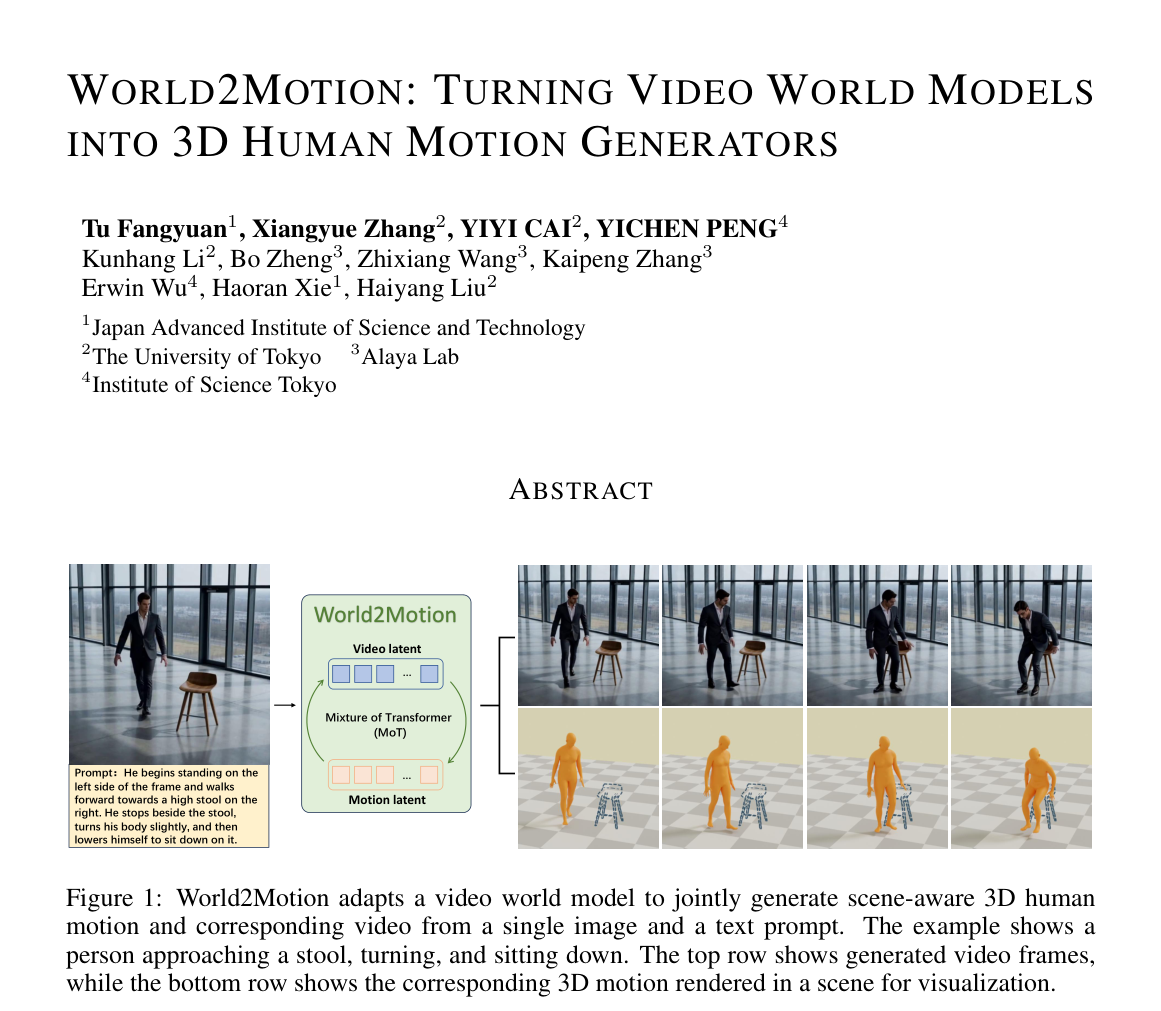
图1展示任务形态:单图+文本进入 World2Motion,联合输出视频帧与场景中渲染的三维动作(走近高凳并坐下)。宜作开篇与特色图。
单阶段适配
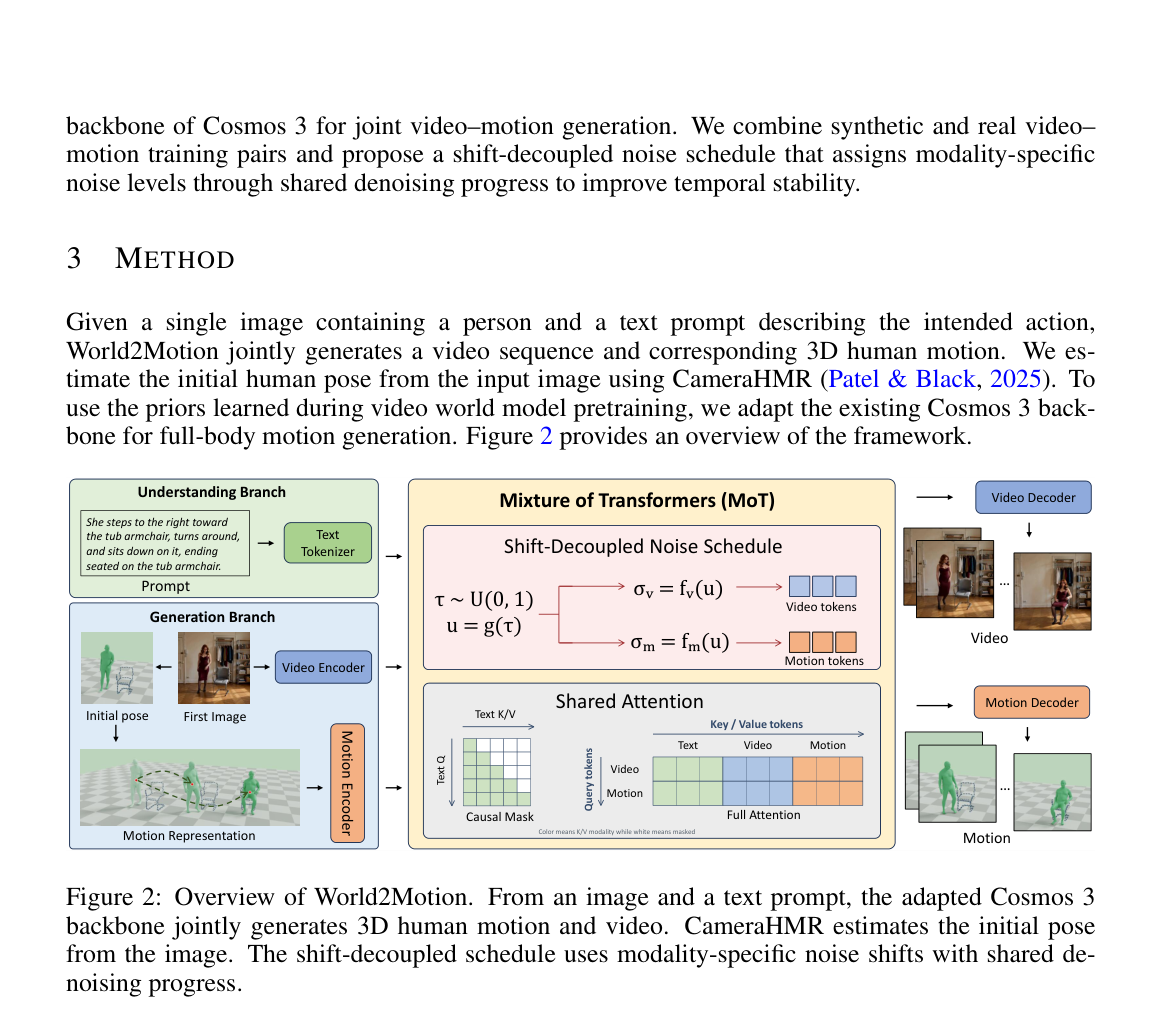
图2总览适配后的 Cosmos 3:理解/生成双分支、MoT 内 shift-decoupled 噪声日程与共享注意力,最终分出视频与动作解码器。
解耦噪声
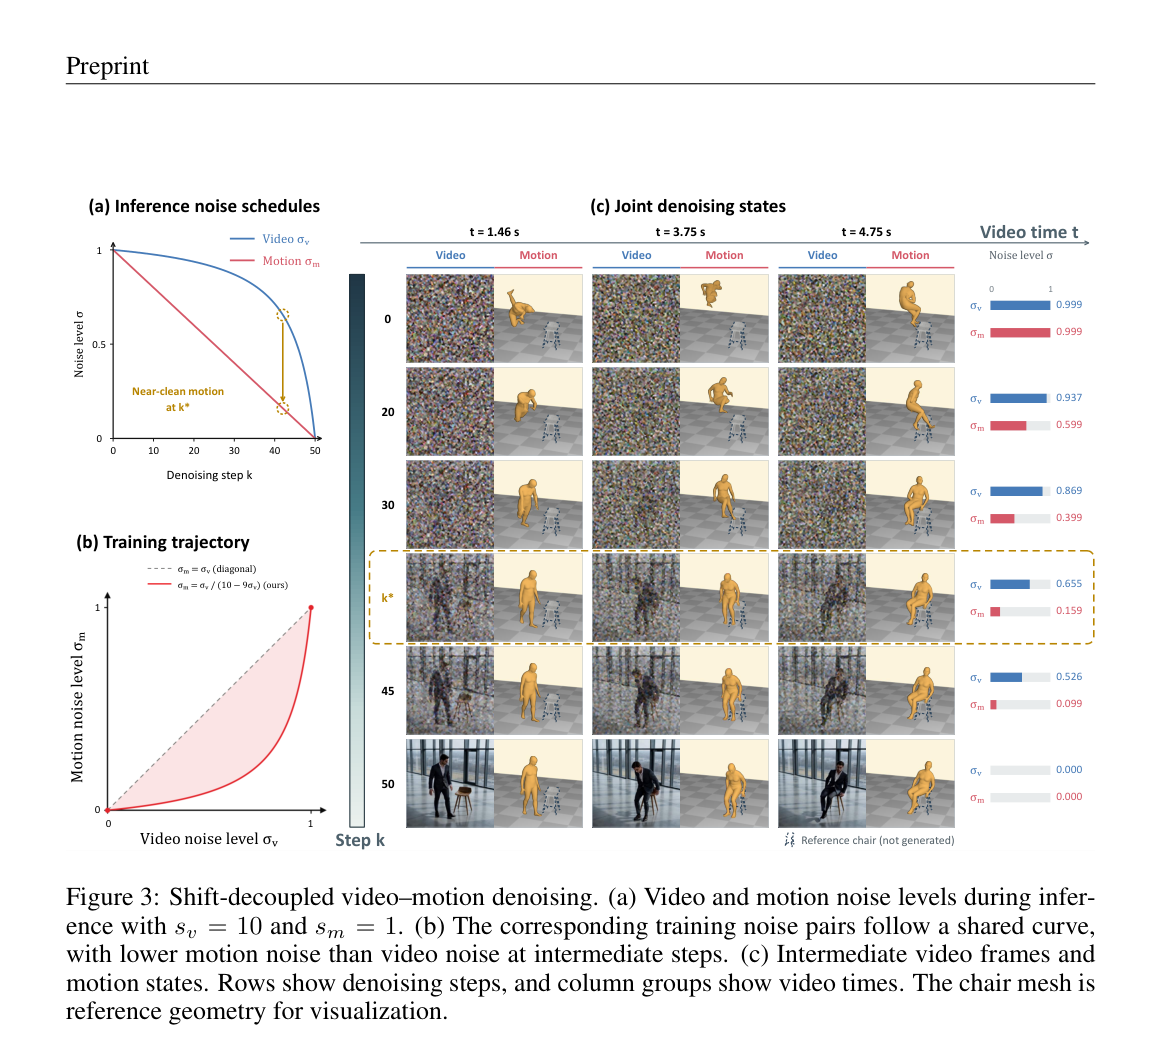
图3解释位移解耦:推理时动作噪声下降更快,中间步已近干净动作;训练轨迹上 σm 低于 σv,用更稳的动作引导视频去噪以减抖动。
实验如何设计?
- 主评测 100 个交互案例,覆盖搬箱、走近坐下等需要身体与物体相对位姿对齐的动作。
- 对照:HY-Motion、Kimodo、Go-to-Zero;HOIFHLI、LIGHT;两阶段 MiniMax-H3+CameraHMR;联合生成 CoMoVi。
- 报告 FID、R@1、MM-Dist、Contact-F1、ISR、Jerk、FSR、PoseError 与平均推理秒数。
- 消融在 35 例、关闭后处理设置下考察相对根平移与 sm 训练—推理匹配;另给定性场景交互对比。
关键结果与论文证据
- 运动质量与文本对齐:FID 0.27、R@1 0.24、MM-Dist 1.13,优于 HY-Motion 与 CoMoVi(页7,Table 2)。
- 场景交互:ISR 0.91 与两阶段持平,明显高于纯 T2M/多数 HOI;Contact-F1 0.22,略低于两阶段 0.24(页7)。
- 视频—动作一致:PoseError 67.50 mm,相对 CoMoVi 81.28 约降 17%(页7)。
- 效率:平均 156.59 s,相对两阶段 523.67 s 约 3.34×,相对 CoMoVi 约 1.73×(页7)。
- 消融:相对根平移显著降抖动;训练与推理 sm 匹配时 Raw Jerk/FSR 最低,错配会大幅恶化(页9)。
阅读时需要注意
- 数据偏单人与简单交互,复杂多人、精细手物操作覆盖不足。
- 推理仍远慢于实时;根放置与接触精度仍是难点。
- 评估上高 ISR 不等于精确接触;不同表对 FSR/Jerk 定义不一致,阅读需分协议。
关联工作
- Cosmos 3 提供可适配的视频世界 MoT 先验。
- T2M 与 HOI 分别代表强文本弱场景、强物体输入两条路线。
- 两阶段视频生成+HMR 与 CoMoVi 式联合生成是最直接对照。