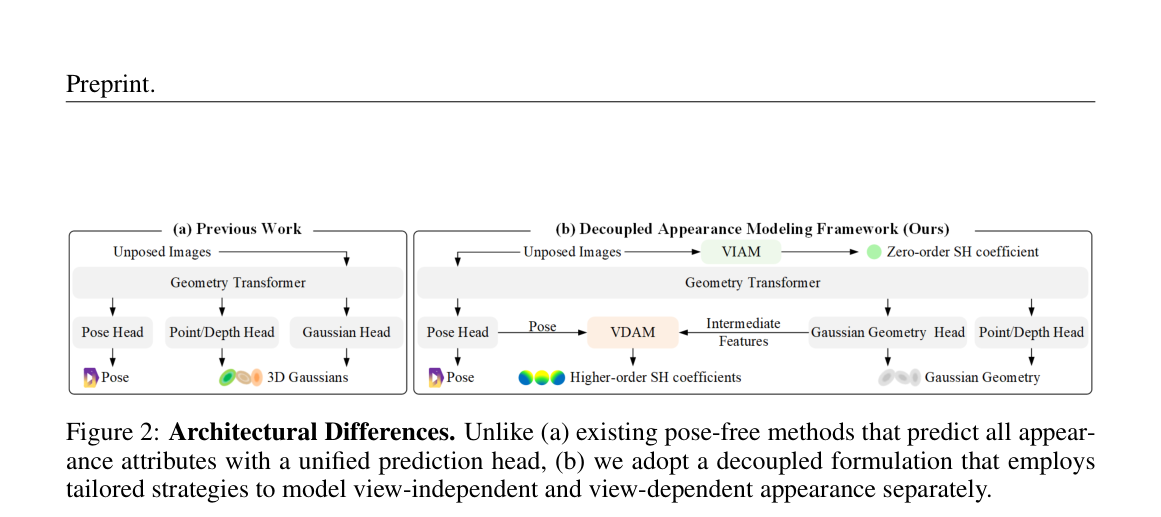
快速导读:AESplat 把球谐外观拆成视角无关的零阶分量与视角相关的高阶分量,用免训练 I2DC 与带 GVSRE/WCM 归纳偏置的浅层 MLP 分别建模,显著提升无位姿前馈三维高斯的新视角渲染质量。
无位姿前馈三维高斯能从无序图像一次前向重建并渲染新视角,但现有方法往往用同一个头预测全部球谐外观,把视角无关的基础颜色与视角相关的高光、反射搅在一起,室内墙面与玻璃镜面都会糊。
AESplat(arXiv:2609.36693 ,南开大学)提出解耦外观建模:零阶 SH 用免训练 I2DC 直接从像素 RGB 得到,高阶 SH 由带 GVSRE 与 WCM 三维感知偏置的浅层 MLP 预测。项目页 https://aesplat.github.io/ ;代码 https://github.com/aesplat/AESplat 。
英文题目:AESplat: Advancing Pose-Free Feed-Forward 3D Gaussian Splatting via Decoupled Appearance Modeling
论文出处:arXiv 每日论文精选 · arXiv:2609.36693
原始论文:PDF / 论文页面
这篇论文解决什么问题?
前馈三维高斯摆脱了逐场景优化,却长期依赖 SfM 位姿;无位姿路线把位姿与高斯联合预测后,外观仍被当作同质回归目标。
球谐分解表明:零阶基为常数,对应视角无关外观;高阶随视线变化,对应视角相关效应。统一预测忽视这一结构差异。
因此需要分别为两类外观设计策略:基础颜色应尽量尊重输入观测,视角相关项则需要显式三维与跨视角线索。
核心创新
- 解耦外观建模:零阶视角无关与高阶视角相关 SH 用不同策略,而非统一预测头。
- I2DC:由输入像素 RGB 直接推导零阶 SH,避免重学已观测基础颜色。
- GVSRE 与 WCM 两套三维感知归纳偏置,引导浅层 MLP 建模视角相关外观。
- 策略可迁移到 NAS3R-m、SPFSplatV2 等不同无位姿基线。
方法概览
给定无位姿上下文图像,Masked Geometry Transformer(DINOv2 特征 + 相机 token)联合预测相机内外参、深度与高斯几何。VIAM/I2DC:像素对齐高斯的零阶 SH 直接由对应像素 RGB 按 vanilla 3DGS 初始化公式 c00=(C-0.5)/Y00 得到,免训练。VDAM:四层浅层 MLP 预测高阶 SH,输入含 (1) GVSRE——聚合各高斯相对全部上下文相机的方向与对数距离的空间关系嵌入;(2) WCM——把高斯中心投影到邻域视图采样颜色与有效性掩码;(3) 几何头中间特征。损失仅为目标视图 MSE+LPIPS 光度误差。
- 整体:无位姿上下文图经 DINOv2 与 Masked Geometry Transformer,联合输出相机内外参、深度与高斯几何,外观走解耦路径后可微渲染目标视图。
- VIAM/I2DC:像素对齐高斯的零阶系数按 c00=(C-0.5)/Y00 从对应像素 RGB 直接换算,不再用网络重学基础颜色。
- VDAM:四层 MLP 吃三类输入——GVSRE(高斯相对全部上下文相机的方向与对数距离嵌入)、WCM(投影到邻域视图得到的扭曲颜色与有效掩码)、几何头中间特征,输出高阶 SH。
- 训练仅用目标视图 MSE 与 LPIPS;视图依赖头学习率 3e-4,其余跟随 NAS3R 设置,单卡 A6000、224 分辨率、400k 步。
逐图理解论文
统一外观的瓶颈
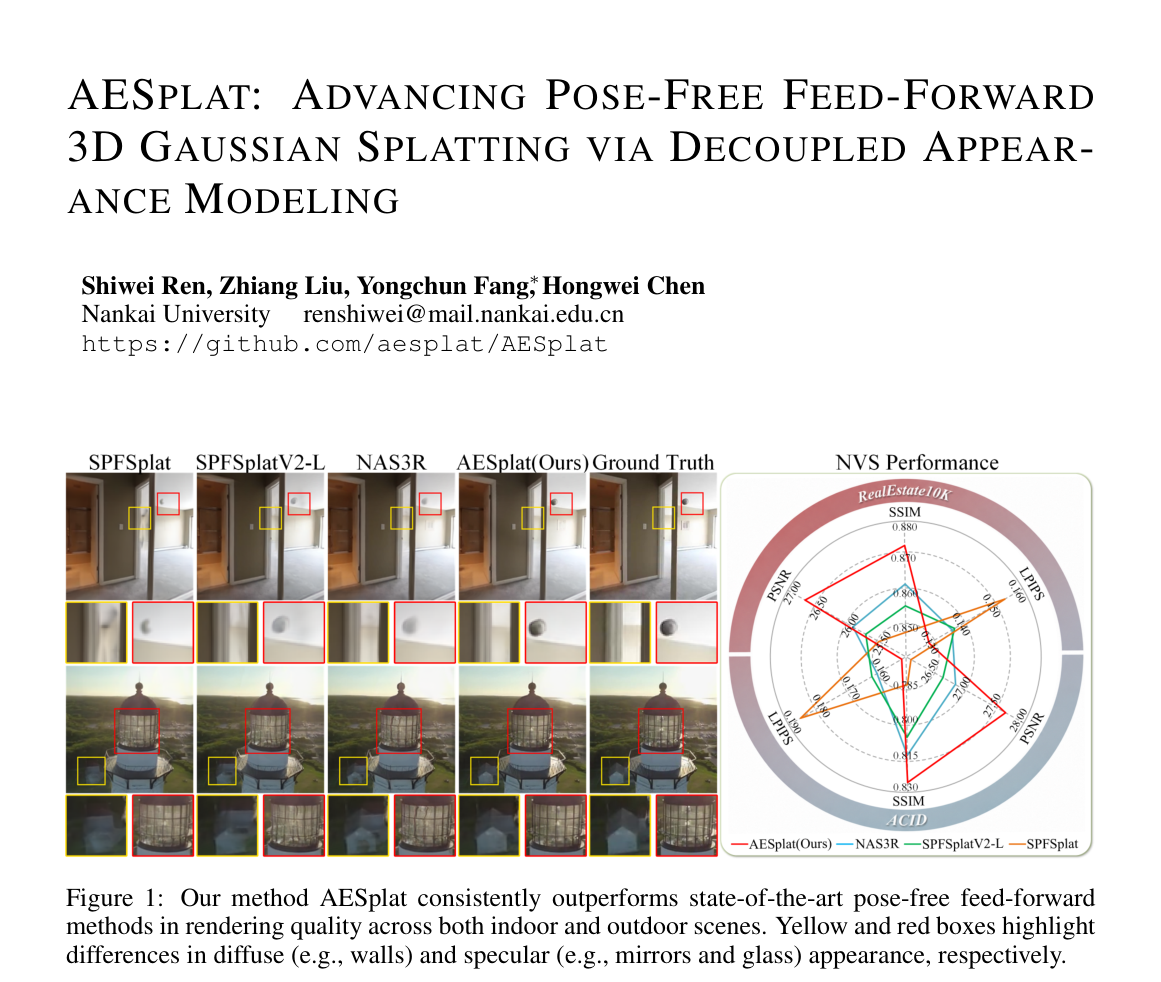
图1并列室内走廊与户外灯塔场景,对比 SPFSplat、SPFSplatV2-L、NAS3R 与 AESplat;黄框标漫反射区域、红框标玻璃镜面等高光,右侧雷达图显示 AESplat 在 RealEstate10K 与 ACID 的 PSNR/SSIM/LPIPS 外包络更大。宜作特色图。
解耦外观
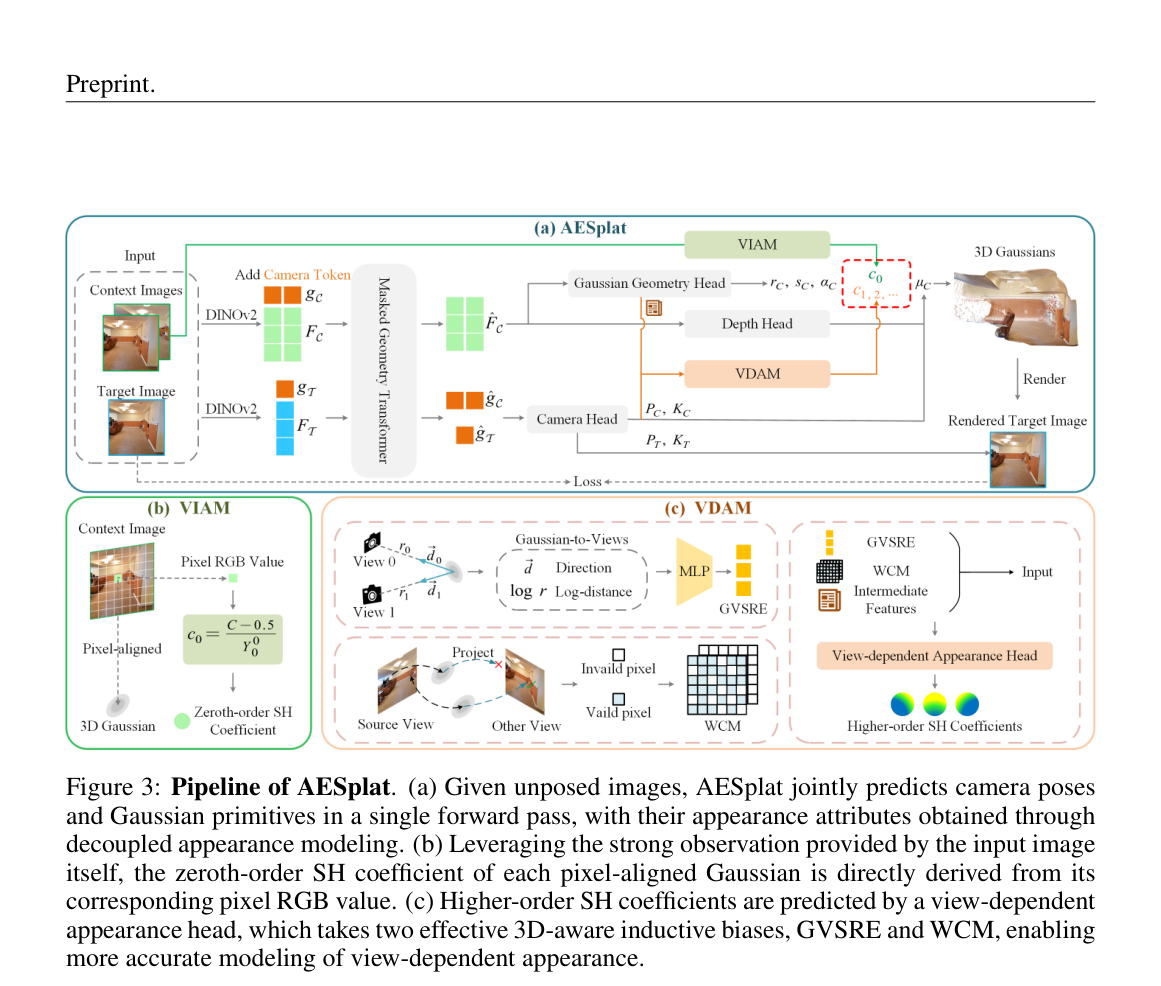
图3总览流水线:(a) 无位姿输入经几何 Transformer 预测位姿与高斯几何;(b) VIAM/I2DC 由像素 RGB 直接得零阶 SH;(c) VDAM 用 GVSRE 与 WCM 驱动高阶 SH。讲方法时的主架构图。
结论与局限
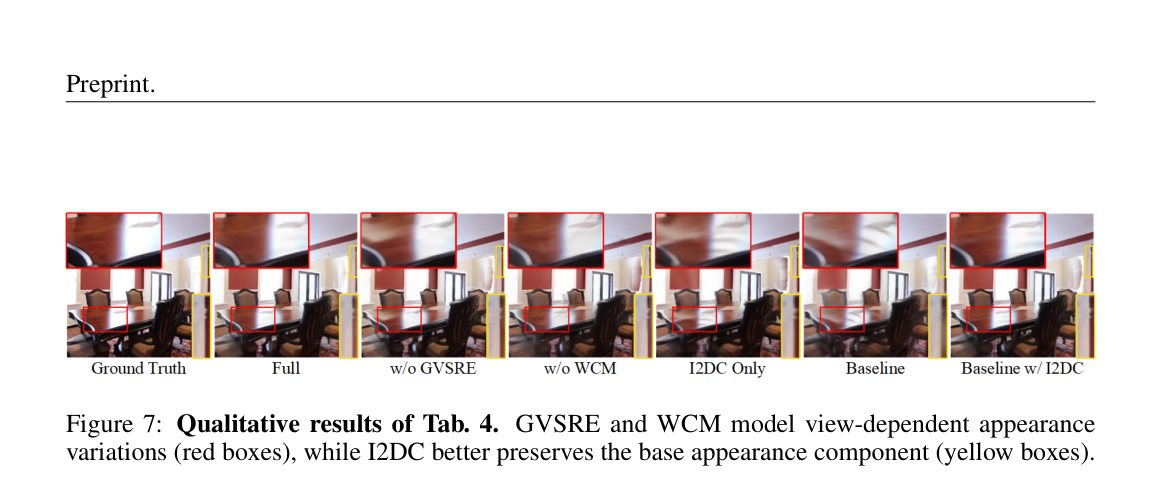
图7消融定性:红框桌面反射依赖 GVSRE/WCM,去掉后模糊;黄框墙柱基础外观由 I2DC 更好保持。对应解耦三件套各自贡献的直观证据。
实验如何设计?
- 主集:RealEstate10K(室内)与 ACID(户外),报告 PSNR、SSIM、LPIPS。
- 对照覆盖有位姿与无位姿前馈方法,包括 DepthSplat、NoPoSplat、SPFSplat、SPFSplatV2-L、NAS3R 等。
- 零样本:仅 RealEstate10K 训练,测 ACID、DL3DV、ScanNet++;另把策略接到其他基线做通用性验证。
- 消融在 50K 步公平设置下拆 GVSRE、WCM 与 I2DC。
关键结果与论文证据
- RealEstate10K 上 AESplat 达 PSNR 26.691、SSIM 0.872、LPIPS 0.128,相对 NAS3R 约 +0.80 dB;ACID 上约 +0.85 dB,摘要亦称相对 DepthSplat 约 +1.1 dB(页7,Table 1;页1)。
- 零样本跨集上 ACID / DL3DV / ScanNet++ 多项指标领先,显示解耦外观学到可迁移表示(页8,Table 2)。
- 接到 NAS3R-m 与 SPFSplatV2 均可抬升 PSNR,说明策略不绑定单一骨干(页8,Table 3)。
- 消融:去 GVSRE 或 WCM 约掉 0.25–0.27 dB,桌面反射变糊;仅 I2DC 已接近基线,基线+I2DC 还能再抬基础墙面保真(页9,Fig.7)。
阅读时需要注意
- 上下文完全未见内容仍无法凭空恢复,这是前馈新视角的固有上限。
- I2DC 在极端曝光与强非朗伯高光下对基础外观的近似可能失真。
- 主实验分辨率与双视图协议偏轻量,更高分辨率与更多视图场景需额外验证。
关联工作
- NAS3R、SPFSplat 系列代表无位姿前馈三维高斯主线。
- DepthSplat、pixelSplat、MVSplat 等代表依赖位姿的前馈对照。
- 球谐外观与 per-scene 3DGS 改进工作提供了外观表达动机,但缺少前馈泛化设定下的解耦设计。