快速导读:EGO2ACT 用 110 个真实日常任务检验视频模型能否从初始场景与高层目标生成物理成立的多步自我中心操作,并用无参考门控评判对齐人类。
视频生成正被当成具身规划与学习的世界模拟器,但真正有用的 rollout 必须在功能上成立:动作要走到目标,并经历正确的物理状态变化。现有评测多停在短动作、逐步指令或外视角演示,很少考自我中心视角下、只给高层目标时的多步操作。自我中心还要穿过手部遮挡与相机晃动,跟踪细粒度物体状态。
EGO2ACT(arXiv:2610.01092,MBZUAI / 南洋理工大学 / 北卡罗来纳大学教堂山分校)给出目标导向基准:110 个真实日常任务、2640 段视频。输入是初始场景图与高层目标,要求模型生成手操作物体的自我中心视频。配套无参考评判管线 EGO2ACTJUDGE。正文首页标注 Code、Dataset 与 Website,但本次未抽到可点击 URL,公开状态待核验。论文页 https://arxiv.org/abs/2610.01092。作者写明将在发表后公开基准与评判代码。
英文题目:EGO2ACT: Evaluating Goal-Directed Manipulation in Egocentric Video Generation
论文出处:arXiv 每日论文精选 · arXiv:2610.01092
原始论文:PDF / 论文页面
这篇论文解决什么问题?
高层目标只说终点,不规定中间动作,合法路径可以有多条,因此不能靠对照一条参考视频判成败,还要检查物理约束。图1用同一初始桌面与目标“把盖好的牙膏和折好的牙刷装进合上的旅行盒”展示三条尝试:局部状态可以暂时合理,但随后出现刷颈弯折、凭空多物、盒未合上等任务错误,以及形变、物体变换等物理错误。
外视角基准绕开了手物交互、末端遮挡与动态视角;已有自我中心基准要么用保真度而不是目标完成,要么依赖逐步提示,测不到自主规划。表1把 EGO2ACT 与 PQSG、WorldModelBench、WR-Arena、RBench、EgoWM、EgoForge、H2R-Bench 对照:同时满足真实自我中心、多步操作、开放目标规划与无参考评判的是本文。
于是有两个问题:现有视频模型在初始场景加高层目标时,能在多大程度上生成物理成立的自我中心操作;以及如何在没有参考轨迹时,把开放执行评到与人类判断对齐。
核心创新
- 据作者所知,首个面向目标导向、多步自我中心视频生成的真实世界基准。
- 无参考、量规派生的 EGO2ACTJUDGE,分别打任务完成与物理合理性。
- 用顺序门控避免 visional 评分膨胀,并系统分析接触密集动作上的失败模式。
- 同时提供正确/错误人工对照,用来检验评估器是否只看画质。
方法概览
每个案例配对真实初始帧与只写结果的目标。人工录 3 成 3 败对照,再让六个视频模型各生成 3 个种子。EGO2ACTJUDGE 先拆子目标,再用任务三门与物理四门顺序早停打分,总分取几何平均。人类评审在 25 案面板上校准后盲评。
- 任务定义:给定初始帧 f1 与目标 G,模型生成序列 V,且只能使用 f1 中可见物品。两条轴:任务完成(是否走过到达目标所需中间步骤)与物理合理性(接触、遮挡下的物体持续性、状态变化是否真实)。任何在合理物理下走到目标的路径都算成功。
- 每个案例含 6 段人工录像:3 段成功且动作序列互异,3 段失败作对照;再让 6 个视频模型各生成 3 个种子,得到每案 18 段生成视频。总计 110 案、660 段人工、1980 段生成。场景分无杂乱、轻度、重度;目标只写结果不写步骤。封闭世界约束禁止引入新物体。人工成功录像中位时长 20.42 秒,平均超过五步。图2显示领域以家居整理 28、办公文具 25、厨房 24、个人护理 21 为主;平均约 5.16 个固体物体、5.20 步观察操作、2.71 类动作族,搬移、容纳与开合共现最高。
- EGO2ACTJUDGE 无训练、无参考轨迹。先只看 f1 与 G 拆出最小可观察子目标;每个子目标经任务门 T1 启动、T2 粗过程、T3 事后状态,失败即停,得 0–3 分再平均。物理门 P1 连续性、P2 起始因果、P3 过程接触、P4 事后稳定性,得 0–4 分,仅对已尝试子目标平均。总分取几何平均;完全未尝试则总分记 0。约 91% 的子目标计划保持相同步数。
逐图理解论文
评测缺口
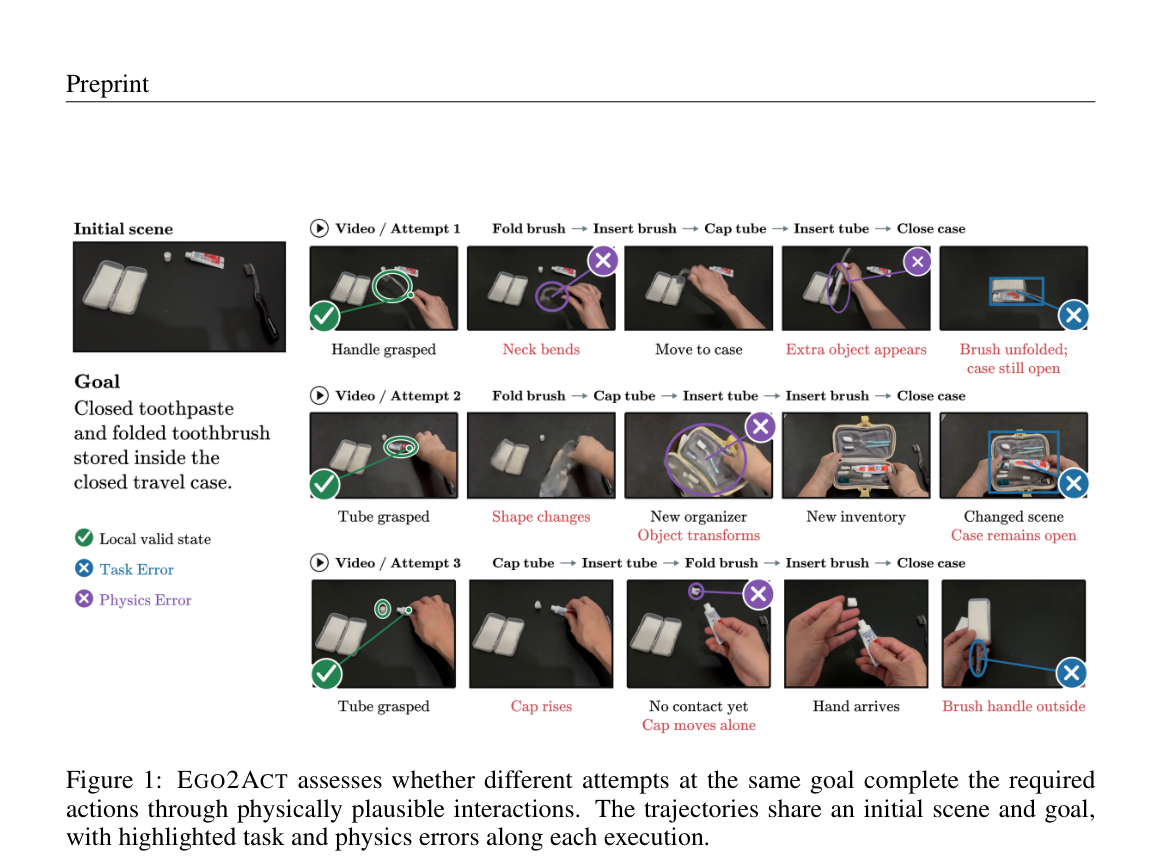
图1:同一初始场景与目标下三条尝试。绿圈标局部合法状态,紫叉为物理错误(刷颈弯曲、形变、盖子自行升起),蓝叉为任务错误(刷未折、盒未合、刷柄露在盒外)。用来说明必须同时查步骤完成与物理接触。宜作问题示意。
基准构成
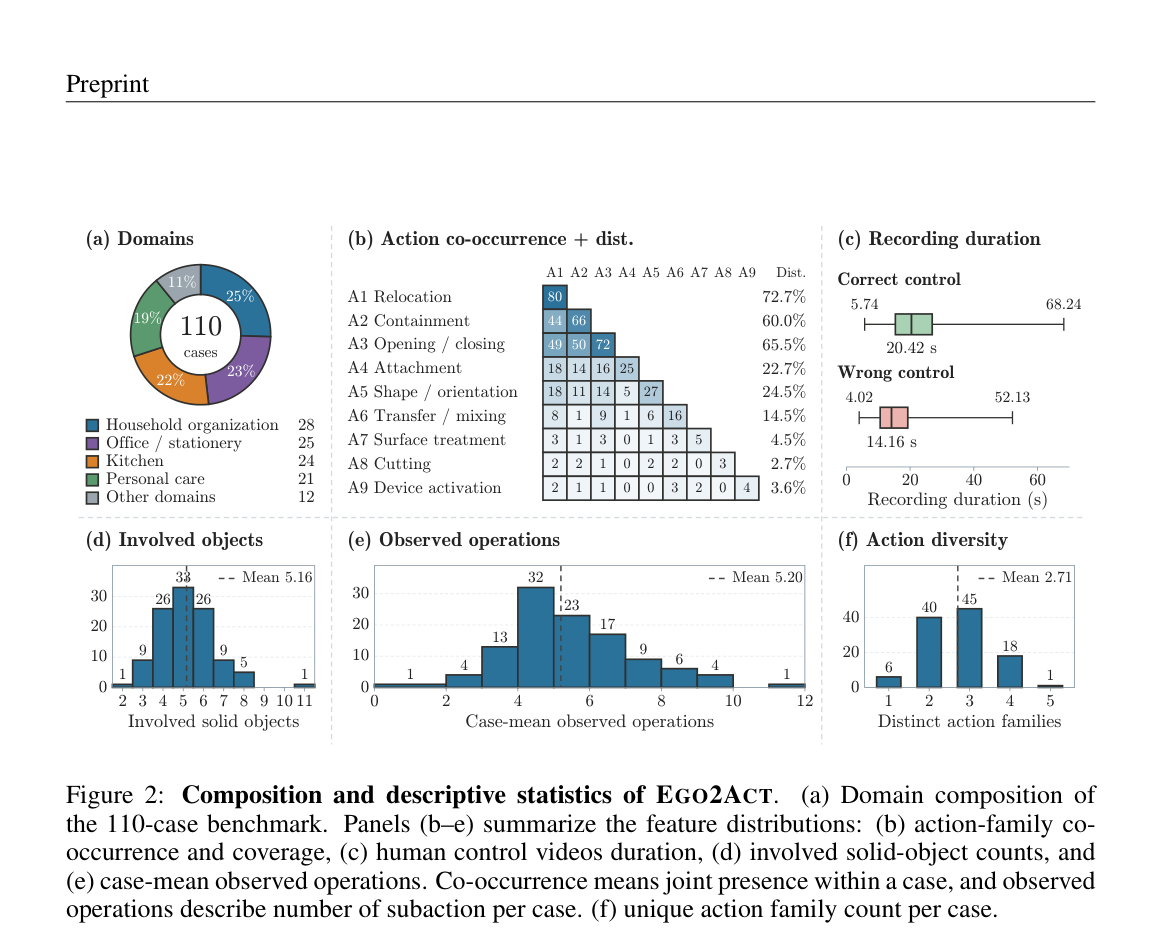
图2给出 110 案构成:家居/办公/厨房/护理等领域饼图,九类动作共现矩阵,正确对照中位时长 20.42 秒,物体数均值 5.16,观察操作均值 5.20,动作族均值 2.71。用来支撑“短目标、真多步”而不是单动作评测。
无参考评判
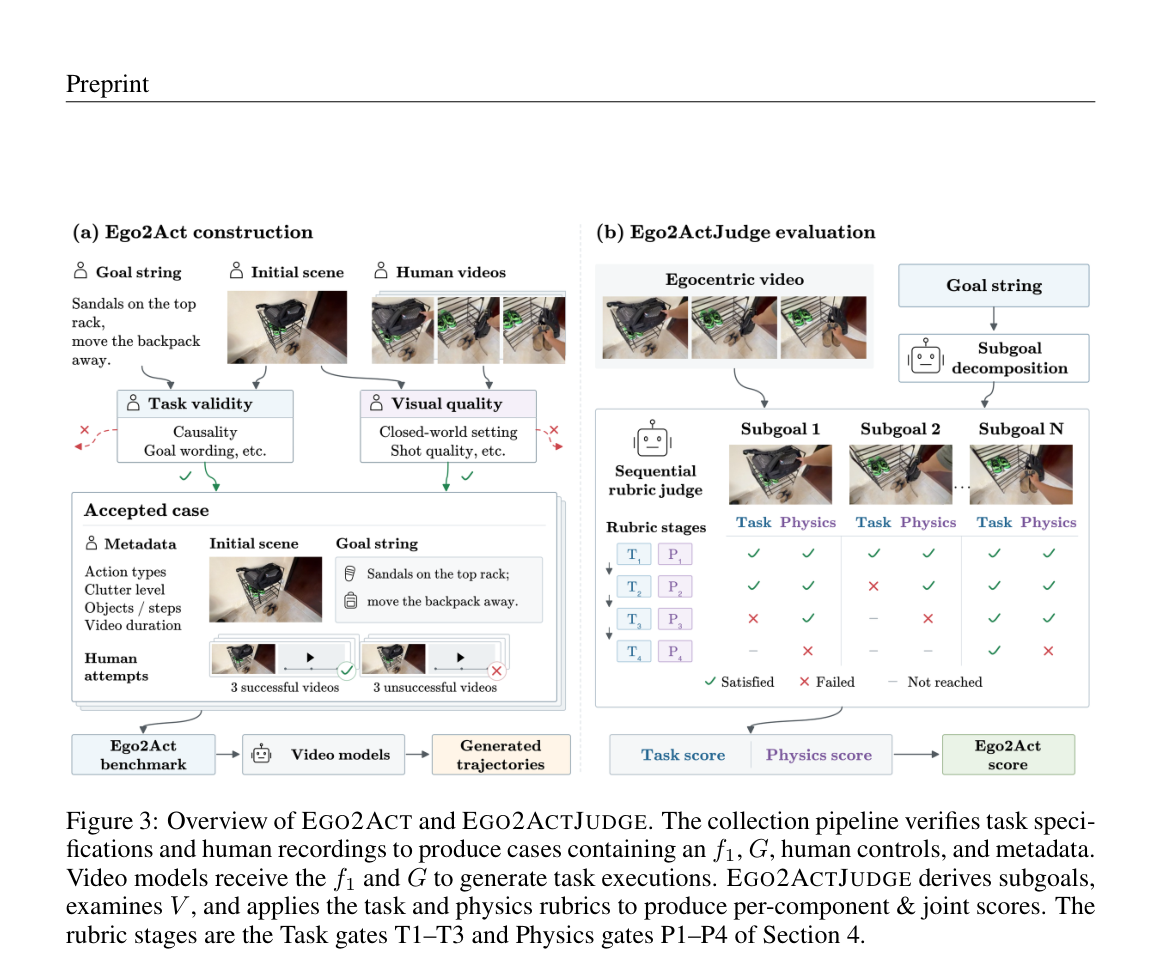
图3总览:左为案例构建,校验目标表述与封闭世界录像后保留 3 成 3 败人工对照,再送给视频模型;右为 EGO2ACTJUDGE,先拆子目标,再按 T1–T3 与 P1–P4 顺序门控,几何平均得到总分。宜作特色图。
关键证据
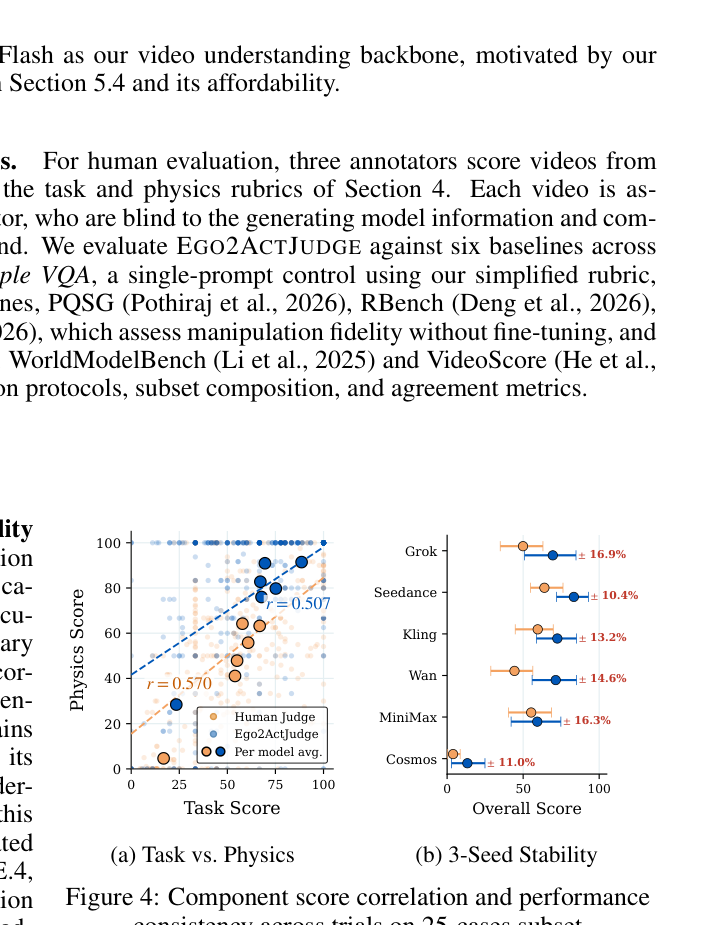
图4在 25 案子集上:(a) 任务分对物理分散点,人类与自动评判质心分离,相关只中等;(b) 三种子稳定性,Seedance 较高、Cosmos 接近零。裁切带有周围正文,读图时以两条坐标轴与误差条为准。
实验如何设计?
- 生成模型为 Grok Imagine 1.5、Seedance 2.0、Cosmos 3、Kling v3 Pro、MiniMax H3、Wan 2.7,480p、最长约 15 秒(Wan 2.7 最长 10 秒)。评判骨干为 Gemini-3.7-Flash。人类评审在 25 案、600 段视频上三人打分,盲模型、先校准。
- 自动评判对照六类基线:简化量规的单提示 VQA,结构化问题图 PQSG、RBench、WR-Arena,以及微调感知评估器 WorldModelBench 与 VideoScore。一致性用 ICC 与 Krippendorff α,对齐用 Pearson r、Kendall τ、CCC 与 MAE。
- 另做动作族难度、种子稳定性、顺序门控消融与骨干替换。定性失败按跳过前置、结果不完整、领域特定操作,以及物体不一致、边界穿透、机构违规来归类。
关键结果与论文证据
- 25 案人类评审面板上,最高分 Seedance-2.0 总分仅 64.0(任务 67.8 / 物理 63.0);Cosmos-3 仅 3.9。正确人工对照为满分 100,错误人工对照 73.4。EGO2ACTJUDGE 给 Seedance 83.3,相对人类偏高,但六模型排序与人类几乎一致(Spearman ρ=0.94)(页7,Table 2)。
- 任务分与物理分只中等相关(人类 r=0.570,自动 r=0.507),点云很散,成功完成步骤并不等于物理可信;多种子分数波动也大,Seedance 相对更稳(约 ±10.4%)。接触密集动作最难:连接/附着子目标任务完成 38.6%、物理 66.7%,低于搬移/摆放的 51.1% 与 75.5%;物料转移/混合最常做不完。场景杂乱和物体数量没有显著关联,任务长度只有弱负相关(ρ=−0.29)(页7–8)。
- 量规标注 ICC=0.863;EGO2ACTJUDGE 与人类共识 Pearson r=0.69,高于 WR-Arena 0.42、RBench 0.40 与单提示 VQA 0.32。VideoScore 几乎分不出正确与错误人工对照。去掉顺序门会抬高分数:独立提问使总分虚高 6.8,r 从 0.69 降到 0.65。去掉物理连续性门 P1 使 MAE 升到 0.922。骨干对帧内重复或换身份较敏感,对帧间短时跳跃不敏感,物理分宜当作偏乐观(页8–9)。
阅读时需要注意
- 人类主表来自 25 案面板而非全部 110 案;自动评判相对人类有向上偏差。物理门对跨帧违规覆盖不足。
- 生成时长上限约 10–15 秒,短于部分人工成功录像,可能截断长程任务。MiniMax 使用原生 4:3 与提示扩写,跨模型比较需读附录。
- 基准与评判代码写明发表后公开,本次正文未抽到可点击项目 URL,公开状态待核验。自我中心录像含手部与家居物品,作者强调研究用途并提示伪造演示风险。
关联工作
- UniSim、UniPi、VLP、DreamGen、EgoWM 把视频生成接到控制或规划;EgoForge 接口相近,但用参考保真度而不是目标完成来评。
- VBench、VideoScore 偏画质与提示对齐;VideoPhy-2、PQSG、WorldModelBench、RBench、WR-Arena 覆盖物理或规划,却不是真实自我中心加开放目标加无参考的组合。
- ALFRED、CALVIN、EgoTV 评交互 Agent 或既有录像;EGO2ACT 评的是生成模型能否从真实初始帧与高层目标滚出完整操作。