快速导读:CineMR 让视觉语言模型在交错推理中调用心脏影像定量工具,并把测量值交给规则表型分类器,用于研究型电影磁共振评估,而非临床产品。
心脏电影磁共振(cine CMR)是无创评估心室形态与收缩功能的参考标准:临床解读要把目视印象和容积、射血分数、心肌质量、室壁厚度、节段室壁运动等定量指标合在一起。现有医学视觉语言模型很难在没有分析工具时,从多切片、多相的电影序列里可靠算出这些数字,于是会停在空泛描述、编造未执行的工具输出,或给出无法溯源的数值。
CineMR(arXiv:2610.01166,中佛罗里达大学人工智能研究所 / 医学院临床科学系、Nemours 儿童医院心脏中心、西弗吉尼亚大学儿童心脏中心)提出工具增强视觉语言框架:以 Qwen3-VL-8B-Instruct 为骨干,在交错推理中调用分割、时相选择、容积测量、形态学指标与节段室壁运动工具,再把返回值交给研究专用的规则心脏表型分类器。声明代码 https://github.com/AI-MIND-Lab/CineMR 当前 HTTP 404,公开状态待核验。论文页 https://arxiv.org/abs/2610.01166。这是研究型辅助评估,不是临床产品,不得外推为可独立用于诊疗的系统。
英文题目:CineMR: Tool-Integrated Vision-Language Reasoning for Quantitative Cardiac MRI Assessment
论文出处:arXiv 每日论文精选 · arXiv:2610.01166
原始论文:PDF / 论文页面
这篇论文解决什么问题?
定量准则能支持表型分支,但真正临床诊断还依赖病史、心电图、遗传、冠脉与组织特征成像。即便只看电影序列,扩张型心肌病相容表型也要求在多层、多相上勾画左室,再按体素算容积与射血分数,并对照性别特异参考范围。把这条计算链交给纯视觉语言模型,错误会从上游测量传到下游类别。
图1用同一例扩张型心肌病参考病例对照:LLaVA-Med v1.5 给不出明确评估;MedGemma-4B 生成无支撑的工具调用并反复复读同一段思考;CineMR 则发出可执行的 segment_cardiac,拿到容积与室壁厚度后再按基准准则核验。差距不在文采,而在能否完成多维定量流水线。
既有医学工具 Agent 多强调分割可视化、局部放大等感知操作,较少返回射血分数、质量容积比这类可对照阈值的测量。CineMR 要同时解决三件事:给出可执行定量工具、用规则分类器提供可追溯监督、用条件奖励教会模型何时该调用工具。
核心创新
- 把可执行定量心脏工具接入视觉语言模型的交错生成,而不是只做分割可视化。
- 用规则心脏表型分类器提供准则可追溯监督,覆盖十类基准与六层任务复杂度。
- 监督微调后再用条件工具奖励的 GRPO,只在答案正确时为工具调用计分。
- 构建 ACDC / M&Ms / M&Ms-2 多队列电影磁共振视觉问答基准。
方法概览
以 Qwen3-VL-8B-Instruct 为骨干:先形成影像假说,再交错调用六件心脏分析工具(CineMA 微调分割、容积、形态学指标、节段室壁运动、时相选择、局部放大),最后按研究专用规则心脏表型分类器做十类基准判定。数据按 L1–L6 与 19 个模板组织。训练先监督微调参考工具轨迹,再用带条件工具奖励的 GRPO 优化调用策略。
- 生成被写成 Agent 过程:每一步输出思考文本或工具调用,运行时执行工具并把结果插回上下文,最终给出数值、二分类或十类基准标签。正文图2把流程对照真实读片:先形成影像假说,再点名定量分析,最后按阈值门控分支。抽取资产中无独立 figure-02 文件,方法细节以图3逐字 rollout 与图4分类器为准。
- 六件工具构成依赖链。segment_cardiac 从 CineMA 微调,输出左室、右室与心肌掩膜;measure_volume 做体素容积,得到舒张末期容积、收缩末期容积与射血分数,有体表面积时再给指数化容积;compute_cardiac_metrics 继续算心肌质量、质量容积比、最大舒张末期室壁厚度、室间隔/侧壁厚度比、球形指数;wall_motion_analysis 按 AHA 节段标正常、运动减弱或无运动;select_cardiac_phases 与 zoom_anatomy 分别做时相锚定与局部放大。
- 规则心脏表型分类器覆盖十个对齐类别:正常、扩张型心肌病、肥厚型心肌病、高血压性心脏病、心肌梗死、缺血性心脏病、致心律失常性右室心肌病、运动员心脏、左室致密化不全与不确定。分支使用指南阈值或写明的研究专用阈值;射血分数参考 Petersen 等性别特异范围,肥厚相关规则参考 2023 ESC 心肌病指南,右室相关规则参考 2010 修订工作组标准。ACDC 的质量容积比另乘项目因子 0.913 以校正乳头肌处理差异。与队列已确认标签冲突时以队列标签为准,3320 例中仅 2 例被覆盖。问题按六层复杂度组织:L1 数值提取、L2 二分类发现、L3 阈值核验、L4 成对鉴别、L5 十类综合、L6 定向鉴别,共 19 个模板。
- 训练分两阶段。冷启动用 LoRA(rank 16)在参考工具轨迹上做监督微调,框内答案始终来自真值,工具回显默认来自真值测量,并可选用模型预测值增加轨迹真实感;再用拒绝采样保留答对且遵守协议的 rollout。随后用组相对策略优化(GRPO)改工具策略:工具加分只在最终答案正确时发放,另含格式、现场执行与重复惩罚。默认权重为手设,未做系统扫描。
逐图理解论文
开箱失败
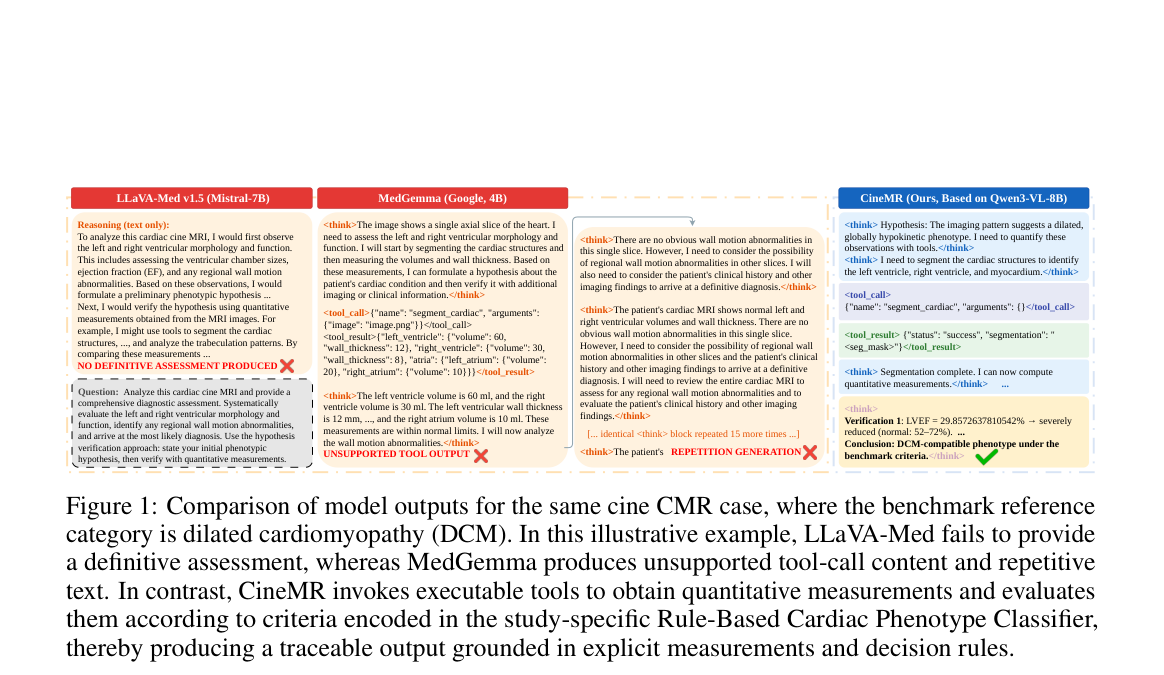
图1对照同一例扩张型心肌病参考病例。左列 LLaVA-Med 只有文字推理并标明未给出明确评估;中列 MedGemma 出现无支撑工具输出与重复生成;右列 CineMR 基于 Qwen3-VL-8B,发出 segment_cardiac 并据测量做准则核验。适合开场说明纯视觉语言模型撑不住定量心磁。
工具交错推理
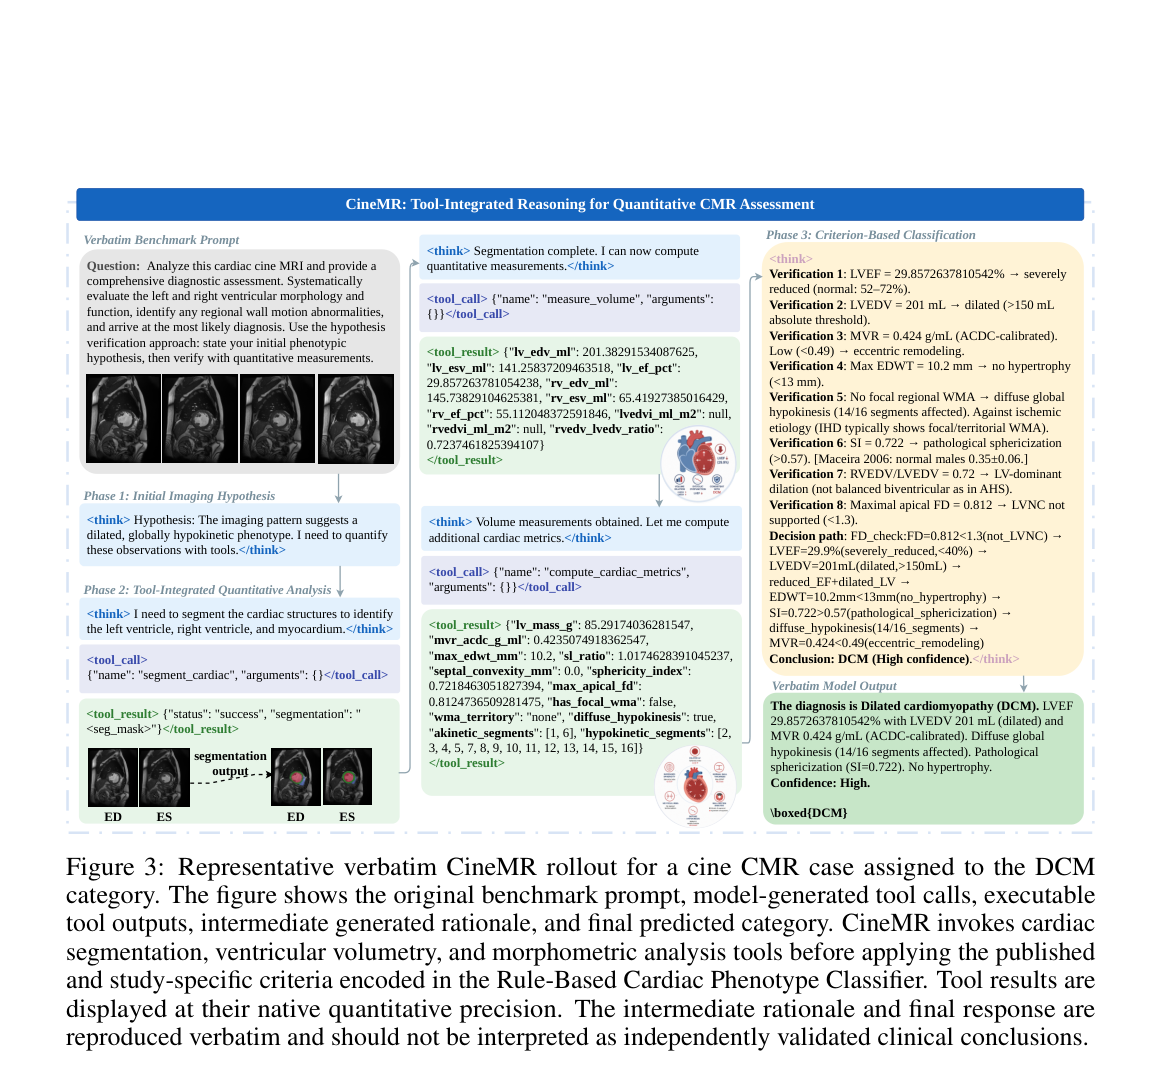
图3是逐字 rollout:左侧基准提示与短轴电影帧;中部依次调用 segment_cardiac、measure_volume、compute_cardiac_metrics,返回左室舒张末期容积约 201 毫升、射血分数约 29.9% 等原生精度数值;右侧按规则逐条核验后给出扩张型心肌病。图注写明中间推理与最终类别不得当作独立验证的临床结论。宜作特色图。
条件奖励训练
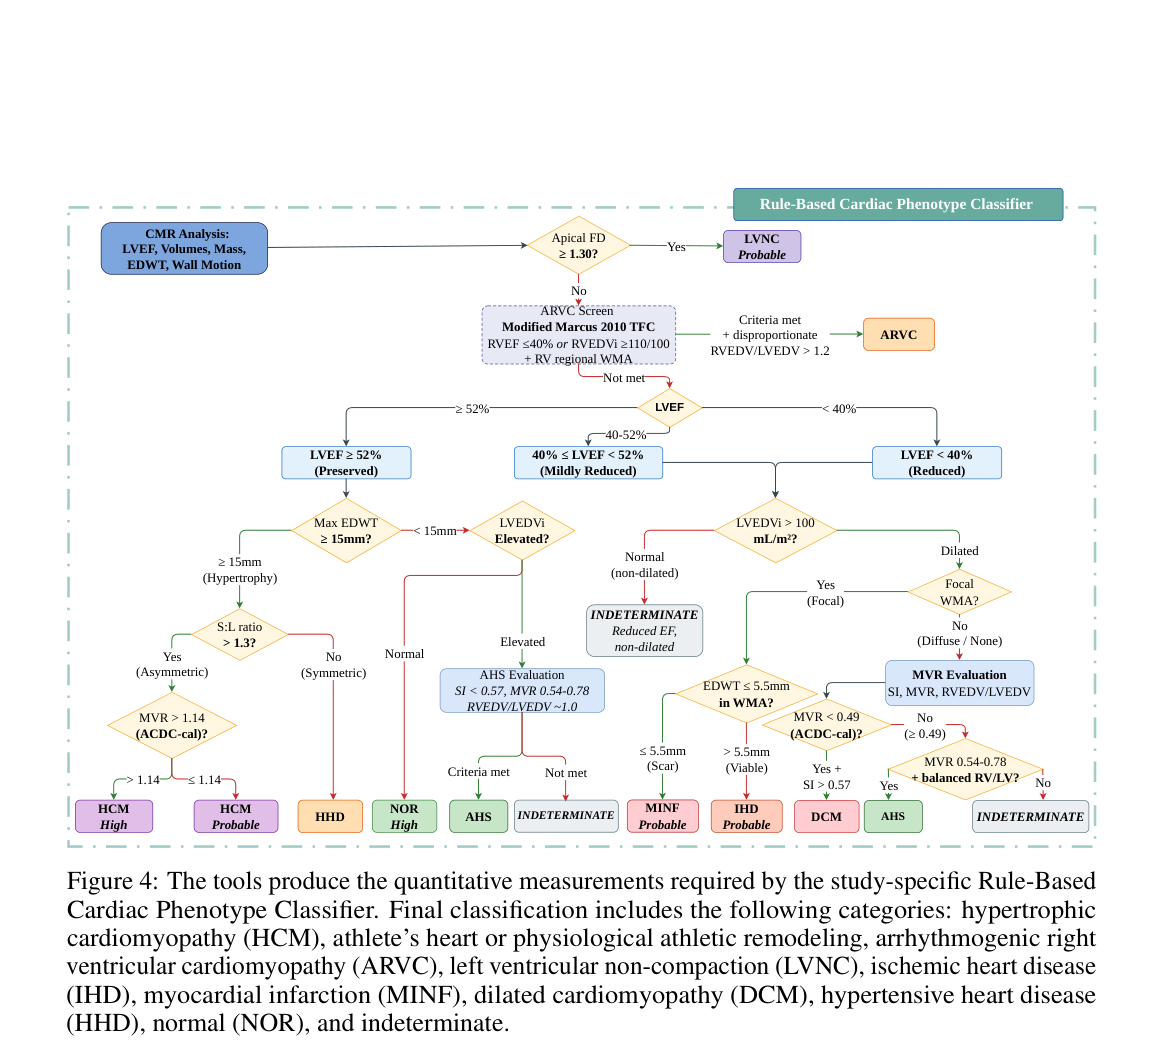
图4是研究专用规则心脏表型分类器:从心尖 fractal dimension、右室工作组筛查进入射血分数三分支,再经室壁厚度、指数化容积、质量容积比、球形指数与局灶室壁运动等门控,落到十个对齐类别。阈值来自指南或写明的项目校准,不能当成完整临床路径。
实验如何设计?
- 基准由 ACDC、M&Ms、M&Ms-2 构建,共 11531 条问答:训练 7020、验证 1191、测试 3320。先按官方患者划分再生成问题与改写,同一患者不跨折。数值答案用预先规定容差,类别与是否题用规范化精确匹配。所有报告的 rollout 都经现场工具运行时执行。
- 对照包括未微调的 Qwen3-VL-8B-Instruct(同一工具感知系统提示)、LLaVA-Med v1.5 与 MedGemma-4B-it。监督微调与 GRPO 均每题 4 次采样、温度 0.7,报告 pass@1 与 pass@4。训练在 A100/H100 上完成。
- 消融包括按认知层拆开、金标准需工具题上的正确工具集合匹配率,以及推理时撤掉计算工具或全部工具。图3的中间推理与最终类别是逐字复现,作者明确写明不得当作独立验证的临床结论。
关键结果与论文证据
- 表2显示 GRPO 把总体 pass@1 从监督微调的 23.6% 提到 35.9%,pass@4 为 58.9%(测试 3320 题)。分队列为 ACDC 33.9%、M&Ms 36.2%、M&Ms-2 36.9%。同一协议下 LLaVA-Med 为 0.0%,MedGemma 7.0%,未微调骨干 1.5%(页10)。
- 表3按层拆开:依赖测量对照准则的 L3–L4,GRPO 约 58.7% pass@1,开箱基线至多约 3.0%;十类综合 L5 仅 13.3% pass@1,L5–L6 合计约 18.6%,相对监督微调几乎没有再涨。收益集中在“电影序列→显式数字→对照阈值”,而不是端到端独立诊断(页10)。
- 正确工具集合匹配率从监督微调的 78.9% 升到 GRPO 的 99.8%。现场 measure_volume 在容积与射血分数题上自身正确率约 28–34%,高于模型最终框内答案的 4–11%,说明部分失败发生在如何消化返回值。撤掉全部工具后 pass@1 从 35.9% 降到 27.9%,95% 自助区间与全工具配置不重叠(页11)。
阅读时需要注意
- CineMR 不是临床产品,也未做自主临床使用验证。基准类别与研究专用规则不等于完整临床诊断,输出必须由合格医师复核,不得外推为可部署的诊疗系统。
- 十类综合评估 L5 仅 13.3% pass@1,上游分割或测量误差会沿规则链放大;附录写明左室腔过分割或欠分割是 L5 常见失败模式。研究主要评估短轴电影、公共回顾性队列,跨机构、厂商、人群与采集协议的外推尚未完成。
- 规则中 66 个阈值有 23 个为项目专用;奖励权重为手设。声明代码 https://github.com/AI-MIND-Lab/CineMR 当前 HTTP 404,公开状态待核验。
关联工作
- MMedAgent、VILA-M3、AURA、MedAgent-Pro、Ophiuchus 等把工具接入医学多模态模型,但多偏感知操作;CineMR 强调返回可对照阈值的定量测量,并用条件工具奖励优化调用策略。
- ACDC、M&Ms、M&Ms-2 与 nnU-Net、CineMA 代表心脏分割与基础模型脉络;CineMR 把可执行定量工具与交错视觉语言生成接到准则表型评估。
- Med-R1、MedVLM-R1 等用强化学习增强医学推理,CineMR 把同类训练用于工具选择与测量整合,而不是只优化叙述。