快速导读:PEARL 先对用户历史做显式推理并渲染,再对照历史反思改写计划,在真实历史基准 PMH-IG 上提升个性化生图。
个性化图像生成长期被定义成:给几张参考图,在新提示词下复现某张脸、某件物或某种画风。真实用户却不是一张概念图。评论、帖子、配图和元数据里,散落着生活方式、兴趣和审美。电商里同一件商品应对不同人生成不同场景,社交里同一话题也应长得像该账号一贯的视觉身份。PEARL(arXiv:2610.00737,Vanderbilt / Adobe / 马里兰大学 / 佐治亚大学)把这件事写成“先推理、再渲染、再对照历史反思”的闭环,并配套提出基于真实历史的基准 PMH-IG。
框架用 Qwen2.5-VL-7B 做 planner 与 reflector,冻结 SDXL 只负责按文本计划出图。先根据历史写出场景计划并得到初渲染,再把这张图拿回与历史比对、改写计划后重绘。训练先用教师银轨迹热启动,再用带检索奖励的 Render-in-the-Loop 交替 DPO。两个任务上个性化相关指标平均约提升 15%,检索与 MLLM 评审同步上升。制作时未见独立项目页。
英文题目:Personalized Image Generation with Reasoning and Reflection
论文出处:arXiv 每日论文精选 · arXiv:2610.00737
原始论文:PDF / 论文页面
这篇论文解决什么问题?
图1把条件个性化与身份个性化拆开。左边场景任务:用户1的评论写农场与马,历史购买是马鞍;用户2写登山靴与冲锋衣。同样一块手表或手电筒参考图,不应该生成同一张目录图。中间创意任务:用户3的 Instagram 是厨房生活与料理,话题 Coffee;用户4是哥特时尚与皮靴,话题 Necklace。右边 (a) 条件个性化几乎复制参考物,(b) 身份个性化才出现 Rugged Style、Greenery Themed、Warm Tone、Dark Themed 以及“马术爱好者”“山地徒步”“居家料理”“哥特时装”这些从历史读出的人设。
现有方法要么把整段历史熔成稠密向量塞进生成器,要么让多模态模型一次写出计划再交给冻结文生图模型。前者把线索缠在向量里、生成器只能隐式解码;后者在看见渲染之前就锁定计划,历史里认对的偏好仍可能在出图时丢失。PMH-IG 因此强调三条原则:信号来自真实公开活动,条件负责“画什么”、历史负责“怎么画”,评价必须同时看条件保真、画质与用户级个性化。
核心创新
- 提出 PMH-IG:从真实 Amazon/Instagram 历史做身份推断,而不是少量参考图复现概念。
- 把个性化拆成先推理出计划、再对照渲染反思改写的交错闭环。
- 用银轨迹热启动加 Render-in-the-Loop 交替 DPO,让两个策略对着真实组合后的图像优化。
- 用检索、画质、MLLM 评审与人工偏好组成多轴评价,避免单点保真度冒充个性化。
方法概览
PEARL 把多模态推理器与冻结 SDXL 交错起来。Planner πϕ(Qwen2.5-VL-7B)读历史 Hu 与条件 c,写出思维链 r1 和自洽场景描述 s1,渲染得到 I1。Reflector πψ 再拿 (Hu,I1) 对比历史,指出场景不合、生活线索缺失或审美偏离,写出修订计划 s2,再渲染最终图。训练分两阶段:先用看见身份锚点 I⋆u 的 Gemini 2.5 Flash 教师蒸馏银轨迹做 LoRA SFT;再做 Render-in-the-Loop 交替 DPO,K=4 个候选走完整下游管线,用任务对齐的检索奖励打分,对 planner 与 reflector 各更新一轮。
- Planner πϕ 读 (Hu,c),自回归写出思维链 r1 与可直接作为文生图提示的场景描述 s1。相关场景很少完整出现在单条历史里,所以这是对分散行为与审美线索的聚合,而不是检索一张旧图。冻结生成器 G 得到初渲染 I1=G(s1,c);场景任务里 c 是商品图,创意任务里 c 是话题。
- Reflector πψ 以 (Hu,I1) 为条件,写出结构化分析 r2 与格式相同的修订描述 s2。r2 沿具体个性化轴对比初渲染与历史,例如场景是否违和、生活线索是否缺失、审美是否偏离。最终图 Î=G(s2,c)。反思的关键是:计划要在看见生成器如何实例化之后再改,而不是只在文本空间里自洽。
- 训练分两段,都用 LoRA。银轨迹阶段,教师 Gemini 2.5 Flash 额外看见身份锚点 I⋆u(场景为留出目标图,创意为留出帖),分别为 planner 与 reflector 写出可被学生复现的 (r⋆,s⋆);reflector 的伪初图由银计划经 G 渲染得到。第二段把两个策略放进真实推理组合:对 planner 采样 K=4 条候选,经冻结 reflector 与 G 得到最终图,用任务对齐奖励 R(Î,Hu) 取最高最低构成 DPO 对;再固定 planner,对 reflector 做同样的采样–渲染–打分。场景奖励混合推荐倒数排名、身份元素覆盖与 Qwen 点分;创意奖励混合与留出帖的 CLIP/DINO 相似。正文只交替一轮。
逐图理解论文
真实历史
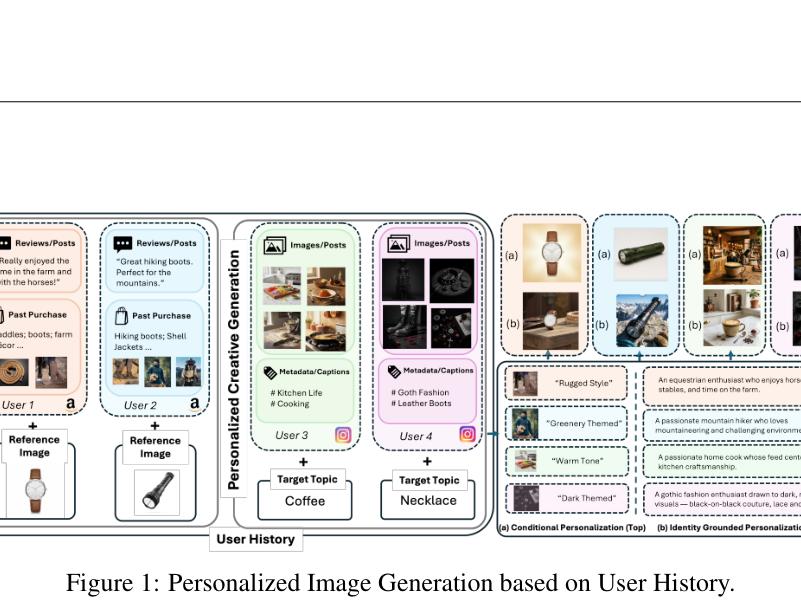
图1说明基于用户历史的个性化生图,顶沿略被裁切。左栏两个用户的 Reviews/Posts 与 Past Purchase,参考图分别是手表和手电筒。中栏 Instagram 式 Images/Posts 加 Metadata/Captions,话题 Coffee 与 Necklace。右栏对比 (a) Conditional Personalization 与 (b) Identity Grounded Personalization:同一对象在身份条件下变成 Rugged Style、Greenery Themed、Warm Tone、Dark Themed,并配有马术、徒步、居家料理、哥特时装等英文人设。
推理闭环
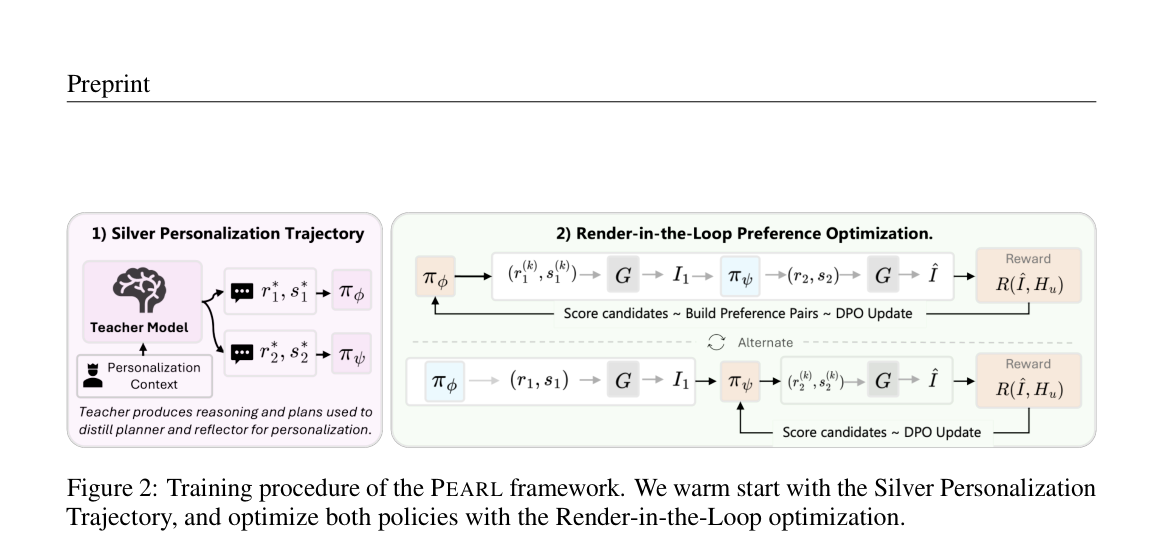
图2是训练总览,宜作特色图。左粉框 1) Silver Personalization Trajectory:Teacher Model 结合 Personalization Context 写出 r1*,s1* 蒸馏 πϕ,写出 r2*,s2* 蒸馏 πψ。右绿框 2) Render-in-the-Loop Preference Optimization 分上下两路、中间标 Alternate。上路更新 planner:πϕ 采样 (r1^(k),s1^(k)),经 G 得 I1,再经 πψ 与第二次 G 得最终图 Î,用 Reward R(Î,Hu) 构造偏好对做 DPO。下路固定 πϕ 出 (r1,s1) 与 I1,对 πψ 的候选 (r2,s2) 同样渲染打分。
关键证据
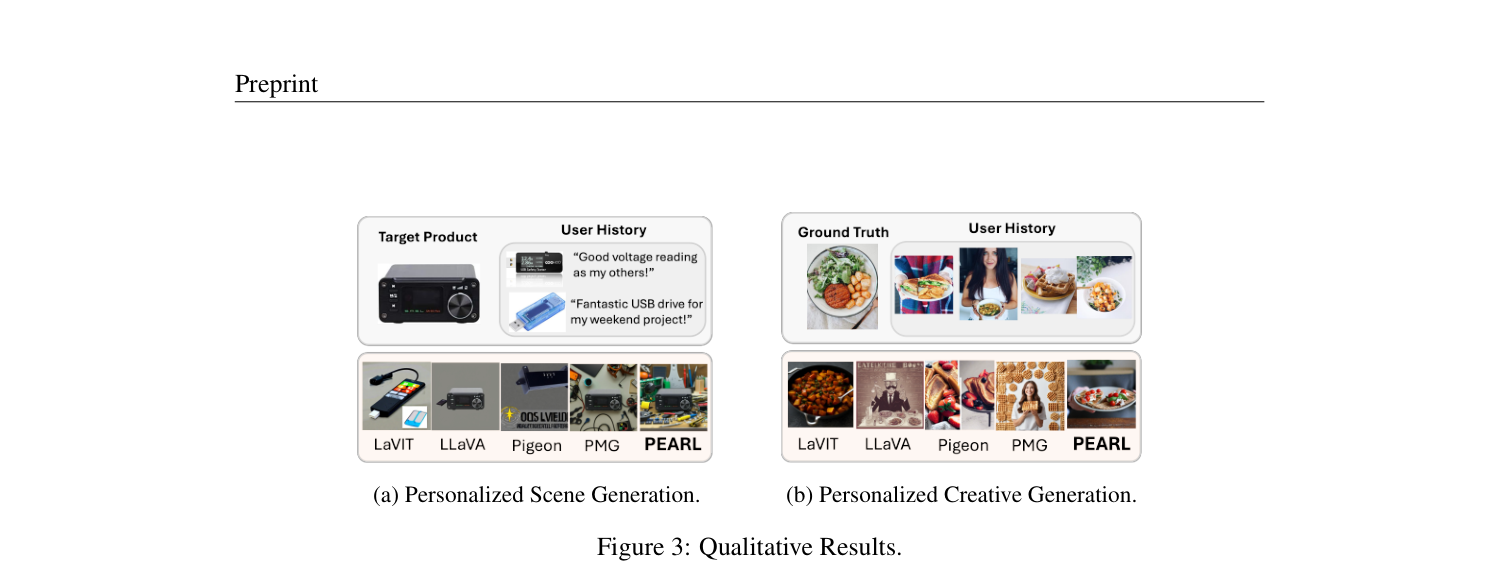
图3定性对比。 (a) Personalized Scene Generation:Target Product 是带旋钮屏幕的黑色电台,User History 是电压表与蓝色 USB,评论写周末项目;下方五张生成图从左到右为 LaVIT、LLaVA、Pigeon、PMG、PEARL,最右张把设备放在工具台。 (b) Personalized Creative Generation:Ground Truth 是浅色碗中的沙拉,历史是手持餐食与清淡厨房风;对照偏暗或偏甜点,PEARL 更接近真值的器皿与构图。
结论与局限
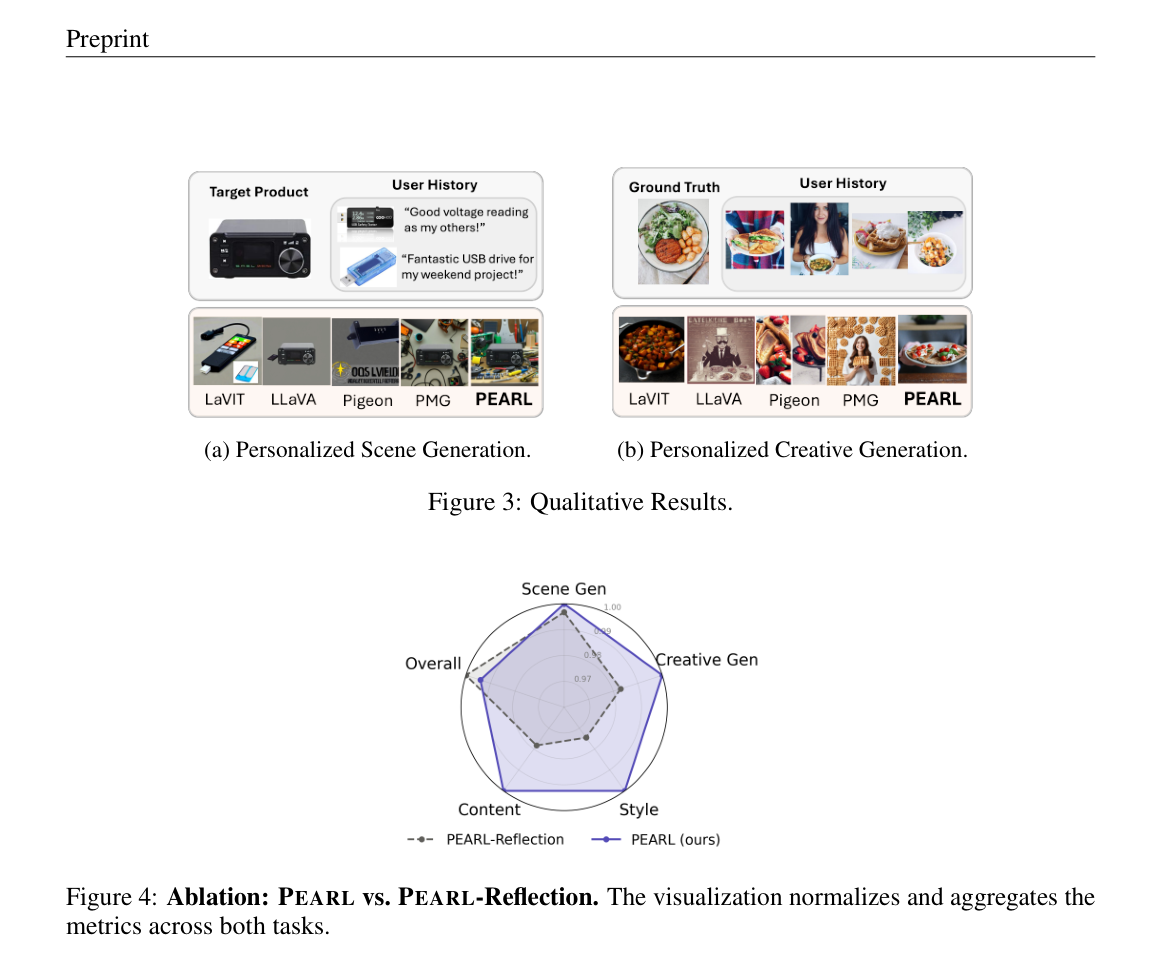
该 PNG 上半重复图3定性,下半才是图4雷达。五轴为 Scene Gen、Creative Gen、Style、Content、Overall,刻度约 0.97、0.99、1.00。实线填充 PEARL,虚线 PEARL-Reflection。PEARL 在 Creative Gen、Style、Content 上更靠外;Scene Gen 与 Overall 上虚线略高。正文解释反思主要对齐检索和画质捕捉不到的细粒度风格与内容,Overall 降幅不到百分之一。
实验如何设计?
- 场景数据来自 Amazon Reviews 2023,限制在运动户外、家居厨房、工具家改、汽车、宠物、电子六类。训练 3972 用户 39720 条评,验证 510,测试 518;合计 5000 用户 5 万评。创意数据来自 Instagram,训练 3464 用户约 4 万帖、957 对,测试 207 用户 2 千帖、314 对。
- 共享指标是 LAION 美学与 Gemini Flash 2.5 + Qwen2.5-VL-32B 集成的 1–5 分风格/内容/总体。场景没有真值场景图,另训双塔对比视觉推荐器,用生成图做 Hit@5 与 MRR,看能否把用户留出真实购买检索回来。创意有留出帖,报告 CIS、DIS、LPIPS、MS-SSIM,并用 StyleDiscriminator 做跨类与类内 R@1。
- 对照 PMG、Pigeon、LLaVA、LaVIT 全部接到同一 SDXL。人工为单标注者、方法名隐藏:25 对场景对 PMG,25 对创意对 Pigeon。消融 PEARL-Reflection 去掉交替 DPO、只留 SFT。实验在单张 4090 上完成。
关键结果与论文证据
- 场景任务上 PEARL 全列最优:Hit@5 0.2297、MRR 0.1639,高于 PMG 的 0.2143/0.1535 与 Pigeon 的 0.0985/0.0834;美学 5.33,MLLM Overall 3.92、Content 4.36、Style 2.88。作者把画质提升也归因于更好的场景推理,因为渲染器相同(页7)。
- 创意任务 10 列中 7 列最优,检索与 MLLM 评审全赢:CIS/DIS 0.645/0.289,跨类/类内 R@1 0.876/0.701,Overall 3.541。赢 LPIPS 或 MS-SSIM 的方法检索很差,说明单点保真度不能代替个性化。人工方面,历史契合选 PEARL 的比例为场景 19/25(76%)、创意 16/25(64%),作者标明这是初步单标注、不是用户本人偏好(页8)。
- 图3定性:场景目标是带旋钮的电台类设备,历史评论写电压表和周末 DIY;LaVIT/LLaVA/Pigeon 难以保住商品或场景,PMG 有设备但背景泛,PEARL 把设备放进工具台。创意真值是浅色餐具上的食物,历史是手递餐食的清淡厨房风;对照出现过暗、过甜或人物错位,PEARL 更接近手递与浅器皿。图4雷达在 0.97–1.00 的归一化尺度上,完整 PEARL 在 Creative Gen、Style、Content 上包住只做 SFT 的 PEARL-Reflection,Scene Gen 与 Overall 上虚线略高,正文称 Overall 降幅不到 1%,反思主要补细粒度风格与内容(页9)。
阅读时需要注意
- 场景任务没有自然真值场景图,个性化只能通过检索与评审间接读,无法做参考图式的逐像素对齐。
- Render-in-the-Loop 只交替一轮,多轮是否继续涨点未经系统研究。
- 人工样本小、单标注者,且评价的是对展示历史的契合,不是上线点击或创作者自认。教师蒸馏依赖特权锚点,部署时不可见。
关联工作
- DreamBooth、Textual Inversion 做测试时优化,IP-Adapter 做适配器条件化,三者都把个性化定义成复现指定概念。
- Pigeon 对历史做掩码聚合,PMG 把历史转成文本偏好,Personalized Image Editing 用协同 DPO 在用户间共享审美;它们把历史当条件,缺少对目标图含义的显式推理。
- 个性化文本生成与推荐长期使用用户历史;PMH-IG 把同一原则搬到图像,并要求条件与身份信号分离。