快速导读:PointWAM 把场景和手拆开,在同一时空坐标里预测三维点轨迹,再把手轨迹重定向成机器人动作,从而用人类视频预训练灵巧操作。
灵巧手要在三维里贴着物体表面协调多指,只把图像映射成关节角往往抓不住接触。世界动作模型试图同时预测世界变化和机器人动作,但多数仍用 RGB 或潜变量表示世界,动作用末端位姿来写,三维结构和因果接触仍然是间接的。
PointWAM(arXiv:2610.02840,POSTECH / KAIST / Hanyang / RLWRLD)把世界拆成场景和手,在同一时空坐标里预测每个观测点与每手十个关键点的三维位移,再把手轨迹重定向成机器人动作块。表示与人类视频一致,因此可以在约 115 万条人类演示上预训练,而不必先选任务物体。DexJoCo 十任务平均成功率 69.0%,比最强对照高 11.7 个百分点。项目页https://chrockey.github.io/PointWAM。
英文题目:PointWAM: 3D World Action Modeling for Dexterous Robotic Manipulation
论文出处:arXiv 每日论文精选 · arXiv:2610.02840
原始论文:PDF / 论文页面
这篇论文解决什么问题?
图1左侧是大量人类演示的 RGB 与深度,绿色点标手;右上把微波炉、双手和物体画成同一坐标系里的彩色轨迹。目标是:看到点云和一句话,先想象场景和手怎么一起动,再把这套手的运动接到机器人上。
VLA 不预测场景演化。视频式 WAM 要在潜空间里对齐动作。点策略能写三维运动,却把环境当成静止的被选中物体。PointWorld 一类模型预测稠密场景运动,但动作是输入而不是输出。PointWAM 同时要场景轨迹、手轨迹和动作。
额外约束是迁移:人类视频没有关节指令,机器人演示又远少于人类视频。若两边都能写成同一套点轨迹,预训练才不必做任务级物体标注。
核心创新
- 在共享时空坐标里联合预测场景点与手关键点的三维轨迹,把世界建模和动作建模写成同一种表示。
- 无需预先挑选任务物体或场景关键点,场景头对观测到的每个点都做预测。
- 把手轨迹与场景解耦,使人类视频预训练能迁移到机器人,并可用同一套点轨迹表示夹爪任务。
方法概览
给定语言指令、彩色点云和当前机器人状态,PointWAM 先用冻结 Mosaic3D 编码场景点,用手指标 one-hot 加手 ID 的 MLP 编码每手十个关键点,再与冻结文本编码器的指令 token 一起送入 transformer。点被放到 1 cm 体素网格,按 Volt 切成非重叠块得到视觉 token,轴向三维旋转位置编码做全局自注意力。解码后残差融合 stem 特征,两个 MLP 头分别预测场景位移 u 和手位移 v。动作重定向器只接手轨迹与状态:逐步嵌入后由 transformer decoder 和可学习 query 输出未来 T 步末端位姿与手指关节。训练分两段:在 EgoDex 与 VITRA 共约 115 万条人类演示上从头预训练主干和两个轨迹头;再在机器人演示上微调并从头训练 retargeter,损失为加权场景轨迹、手轨迹与动作 L1。
- 输入是指令 ℓ、彩色点云 P_t 和机器人状态 s_t(末端位姿与各臂手指角)。手用 K 个语义对应关键点,每手十个,人类来自 EgoDex 标注或 VITRA 重建,机器人来自正运动学。轨迹写成相对 t 的位移:u 是场景点,v 是手点。
- 三维轨迹预测器:冻结 Mosaic3D 提场景点特征;手点用索引 one-hot 加手 ID 的 MLP。特征落到 1 cm 体素,稀疏卷积 stem 后按 Volt 切成 K_v^3 的非重叠块,每块投成一个视觉 token。冻结文本编码器给出指令 token。Transformer 编码器做全局自注意力和轴向三维 RoPE。Detokenizer 还原到点,与 stem 特征残差融合,再分出场景头 MLPu 与手头 MLPv。场景头对每个观测点都预测,不挑选目标物体。
- 动作重定向器不看场景预测,只编码各未来步的手位移、步嵌入和状态嵌入,得到上下文 C_t;transformer decoder 用可学习 query 输出 T×d_a 的动作块,含末端位姿和手指目标。图2右侧用雪花标记冻结模块。
- 人类视频用 CoTracker3 的二维轨迹加 VGGT 单目深度(按手尺度缩放)得到场景轨迹。机器人侧 DexJoCo 用物体刚体回放移动初始点;真机用 Fast-FoundationStereo 深度抬升。先在人类数据上预训练主干和两头,再在机器人数据上联合轨迹损失与 λ=1 的动作 L1 训练 retargeter。
逐图理解论文
失败直觉
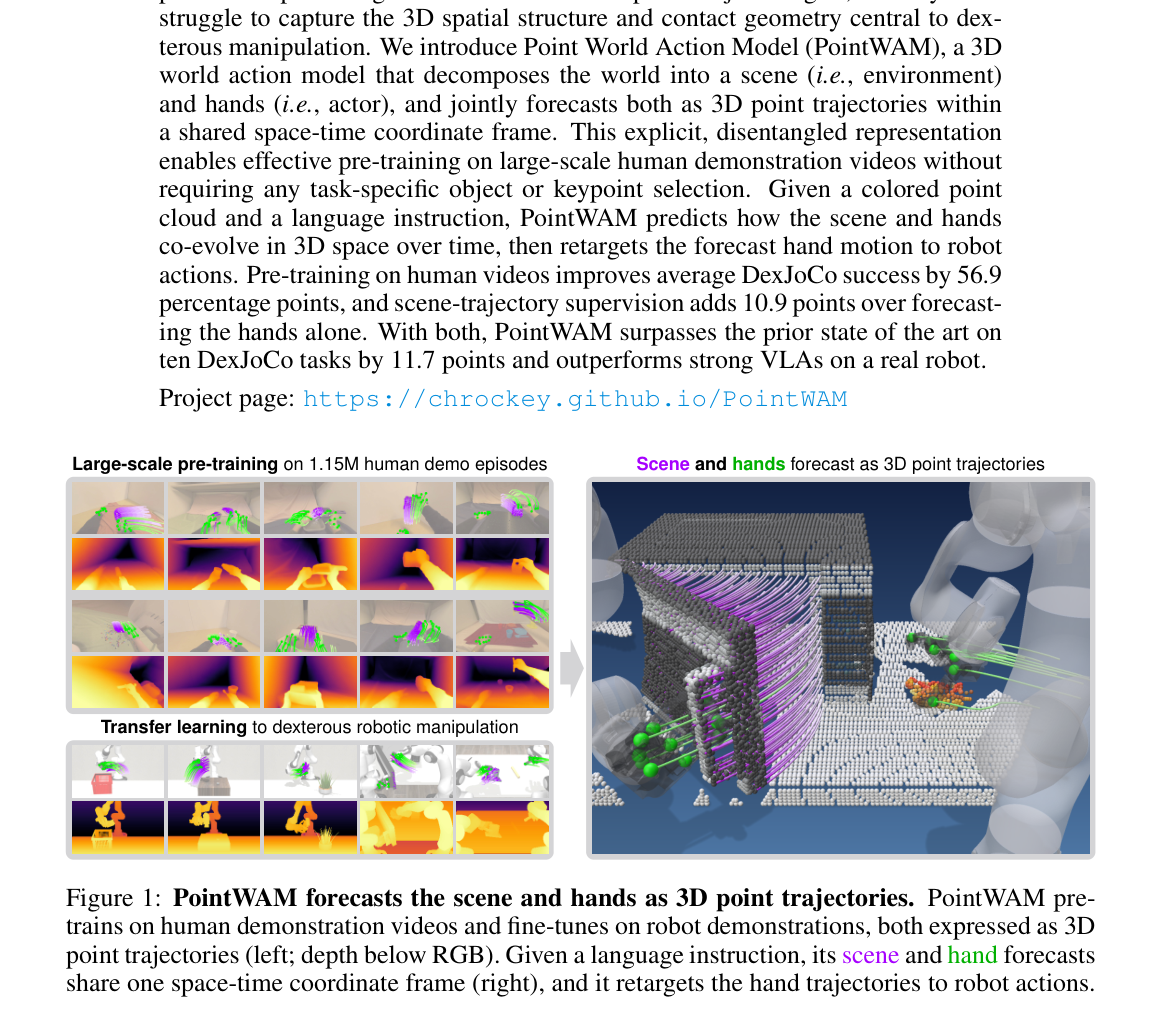
该裁切上半是摘要,下半才是图1。左上网格是 115 万条人类演示的 RGB,其下是对应深度热图,绿色点标手;左下较小网格是迁移到机器人后的 RGB 与深度。右侧三维图里微波炉点云、绿色手点和彩色物体轨迹处在同一坐标,标题写 Scene and hands forecast as 3D point trajectories。适合开场,但不要把摘要段落当成图注。
研究缺口
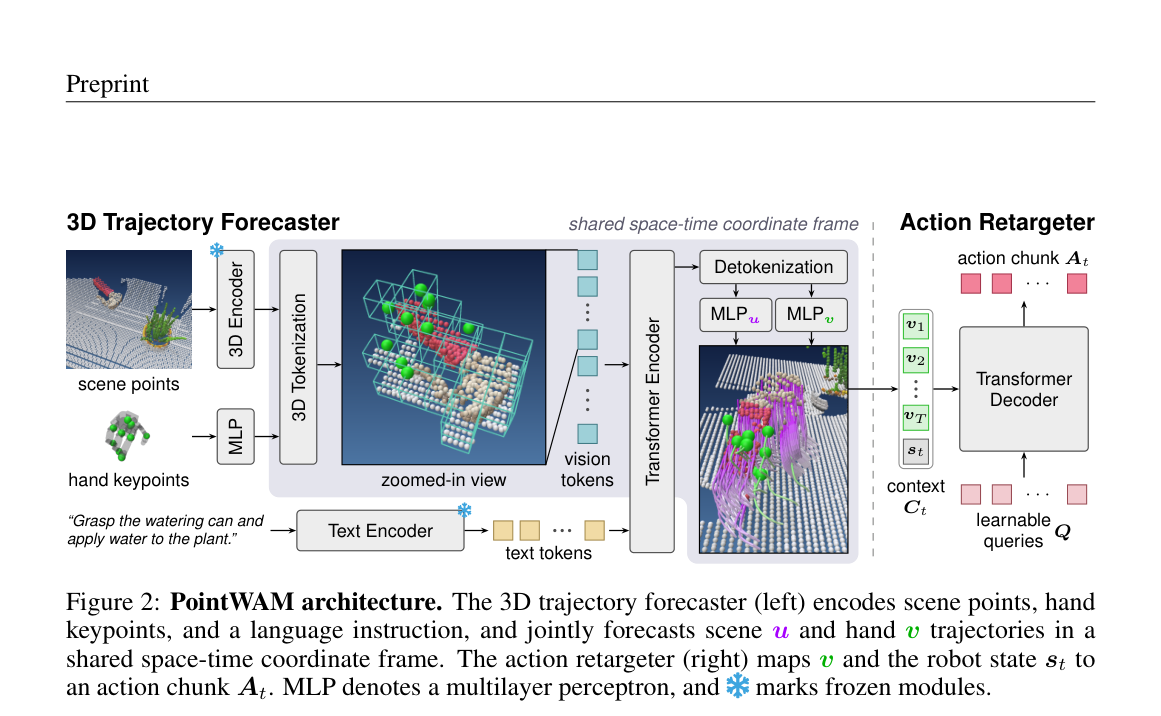
图2是架构,宜作特色图。左侧 3D Trajectory Forecaster:scene points 经 3D Encoder(冻结)、hand keypoints 经 MLP,再 3D Tokenization;中间放大的体素块里绿球是手、红点是场景,输出 vision tokens,与 text tokens 一起进 Transformer Encoder;右侧 Detokenization 后 MLPu 与 MLPv 画出品红场景轨迹和绿手轨迹。虚线右是 Action Retargeter:v_1…v_T 与 s_t 构成 C_t,learnable queries Q 经 Transformer Decoder 得到 action chunk A_t。指令示例为 Grasp the watering can and apply water to the plant。
关键证据
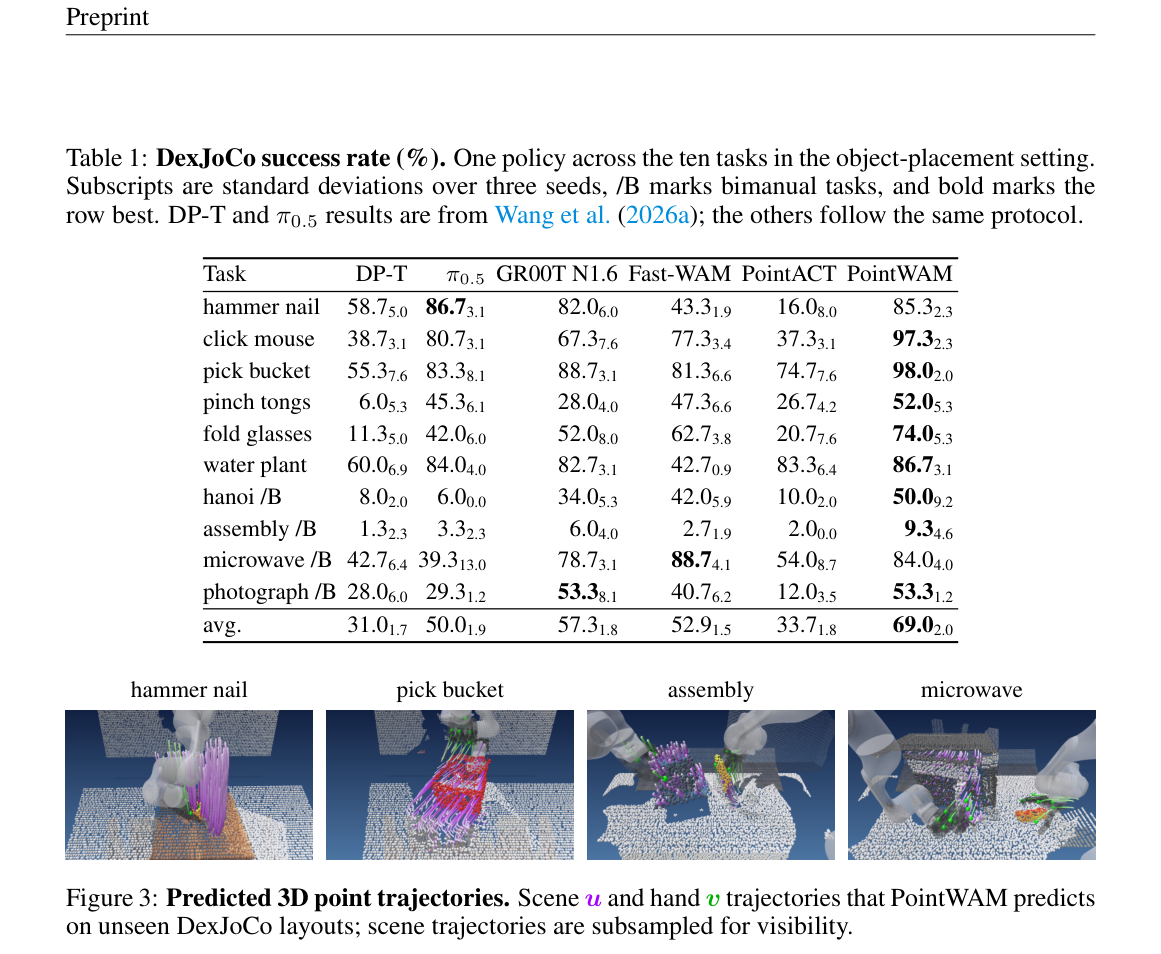
上半是 Table 1,下半是 Figure 3。表中 PointWAM 平均 69.0 加粗,八个任务最优。下排四张未见布局的预测轨迹:hammer nail、pick bucket、assembly、microwave,白色点云上品红/紫色为场景运动,绿色为手。讲数字时引用表,讲共演化时引用下排图。
结论与局限
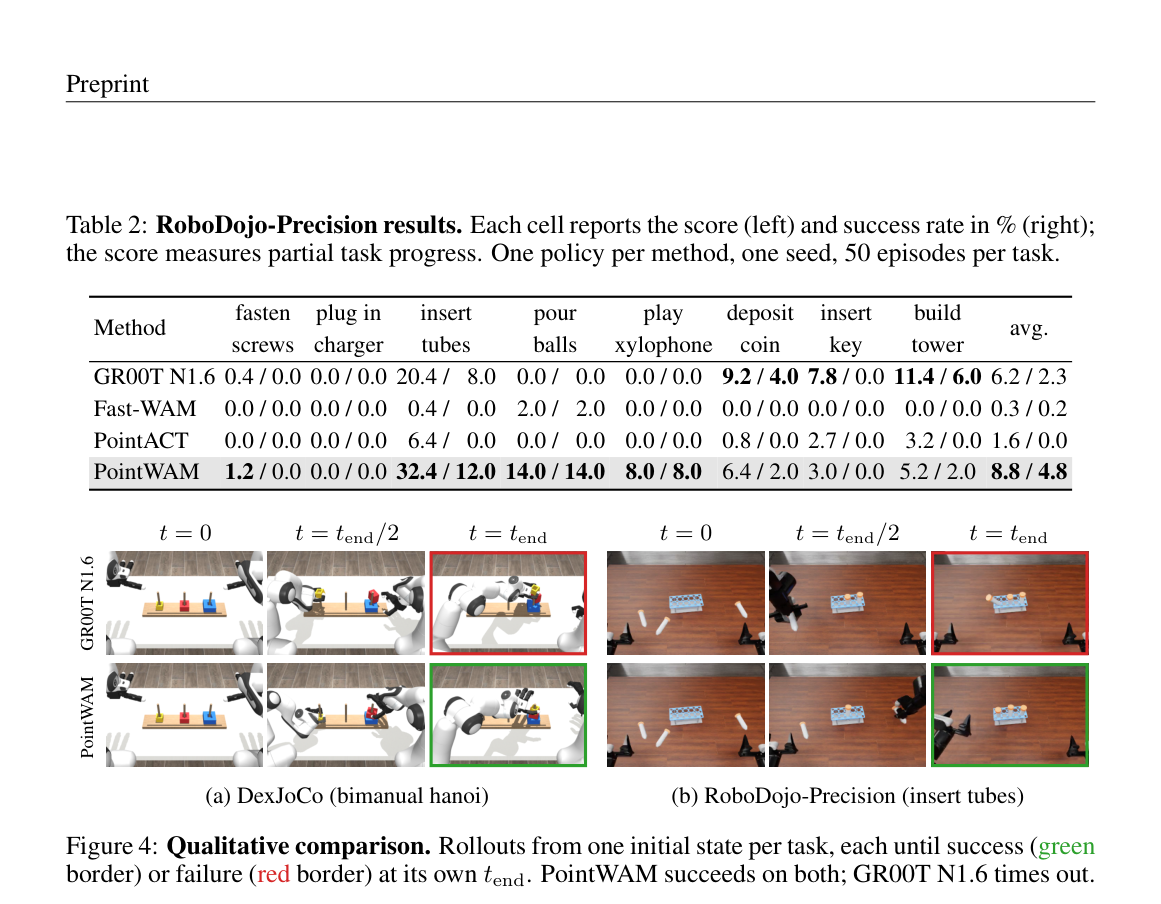
上半 Table 2:PointWAM 平均 8.8/4.8 加灰加粗,insert tubes 与 pour balls 明显领先。下半 Figure 4 两列时间轴 t=0、t_end/2、t_end。左列 DexJoCo 双臂汉诺塔,GR00T 终帧红框超时,PointWAM 绿框叠好。右列 RoboDojo 插管,同样红对绿。用来同时给夹爪迁移和定性成功/失败边界。
实验如何设计?
- DexJoCo:十一任务中排除 replay 失败过多的 bimanual unlock iPad,保留十任务,物体放置设定。一种策略覆盖十任务,官方协议为三颗种子、每任务 50 个闭环回合。对照 DP-T 与 π0.5 用论文发表数字,GR00T N1.6、Fast-WAM、PointACT 按同一协议复现。
- RoboDojo-Precision:八个夹爪高精度任务,各 100 条 RGBD 演示,每方法一种策略、一种子、每任务 50 回合,报告部分进度分和成功率。
- 真机 OpenArm 加 ZED 2i:香蕉抓放 54 条、方榫插入 64 条,各 24 次试验。香蕉一半域内、一半颜色接近桌面的未见盒子。方榫另报三阶段进度均值。
- 消融在 Volt-L12、仅 EgoDex、60k 微调的参考设置上进行,因此参考成功率 64.4%,低于表1满数据 Volt-H 的 69.0%。
关键结果与论文证据
- 表1(页6):PointWAM 平均 69.0%,八个任务最高。click mouse 97.3%、pick bucket 98.0%、fold glasses 74.0%、hanoi 50.0%。hammer nail 略低于 π0.5 的 86.7%,microwave 低于 Fast-WAM 的 88.7%。相对 GR00T N1.6 高 11.7 个百分点,且除 DexJoCo 微调外不再用机器人语料预训练。
- 图3把预测轨迹画在未见布局上:紫色/品红多为场景点运动,绿色为手。hammer nail、pick bucket、assembly、microwave 都能看出物体随手移动,而不是只挥手。
- 表2与图4(页7):夹爪精度任务上 PointWAM 平均 8.8/4.8%,GR00T 为 6.2/2.3%,Fast-WAM 与 PointACT 接近零。图4左列双臂汉诺塔 GR00T 超时红框,PointWAM 绿框完成;右列插管任务同样对比。论文把这解释为人类手预训练对夹爪的初步迁移,深度本身解释不了领先,因为 PointACT 也看到深度。
- 真机(页7–8):域内香蕉三方法接近,域外盒子 PointWAM 58.3%,对照 16.7% 与 25.0%。方榫插入 50.0% 对 16.7%、25.0%;三方法通常都能拿起两个零件,失败多在插入。
- 缩放与消融(页8–9):EgoDex 预训练把 PointWAM 从 12.1% 提到 60.1%,对照最多变 1.4 个百分点。数据从 32.4 万加到 115 万,成功率 60.1%→64.9%→69.0%。可训练参数从约 39M/106M 的约 50% 升到 Volt-H 655M 的 69.0%。Table 3:Mosaic3D 64.4% 对抬升 DINOv3 的 59.0%;去掉场景监督 53.5%;二维帧潜变量 60.1%;解剖关键点远好于手表面点;1 cm 体素优于 0.5 cm 与 2 cm。
阅读时需要注意
- 点表示会丢掉印刷文字和透明物体等细于点间距或深度失效的信息。未来工作提到给点加上外观或质量、摩擦等物理属性。
- bimanual assembly 成功率 9.3%,RoboDojo 平均成功 4.8%,绝对性能仍低。真机任务少、试验次数有限。
- 预印本。多任务表1与消融表3的模型规模和预训练数据量不同,不能把 10.9 个百分点直接套到 69.0% 那一行。
关联工作
- 相对 VLA,PointWAM 把三维接触写成可监督的点轨迹。相对 Fast-WAM,它预测的是点和手,而不是未来视频。相对点策略,它不再要求预先分割任务物体。
- EgoWAM、PointWorld、PointZero 说明三维场景运动已经出现,但灵巧手指动作与人类视频预训练的组合是本文的位置。
- 作者强调增益来自人类与机器人共用同一套场景-手点轨迹,而不是“做了世界模型”这一口号本身:同样做未来预测的 Fast-WAM 从 EgoDex 几乎得不到好处。