快速导读:SpatialMind 用度量深度适配与递进状态链,让视觉语言模型从当前几何和已见动态外推未观测未来的距离与关系。
现有视觉语言模型已经能描述看到的场景,但在动态环境里更关键的是预见:白车会不会越来越近、刹车后空隙还够不够。SpatialMind(arXiv:2610.04139,University of Illinois at Chicago 与 Bosch Research / BCAI)把空间推理写成三级递进——先建立当前度量几何与空间关系,再跟踪已见区间里的运动与关系变化,最后把这些趋势外推到未观测未来。项目页为 https://brack-wang.github.io/spatialmind/ 。
作者用可扩展数据引擎从 Waymo 驾驶视频与 Ego-Exo4D 日常自我中心视频生成度量问答,得到 SpatialMind-30K(30,677 条训练问答)与 SpatialMind-2K(2,000 道评测题),覆盖八类任务。模型把绝对度量深度适配器与递进状态链接到 Qwen3-VL-8B:在自建基准上总体准确率从同数据微调的 45.70% 升到 52.65%,并在 VSI-Bench、OSI-Bench、VLM4D 上取得有竞争力的零样本结果。预印本尚未同行评审。
英文题目:From Sight to Foresight: Predictive Spatial Reasoning in Vision-Language Models
论文出处:arXiv 每日论文精选 · arXiv:2610.04139
原始论文:PDF / 论文页面
这篇论文解决什么问题?
可靠的未来预测依赖两件事:把实体钉在米制空间里,以及看清已见区间里场景如何演化。缺少前者,未来距离没有物理尺度;缺少后者,外推没有时间趋势。作者因此提出一个根本问题:视觉语言模型要具备怎样的空间理解,才能做可靠的未来预测。
现有工作往往只覆盖这条链的一段。深度监督、RGB-D 或预训练三维特征能提供几何线索,但尺度仍受底层估计精度限制;未来事件监督或潜视觉推理多盯事件本身,较少显式估计以米为单位的未来距离。基准方面,度量几何、视角关系和已见运动已有较充分评测,STRIDE-QA 等开始看短时未来距离与速度,但仍缺少同一实体上从当前状态经已见动态到未来预测的完整评测。
核心创新
- 用 Select–Describe–Verify 与度量几何构造可扩展数据引擎,生成三级八任务问答与状态监督。
- 绝对度量深度适配器做全局与局部修正,再把几何与相机运动按时对齐并融合进视觉 token。
- 递进状态链按问题层级监督当前状态、已见动态与未来预测,把最终答案钉在显式中间估计上。
方法概览
数据引擎对目标做 Select–Describe–Verify:视频实例分割选出跨帧可见、面积足够的目标,在面积最大帧用 VLM 写类别与外观描述,再在无标记帧做反向定位,仅当预测框与目标重叠且无其他匹配对象时保留。随后用前馈三维模型预测稠密深度,并用源数据稀疏度量(Waymo 激光、Ego-Exo4D Aria 路标)拟合尺度与偏移,把深度校准到米制;在掩码内反投影到世界坐标,传播得到目标四维轨迹与观察者轨迹。据此自动生成三级八任务问答。模型侧,绝对度量深度适配器把预训练深度 D0 与多视图几何的多帧特征、深度与置信度结合,预测每帧全局尺度修正 δg 与局部修正图 Δl,在对数深度空间得到 Dm;度量编码器与运动编码器分别处理几何与相对相机变化,经锚点时间对齐后用交叉注意力写入视觉 token。递进状态链按层级生成 GROUND、CURRENT,Level 2 加 DYNAMICS,Level 3 再加 FUTURE,最后 ANSWER。用 LoRA 在同源问答上同时训练状态链与直接作答。推理只给观测 RGB 前缀与问题,不给未来帧。
- 数据引擎先锁定可跟踪目标。视频实例分割关联跨帧区域;只保留连续可见、面积足够的目标,取其面积最大帧裁剪后交给视觉语言模型,写出类别、外观与区分性属性。反向定位把描述送回无标记原帧,要求预测框与目标充分重叠且没有其他匹配对象,通过后才作为语义基础。
- 四维空间元数据需要米制几何。源数据稀疏深度覆盖不足,作者先用前馈三维模型预测稠密深度,再用稀疏度量参照拟合尺度与偏移并做跨帧稳定,把预测校准到真实尺度。目标掩码内的校准深度按内参与位姿反投影到共享世界坐标,掩码跨帧传播后连成四维轨迹;观察者位置取相机中心,朝向取相机朝向。驾驶视频来自 Waymo,日常视频来自 Ego-Exo4D。
- 问答按三级八任务自动生成。Level 1 问当前距离、速度与转角;Level 2 问观察者路程、目标路程与相对运动;Level 3 把视频切成观测前缀与扣留未来段,只给前缀,问未来方向、未来距离与未来关系。参考答案由空间元数据计算,数值题以米为单位。图2右栏给出配比:当前状态约 28.6%,已见动态约 35.8%,未来预测约 35.7%。基准题经人工对照几何与时间计算记录纠错。
- 模型推理时输入观测 RGB 与空间问题。冻结的深度估计器与多视图几何模型提供初值;可训练的绝对度量深度适配器预测全局尺度修正与局部修正图,在对数深度空间得到 Dm,并用系数限制偏离。度量编码器处理由 Dm 导出的几何,运动编码器处理相对相机变化,二者按采样帧时间做锚点对齐,再用交叉注意力写入视觉 token。视觉语言模型按问题层级生成递进状态链:GROUND 识别目标与空间参照,CURRENT 写当前空间与运动状态,Level 2 增加 DYNAMICS,Level 3 再增加 FUTURE,最后 ANSWER。训练用 LoRA,同时优化状态链损失与直接作答损失。
逐图理解论文
数据引擎
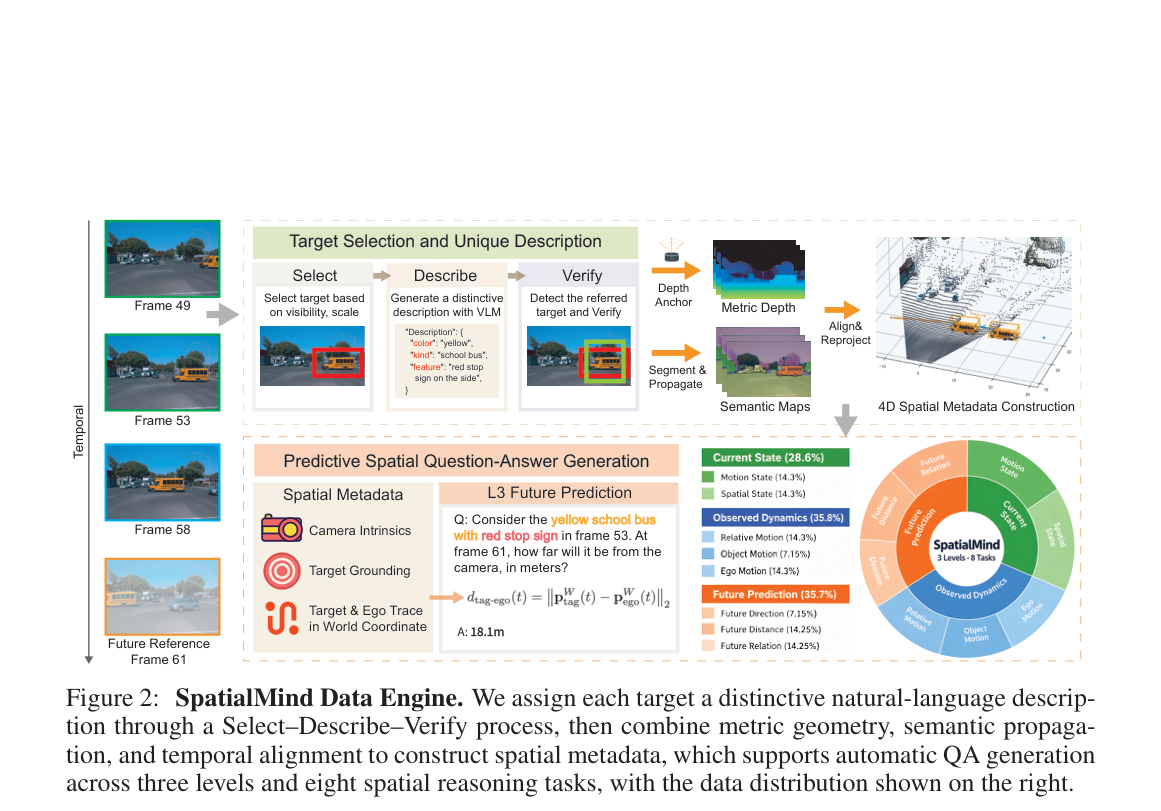
图2是 SpatialMind Data Engine。左侧时间列 Frame 49、53、58,底部 Future Reference Frame 61 为橙色未来参照。上栏 Target Selection and Unique Description 按 Select → Describe → Verify:校车被红框选出,描述 JSON 写 color yellow、kind school bus、feature red stop sign on the side,核验帧再次框中目标。右侧 Depth Anchor 与 Segment & Propagate 生成 Metric Depth 与 Semantic Maps,再 Align & Reproject 得到 4D Spatial Metadata Construction 的点云与校车。下栏 Predictive Spatial Question-Answer Generation 用 Camera Intrinsics、Target Grounding、Target & Ego Trace in World Coordinate 生成 L3 问题:frame 53 的 yellow school bus with red stop sign 在 frame 61 距相机多远,答案 18.1 m,公式为世界坐标欧氏距离。右下柱状与环形图给出八任务配比:Current State 28.6%(Motion / Spatial 各 14.3%),Observed Dynamics 35.8%(Relative 14.3%、Object 7.15%、Ego 14.3%),Future Prediction 35.7%(Direction 7.15%、Distance 14.25%、Relation 14.25%)。
模型结构
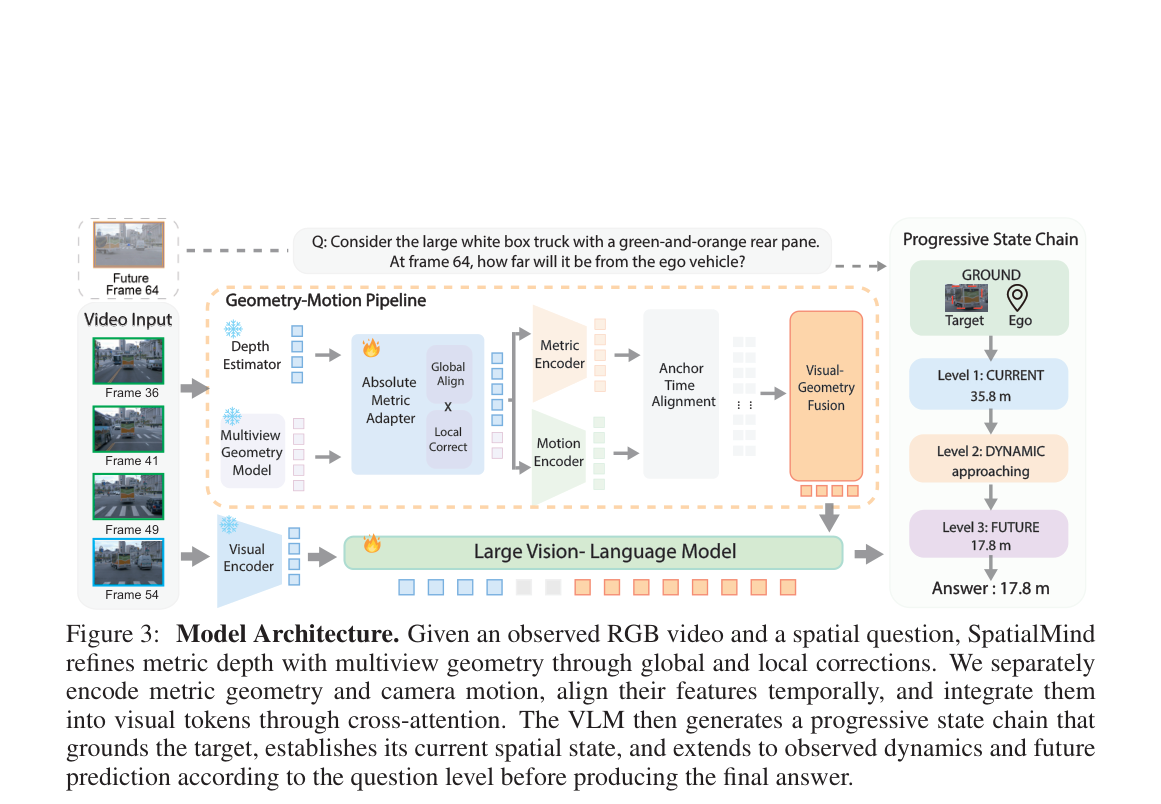
图3是模型结构。左侧 Video Input 为 Frame 36、41、49、54,虚线 Future Frame 64 不进入模型。问题为:Consider the large white box truck with a green-and-orange rear pane. At frame 64, how far will it be from the ego vehicle? 中间 Geometry-Motion Pipeline:冻结雪花图标的 Depth Estimator 与 Multiview Geometry Model 进入带火焰的 Absolute Metric Adapter,内含 Global Align 与 Local Correct;其后 Metric Encoder 与 Motion Encoder 经 Anchor Time Alignment 做 Visual-Geometry Fusion。下方 Visual Encoder 与可训练 Large Vision-Language Model 输出 token。右侧 Progressive State Chain:GROUND 标 Target 与 Ego,Level 1 CURRENT 写 35.8 m,Level 2 DYNAMIC 写 approaching,Level 3 FUTURE 写 17.8 m,Answer 17.8 m。
关键证据
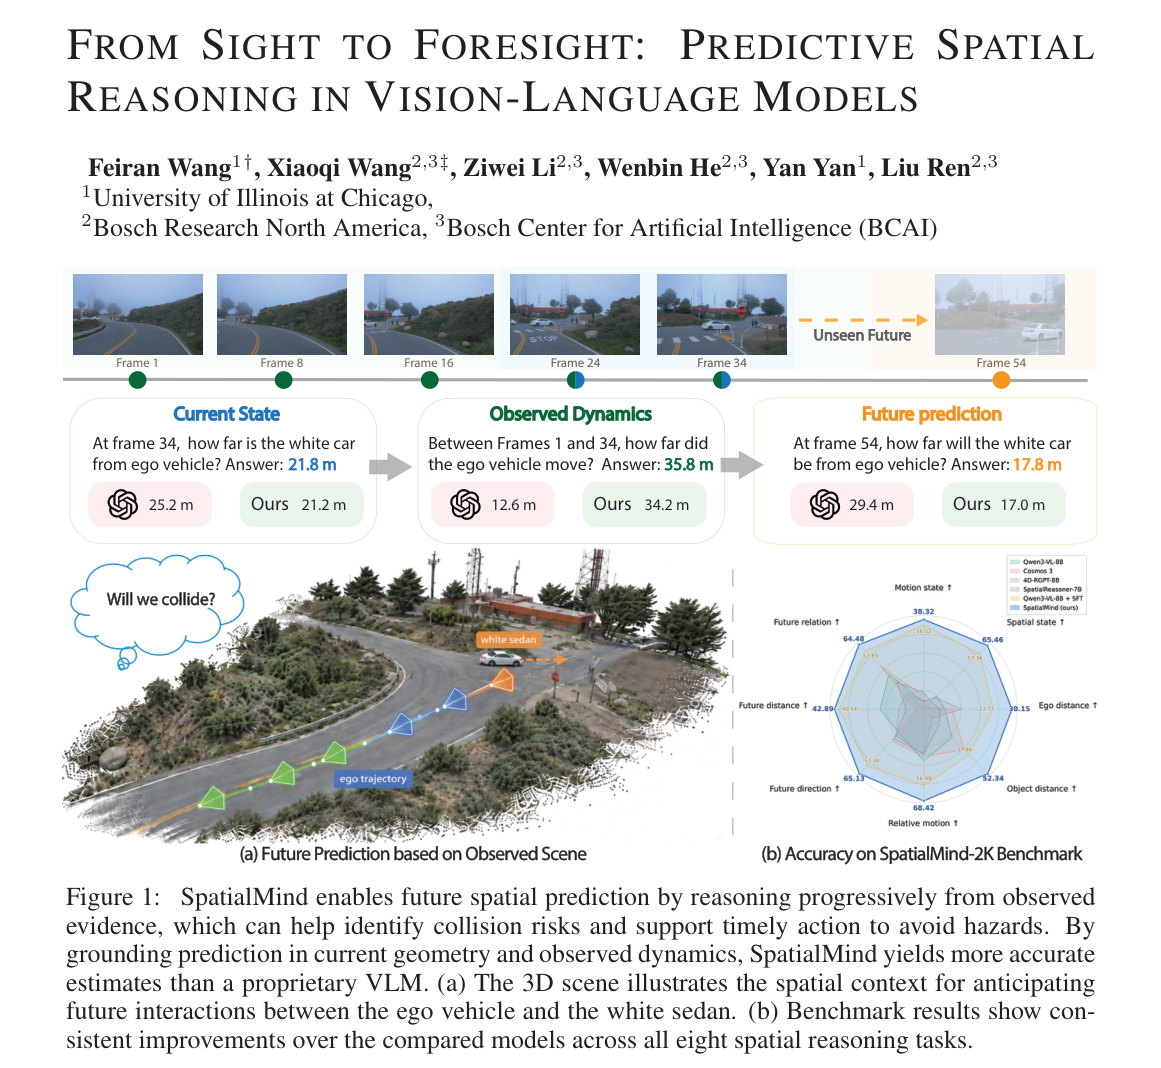
图1是论文首页总览,宜作特色图。上方时间轴从 Frame 1、8、16、24、34 的观测前缀接到淡化的 Unseen Future Frame 54。三块卡片对应三级推理:Current State 问第 34 帧白车距自车,真值 21.8 m,专有模型 25.2 m、Ours 21.2 m;Observed Dynamics 问第 1 到 34 帧自车走了多远,真值 35.8 m,对照 12.6 m、Ours 34.2 m;Future prediction 问第 54 帧未来距离,真值 17.8 m,对照 29.4 m、Ours 17.0 m。左下 (a) 是盘山公路三维示意,绿色三角标 ego trajectory,橙色标 white sedan,旁有 Will we collide?。(b) 是 SpatialMind-2K 八任务雷达图,图例含 Qwen3-VL-8B、Cosmos 3、4D-RGPT-8B、SpatialReasoner-7B、Qwen3-VL-8B + SFT 与 SpatialMind,完整模型覆盖最外。
实验如何设计?
- SpatialMind-2K 含三类选择题(相对运动、自我未来方向、目标未来关系)与五类填空数值题(空间状态、运动状态、自我路程、目标路程、目标未来距离)。选择题用准确率,数值题用 mean relative accuracy(MRA);无法解析的数值答案记零分。未来预测任务对所有模型都只给观测前缀。
- 对照包括 GPT-5.6 Luna、Claude Sonnet 5、Gemini 3.8 Flash、GPT-6-Astra 等专有模型,Qwen、LLaVA-NeXT、Cosmos3 等通用开源模型,以及 SR-3D、SpatialRGPT、VLM-3R、4D-RGPT、SpatialReasoner 等空间专用模型。关键对照是在同一 SpatialMind-30K 上微调的 Qwen3-VL-8B SFT,用来分离数据监督与方法设计的贡献。
- 附录 Table 5 给出域与任务家族分布:训练自我中心 11,456、驾驶 19,221;测试 858 / 1,142。目标运动距离与自我未来方向只出现在驾驶域。消融时几何变体都保留递进状态链,状态链变体都保留绝对度量适配器。
关键结果与论文证据
- Table 1 上,专有模型整体高于未微调开源与空间专用模型,最强 GPT-6-Astra 总体 39.00%,但当前距离与自我路程仍弱,说明综合能力强不等于米制估计准。通用与空间专用模型更偏向方向或关系类题目,Level 1 度量与 Level 2 自我路程尤其困难。同数据 SFT 把 Qwen3-VL-8B 总体拉到 45.70%,八项全升;SpatialMind 再升到 52.65%,空间状态 65.46%、相对运动 68.42%、未来方向 65.13%、未来关系 64.48%。图1雷达图上完整模型覆盖最外圈。
- 零样本方面,Table 2 报告 VSI-Bench 测量 52.1、时空 52.4,分项高于对照,总分 46.4 仍有竞争力;OSI-Bench 总分 35.0,静态度量 30.2 领先,动态 33.4 接近更大的 Qwen3-VL-32B;VLM4D 总分 53.4,真实 53.5、合成 52.9。作者据此认为度量估计与时空推理可以迁到室内、开放世界与不同视觉环境。
- Table 3 中 RGB only 总体 50.42%,直接换 DA3 或 VGGT-Ω 深度只有小幅提升,完整适配器到 52.65%,对 Level 2 已见动态帮助最大。Table 4 中直接作答 49.95%,无微调自由 CoT 掉到 34.15%,去掉 GROUND 为 51.55%,完整链 52.65%。可读中间状态需要任务化监督,而不是提示一份检测-思考-作答格式。
阅读时需要注意
- 附录 G 写明:方法依赖估计几何、对应与轨迹,误差会传到答案和状态链目标;两个源域与所评时域不能证明无限制迁移或长时预报;可读状态链不等于因果忠实;实验也未报告端到端时延。
- 未来距离在驾驶域更不能靠“保持当前值”蒙对:附录诊断里,标注当前距离落在未来容差内的比例,自我中心为 81.8%,驾驶仅为 34.5%。该诊断用的是标注当前状态,不是只看 RGB 的模型。
- 伦理声明指出语料继承 Waymo 与 Ego-Exo4D 的偏差与隐私限制,模型仅供研究。预印本未同行评审。
关联工作
- 空间推理 VLM 多用外部几何先验:深度监督、RGB-D 或预训练三维特征。另一路工作用未来事件、时间事件链或潜视觉推理做预测,但较少显式输出以米计的未来距离。SpatialMind 把绝对度量适配器与递进状态链接到同一条从当前到未来的链上。
- STRIDE-QA 评城市驾驶的短时未来距离与速度,发布接口常用视觉标记目标、观测跨度约 1.5 秒。SpatialMind-2K 用语言描述指称实体,观测窗最长到 19.8 秒,并同时覆盖驾驶与日常自我中心。OmniSpatial 与 SCP-Bench 分别看运动预测与未见空间状态,仍不是同一实体上的三级递进。
- VSI-Bench、OSI-Bench 与 VLM4D 被用作外部零样本压力测试,分别强调视频空间测量、开放世界静动态度量,以及真实与合成视频上的四维运动理解。