快速导读:EgoExo-Next 用四选一视觉选项考查自我中心下一状态、双向跨视角对应及其组合,揭示当前视觉语言模型与人类的巨大差距。
预测“下一步做什么”并不等于认出“下一帧看起来如何”。同一抓取或装配动作会经过物体配置、身体姿态、接触关系和空间布局都不同、但高层语义相近的多个状态;跨视角时,还要把未观测的未来状态翻译成另一台相机看到的样子。EgoExo-Next(arXiv:2610.04506,复旦大学与西交利物浦大学)把预测目标改成视觉状态本身:模型必须从四张时序相关的候选图里指出后续画面,而不是选动作标签或文字描述。基准公开于 https://huggingface.co/datasets/yutongli2024/EgoExo-Next 。
基准含 2,503 道人工核验四选一题,来自六个公开自我中心与自我–外中心视频源,并拆成四个互连子任务:自我中心下一状态、双向同步跨视角匹配、外中心下一状态,以及组合的 Ego-to-Exo Next-State。全四子任务评测中最强模型 Gemini-3.1-Pro 平均 43.81%,人类 98.55%;组合子任务上全评模型室内/室外最高仅 32.89% / 34.28%。预印本尚未同行评审。
英文题目:EgoExo-Next: Benchmarking Vision-Language Models on Visual-Option Next-State and Cross-View Reasoning
论文出处:arXiv 每日论文精选 · arXiv:2610.04506
原始论文:PDF / 论文页面
这篇论文解决什么问题?
在物理环境里,智能体往往自我中心地看世界,示范、监督或协作观察却来自外中心视角。人可以从第一人称里手伸向工具的过程,预判物体接下来的配置,并想象第三人称下的身体姿态与场景布局。这要求同时做时间推进和视角变换。
既有基准打下了基础,但停在另一层能力。EgoSchema、EgoPlan、EgoTempo、EgoThink 评长视频、规划或细粒度时序;EgoExoBench 评语义对齐、视角关联、动作预测与跨视角匹配。它们主要问模型能否识别、预测、排序或对齐已经发生的动作与事件,或在已经给出的自我–外中心观测之间建立对应。EgoExo-Next 则要求先推断未观测的后续状态,再在视觉空间里把它认出来;组合题还要把这个未来状态映射到外中心画面。
核心创新
- 把预测目标从动作标签改成未观测的下一视觉状态,用四张时序相关图像作选项。
- 用四个互连子任务分别测自我中心推进、外中心推进、双向跨视角对应,以及二者的组合。
- 用非均匀采样、更早状态与更晚未来干扰项,以及均衡未来候选配比,降低“只选最未来”的捷径。
方法概览
EgoExo-Next 含 2,503 道人工核验的四选一视觉题,来自 EPIC-KITCHENS-100、Ego4D、WEAR、Ego-Exo4D、EgoExoLearn、EgoHumans。视觉状态指一帧里可见的物体配置、人体姿态、接触关系与空间布局。四个子任务构成诊断套件:子任务1 Ego Next-State 由自我中心序列选下一自我中心状态;子任务2 Ego–Exo Matching 在同步时刻做双向跨视角对应;子任务3 Exo Next-State 在外中心做下一状态;子任务4 Ego-to-Exo Next-State 由自我中心观测推断未观测未来并选出对应外中心画面。下一状态题的目标是观测结束后最近的采样未来帧,干扰项可在观测前或目标之后;题目均分成四组,未来候选数 1 到 4 各占 25%,对应 (1,0,3)、(1,1,2)、(1,2,1)、(1,3,0) 的目标/更晚未来/过去配比。候选来自同一动作轨迹,选项顺序随机,正确答案在 A/B/C/D 上均衡。三位独立审阅者核验可解性,必要时做模糊检测与换帧。评测为零样本四选一,观测与候选分开输入,每模型跑三次取均值;子任务2 两个方向分开再平均。另用 CLIP 与 DINO 最近邻检验视觉相似度捷径。
- 作者把视觉状态定义为一帧里可观察的场景配置,包括物体配置、人体姿态、接触关系与空间布局。形式化上,F_t^ego 与 F_t^exo 表示时刻 t 的两种视角状态。子任务1评 F_{1:t}^ego → F_{t+}^ego,子任务2评同步的 F_t^ego ↔ F_t^exo,子任务3评 F_{1:t}^exo → F_{t+}^exo,子任务4评 F_{1:t}^ego → F_{t+}^exo。观测与目标之间的时间间隔不固定。
- 数据来自六个公开源。EPIC-KITCHENS-100、Ego4D、WEAR 主要提供自我中心视频;Ego-Exo4D、EgoExoLearn、EgoHumans 提供配对或多视角记录。标注者先标出完整动作片段,再按子任务构造观测序列与候选。观测保持时间顺序,但片段之间和片段内部的时间间隔可以不同,不使用固定网格。
- 下一状态题的目标是观测结束后最近的采样未来状态;干扰项可以在最终观测之前,也可以在目标之后。题目均分成四组,未来候选数 1 到 4 各占 25%,分别对应 (目标, 更晚未来, 过去) = (1,0,3)、(1,1,2)、(1,2,1)、(1,3,0)。因此既不能靠“找出唯一的未来”,也不能靠“选时间上最靠后的一张”。所有候选来自同一动作轨迹,以保留场景与动作语义,同时迫使模型区分细粒度进程。子任务2在同步时间戳上构造双向匹配。选项顺序随机,正确答案在 A/B/C/D 上均衡。
- 质量上,三位独立于原标注者的审阅者只看提供的视觉输入,检查动作是否清楚、进程是否可辨、画质、候选是否可区分、跨视角是否有对应。下一状态题还要确认目标能同时从更早状态和更晚未来里被区分。必要时做模糊检测与局部换帧;含糊或不可解的样本被修改或删除。
逐图理解论文
评测缺口
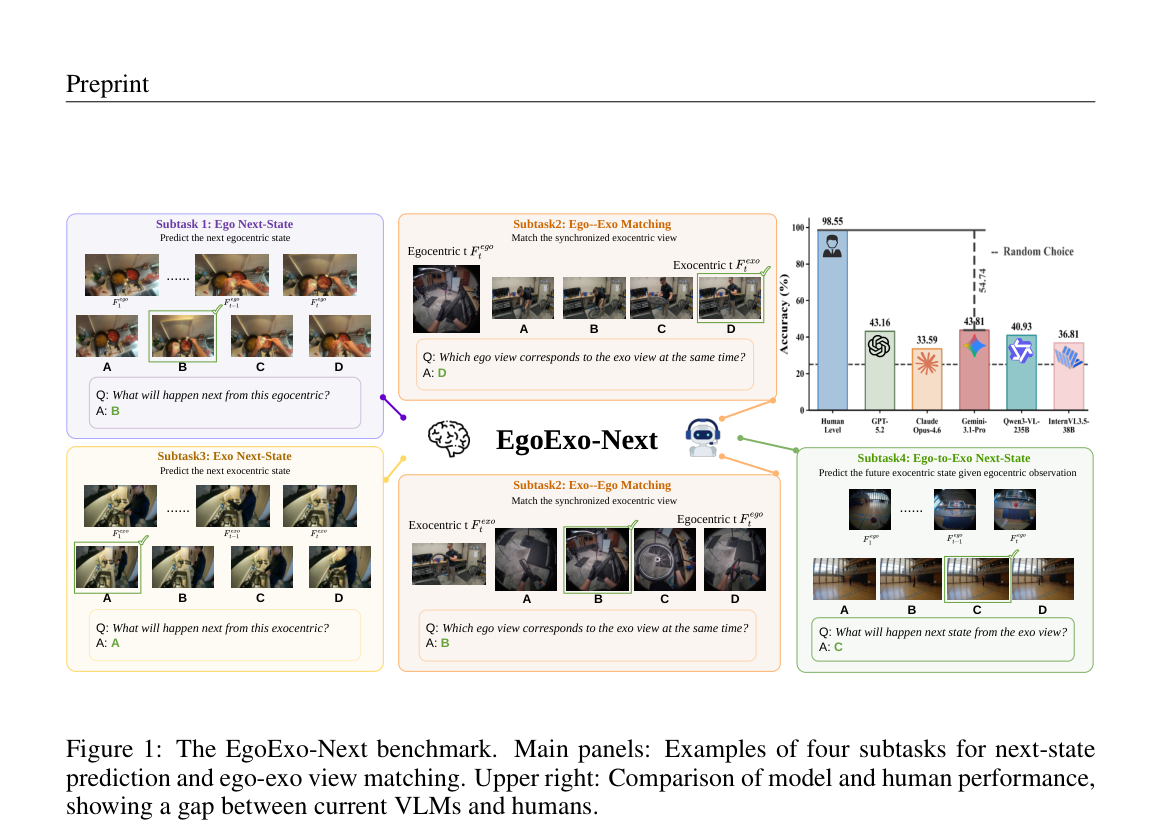
图1是 EgoExo-Next 总览,宜作特色图。页眉有 Preprint。中央标 EgoExo-Next。左上紫色 Subtask 1: Ego Next-State 为厨房切物的自我中心序列,四选项中 B 有绿框,题面 Q: What will happen next from this egocentric? A: B。上中橙色 Subtask2: Ego–Exo Matching 用健身房自我中心查询匹配外中心,D 有绿勾,A: D。左下橙色 Subtask3: Exo Next-State 为厨房外中心,A 有绿框,A: A。下中 Subtask2: Exo–Ego Matching 外中心查询匹配自我中心,B 有绿框,A: B。右下绿色 Subtask4: Ego-to-Exo Next-State 由自我中心序列选未来外中心,C 有绿框,A: C。右上柱状图比较 Human Level 98.55 与 GPT-5.2 43.16、Claude-Opus-4.6 33.59、Gemini-3.1-Pro 43.81、Qwen3-VL-235B 40.93、InternVL3.5-38B 36.81,虚线 Random Choice,人机差标注 54.74。
基准设计
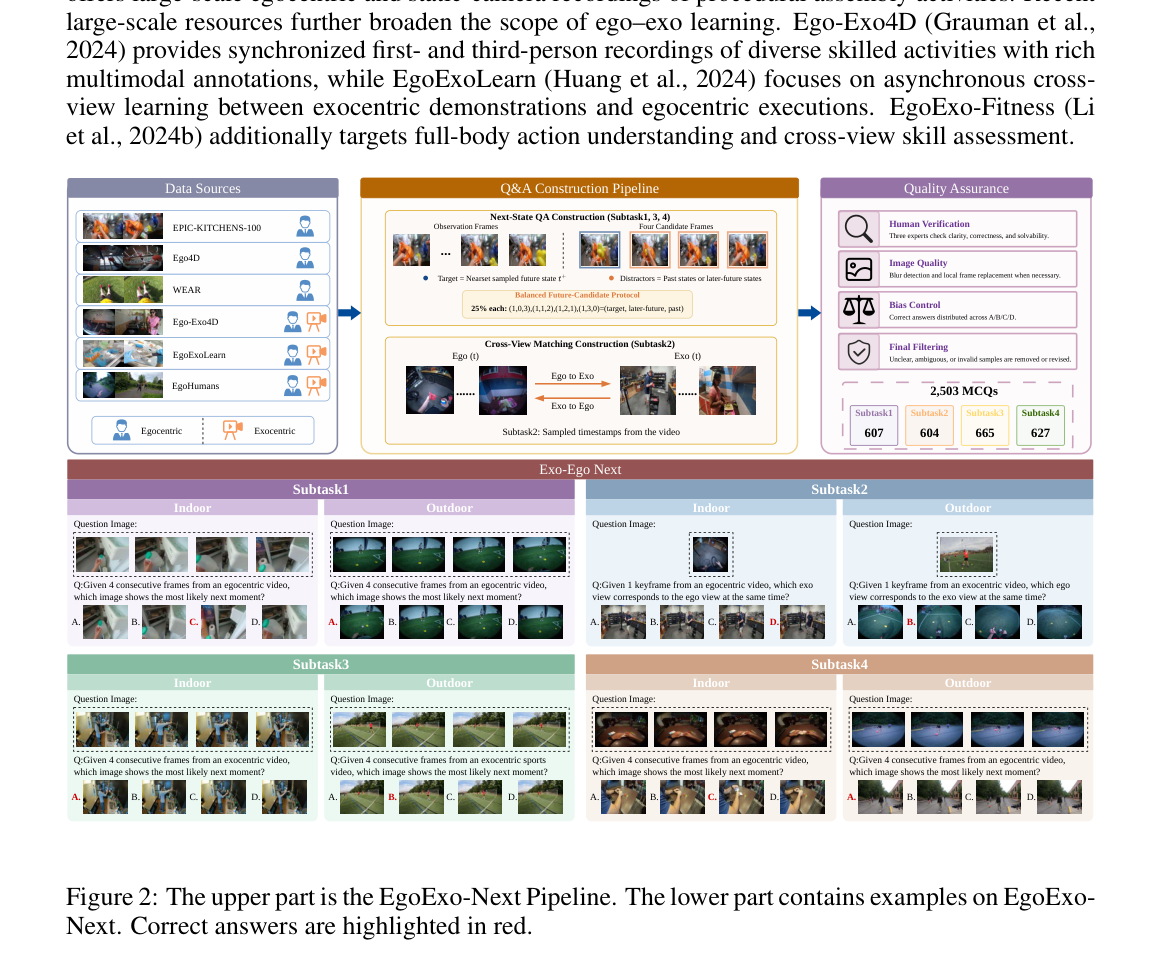
图2上半是构造流水线,下半是室内外样例。上沿裁进了相关工作段落,讲图时忽略。Data Sources 列出 EPIC-KITCHENS-100、Ego4D、WEAR、Ego-Exo4D、EgoExoLearn、EgoHumans,并区分 Egocentric 与 Exocentric 图标。Q&A Construction Pipeline 分两块:Next-State QA Construction 标明 Target = nearest sampled future state,Distractors = past or later-future,以及 25% each 的 (1,0,3)/(1,1,2)/(1,2,1)/(1,3,0);Cross-View Matching Construction 在 Ego (t) 与 Exo (t) 之间做 Ego to Exo 与 Exo to Ego。Quality Assurance 含 Human Verification、Image Quality、Bias Control、Final Filtering,并给出 2,503 MCQs 及 607 / 604 / 665 / 627。下半八个样例按子任务与 Indoor/Outdoor 排列,正确答案用红字标出,例如子任务1室内为 C、室外为 A。
抗捷径
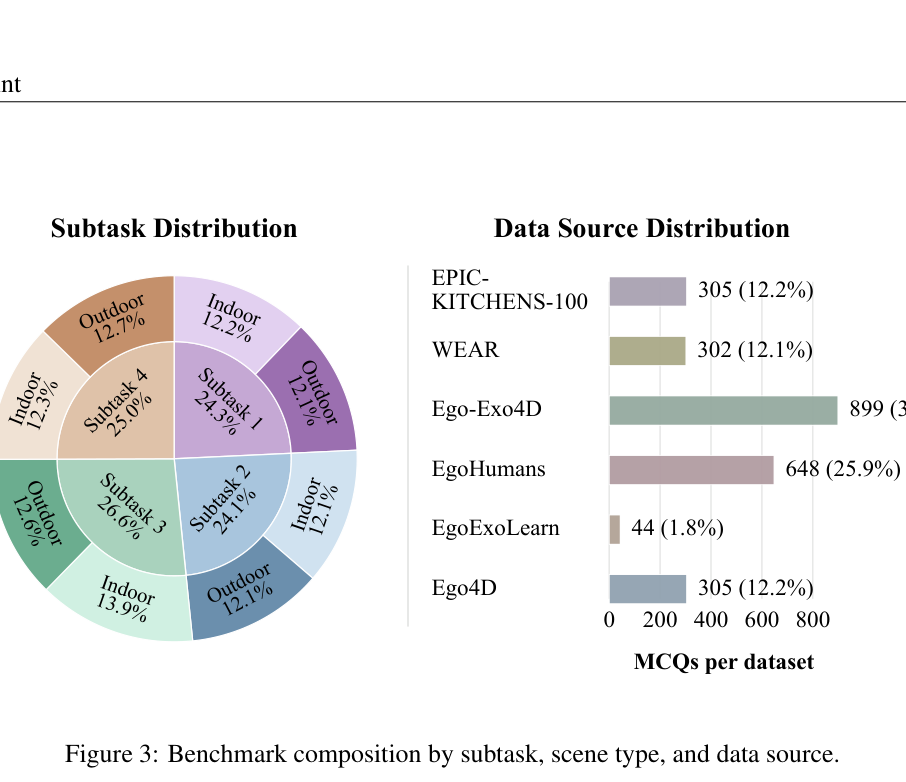
图3是构成统计。左环图按子任务与室内外切分:Subtask 1 24.3%(Indoor 12.2%、Outdoor 12.1%),Subtask 2 24.1%(两侧各 12.1%),Subtask 3 26.6%(Indoor 13.9%、Outdoor 12.6%),Subtask 4 25.0%(Indoor 12.3%、Outdoor 12.7%)。右柱为来源:EPIC-KITCHENS-100 305(12.2%)、WEAR 302(12.1%)、Ego-Exo4D 899(35.9%)、EgoHumans 648(25.9%)、EgoExoLearn 44(1.8%)、Ego4D 305(12.2%)。页眉裁到 Preprint 残字 nt,应忽略。环图百分比与正文 607/604/665/627 及室内 50.5%、室外 49.5% 一致。
结论与局限
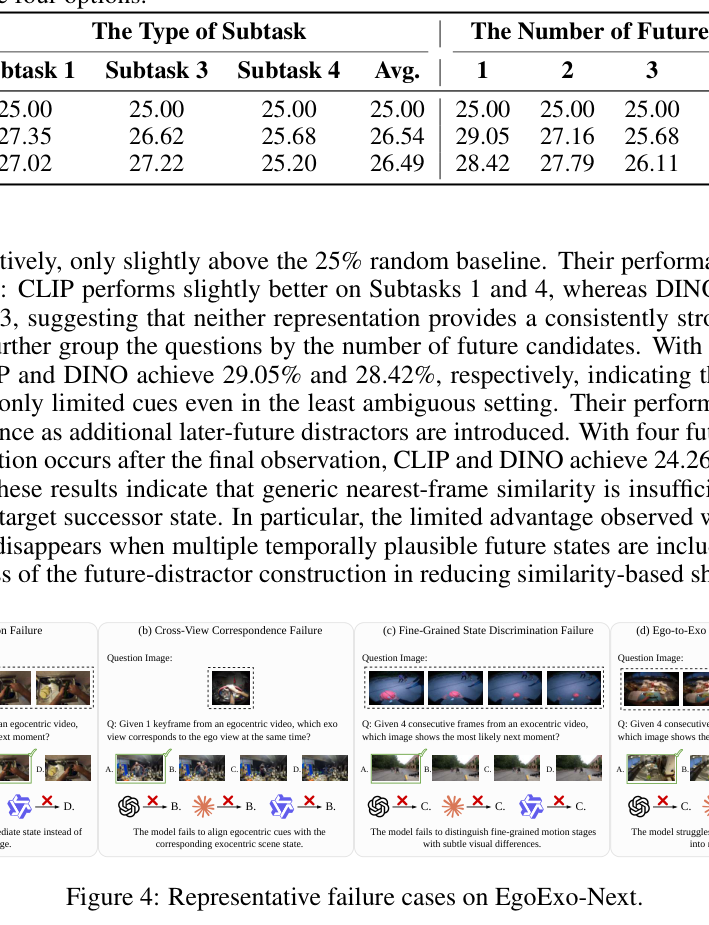
图4展示四类失败,但裁切上沿带有 Table 3 的数字残片,讲图时只看下半四宫格。(a) Temporal Progression Failure:自我中心下一状态题,模型选了更早中间状态而不是下一动作阶段,标为选 D。(b) Cross-View Correspondence Failure:用一张自我中心关键帧匹配外中心,GPT、Claude 与 Qwen 都错在 B,说明对不上手物交互与第三人称场景。(c) Fine-Grained State Discrimination Failure:外中心下一状态,三家都错在 C,候选只在细微运动阶段上不同。(d) Ego-to-Exo Next-State Reasoning Failure:由自我中心序列选未来外中心,示例中模型错在 C。四块共同说明错误不只来自动作识别,还来自进程、跨视角、细粒度分辨及其组合。
实验如何设计?
- 评测是零样本四选一:观测帧与候选图作为分开的视觉输入,模型输出选项字母。不用上下文样例,也不做任务微调。每模型运行三次,报告平均准确率。子任务2 的两个方向独立计分再平均。随机猜测为 25%。GPT-6 因成本只评子任务4,故不进入总体均值。
- 对照覆盖专有模型(GPT-5.2、Claude-Opus-4.6、Gemini-3.1-Pro,以及仅子任务4 的 GPT-6)、开源模型(Qwen3-VL 235B/32B/8B、InternVL3.5 8B/38B、LLaVA-OneVision-1.5-8B)与空间推理模型(SpatialVLM、SpatialMLLM、RoboBrain)。另外在子任务1、3、4 上用 CLIP 与 DINO 对最后一帧观测与四张候选做余弦最近邻,检验能否靠泛化视觉相似度解题。
- 捷径分析在五个代表模型上做:Candidate Only 去掉全部观测;Last Frame Only 只留最后一帧观测;Shuffled Sequence 打乱观测顺序;Mismatched Observation 把查询换成同源同场景划分的另一条样本。
关键结果与论文证据
- Table 1 的第一条结论是人机差距很大。全四子任务最强的 Gemini-3.1-Pro 平均 43.81%,GPT-5.2 为 43.16%,开源最强 Qwen3-VL-235B 为 40.93%,人类 98.55%。图1右上柱状图把这条鸿沟画成约 54.74 个百分点,并标出随机线 25%。
- 第二条是组合题最有区分度。全评模型在子任务4 室内/室外最高仅 32.89% 与 34.28%;GPT-6 升到 62.23% 与 58.14%,说明基准能随模型能力上升,但仍低于人类 97.09% 与 96.86%。第三条是缩放与空间特化都不能稳定打穿全基准:专有模型整体更强,但 Qwen3-VL-235B 在子任务3 室外可排到全评模型最好;InternVL3.5 随规模上升,Qwen3-VL 家族并非严格单调;SpatialVLM、SpatialMLLM、RoboBrain 也没有稳定超过通用模型。
- Table 2 显示成绩依赖观测上下文、时间顺序与跨视角对应,而不是候选图自带线索。五模型平均从 Full Input 40.70% 降到 Candidate Only 26.31%;时序子任务从 40.63% 降到末帧 35.56%、打乱 31.70%;跨视角从 35.02% 降到错配观测 26.32%。Table 3 中 CLIP 与 DINO 平均 26.54% 与 26.49%;只有一个未来候选时略高于随机,四个未来候选时掉到 24.26% 与 23.63%。图4把失败归纳为四类:选了更早的中间状态、对不上跨视角场景、分不清细微动作阶段、无法把自我中心进程译成外中心下一状态。
阅读时需要注意
- 基准考查的是静态图像选项上的识别,而不是开放式描述或连续视频生成;观察与候选被拆成独立输入,与端侧流式感知仍有距离。
- 子任务4 只提供自我中心观测去选未来外中心画面,因此同时混合了时间外推与视角变换,失败时需要结合图4 的分类型错误来读,不能直接等同于单一能力缺失。GPT-6 只评该子任务,不能写入总体平均。
- 来源分布不均:Ego-Exo4D 占 35.9%,EgoExoLearn 仅 44 条。作者说明是为避免与其他源的场景和活动重复。预印本未同行评审,语料也继承原数据集的偏差与隐私约束。
关联工作
- 自我中心问答线包括 EgoVQA、EgoSchema、EgoPlan、EgoThink、EgoTempo 与 EgoProx,分别覆盖第一人称问答、长时理解、规划、认知维度、细粒度时序与三维邻近。EgoExo-Next 与它们的差别不在“有没有时间问题”,而在预测对象是未观测视觉状态。
- 跨视角数据从 Charades-Ego、Home Action Genome、LEMMA、H2O、Assembly101 走到 Ego-Exo4D、EgoExoLearn、EgoExo-Fitness。EgoExoBench 已在配对视频上评语义与动作级跨视角推理。EgoExo-Next 借用这些源,把任务改成视觉选项上的状态级对应与组合预测。
- 附录还把本基准与空间推理评测对照:关键不是单独的时间或空间能力,而是在一道题里认出后续视觉状态,并在 Ego-to-Exo 设置中把时间推进与视角变换组合起来。