快速导读:LoCoSplat 用细粗网格上的固定局部平均代替沉重三维网络,在 RealEstate10K 的 6/12/24 视角上领先,并在单卡上以 33 毫秒重建六视角场景。
前馈三维高斯溅射(feed-forward 3DGS)正在用越来越重的学习三维模块聚合多视图:稀疏三维U-Net、代价体网络,或对图像token做长序列Mamba/Transformer。VolSplat把像素沿预测深度反投影并体素化成锚点,再用约17M参数的稀疏三维U-Net细化,是体素对齐一族的代表;该U-Net形状动态,进不了CUDA图,混合精度几乎无收益,也是视角变密时的训练显存主因。LoCoSplat(Local-Context Splatting,arXiv:2610.04351,Georgia Institute of Technology)问的是:高斯既然是局部图元,三维阶段是否还需要这么大的学习容量。
作者的答案是固定局部平均就够。深度与逐像素特征反投影、体素化成锚点后,把16维线性投影溅射进细网格(体素0.001)和粗网格(单元0.128),再用0.14M逐点MLP读回并逐点解码高斯。无学习三维网络、无动态稀疏计算,整编码器作为一张fp16 CUDA图运行。在RealEstate10K上,6/12/24视角的PSNR、SSIM、LPIPS全面领先先前前馈方法;六视角场景在一块NVIDIA RTX PRO 6000上33毫秒重建,是文中七种前馈方法里最快,相对先前体素对齐SOTA约4.2倍,并在ACID零样本与ScanNet微调上拉开差距。预印本尚未同行评审。
英文题目:LoCoSplat: Real-Time Feed-Forward 3D Gaussian Splatting with Minimal 3D Reasoning
论文出处:arXiv 每日论文精选 · arXiv:2610.04351
原始论文:PDF / 论文页面
这篇论文解决什么问题?
逐场景NeRF与3DGS要把每个场景优化很久。前馈方法用学习先验一次前向从少量已标定图像预测高斯。占主导的像素对齐路线会遇到多视图错位,以及高斯数量被图像分辨率绑死。领域的应对是把预测搬进三维,用更重的学习模块做推理。
VolSplat代表深度引导的体素对齐路线:预测深度、把反投影像素体素化成锚点,再用稀疏三维U-Net细化后解码高斯。作者指出该U-Net是最大推理开销(约每秒7个场景),24视角训练约159小时。背后的隐含假设是:在三维里聚合多视图证据需要可观的学习三维容量。LoCoSplat从局部视角反驳:高斯需要从邻居得到的是网格可以免费计算的低阶局部信息,而不是学习三维网络。
核心创新
- 用高斯局部性论证三维阶段只需粗尺度固定平均,无需学习三维网络。
- 细网格0.001加粗网格0.128的splat-and-query,配合0.14M逐点MLP,整编码器进一张CUDA图。
- 用平面扫描候选间距解释稠密视角崩溃,并说明失败在深度分支而非三维阶段。
方法概览
LoCoSplat保持VolSplat/DepthSplat式深度引导管线直到锚点:冻结DepthAnythingV2 ViT-B提供单目特征,最近两视图的局部窗口交叉注意力与D=64逆深度平面扫描得到匹配概率与粗深度,两个DPT头分别输出全分辨率深度与132维逐像素特征。像素沿深度反投影,在v=0.001体素化,占用体素成为锚点。三维阶段无学习三维网络:特征线性投影到16维后,细网格直接取锚点自身均值u0,粗网格H=0.128做无参数平均得到u1,0.14M逐点MLP残差融合[u0;u1;fa],6.5k逐点头解码高斯(中心偏移限制在±1.5细体素,颜色DC来自像素均值RGB)。损失为渲染L2+λLPIPS,并对粗深度分支加β=0.9辅助项,无深度真值。编码器无数据依赖形状,推理时整网作为一张fp16 CUDA图运行。
- 输入是V张带内参与相机到世界位姿的图像。冻结的DepthAnythingV2 ViT-B给出单目特征,经可训练线性接口从768维映到384维;一个带最近两视图局部窗口交叉注意力的CNN给出匹配特征,并在D=64个逆深度候选上建平面扫描代价体。深度可分、半宽的UniMatch式回归器得到匹配概率与粗逆深度;一个DPT头结合单目特征细化成全分辨率深度,另一个DPT头输出进入三维阶段的132维逐像素特征(拼接图像、深度与峰值匹配概率)。
- 每个像素沿深度反投影,在细体素尺寸v=0.001处体素化。占用体素构成锚点集,每锚点一颗高斯,携带该体素内点的均值位置与均值特征。在该工作体素下,几乎每个占用体素只含一点;六视角时仅0.42%锚点在3×3×3邻域有占用邻居,因此细格子本身几乎没有邻域结构,三维阶段需要的上下文必须来自更粗尺度。
- 三维阶段把式(2)实例化为两档盒核平均。细层就是锚点格子,u0(a)=W0 fa,不必再溅射。粗层单元尺寸H=0.128,把W1 fi按粗单元格平均得到u1,空单元为0。融合为fa'=fa+g([u0;u1;fa]),其中W0、W1∈R^{16×132},g是164→256→256→132的逐点MLP。聚合本身无参数、无数据依赖形状;三维阶段仅学习投影4.3k参数与g的0.14M参数。随后两层逐点MLP h(6.5k)把fa'映到原始高斯参数:中心只允许在锚点周围±1.5细体素内偏移,尺度经softplus裁剪,旋转由单位四元数给出,颜色用二阶球谐,直流项取锚点像素均值RGB。因为99.6%锚点没有占用的3×3×3邻居,稀疏卷积几乎会退化成中心抽头,逐点头也让管线避开稀疏张量。
- 训练只靠RGB:可微光栅化渲染目标视图,损失为L2加λ=0.05的LPIPS,并对由粗深度走同一套锚点、三维阶段与头(共享权重)得到的高斯加β=0.9辅助项,不用深度真值。150k步AdamW,跟随VolSplat训练协议。二维到三维阶段无数据依赖形状,推理时整编码器捕获为一张fp16 CUDA图。
逐图理解论文
沉重三维阶段
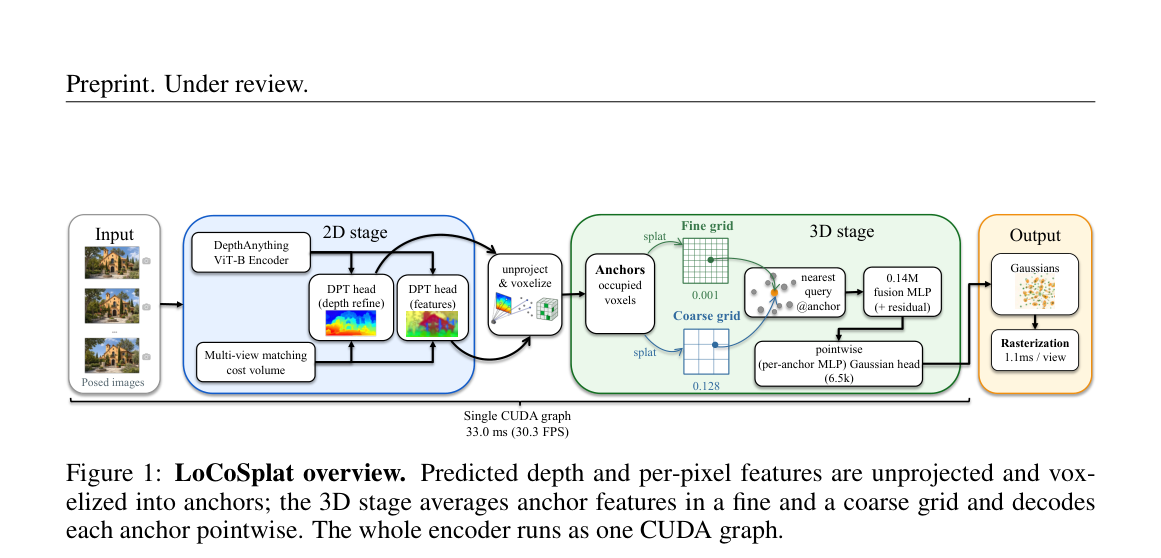
图1是LoCoSplat总览,宜作特色图。页眉写Preprint. Under review。左侧Input为三张带位姿的房屋照片。蓝色2D stage含DepthAnything ViT-B Encoder、Multi-view matching cost volume,以及两个DPT head:左侧伪彩深度细化、右侧绿色特征图。中间经unproject & voxelize进入绿色3D stage:Anchors occupied voxels,向上splat到Fine grid(标0.001),向下splat到Coarse grid(标0.128),nearest query @anchor后经0.14M fusion MLP(+ residual),再经pointwise per-anchor MLP Gaussian head(标6.5k)。橙色Output为Gaussians与Rasterization 1.1ms/view。底栏写Single CUDA graph 33.0 ms (30.3 FPS)。
质量与速度
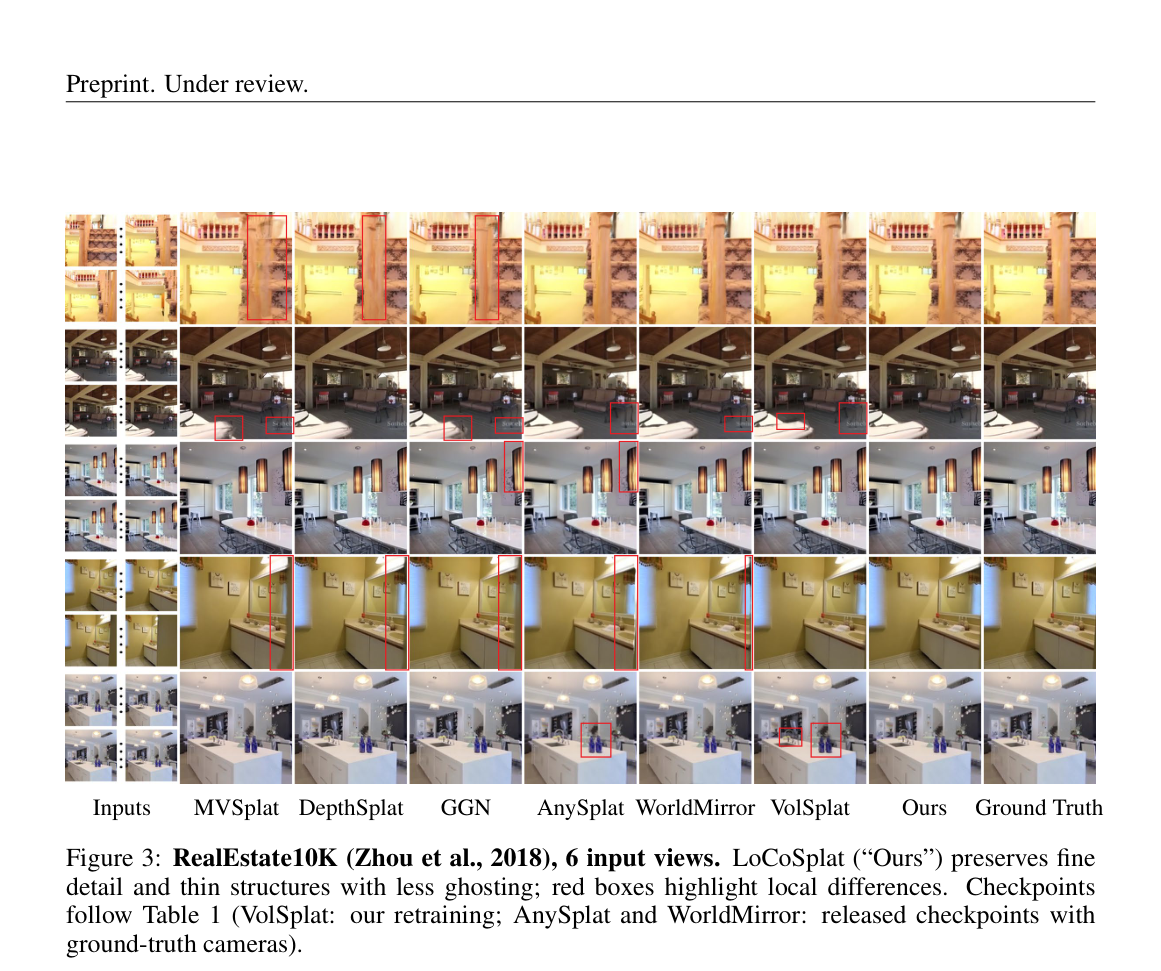
图3是RealEstate10K六输入视角的定性对比。列从左到右为Inputs(小图叠放加省略号)、MVSplat、DepthSplat、GGN、AnySplat、WorldMirror、VolSplat、Ours、Ground Truth。五行室内场景:黄墙木楼梯、吊扇客厅、餐桌吊灯、黄墙厨房、中岛厨房。红框标出细结构差异,例如木柱、沙发角、吊灯、柜边与瓶罐;像素对齐与部分位姿无关方法更容易糊或重影,Ours更接近最右真值。检查点遵循Table 1。页眉Preprint。
泛化与崩溃解释
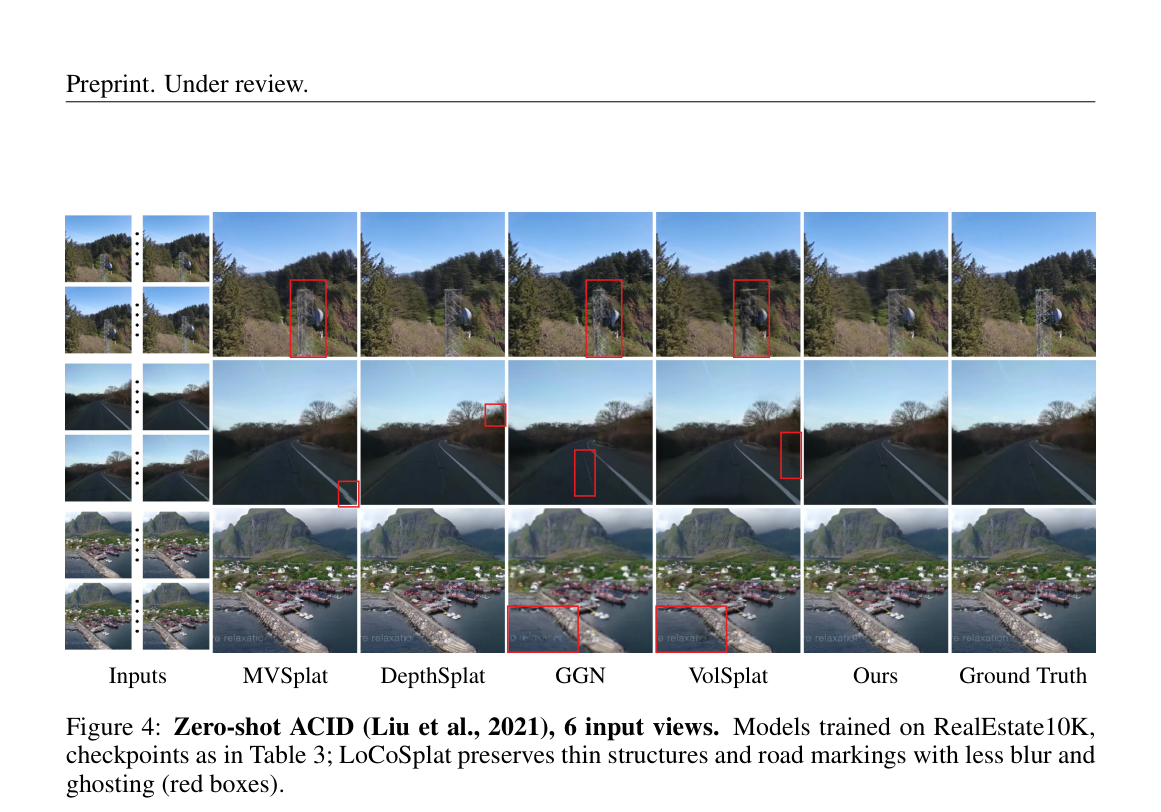
图4是在RealEstate10K上训练、零样本到ACID的六视角结果。列依次为Inputs、MVSplat、DepthSplat、GGN、VolSplat、Ours、Ground Truth,没有AnySplat与WorldMirror。三行分别为山坡铁塔、公路标线、海湾小镇。红框标出MVSplat/GGN/VolSplat把铁塔抹成团块、把路面标线弄丢或重影、把岸边结构拖糊;Ours更保住细结构和标线。检查点遵循Table 3。页眉Preprint。
实验如何设计?
- 主实验在RealEstate10K上以256×256训练,按VolSplat官方索引在约700个测试场景、每场景8个目标视图上评6/12/24上下文视角。零样本用ACID的173个场景;室内迁移跟随FreeSplat协议,把每个RealEstate10K检查点在ScanNet上微调150k步,评VolSplat官方72序列索引。作者自己的模型与重训VolSplat都用4×NVIDIA RTX PRO 6000。
- 对照包括像素对齐的pixelSplat、MVSplat、TranSplat、DepthSplat,后处理的GGN,位姿无关的AnySplat与WorldMirror(已发布检查点,表中标‡),ScanNet上的FreeSplat,以及发表版与按官方协议重训的VolSplat。指标为PSNR、SSIM、LPIPS。时序在同一GPU、同一协议下用各方法发布代码测量。消融在完全相同的150k步协议与种子下一次改一个组件;自有模型之间报逐场景配对差,≤0.03 PSNR视为平局。
关键结果与论文证据
- Table 1上LoCoSplat在每个视角数都取得最好的PSNR、SSIM与LPIPS:六视角31.51/0.942/0.074,十二视角31.47/0.942/0.073,二十四视角30.57/0.934/0.082。相对重训VolSplat,六、十二视角配对+0.58与+0.61 PSNR(68%场景更好);二十四视角所有在RealEstate10K上训练的方法都随上下文变密而下降,VolSplat最明显,LoCoSplat不共享这次下跌,配对+3.3(98%场景更好),也比大语料预训练、视角数几乎持平的WorldMirror高约1.2 PSNR。图3显示六视角时像素对齐方法会模糊或复制细结构,LoCoSplat(Ours)更接近真值。
- Table 2给出六视角效率。部署路径33.0毫秒(30.3 FPS)、峰值显存1081 MB、可训练12.5M/总计99.1M;相对VolSplat的137.0毫秒、7271 MB为4.2倍更快、约85%更少峰值显存;同等fp32 eager仍56.9对137.0毫秒(2.4倍)。训练墙钟约13.2小时对35.4小时(2.7倍),二十四视角为27小时对159小时(5.9倍)。VolSplat从同样的图捕获与混合精度只再快约1.4%,因为稀疏U-Net抗拒这些优化。去掉U-Net就把fp32 eager编码器从137.0降到94.4毫秒,同时质量上升。
- 零样本ACID上相对VolSplat的优势不缩反扩:配对+0.87 PSNR(77%场景),优于域内+0.58。图4里VolSplat的细化会抹掉无线电塔一类细结构,像素对齐基线则重影或溶解它们,LoCoSplat更能保住塔架与路面标线。ScanNet微调后相对微调VolSplat再扩到+0.92 PSNR(全部8个场景更好),并高于所有已发表条目。
- 消融支持“三维阶段需要很少”。固定网格平均加不足0.2M逐点MLP相对17M U-Net高0.70 PSNR。粗上下文换成未训练低通,或换成不含外观的10通道几何描述子,都与学习粗层打平。二十四视角崩溃由平面扫描候选数D决定:把D从64改回VolSplat的128会复现失败(28.08 PSNR,98%场景更差),即使网格与逐点头都在;每个变差的二十四视角模型都用D=128,每个健康模型都用D=64。预注册实验中,十二视角D=256崩溃,二十四视角D=32保持健康。把原版VolSplat在二十四视角只改成D=64,也会走上LoCoSplat的健康损失曲线。
阅读时需要注意
- 三维阶段消融只在六视角、只对照VolSplat的U-Net,没有对比更小的三维卷积或局部注意力。作者也未在512²、更宽基线数据如DL3DV,或噪声深度与位姿误差下评测;粗网格H=0.128在更高分辨率上未必直接迁移。
- 几何在原则上由深度主导:高斯中心最多偏离锚点1.5个细体素,三维布局继承深度预测质量,二十四视角崩溃也确实发生在深度分支。普通均值只对光滑、同方差噪声场最优,会在遮挡边界跨表面模糊;逐点头依赖锚点孤立,更密输入可能侵蚀该假设。
- AnySplat与WorldMirror使用不同训练语料与分辨率的已发布检查点,不宜与等协议重训直接比较绝对值。预印本未同行评审,文中未见独立项目页。
关联工作
- pixelSplat与MVSplat从对极或代价体特征预测像素对齐高斯;TranSplat、DepthSplat与FreeSplat改进深度估计与跨视图融合;GGN与AnySplat对像素对齐高斯做后处理,WorldMirror则与几何联合预测。位姿无关一系建立在DUSt3R、VGGT风格的几何Transformer与多数据预训练上,改变的是输入与训练数据,而不是三维阶段。
- VolSplat把逐像素特征沿预测深度反投影、体素化,用三维U-Net细化稀疏体,再按占用体素解码高斯;相关系统同样依赖稀疏三维CNN或体融合,Long-LRM则把长序列模型打在图像token上。Instant-NGP让多分辨率网格加小MLP在逐场景优化中流行;LoCoSplat的网格不存储学习到的场景内容,每步从输入重建,是分箱核估计意义下的局部均值聚合结构。